API de génération d’images : guide pratique pour les équipes
Une API de génération d’images est facile à tester dans une démo et étonnamment facile à mal gérer en production. Une équipe peut envoyer une seule requête, recevoir une image attrayante en retour, et pourtant ne toujours pas avoir de réponse aux questions qui compteront plus tard : quel modèle doit prendre en charge quelle charge de travail, que se passe-t-il lorsqu’une requête est bloquée, comment estimer le coût avant le lancement, et comment les équipes produit, design et ingénierie examinent-elles les résultats sans transformer chaque image en exception manuelle ?
Ce guide s’adresse aux équipes qui évaluent une API de génération d’images pour des écrans produit, des publicités, des créations e-commerce, des workflows d’agents ou des opérations de contenu internes. Il vous propose un flux de travail pratique que vous pouvez utiliser avant de vous engager auprès d’un fournisseur, d’un modèle ou d’un style d’intégration.
Flatkey s’intègre bien à ce flux de travail lorsque votre équipe souhaite une seule clé API, un solde partagé, un registre d’utilisation unique et un routeur unique pour les appels de texte, d’image, de vidéo et d’outils. Vous pouvez toujours choisir le modèle adapté à la tâche. La différence opérationnelle est que votre équipe examine les dépenses, la latence et l’utilisation à un seul endroit au lieu de courir après des comptes de fournisseurs séparés.
Réponse rapide
Choisissez une API de génération d’images en alignant la charge de travail sur la boucle de validation :
| Charge de travail | Ce qui compte le plus | Modèle d’API à privilégier | À mesurer |
|---|---|---|---|
| Génération créative ponctuelle | Sortie rapide du prompt à l’image | Endpoint de génération directe | Coût par image acceptée, latence, taux de retry |
| Éditions d’images produit ou e-commerce | Fidélité de la référence et changements contrôlés | Endpoint d’édition d’image ou route d’image multimodale | Taux de réussite des modifications, respect du prompt, taux de rejet |
| Itération conversationnelle sur image | Contexte multi-échanges et historique des révisions | Workflow de type agent ou responses | Itérations par asset accepté, temps jusqu’à validation |
| Variantes de campagne à grand volume | Mise en file d’attente, contrôle des coûts et format de sortie prévisible | Modèle batch ou job asynchrone | Coût par variante approuvée, temps d’attente dans la file, classe d’échec |
| Assistance interne au design | Gouvernance, contrôle d’accès et traçabilité de l’usage | Passerelle avec sous-clés et journaux | Dépenses par équipe, modèle, projet et environnement |
L’erreur consiste à choisir l’API de génération d’images dont la galerie d’exemples est la plus séduisante. La meilleure décision consiste à définir le workflow, choisir la surface d’API, établir les métriques de revue, puis seulement ensuite tester les modèles.
Ce qu’une API de génération d’images doit réellement faire
Pour une équipe en production, une API de génération d’images n’est pas seulement « prompt en entrée, image en sortie ». Elle doit prendre en charge une boucle opérationnelle reproductible :
- Accepter une entrée créative structurée provenant d’un utilisateur, d’un workflow ou d’un agent.
- Router la requête vers le bon modèle d’image ou fournisseur.
- Renvoyer les images dans le ratio d’aspect, le type de fichier, le niveau de qualité et la résolution requis.
- Gérer les prompts bloqués, les entrées mal formées, les erreurs du fournisseur et les timeouts.
- Conserver suffisamment de contexte de requête pour la revue, le débogage et le reporting des coûts.
- Permettre à l’équipe de comparer les modèles sans réécrire l’application à chaque fois.
C’est pourquoi les équipes devraient évaluer l’API de génération d’images comme une infrastructure, et non comme une fonctionnalité gadget. Une intégration en production doit résister aux révisions de prompts, aux règles de marque, au comportement de modération et aux questions financières.
Commencez par le cas d’usage, pas par le modèle
Avant de comparer les modèles, notez le type exact d’image que votre flux de travail doit créer. Un objectif vague comme « générer des images marketing » ne suffit pas. Un cas d’usage utile comporte des entrées, des contraintes, des critères de validation et un plan de repli.
Utilisez ce modèle :
| Champ | Exemple |
|---|---|
| Propriétaire du flux de travail | Growth, e-commerce, produit, support, design ops |
| Source d’entrée | Prompt humain, catalogue produit, ligne de CMS, ticket, tâche d’agent |
| Type de sortie | Image héro, scène produit, variante de publicité, miniature, diagramme, publication sociale |
| Dimensions requises | 1:1, 4:5, 16:9, 9:16, ou contraintes exactes en pixels |
| Entrées de référence | Photo de produit, guide de marque, image précédemment approuvée, capture d’écran |
| Critères de réussite | Aucun artefact évident, respect des règles de marque, préservation de la forme du produit, texte requis lisible |
| Critères de rejet | Détails du produit incorrects, sortie non sûre, texte illisible, visages ou mains déformés, mauvais ratio d’aspect |
| Propriétaire de la revue | Designer, marketeur produit, merchandiser, éditeur, opérateur QA |
| Contrainte de lancement | Coût maximal par ressource acceptée, objectif de latence, SLA d’approbation, exigence de revue juridique |
Cet exercice évite le mode d’échec courant dans lequel une équipe choisit un modèle impressionnant, puis découvre qu’il ne peut pas gérer de manière fiable la boucle de validation réelle.
Choisissez la bonne surface d’API
La plupart des équipes ont besoin de plus d’un modèle d’API de génération d’images. La documentation actuelle d’OpenAI sur la génération d’images distingue la génération d’images entre l’Image API pour la génération et les retouches directes, et la Responses API pour la génération d’images dans des flux conversationnels ou multi-étapes. La documentation de Google sur la génération d’images Gemini décrit Nano Banana comme la capacité native de génération d’images de Gemini, avec génération conversationnelle et édition sur des entrées texte, image, vidéo et mixtes.
Cette distinction est importante. Si votre produit n’a besoin que d’une seule image générée à partir d’un prompt, un point de terminaison d’image direct est plus simple. Si votre flux de travail nécessite des modifications itératives, des références téléversées ou un agent qui révise un visuel en plusieurs tours, un flux conversationnel ou multimodal peut mieux convenir.
Utilisez ce tableau de décision :
| Exigence | Meilleure solution |
|---|---|
| Générer une image à partir d’un seul prompt | Point de terminaison direct de génération d’images |
| Modifier une image existante avec un prompt | Point de terminaison de modification d’image ou modèle d’image multimodal |
| Utiliser plusieurs images de référence | Route d’image multimodale avec prise en charge explicite des références |
| Permettre aux utilisateurs d’itérer dans un flux de type chat | Workflow de type Responses ou de type conversation |
| Générer de nombreuses variantes à partir de lignes ou de tâches | Workflow par lots, asynchrone ou mis en file d’attente |
| Basculer entre fournisseurs pendant l’évaluation | Route passerelle avec contrat stable côté application |
| Permettre au service financier d’auditer les dépenses liées aux images | Passerelle ou plateforme avec journaux d’utilisation par requête |
La meilleure API de génération d’images pour votre équipe peut être une combinaison : des points de terminaison directs pour les tâches simples, des routes multimodales pour les modifications, et une couche passerelle pour le changement de modèle, la revue de l’utilisation et les contrôles d’équipe.
Un workflow de production pour les équipes
Voici le workflow opérationnel pratique que je recommande avant le lancement.
1. Définissez trois prompts de référence
Choisissez trois prompts qui représentent le travail réel :
- Prompt facile : quelque chose que le système doit exécuter rapidement et à faible coût.
- Prompt de marque : un prompt réaliste avec des contraintes de ton, de style, de produit ou de mise en page.
- Prompt difficile : un prompt avec des références, du rendu de texte, un ratio d’aspect strict ou une instruction en plusieurs étapes.
N’optimisez pas en fonction d’un seul prompt de démonstration esthétique. Un ensemble de tests utile pour une API de génération d’images devrait révéler quand le modèle est rapide, quand il est fidèle, et quand il nécessite une revue humaine.
2. Figez les exigences de sortie
Rédigez le contrat de sortie avant d’intégrer l’API :
- Ratio d’aspect ou dimensions exactes.
- Format de fichier.
- Niveau de qualité.
- Exigences concernant l’arrière-plan.
- Si la transparence est autorisée.
- Si la sortie peut contenir du texte lisible.
- Si la requête peut inclure des images de référence.
- Latence maximale acceptable.
- Coût maximal par image acceptée.
Ce contrat de sortie devient votre test de régression lorsque vous essayez de nouveaux modèles.
3. Séparez les échecs de prompt des échecs système
Une API de génération d’images peut échouer parce que la requête est techniquement invalide, que le fournisseur est indisponible, que le compte est soumis à une limite de débit, que le prompt est bloqué, ou que l’image générée ne respecte pas votre propre standard de revue. Traitez ces cas comme des classes d’échec différentes.
| Classe de défaillance | Exemple | Nouvelle tentative ? | Responsable |
|---|---|---|---|
| Requête invalide | Taille non prise en charge, fichier manquant, charge utile incorrecte | Non, corriger la charge utile | Ingénierie |
| Erreur du fournisseur ou du réseau | Timeout, 5xx, problème de service transitoire | Oui, avec backoff | Ingénierie |
| Quota ou limite de débit | Limite du fournisseur ou plafond du compte | Peut-être, après mise en file d'attente | Ingénierie ou ops |
| Blocage de sécurité | Prompt ou sortie rejeté | Pas de nouvelle tentative aveugle ; réviser le prompt | Produit ou responsable des politiques |
| Échec de la revue | Hors marque, mauvais objet, texte de mauvaise qualité | Générer un prompt révisé ou réacheminer | Responsable créatif |
Cette classification est importante, car les nouvelles tentatives aveugles peuvent gaspiller le budget. La documentation des images d'OpenAI, par exemple, recommande de traiter les échecs de génération d'images comme les autres erreurs d'API, d'enregistrer les identifiants de requête et de réessayer les défaillances transitoires plutôt que les erreurs de prompt que l'utilisateur peut corriger. Pour une mesure plus approfondie, associez ce flux de travail à des indicateurs de l'API de génération d'images.
4. Ajouter Tôt Une File De Revue Humaine
Même si votre objectif à long terme est l'automatisation, commencez par une file de revue. Stockez le prompt, le modèle, l'image générée, la classe de défaillance, l'identifiant de requête si disponible, le coût, la latence, la décision du réviseur et le motif du rejet.
Pour les 100 à 300 premières sorties réelles, votre objectif n'est pas l'automatisation complète. Votre objectif est de comprendre quels prompts, modèles, tailles et critères de revue sont corrélés avec des images acceptées.
5. Décidez Quand Router Ou Escalader
Toutes les images ne doivent pas utiliser le même modèle. Votre politique de routage peut être simple :
- Utilisez le modèle le plus rapide et le moins coûteux pour les brouillons et les miniatures internes.
- Utilisez un modèle plus puissant pour les éléments de marque finaux, les scènes de produit complexes ou les images avec du texte.
- Utilisez un modèle capable d'édition lorsque l'utilisateur fournit une image de référence.
- Utilisez un modèle avec un meilleur ancrage ou un support multimodal lorsque la demande dépend d'un contexte externe.
- Escaladez vers une revue humaine lorsque l'actif est destiné aux clients, réglementé, sensible à la marque ou coûteux à relancer.
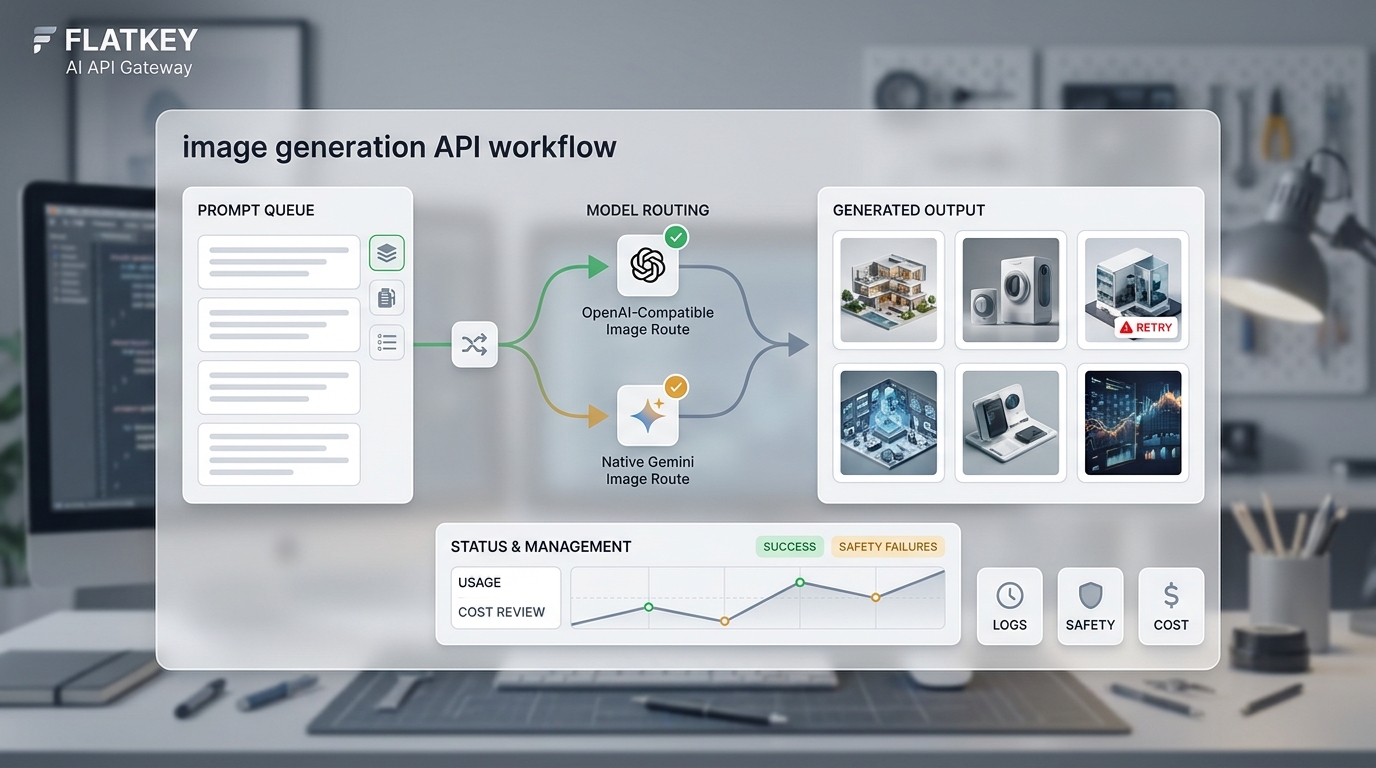
Flatkey est utile ici, car l'application peut conserver une surface d'intégration stable pendant que l'équipe change de modèles d'images et examine l'utilisation depuis un registre unique.
Exemple : Appeler Une Route D'Images Compatible Avec OpenAI Via Flatkey
Le guide de démarrage rapide de l'API Flatkey permet de pointer le SDK OpenAI vers https://router.flatkey.ai/v1 avec votre FLATKEY_API_KEY. Pour les routes de génération d'images directes exposées via une interface compatible avec OpenAI, gardez le contrat applicatif minimal et consignez le résultat.
import OpenAI from "openai";
import fs from "node:fs";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});

const result = await client.images.generate({
  model: "gpt-image-2",
  prompt: [
    "Créez une image héro 16:9 pour un lancement de SaaS B2B.",
    "Style : éditorial technique épuré.",
    "Évitez le texte d’interface minuscule et illisible.",
    "Laissez un espace négatif sûr pour un titre."
  ].join(" "),
  size: "1536x864",
});

const imageBase64 = result.data[0].b64_json;
fs.writeFileSync("hero.png", Buffer.from(imageBase64, "base64"));
Avant de déployer cela, ajoutez des contrôles de production :
- Validez la taille et le format demandés avant d’appeler l’API de génération d’images.
- Stockez la version du prompt, le modèle, la route, l’ID de requête, la latence et le coût.
- Ajoutez un champ de motif de rejet manuel.
- Traitez les prompts bloqués différemment des erreurs transitoires.
- Envoyez les ressources finales dans le même pipeline d’actifs que les images créées par des humains.
Exemple : utilisation d’une route d’image Gemini native
Certains flux de travail d’images sont mieux gérés via une route multimodale native. La documentation Gemini de Google décrit gemini-3.1-flash-image et les modèles Nano Banana associés pour la génération et l’édition d’images, y compris les workflows texte-et-image-vers-image. Pour les opérations créatives spécifiques au e-commerce, consultez le guide مرتبط à l’API de génération d’images IA pour les pipelines créatifs e-commerce.
La charge utile exacte dépend de votre passerelle et de la route du modèle, mais l’idée d’exploitation reste la même :
{
  "model": "gemini-3.1-flash-image",
  "input": [
    {
      "type": "text",
      "text": "Créez une scène produit carrée pour une tasse en céramique noire mate sur un bureau en béton. Préservez la forme de la tasse et laissez un espace net en haut à gauche."
    },
    {
      "type": "image",
      "mime_type": "image/png",
      "data": "<BASE64_REFERENCE_IMAGE>"
    }
  ],
  "response_format": {
    "type": "image",
    "image_size": "1K"
  }
}
Utilisez ce style lorsque l’API de génération d’images doit comprendre une image de référence, préserver un objet ou réviser un visuel existant. Le principal indicateur d’évaluation n’est pas « était-ce cool ? » L’indicateur est de savoir si le modèle a effectué la modification demandée tout en préservant les détails qui ne doivent pas changer.
Ce qu’il faut mesurer le premier mois
Si vous ne suivez que la dépense totale et le nombre total d’images, vous manquerez le véritable coût opérationnel. Suivez plutôt la sortie acceptée.
| Métrique | Pourquoi c’est important |
|---|---|
| Coût par image acceptée | Révèle le coût réel après les rejets, les tentatives répétées et les modifications |
| Respect du prompt | Montre si le modèle suit les contraintes requises |
| Taux de réussite des modifications | Mesure les workflows d’image de référence et de révision |
| Latence par route | Aide à distinguer les workflows de brouillon des workflows d’asset final |
| Taux de rejet lié à la sécurité | Montre où les prompts nécessitent des changements de politique ou d’UX |
| Taux de réessai par classe d’échec | Empêche les comportements de réessai inutiles |
| Temps de revue manuelle | Mesure le coût humain réel du workflow |
| Coût par équipe et par projet | Permet de relier l’examen financier à la responsabilité d’usage |
Les journaux d’utilisation de Flatkey sont particulièrement utiles à ce stade, car la même équipe peut examiner le modèle, le nombre de jetons, la latence et le coût après les requêtes. Pour les travaux liés à l’API de génération d’images, ajoutez vos propres données de décision accepté/rejeté à côté de ces journaux d’infrastructure. Si votre équipe standardise plus que les routes d’images, le guide de l’API IA unifiée montre comment conserver proprement l’URL de base élargie et la migration du SDK.
Planification des coûts sans approximation
La tarification de la génération d’images peut varier selon le modèle, le niveau de qualité, la résolution, le format de sortie et le fait qu’une requête inclue ou non des entrées d’image. Ne comparez pas les API uniquement sur le prix par image affiché le plus bas.
Utilisez cette estimation de lancement :
assets acceptés par mois
× nombre moyen de générations par asset accepté
× coût moyen du fournisseur ou du gateway par génération
+ surcharge de modification/image de référence
+ coût de stockage et de CDN
+ coût de la main-d’œuvre de revue
= coût mensuel estimé du workflow d’images
Par exemple, un workflow qui nécessite 1 000 images acceptées par mois et qui moyenne 2,4 générations par image acceptée représente en réalité une charge de 2 400 générations avant les modifications, le stockage et le temps de revue. C’est ce chiffre que votre évaluation de l’API de génération d’images devrait optimiser.
Le répertoire de modèles en temps réel de Flatkey est l’endroit approprié pour vérifier les modèles d’images actuellement disponibles et les prix par image avant une estimation de lancement. Utilisez la page de tarification et le répertoire de modèles au moment de la décision plutôt que de recopier un chiffre statique dans un document de planification.
Liste de contrôle sécurité et gouvernance
Les équipes testent souvent une API de génération d’images avec une seule clé partagée. C’est acceptable pour une exploration rapide, mais c’est faible en production. Avant le lancement, mettez en place ces contrôles :
- Utilisez des clés distinctes ou des sous-clés pour le développement, la préparation, la production et les agents.
- Définissez des plafonds budgétaires pour les expérimentations et les workflows hors production.
- Limitez les modèles que chaque environnement peut appeler.
- Journalisez les métadonnées des prompts sans stocker inutilement les données sensibles des clients.
- Conservez les images de référence téléchargées conformément à votre politique de rétention des données.
- Stockez les assets générés dans votre système d’assets habituel, et pas seulement dans les réponses de l’API.
- Examinez les exigences de licence, de marque, de confidentialité et de modération pour les images destinées aux clients.
- Ajoutez un interrupteur d’arrêt d’urgence pour les tâches à fort volume.
Si votre équipe utilise déjà Flatkey pour le texte, la vidéo ou les appels d’outils, la génération d’images peut partager le même schéma de gouvernance : un seul solde, des listes d’autorisation de modèles, des journaux d’utilisation et un historique des requêtes visible par la finance.
Grille d’évaluation interne
Utilisez une grille d’évaluation plutôt qu’un long débat sur la qualité subjective.
| Critère | Poids | Question de notation |
|---|---|---|
| Respect du prompt | 25% | L’image a-t-elle suivi les objets, la mise en page, le style et les exclusions requis ? |
| Fidélité à la référence | 20% | A-t-elle conservé les détails du produit, du personnage, de la marque ou de la capture d’écran lorsqu’ils étaient fournis ? |
| Vitesse de revue | 15% | À quelle vitesse un humain peut-il approuver ou rejeter le résultat ? |
| Coût par image acceptée | 15% | Quel est le coût réel après les rejets et les nouvelles tentatives ? |
| Fiabilité de la latence | 10% | La route reste-t-elle prévisible sous un volume de charge normal ? |
| Simplicité d’intégration | 10% | L’équipe peut-elle changer de modèle sans réécrire la logique de l’application ? |
| Adéquation à la gouvernance | 5% | L’utilisation, les budgets et les clés peuvent-ils être audités par le propriétaire ? |
Appliquez la grille à au moins deux routes de modèles et trois classes de prompts. Le gagnant devrait être la route qui produit de manière fiable des assets approuvés, et non celle qui présente l’échantillon isolé le plus impressionnant.
Quand une passerelle est utile
Une intégration directe au fournisseur suffit lorsqu’une équipe utilise un seul modèle d’image pour un seul workflow stable. Une passerelle commence à devenir importante lorsque l’API de génération d’images fait partie d’un système d’exploitation plus large :
- Le produit veut un modèle pour la génération dans l’application et le growth en veut un autre pour les publicités.
- Un agent a besoin, à partir du même solde, d’outils d’image, de texte, de navigateur et d’enrichissement.
- La finance veut une seule facture et une visibilité de l’utilisation au niveau des requêtes.
- L’ingénierie veut évaluer de nouveaux modèles sans remplacer le code du SDK.
- Les opérations ont besoin de budgets, de listes d’autorisation de modèles et d’une propriété par clé.
- La fiabilité compte parce que les tâches créatives sont liées à des dates de lancement.
Flatkey est conçu pour cette couche opérationnelle multi-modèles et multi-outils. L’avantage pratique n’est pas que chaque requête d’image doive être routée automatiquement. L’avantage est que votre équipe peut faire du choix du modèle une politique opérationnelle plutôt qu’une dépendance codée en dur.
Liste de contrôle de mise en œuvre
Avant de choisir ou de lancer une API de génération d’images, assurez-vous que chaque élément a un responsable :
- Trois prompts « or » représentant des workflows faciles, sensibles à la marque et difficiles.
- Contrat de sortie pour la taille, le format, la qualité, l’arrière-plan et les entrées de référence.
- Liste restreinte de modèles pour les tâches de brouillon, finales, de retouche et d’images à fort contexte.
- Taxonomie des erreurs pour requête invalide, problème transitoire du fournisseur, quota/limite de débit, blocage de sécurité et échec de revue.
- Politique de nouvelle tentative qui évite les retries aveugles pour les erreurs de prompt ou de politique.
- File d’attente de revue avec prompt, modèle, sortie, décision, raison, latence et coût.
- Estimation des coûts basée sur les éléments acceptés, et non sur le nombre brut de générations.
- Stratégie clé pour les environnements, les équipes et les agents.
- Cadence de revue des journaux d’utilisation pendant les 30 premiers jours.
- Responsable interne des modèles de prompt et des règles de marque.
Questions fréquemment posées
Qu’est-ce qu’une API de génération d’images ?
Une API de génération d’images est une interface programmatique qui permet à une application de générer ou de modifier des images à partir de prompts textuels, d’entrées d’images, ou d’une combinaison des deux. En production, l’API doit également gérer les erreurs, le suivi des coûts, les comportements de sécurité, les métadonnées de revue et le stockage des assets.
Quelle est la meilleure API de génération d’images pour les équipes ?
La meilleure API de génération d’images dépend du workflow. Les endpoints d’images directs sont généralement les plus simples pour une génération par prompt. Les parcours multimodaux ou conversationnels sont meilleurs pour les retouches d’images, les images de référence et les workflows itératifs. Une passerelle est utile lorsque l’équipe a besoin de plusieurs modèles, d’un ledger unique, d’une gouvernance partagée et d’un changement de modèle plus simple.
Comment les équipes devraient-elles comparer les outils d’API de génération d’images ?
Comparez les outils selon le coût par image acceptée, le respect du prompt, le taux de réussite des retouches, la latence, le taux de rejet par sécurité, le comportement de retry, les contrôles de gouvernance et l’effort d’intégration. Ne les comparez pas uniquement sur la qualité de la galerie d’exemples ou sur le prix affiché par image.
Une API compatible OpenAI fonctionne-t-elle pour la génération d’images ?
Oui, lorsqu’une passerelle ou un fournisseur expose le modèle d’image via une route d’image compatible OpenAI. Pour des workflows d’images multimodaux plus complexes, une route native du fournisseur peut exposer des capacités qu’une couche de compatibilité générique ne couvre pas entièrement. Testez à la fois le contrat de l’endpoint et le comportement du modèle avant le lancement.
Comment Flatkey aide-t-il avec les opérations d’API de génération d’images ?
Flatkey offre aux équipes une clé unique, un solde partagé, un répertoire de modèles, un routage compatible OpenAI lorsqu’il est pris en charge, et des journaux d’utilisation pour la revue. Cela facilite l’évaluation des modèles d’images, le contrôle des dépenses et le raccordement de l’utilisation de l’API de génération d’images à la même couche opérationnelle que les appels d’outils texte, vidéo et agents.
Étape suivante
Si vous évaluez une API de génération d’images, commencez par le modèle de workflow et la grille de notation ci-dessus. Exécutez ensuite vos trois prompts « or » sur les modèles que vous envisagez et comparez le coût par image acceptée, la latence, le temps de revue et la classe d’échec.
Avec Flatkey, vous pouvez tester des modèles d’images via un seul compte, consulter l’utilisation en un seul endroit et garder le code de votre application centré sur le workflow plutôt que sur la prolifération des fournisseurs.