Comment utiliser une API IA unifiée en 2026
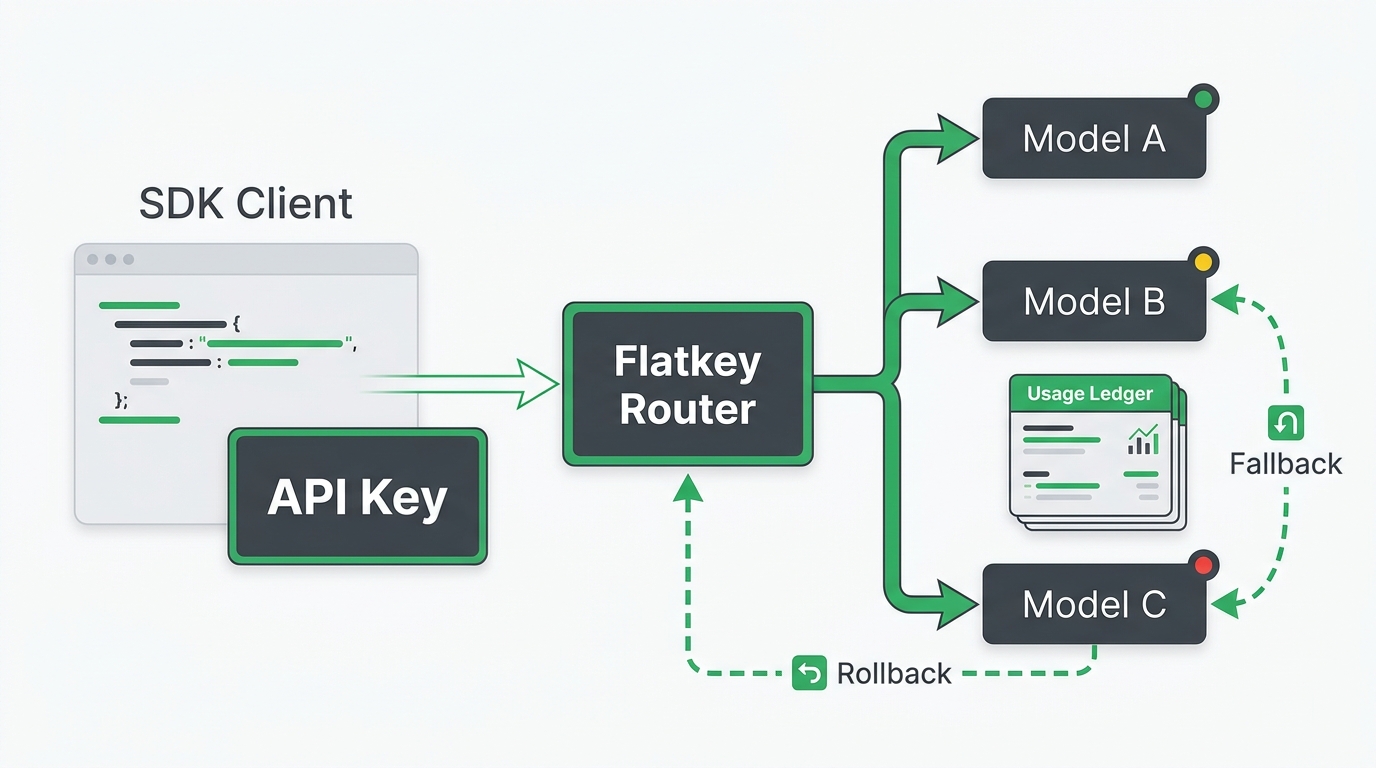
Une API IA unifiée permet à votre application d'appeler plusieurs fournisseurs de modèles IA via une seule couche d'accès, au lieu d'intégrer chaque fournisseur séparément. En 2026, cela signifie généralement une seule clé API, une seule URL de base compatible OpenAI, un seul catalogue de modèles et un seul endroit pour consulter l'utilisation, les coûts et les échecs.
Cela paraît simple, mais les détails d'implémentation comptent. Une API IA unifiée n'est utile que si elle préserve votre flux de travail SDK actuel, rend le changement de modèle plus sûr et offre aux équipes d'ingénierie et de finance la même vue de ce qui s'est passé après chaque requête.
Ce guide montre un parcours de déploiement pratique : configurer la clé, pointer un client compatible OpenAI vers un endpoint unifié, choisir un modèle, exécuter une première requête, vérifier le journal d'utilisation, puis décider ce qui doit passer derrière la couche unifiée et ce qui doit rester directement chez un fournisseur.
Réponse rapide : le flux de travail de l'API IA unifiée
Utilisez une API IA unifiée lorsque votre équipe doit tester ou exécuter plusieurs modèles sans créer une nouvelle intégration, une nouvelle piste de facturation et un nouveau processus de gestion des clés pour chaque fournisseur.
Le flux de travail de base est le suivant :
- Créez une seule clé API pour la passerelle unifiée.
- Stockez-la comme variable d'environnement.
- Définissez l'URL de base de votre client sur le endpoint de la passerelle.
- Envoyez une requête normale de chat, de réponses, d'embeddings, d'image ou de vidéo.
- Choisissez le modèle avec le paramètre
model. - Vérifiez les journaux d'utilisation pour les jetons, le modèle, le coût, le statut et la latence.
- Ajoutez des règles de basculement, de quota et de routage seulement après que le premier parcours soit observable.
Pour Flatkey, l'URL de base REST compatible OpenAI est :
https://router.flatkey.ai/v1L'important n'est pas que chaque modèle se comporte de manière identique. L'important est que votre application dispose d'une seule surface d'intégration vérifiable tout en continuant à choisir le bon modèle pour chaque charge de travail.
Quand une API IA unifiée a du sens
Une API IA unifiée est particulièrement utile lorsque votre équipe ressent déjà la surcharge liée à la prolifération des fournisseurs.
Utilisez-en une lorsque :
| Situation | Pourquoi une API IA unifiée aide |
|---|---|
| Vous testez GPT, Claude, Gemini, DeepSeek, Qwen ou des modèles d'image/vidéo dans le même produit | Les changements de modèle peuvent se faire derrière une seule couche d'intégration. |
| Vous utilisez déjà la forme du SDK OpenAI | La migration peut commencer par un changement d'URL de base et de clé plutôt que par une réécriture complète. |
| La finance demande une vue unique de l'utilisation et de la facturation | Les requêtes peuvent être examinées depuis un seul tableau de bord au lieu de plusieurs consoles de fournisseurs. |
| La plateforme a besoin de clés et de quotas par environnement | La propriété des clés, les plafonds de dépenses et les règles de routage peuvent être centralisés. |
| La fiabilité est importante entre plusieurs fournisseurs | Le basculement et les vérifications d'état peuvent être gérés comme une politique d'exploitation plutôt que par du code improvisé. |
Conservez des comptes directs chez les fournisseurs lorsqu'un flux de travail dépend d'une fonctionnalité native du fournisseur que la passerelle unifiée n'expose pas, lorsque les achats exigent un contrat direct, ou lorsque votre produit n'utilise réellement qu'un seul fournisseur.
Étape 1 : Choisissez la charge de travail avant de choisir le fournisseur
Ne commencez pas par demander : "Quel modèle est le meilleur ?" Commencez par noter la charge de travail.
Utilisez un petit tableau comme celui-ci :
| Charge de travail | Risque pour l’utilisateur | Candidats modèles | À vérifier impérativement |
|---|---|---|---|
| Réponse du support client | Explication incorrecte de la politique | Modèle de chat rapide, modèle de raisonnement | Précision, latence, coût par ticket résolu |
| Assistant de revue de code | Bug manqué ou retour bruyant | Modèle de codage, modèle de raisonnement | Taux de détection des bugs, qualité des modifications, comportement de repli |
| Génération d’images produit | Résultat créatif médiocre | Modèle de génération d’images | Coût par image acceptée, contrôles de prompt, voie de modération |
| Agent de recherche | Réponse lente ou incomplète | Modèle de raisonnement plus outils | Accès aux outils, traçabilité, gestion des délais d’attente |
Cette étape évite l’erreur la plus courante avec une API IA unifiée : traiter la passerelle comme un simple sélecteur aléatoire de modèles. Une bonne implémentation relie toujours les charges de travail à des responsables, à des contrôles qualité et à des règles de repli.
Étape 2 : Créer et stocker la clé API
Create the key in the gateway console and store it outside source control.
For Flatkey, create a key in the console and store it as FLATKEY_API_KEY :
export FLATKEY_API_KEY="sk-fk-your-key"Use separate keys for development, staging, and production. That gives you cleaner logs and safer revocation if a key leaks.
Recommended key naming:
| Environment | Example key name | Purpose |
|---|---|---|
| Development | dev-local-ai-tests | Local testing with low spend limits |
| Staging | staging-model-routing | Pre-production validation |
| Production | prod-customer-chat | Live user traffic |
| Agent workflow | prod-research-agent | Autonomous or scheduled agent calls |
Une API IA unifiée doit réduire la prolifération des identifiants, pas la masquer. Gardez la propriété des clés explicite.
Étape 3 : Effectuer la première requête avec cURL
Start with cURL before changing your app. It proves the key, endpoint, model ID, and request shape work independently from your framework.
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -d '{
    "model": "gpt-4o-mini",
    "messages": [
      {
        "role": "user",
        "content": "Write one sentence explaining what a unified AI API does."
      }
    ],
    "max_tokens": 120
  }'
Avant d’utiliser un modèle en production, confirmez l’identifiant exact du modèle dans le répertoire de modèles actuel ou la liste des modèles de l’API. La disponibilité des modèles, les alias, les tarifs et les points de terminaison pris en charge peuvent évoluer rapidement sur le marché de l’IA.
Étape 4 : Modifier l’URL de base du SDK OpenAI
Many teams can test a unified AI API with the OpenAI Python or Node.js SDK they already use. The core migration is the API key plus the base URL.
Python:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "user", "content": "Résumez ce retour produit en trois puces."}
    ],
    max_tokens=300,
)

print(response.choices[0].message.content)
Node.js :
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});

const response = await client.chat.completions.create({
  model: "gpt-4o-mini",
  messages: [
    { role: "user", content: "Résumez ce retour produit en trois puces." },
  ],
  max_tokens: 300,
});

console.log(response.choices[0].message.content);
L’objectif n’est pas de supprimer toutes les différences entre fournisseurs. L’objectif est de maintenir stable l’enveloppe applicative tandis que le choix du modèle passe dans un paramètre contrôlé.
Étape 5 : Choisissez les modèles selon une politique, pas au hasard
Une API IA unifiée facilite le changement de modèle. Cela peut aider ou nuire selon que vous définissez ou non des règles de sélection.
Utilisez un tableau de politique simple :
| Route | Modèle principal | Modèle de secours | Règle d’approbation |
|---|---|---|---|
support_summary | Modèle de chat rapide et peu coûteux | Modèle de raisonnement plus grand | Le product owner peut changer après validation d’un échantillon QA |
code_review | Modèle axé sur le code | Modèle de raisonnement généraliste | Approbation du responsable ingénierie requise |
image_creative | Modèle d’image | Aucun basculement automatique | Le responsable créatif approuve la qualité de sortie |
research_agent | Modèle de raisonnement | Modèle à latence plus faible | Approbation des opérations requise si le secours modifie la profondeur de la réponse |
Le nom du modèle ne devrait jamais être une chaîne magique dispersée dans toute la base de code. Placez-le dans la configuration, associez-le à une charge de travail, et journalisez à la fois le modèle demandé et le modèle final utilisé.
Étape 6 : Vérifiez les journaux d’utilisation après le premier appel
Ne déclarez pas la migration terminée lorsque l’API renvoie 200. Vérifiez la trace d’utilisation et de coût.
Pour Flatkey, le tableau de bord Usage affiche des champs au niveau de la requête tels que l’horodatage, le modèle, les jetons d’entrée, les jetons de sortie, le coût déduit, la clé API et le statut. Après votre première requête, vérifiez :
| Vérification | Ce que vous devriez voir |
|---|---|
| Modèle | L’ID du modèle que vous avez demandé ou le modèle final routé |
| Jetons | Les décomptes de jetons d’entrée et de sortie |
| Coût | Le montant déduit du solde pour cette requête |
| Clé | La clé d’environnement utilisée par la requête |
| Statut | État de succès, d’erreur ou de limitation de débit |
| Latence | Si le premier test se situe dans la plage attendue |
C’est là qu’une API IA unifiée devient utile sur le plan opérationnel. Les équipes produit, ingénierie et finance peuvent examiner la même trace de requête au lieu de recouper des captures d’écran provenant de plusieurs tableaux de bord fournisseurs.
Étape 7 : Ajoutez un mécanisme de secours seulement après pouvoir le mesurer
Le fallback n’est pas automatiquement une bonne chose. Il l’est lorsqu’il permet de rétablir les requêtes sans dégrader la qualité des réponses, enfreindre une politique ou masquer les coûts.
Avant d’activer le fallback, définissez :
| Question | Pourquoi c’est important |
|---|---|
| Quelles erreurs déclenchent le fallback ? | La limitation de débit, le délai d’attente, la panne du fournisseur et les échecs liés à la politique de contenu sont des événements différents. |
| Quel modèle est autorisé comme solution de secours ? | Un modèle de fallback peut modifier la qualité, la latence, le coût ou la posture de conformité. |
| Qui approuve la route ? | La politique de fallback est un comportement de production, pas seulement une commodité pour les développeurs. |
| Qu’est-ce qui est journalisé ? | Vous devez disposer du modèle demandé, du modèle final, du nombre de tentatives, du statut final, des jetons, du coût et de la latence. |
| Quel est le plan de retour arrière ? | Si le fallback provoque de mauvaises réponses, vous avez besoin d’un moyen rapide pour le désactiver. |
La documentation des routeurs open source et commerciaux met souvent l’accent sur le routage, l’ordre des fournisseurs, l’équilibrage de charge et le comportement de fallback. Ces fonctionnalités sont importantes, mais votre déploiement doit mesurer le taux de sortie acceptée, le coût par sortie acceptée, la latence p95 et le taux de décalage du fallback.
Étape 8 : conserver les exceptions directes au fournisseur
Le meilleur déploiement d’une API IA unifiée autorise toujours des exceptions.
Utilisez un accès direct au fournisseur lorsque :
- une fonctionnalité spécifique à un modèle n’est pas exposée par la couche unifiée
- le fournisseur exige un format de requête natif pour une fonctionnalité critique au lancement
- les politiques d’achats, de conformité ou de résidence des données exigent un chemin direct
- une équipe a besoin de journaux ou de contrôles natifs du fournisseur pour un workflow réglementé
- le chemin unifié échoue à votre test d’acceptation de qualité, de latence ou de coût
Cela rend l’architecture crédible. La couche unifiée devient la valeur par défaut pour un travail multi-modèles répétable, et non une abstraction imposée pour chaque requête possible.
Liste de contrôle de mise en œuvre
Utilisez cette liste de contrôle avant de placer une charge de travail derrière une API IA unifiée :
- Le responsable de la charge de travail est nommé.
- Le modèle principal et le modèle de secours sont documentés.
- La clé API est stockée dans un gestionnaire de secrets ou une variable d’environnement.
- Les clés de développement, de préproduction et de production sont séparées.
- L’URL de base est configurée dans un seul wrapper client.
- L’ID du modèle est piloté par la configuration, et non codé en dur dans les fichiers.
- La première requête cURL réussit.
- La requête SDK réussit en préproduction.
- Les journaux d’utilisation affichent le modèle, les jetons, le coût, la clé, le statut et la latence.
- Le coût par sortie acceptée est mesuré par rapport au chemin direct du fournisseur.
- Le comportement de fallback est testé avec un cas d’échec non production.
- Le plan de retour arrière est documenté.
Ce qu’il faut mesurer pendant les 30 premiers jours
Le premier mois doit permettre de déterminer si l’API IA unifiée améliore les opérations, et pas seulement si les requêtes s’exécutent.
Suivez :
| Métrique | Pourquoi c’est important |
|---|---|
| Taux de sortie acceptée | Mesure les réponses utilisables, pas seulement les appels HTTP réussis |
| Coût par sortie acceptée | Normalise le prix par rapport à la qualité et aux tentatives |
| Latence p95 par charge de travail | Empêche qu’un chemin masque une expérience utilisateur lente |
| Taux de récupération du fallback | Indique si le fallback permet réellement d’économiser des requêtes |
| Taux de divergence du fallback | Détecte les réponses de secours qui passent techniquement mais échouent en qualité |
| Dépense au niveau de la clé par environnement | Sépare les expérimentations de développement de l’utilisation en production |
| Temps d’ajout d’un nouveau modèle | Mesure si la couche unifiée réduit la friction opérationnelle |
Si ces métriques s’améliorent, déployez la couche unifiée sur une autre charge de travail. Si ce n’est pas le cas, conservez le chemin direct du fournisseur pour ce flux de travail et utilisez le résultat comme contrainte pour le prochain test.
Adaptation Flatkey : une clé, une URL de base, une surface de revue
Flatkey est conçu pour les équipes qui souhaitent utiliser une clé et une URL de base compatible OpenAI pour de nombreux flux de travail liés aux modèles et aux outils. La documentation actuelle de Flatkey décrit l’accès à l’API REST à l’adresse https://router.flatkey.ai/v1, l’authentification Bearer, la compatibilité avec le SDK OpenAI, la sélection du modèle via le paramètre model, ainsi que des journaux d’utilisation pour la revue du modèle, des jetons, de la latence, des coûts, des clés et des statuts.
Cela fait de Flatkey une solution pratique lorsque votre équipe souhaite le flux de travail API IA unifiée sans réécrire chaque enveloppe de requête. Commencez par une charge de travail de préproduction, validez le modèle exact dans le répertoire des modèles actuel, vérifiez le journal d’utilisation, puis décidez si le routage, le fallback, les quotas ou les contrôles d’équipe doivent venir ensuite.
Pour des détails d’implémentation proches, lisez le guide de démarrage rapide de l’API Flatkey, la checklist de migration vers une passerelle d’API compatible OpenAI et le cadre d’évaluation des outils de l’API de routage IA.
Questions fréquentes
Qu’est-ce qu’une API IA unifiée ?
Une API IA unifiée est une couche d’accès unique pour appeler plusieurs modèles ou outils d’IA pris en charge via une authentification partagée, une configuration de point de terminaison, la sélection du modèle et la revue de l’utilisation.
Une API IA unifiée est-elle la même chose qu’une passerelle d’API IA ?
Elles se recoupent. Une passerelle d’API IA met généralement l’accent sur le routage, les contrôles, le fallback et l’observabilité. Une API IA unifiée met l’accent sur une surface d’intégration unique à travers plusieurs modèles ou fournisseurs. De nombreux produits combinent les deux.
Puis-je utiliser une API IA unifiée avec le SDK OpenAI ?
Oui, lorsque la passerelle expose une API compatible OpenAI. Dans ce cas, vous définissez généralement la clé API, modifiez l’URL de base du SDK et choisissez le modèle cible avec le paramètre model.
Une API IA unifiée supprime-t-elle les différences propres aux fournisseurs ?
Non. Le comportement des modèles, les limites de contexte, les paramètres pris en charge, la latence, la tarification et le comportement des politiques peuvent toujours différer. Une API IA unifiée réduit les coûts d’intégration et d’exploitation, mais vous avez toujours besoin d’une QA spécifique à chaque charge de travail.
Quand ne devrais-je pas utiliser une API IA unifiée ?
Évitez de faire passer un workflow derrière une couche unifiée lorsqu’il dépend de fonctionnalités natives du fournisseur, d’un approvisionnement direct strict auprès du fournisseur, de contrôles de conformité spécialisés ou d’optimisations propres à un seul fournisseur que la passerelle ne peut pas exposer.
Synthèse finale
Une API IA unifiée est utile en 2026 lorsqu’elle offre à votre équipe un moyen plus simple d’exécuter plusieurs modèles d’IA, de gérer les clés, d’inspecter l’utilisation et de modifier les routes sans réécrire le code de l’application. Le déploiement le plus sûr est ciblé : choisissez une charge de travail, remplacez l’URL de base en préproduction, vérifiez la trace des requêtes, mesurez la qualité et le coût, puis étendez-vous uniquement là où la couche unifiée réduit clairement le travail opérationnel.
Si vous évaluez Flatkey pour ce workflow, commencez par le répertoire des modèles, la page tarifaire et le guide de démarrage rapide de l’API, puis exécutez une requête de préproduction via https://router.flatkey.ai/v1 avant de modifier le trafic de production.