
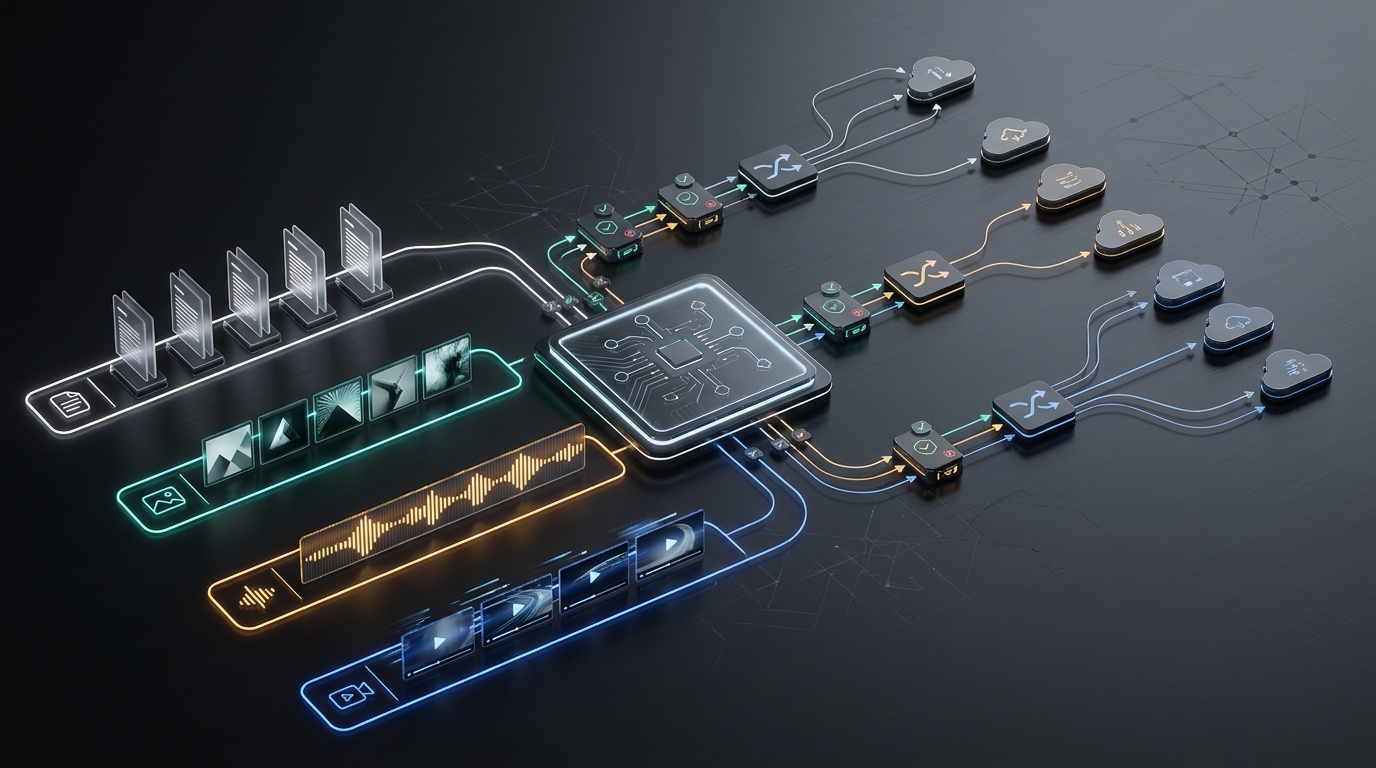
Le routage de secours pour les API LLM est simple lorsque chaque requête renvoie du texte. Si le route primaire expire, vous réessayez une fois, passez à un modèle de secours, validez le schéma et consignez la raison.
Cette logique s’effondre lorsque le même produit route également la génération d’images, la transcription audio, la sortie vocale et la génération vidéo. Un secours sûr pour l’extraction JSON n’est pas automatiquement sûr pour les visuels de marque. Un secours speech-to-text n’est pas la même chose qu’un secours text-to-speech. Un secours vidéo peut créer des dépenses en double, de la confusion dans les files d’attente, ou une sortie qui nécessite encore une validation humaine.
Ce guide transforme Fallback Routing for LLM APIs: Multimodal Agent Routing for Text, Image, Audio, and Video en un playbook de mise en œuvre pour les équipes produit IA. L’objectif n’est pas de choisir un modèle universel. L’objectif est de rendre explicites le choix de la route, la vérification, le secours et la revue des coûts pour chaque modalité que votre agent touche.
Au 12 septembre 2026, les pages publiques en direct de Flatkey présentent le produit autour d’une clé, un solde, une facture, plus de 100 modèles IA officiels, plus de 1 000 outils, une configuration compatible OpenAI, des journaux d’utilisation et un basculement automatique. Les surfaces publiques des modèles et des tarifs de Flatkey exposent également des routes de modèles orientées texte, image, audio et vidéo. Considérez ces pages en direct comme le point de contrôle commercial actuel avant le déploiement, car la disponibilité des modèles, les prix et l’état des routes peuvent changer.
Réponse rapide : qu’est-ce qui change dans le routage de secours multimodal ?
Dans les systèmes uniquement textuels, le secours pose généralement une seule question : « Une autre route peut-elle produire une réponse équivalente ? »
Dans les systèmes multimodaux, le routage de secours pour les API LLM doit poser quatre questions :
- Quel artefact est produit ? Le texte, l’image, l’audio et la vidéo ne partagent pas une seule norme de qualité.
- Comment l’artefact est-il vérifié ? Un parseur JSON, un relecteur visuel, un vérificateur de transcription et une file d’approbation vidéo sont des systèmes de vérification différents.
- Quelle défaillance est réellement récupérable ? Les limites de débit, les délais d’attente, les entrées invalides, les rejets de sécurité et les sorties de mauvaise qualité nécessitent des actions différentes.
- Le secours peut-il préserver le contrat ? Une route de secours n’est sûre que lorsqu’elle préserve la modalité, la forme de sortie, le budget de latence, le plafond de coût et le chemin de revue.
La règle pratique est simple : le secours reste à l’intérieur de la classe de workflow, sauf si une couche humaine ou de politique approuve explicitement le passage.
Pourquoi les réessais génériques échouent pour le texte, l’image, l’audio et la vidéo
Les réessais génériques traitent chaque requête échouée comme un problème de transport. C’est trop superficiel pour le routage d’agents multimodaux.
| Modalité | Forme d’échec courante | Pourquoi une nouvelle tentative générique est risquée |
|---|---|---|
| Texte | Délai d’attente, limite de débit, échec d’analyse, incompatibilité d’appel d’outil, réponse de faible qualité | Réessayer peut être sans risque, mais changer de modèle peut rompre les schémas, les citations, les outils ou le ton. |
| Image | Blocage de sécurité, mauvais ratio d’aspect, décalage de marque, faible fidélité, mauvaise conformité à l’édition | Un autre modèle d’image peut renvoyer un fichier valide qui échoue quand même à la revue créative. |
| Audio | Format non pris en charge, transcription médiocre, mauvaise langue, voix non conforme, pic de latence | La transcription, la traduction et la sortie vocale sont des tâches distinctes avec des règles de repli distinctes. |
| Vidéo | Longue file d’attente, tâche échouée, ressource expirée, mouvement incohérent, sortie rejetée coûteuse | Soumettre à nouveau à l’aveugle peut créer des tâches en double, des dépenses en double et davantage d’éléments à examiner. |
Le routeur doit savoir si un échec est un événement de service récupérable, une requête invalide, un résultat de sécurité ou de politique, ou un manque de qualité. Ces catégories entraînent des actions différentes.
Commencez par les classes de routage, pas par les noms de modèle
Le routage de secours le plus sûr pour les API LLM commence par les classes de routage. Les modèles peuvent entrer et sortir d’une classe selon l’évolution de la disponibilité et de la qualité ; la politique de flux de travail doit rester stable.
| Classe de routage | Tâches principales | Classe de vérification | Comportement de secours par défaut |
|---|---|---|---|
| Raisonnement textuel | Extraction, classification, résumé, codage, sortie structurée, appels d’outils | Vérifications de schéma, tests d’analyse, échantillonnage par grille d’évaluation, réussite des outils | Le repli automatique peut être autorisé lorsque la solution de secours préserve la forme de la réponse et le comportement des outils. |
| Compréhension visuelle | Analyse d’image, revue de documents, interprétation de captures d’écran | Vérifications de la sortie textuelle plus couverture de l’entrée visuelle | Repli vers une autre voie de raisonnement capable de traiter la vision, pas vers une voie de génération d’images. |
| Génération ou édition d’images | Nouvelles images, retouches, variantes de produits, brouillons créatifs | Contrôle qualité visuel, vérifications de marque, revue du modèle de prompt | Repli uniquement vers une voie d’image approuvée avec un ratio d’aspect, un style et des règles de revue correspondants. |
| Entrée audio | Transcription, traduction, résumés de réunions, contrôle qualité d’appels | Vérifications de précision de la transcription, vérifications de langue, revue des horodatages | Repli vers une autre voie de transcription ou de compréhension audio avec les mêmes limites d’entrée. |
| Sortie audio | Synthèse vocale, réponse d’agent vocal, narration | Contrôle qualité de lecture, politique vocale, budget de latence | Repli vers une voie vocale approuvée ; la garder séparée du repli de transcription. |
| Génération vidéo | Texte vers vidéo, image vers vidéo, clips d’aperçu, contenus créatifs | Approbation humaine, vérifications de durée/fidélité, surveillance de la file d’attente | Conserver un repli étroit ; souvent renvoyer vers une revue manuelle plutôt que de créer automatiquement une autre tâche. |
Cette carte des routes par classe évite une erreur courante : considérer « modèle multimodal » comme un seul ensemble de capacités. Un modèle qui accepte des images pour l’analyse ne génère pas nécessairement des images. Un modèle qui comprend l’audio n’est pas automatiquement un modèle vocal de production. Un modèle capable de produire une vidéo dans une démo n’est pas automatiquement sûr pour une automatisation destinée aux clients.
Utilisez une matrice de décision de secours avant d’écrire du code
Une matrice de décision fournit aux équipes produit, ingénierie et opérations une politique commune. Commencez avec la matrice ci-dessous et remplacez les exemples par vos propres modèles, fournisseurs et règles d’approbation.
| Condition | Action texte | Action image | Action audio | Action vidéo |
|---|---|---|---|---|
| Délai d’attente de la route principale avant le début de la sortie | Réessayer dans la limite du budget, puis basculer vers la route texte approuvée | Réessayer une fois si aucun actif n’a été créé, puis basculer vers la route image approuvée | Réessayer ou basculer au sein du même type de tâche audio | Vérifier d’abord l’état de la tâche ; ne créez pas de tâche en double tant que l’état d’origine n’est pas connu. |
| Erreur de limite de débit ou de capacité | Basculez lorsque la solution de secours respecte le schéma et les limites de coût | Basculez lorsque la solution de secours respecte les limites de prompt, de taille et de revue | Basculez lorsque la solution de secours prend en charge le même format de fichier et la même langue | Basculez uniquement si le coût du doublon et le comportement de file d’attente sont acceptables. |
| Requête invalide ou entrée non prise en charge | Arrêter et corriger la requête | Arrêter et corriger le prompt, le type d’entrée, la taille ou le format | Arrêter et corriger le format multimédia, la durée, la langue ou la fréquence d’échantillonnage | Arrêter et corriger la durée, le média de référence, le prompt ou les champs de l’endpoint. |
| Rejet lié à la sécurité ou à la politique | Ne masque pas le rejet avec une solution de secours | Ne contournez pas la politique avec un autre modèle | Ne contournez pas la politique avec un autre fournisseur audio | Ne contournez pas la politique avec un autre fournisseur vidéo. |
| La sortie échoue à la vérification automatisée | Basculez si le contrat peut être vérifié par machine | Envoyer en revue visuelle ou régénérer selon la politique de route approuvée | Envoyer en revue de transcript/lecture ou basculer à l’intérieur du même type de tâche | Envoyer en revue humaine ; utilisez des règles de régénération, pas une bascule aveugle. |
| Une sortie de streaming partielle a déjà atteint l’utilisateur | En général, arrêter et réconcilier ; éviter un changement de modèle transparent | Sans objet pour la plupart des routes image | Arrêter et réconcilier l’état visible par l’utilisateur | Ne basculez pas de manière invisible après l’existence d’un état de tâche visible. |
| Un appel d’outil a peut-être créé des effets de bord | Réconcilier l’idempotence avant de réessayer ou de basculer | Réconcilier toute écriture d’actif/de stockage | Réconcilier l’état du transcript, de l’appel ou de la session vocale | Réconcilier d’abord l’ID de tâche, le stockage, la facturation et l’état d’approbation. |
Cette matrice est le principal atout de valeur de l’article. Elle transforme le routage de secours pour les API LLM d’une réflexion après coup en ingénierie en une politique qui peut être examinée avant que le trafic de production ne bascule.
Une architecture de référence pour le routage d’agents multimodaux
Un routeur de production n’a pas besoin d’être compliqué, mais il doit avoir des frontières claires.
flowchart LR
    A[Demande de l’agent] --> B[Classer le flux de travail]
    B --> C[Sélectionner l’itinéraire principal]
    C --> D[Appeler le fournisseur ou la passerelle]
    D --> E[Vérifier l’artefact]
    E -->|réussi| F[Retourner et journaliser]
    E -->|échec réessayable| G[Politique de repli]
    E -->|politique ou entrée non valide| H[Arrêter avec une erreur exploitable]
    G --> I[Itinéraire de secours approuvé]
    I --> D
    G --> J[Examen humain ou file manuelle]
Les éléments clés sont :
- Classificateur de flux de travail : étiquette la tâche comme texte, vision, génération d’images, entrée audio, sortie audio ou génération vidéo avant la sélection de l’itinéraire.
- Registre des capacités : enregistre quels itinéraires prennent en charge chaque modalité, endpoint, format d’entrée, forme de sortie, contexte maximal, comportement de streaming et classe de coût.
- Politique de repli : définit les erreurs réessayables, les sauvegardes autorisées, les règles anti-contournement et le nombre maximal de tentatives.
- Couche de vérification : contrôle l’artefact avant de le renvoyer à l’utilisateur ou de le transmettre en aval.
- Journal et observabilité : consigne le modèle, l’itinéraire, le propriétaire, l’état, la raison du repli, la latence, l’utilisation, le coût et le résultat de l’examen.
Flatkey peut se situer dans la couche fournisseur-ou-passerelle lorsqu’une équipe souhaite un routeur compatible OpenAI, un solde partagé et un seul endroit pour examiner les itinéraires de modèles pris en charge. Votre application conserve la politique : quelle classe de modalité est autorisée à basculer en repli, quand arrêter et quand un humain doit décider.
Définir la politique comme des données
Gardez la politique de routage hors des instructions if dispersées. Un petit objet de données est plus facile à examiner et plus sûr à modifier.
{
  "workflow": "support_ticket_with_screenshot",
  "route_class": "vision_understanding",
  "primary_model": "primary-vision-reasoning-route",
  "fallback_models": ["backup-vision-reasoning-route"],
  "fallback_on": ["timeout_before_output", "rate_limit", "upstream_5xx"],
  "do_not_fallback_on": ["safety_rejection", "invalid_input", "partial_stream_sent"],
  "verification": {
    "type": "structured_text",
    "required_fields": ["summary", "severity", "evidence"]
  },
  "max_attempts": 2,
  "max_incremental_cost_usd": 0.05,
  "log_fields": [
    "request_id",
    "workspace_id",
    "route_class",
    "model",
    "fallback_reason",
    "latency_ms",
    "cost_usd",
    "verification_status"
  ]
}
La même structure peut représenter des flux de travail multimédias :
{
  "workflow": "aperçu vidéo produit",
  "route_class": "génération vidéo",
  "primary_model": "primary-video-route",
  "fallback_models": ["approved-video-preview-route"],
  "fallback_on": ["provider_5xx", "capacity_unavailable"],
  "do_not_fallback_on": ["client_timeout_without_task_state", "safety_rejection", "asset_created"],
  "verification": {
    "type": "human_review",
    "checks": ["duration", "motion", "brand_safety", "reference_consistency"]
  },
  "max_attempts": 1,
  "manual_queue_after_failure": true
}
Remarquez la différence : la politique texte peut souvent basculer automatiquement, car le résultat peut être vérifié par machine. La politique vidéo est plus étroite, car une seconde génération n’est pas simplement une nouvelle tentative ; c’est un autre artefact et un autre événement de coût.
Règles de repli par modalité
Texte : préserver le contrat de réponse
Le texte est le point de départ le plus simple, car la vérification peut être automatisée. Pour le routage de secours des API LLM, une solution de repli textuelle devrait préserver :
- la forme du point de terminaison ;
- la forme des événements de streaming, si elle est utilisée ;
- le comportement JSON ou de sortie structurée ;
- le comportement des appels d’outils ;
- les exigences de citation ou de récupération ;
- le plafond de latence ;
- le plafond de coût.
L’erreur consiste à basculer depuis une route de sortie structurée prévisible vers un modèle plus créatif qui paraît meilleur mais casse l’analyse en aval. Si la route sert l’automatisation produit, la stabilité du parseur compte plus que le style rédactionnel.
Vision : séparer la compréhension d’image de la génération d’image
Les tâches de vision produisent souvent du texte à propos d’une image. Les tâches de génération d’image produisent un nouvel artefact visuel. Elles ne devraient pas partager le même panier de repli.
OpenAI, Google Gemini et Anthropic documentent tous des capacités d’API de compréhension d’image ou liées à l’image, mais ces documentations décrivent des surfaces de requête et des comportements de modèle différents. Pour le routage d’agents multimodaux, la question de politique n’est pas simplement « cette route peut-elle gérer des images ? » C’est « cette route gère-t-elle cette tâche d’image avec les mêmes contraintes d’entrée et le même contrat de sortie ? »
Par exemple, un workflow de triage de captures d’écran peut nécessiter une route de raisonnement capable de vision qui renvoie du texte structuré. Un workflow créatif de marque a besoin d’une route de génération d’image qui renvoie un fichier et passe une revue visuelle. Il s’agit de classes de routes distinctes.
Génération d’image : ne pas contourner la revue créative
Le repli pour l’image doit protéger le contrat créatif :
- le ratio d’aspect ;
- la résolution ou la classe de taille ;
- la modification versus la génération entièrement nouvelle ;
- la compatibilité avec le modèle de prompt ;
- la revue de marque et de conformité ;
- le stockage et le cycle de vie de l’artefact ;
- le coût par artefact accepté.
Si la route d’image primaire échoue parce que l’entrée est invalide, le repli est la mauvaise solution. Corrigez la requête. Si elle échoue parce que le fournisseur est temporairement indisponible avant la création de tout artefact, le repli peut être raisonnable lorsque la route de secours a déjà passé l’assurance qualité visuelle.
Audio : distinguer transcription, compréhension et synthèse vocale
Le routage audio masque souvent trois tâches différentes :
- Speech-to-text : convertir l’audio en transcription.
- Compréhension audio : raisonner sur le contenu audio, l’intention du locuteur ou le contexte de la réunion.
- Text-to-speech : générer une sortie vocale.
Ces tâches ont des modes de défaillance différents. Un routage de transcription peut être évalué par le taux d’erreur de mots, le vocabulaire du domaine, les étiquettes de locuteur, les horodatages et la latence. Un routage vocal est évalué par la qualité de la voix, la prononciation, la latence, la politique de voix autorisée et l’expérience de lecture.
Le fallback doit rester à l’intérieur du type de tâche audio spécifique. N’utilisez pas « compatible avec l’audio » comme libellé de politique unique.
Vidéo : traiter le basculement comme un autre événement de production
La vidéo est généralement la modalité la plus à risque pour un fallback automatique, car une requête échouée ou lente a peut-être déjà créé une tâche côté fournisseur. Avant de créer une autre tâche, votre système doit savoir :
- si la tâche d’origine existe ;
- si elle est en file d’attente, en cours de traitement, réussie, en échec ou expirée ;
- si une URL de sortie a été créée ;
- si une utilisation ou un coût a été enregistré ;
- si un évaluateur a vu l’élément ;
- si une seconde génération violerait le budget ou le flux d’approbation.
Pour la génération vidéo, un défaut sûr est : ne réessayer le transport qu’avant qu’une tâche n’existe, interroger la tâche existante jusqu’à l’état terminal, puis utiliser un chemin de régénération manuel ou étroitement approuvé.
Que consigner lorsqu’un basculement se produit
Un fallback invisible dans les journaux devient impossible à améliorer. Au minimum, chaque requête doit enregistrer :
| Champ | Pourquoi c’est important |
|---|---|
request_id |
Associe le comportement visible par l’utilisateur aux preuves du fournisseur et de la passerelle. |
route_class |
Indique si la tâche était du texte, de la vision, de l’image, de l’audio ou de la vidéo. |
primary_model et final_model |
Révèle quelle route a répondu ou produit l’artefact. |
fallback_reason |
Distingue un timeout, une limite de débit, une erreur amont, un échec de vérification ou un contournement manuel. |
attempt_count |
Empêche les boucles de retry sans limite. |
latency_ms |
Montre si le fallback a aidé ou nui à l’expérience utilisateur. |
usage et cost |
Rend visible l’économie de la route de secours. |
verification_status |
Relie le fallback à la qualité de sortie, pas seulement au succès de l’API. |
reviewer_outcome |
Nécessaire pour le suivi d’acceptation des images, de l’audio et de la vidéo. |
Pour les équipes produit IA, la métrique la plus utile n’est souvent pas le simple temps de disponibilité. C’est le taux de sortie acceptée après fallback. Une route de secours qui répond rapidement mais produit des éléments rejetés n’est pas fiable du point de vue produit.
Où Flatkey s’inscrit
Flatkey est pertinent pour le routage de secours des API LLM, car la douleur opérationnelle dépasse un seul appel API. Les produits multimodaux accumulent souvent des clés spécifiques aux fournisseurs, des comptes de facturation directs, des identifiants de modèle dispersés, une gestion des erreurs incohérente et des tableaux de bord séparés pour les expériences texte, image, audio et vidéo.
La documentation publique et le site de Flatkey offrent aux équipes une URL de routeur unique compatible OpenAI pour les appels de modèles pris en charge, un catalogue de modèles, des journaux d’utilisation, un solde unique et une surface de facturation unique. Le site en direct présente également la fiabilité autour du basculement automatique et de surfaces publiques de statut/SLA. Cela ne supprime pas la nécessité de votre propre politique de modalité. Cela donne à cette politique un seul endroit où s’appliquer au lieu de disperser le choix de route dans le code des fonctionnalités.
Utilisez Flatkey lorsque vous voulez :
- un point de terminaison de routeur unique tout en comparant les routes de modèles prises en charge ;
- un seul endroit pour vérifier la disponibilité des modèles et le contexte commercial ;
- un solde et une facture uniques au lieu de comptes fournisseur dispersés ;
- des journaux d’utilisation pour le modèle, les jetons, le coût, la latence et la revue par le responsable ;
- une gouvernance des routes à mesure que davantage d’agents et de workflows adoptent les API IA.
Utilisez directement les comptes fournisseurs lorsqu’un seul fournisseur est la seule exigence, que la charge de travail n’a pas besoin de secours, et que le chemin fournisseur le plus simple est plus important qu’un contrôle inter-modèles.
Liste de contrôle de déploiement pour le routage de secours des API LLM
Avant d’activer le basculement automatique dans un produit multimodal, complétez cette liste de contrôle :
- Inventoriez les modalités. Dressez la liste de chaque workflow qui produit du texte, analyse des images, génère des images, accepte de l’audio, parle ou génère de la vidéo.
- Affectez des classes de routes. Ne laissez pas une seule étiquette « multimodal » couvrir différents types d’artefacts.
- Définissez la vérification. Chaque classe de route a besoin d’une méthode de réussite/échec avant que le secours puisse être fiable.
- Séparez la tentative du secours. La tentative répète la même route. Le secours change de route. La régénération crée un nouvel artefact.
- Rédigez des règles anti-contournement. Les rejets de sécurité, les entrées invalides, les effets de bord et les sorties partielles visibles ne devraient pas basculer silencieusement vers un secours.
- Fixez des plafonds de coût. Un secours qui enregistre la requête mais fait exploser le budget a quand même échoué pour le produit.
- Enregistrez la décision de routage. Stockez la route principale, la route finale, la raison de l’échec, le coût, la latence et le résultat de la vérification.
- Testez l’injection de pannes. Simulez des délais d’attente, des limites de taux, des erreurs 5xx, des entrées invalides, des échecs d’analyse, des images rejetées, de mauvaises transcriptions et des tâches vidéo lentes.
- Commencez par un workflow à faible risque. N’activez pas d’un coup le secours inter-modalité sur l’ensemble du produit.
- Examinez chaque semaine le taux de sortie acceptée. Optimisez pour des résultats exploitables, pas seulement pour des réponses HTTP réussies.
C’est la différence entre un routage de secours fiable pour les API LLM et des nouvelles tentatives aveugles sur des routes incompatibles.
Questions fréquentes
Qu’est-ce que le routage de secours pour les API LLM ?
Le routage de secours pour les API LLM est la politique qui décide quand une route de modèle échouée, dégradée ou indisponible doit être retentée, basculer vers une solution de secours approuvée, s’arrêter avec une erreur exploitable, ou passer à une revue humaine.
Pourquoi le routage d’agents multimodaux est-il plus difficile que le routage de texte seul ?
Le routage d’agents multimodaux est plus difficile parce que les sorties texte, image, audio et vidéo ont des méthodes de vérification, des courbes de coût, des attentes de latence et des risques de revue différents. Une règle de secours générique ne peut pas couvrir les quatre en toute sécurité.
Une seule passerelle API peut-elle gérer le texte, l’image, l’audio et la vidéo ?
Oui, une seule passerelle peut centraliser l’accès et la revue de l’utilisation sur l’ensemble des routes prises en charge. L’application a tout de même besoin de classes de route distinctes et de politiques de secours pour chaque modalité et chaque flux de travail.
Quand le basculement doit-il être automatique ?
Le basculement automatique est le plus sûr lorsque le contrat de sortie est vérifiable par machine, que la route de secours a déjà été testée, qu’aucune sortie partielle n’est parvenue à l’utilisateur, qu’aucun effet de bord n’est incertain et que la route de secours reste dans les limites de latence et de coût.
Quand le basculement doit-il rester manuel ?
Le basculement doit rester manuel lorsque l’artefact nécessite une revue subjective, que la requête peut avoir créé des effets de bord, que le coût d’un travail dupliqué est élevé, ou qu’un rejet de politique/de sécurité s’est produit. La génération vidéo et la génération d’images sensibles à la marque entrent souvent dans cette catégorie.
Une nouvelle tentative est-elle la même chose qu’un basculement ?
Non. Le retry renvoie la même requête vers la même route. Le fallback change de route. La régénération crée un nouvel artefact. Traitez-les comme des actions de politique distinctes, car elles ont des implications différentes en matière de coût et de qualité.
Comment les équipes doivent-elles mesurer la qualité du basculement ?
Mesurez le taux de réussite, le taux de fallback, la latence, le coût incrémental, les échecs d’analyse, l’acceptation par les réviseurs, le taux de sortie rejetée et le taux de sortie acceptée après fallback. Un HTTP 200 n’est que le début de la mesure.
Construisez la politique de routage avant le prochain changement de modèle
La raison la plus forte de formaliser le routage de secours pour les API LLM est que l’accès aux modèles évolue plus vite que l’architecture applicative. De nouvelles routes pour le texte, l’image, l’audio et la vidéo continueront d’apparaître. Certaines disparaîtront, ralentiront, changeront de prix ou se comporteront différemment sous charge.
Si votre produit dispose de classes de route, de règles de vérification, de plafonds de coûts et de décisions de fallback observables, l’ajout ou la suppression d’un modèle devient une mise à jour de politique contrôlée. Si votre logique de routage est cachée dans le code métier, chaque changement de modèle devient un risque de migration.
Commencez par un flux de travail contenu, définissez sa modalité et sa classe de vérification, testez les solutions de secours approuvées, puis étendez. Lorsque vous serez prêt à centraliser l’accès et la facturation sur les routes prises en charge, utilisez le guide de démarrage rapide de l’API Flatkey, consultez le flux de travail de l’API IA unifiée et comparez la disponibilité actuelle des modèles dans le répertoire des modèles Flatkey.


