
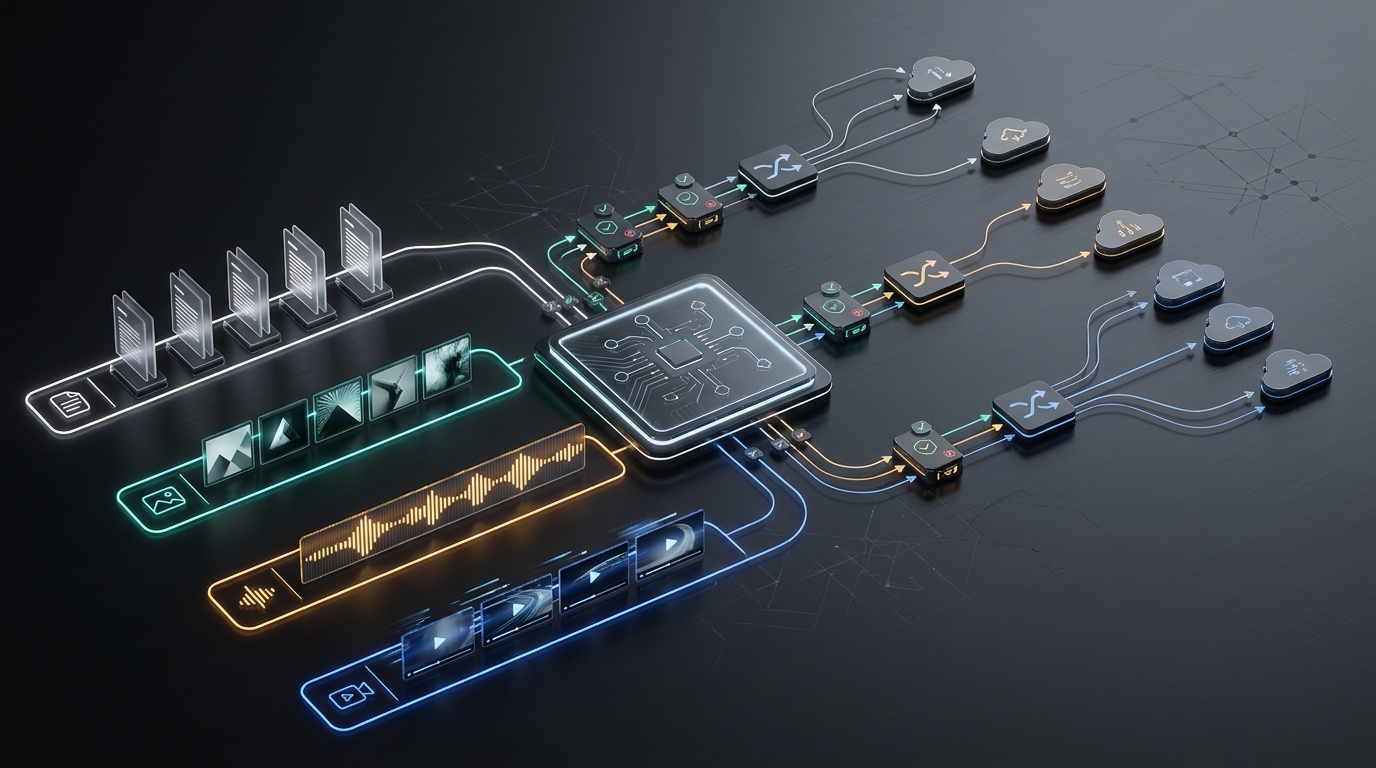
El enrutamiento de respaldo para APIs de LLM es sencillo cuando cada solicitud devuelve texto. Si la ruta principal supera el tiempo de espera, reintentas una vez, pasas a un modelo de respaldo, validas el esquema y registras el motivo.
Eso se descompone cuando el mismo producto también enruta generación de imágenes, transcripción de audio, salida de voz y generación de video. Un respaldo que es seguro para la extracción de JSON no es automáticamente seguro para imágenes de marca. Un respaldo de voz a texto no es lo mismo que un respaldo de texto a voz. Un respaldo de video puede crear gasto duplicado, confusión en la cola o una salida que todavía necesita aprobación humana.
Esta guía convierte Fallback Routing for LLM APIs: Multimodal Agent Routing for Text, Image, Audio, and Video en un manual de implementación para equipos de productos de IA. El objetivo no es elegir un modelo universal. El objetivo es hacer explícitos la elección de ruta, la verificación, el respaldo y la revisión de costes para cada modalidad que toque tu agente.
A fecha de 12 de septiembre de 2026, las páginas públicas en vivo de Flatkey enmarcan el producto en torno a una clave, un saldo, una factura, más de 100 modelos oficiales de IA, más de 1.000 herramientas, configuración compatible con OpenAI, registros de uso y conmutación por error automática. Las superficies públicas de modelos y precios de Flatkey también exponen rutas de modelos orientadas a texto, imagen, audio y video. Trata esas páginas en vivo como el punto de control comercial actual antes del despliegue porque la disponibilidad de modelos, los precios y la salud de las rutas pueden cambiar.
Respuesta rápida: ¿qué cambia en el enrutamiento de respaldo multimodal?
En sistemas solo de texto, el respaldo suele hacer una pregunta: "¿Puede otra ruta producir una respuesta equivalente?"
En sistemas multimodales, el enrutamiento de respaldo para APIs de LLM tiene que hacer cuatro preguntas:
- ¿Qué artefacto se está produciendo? Texto, imagen, audio y video no comparten un único estándar de calidad.
- ¿Cómo se verifica el artefacto? Un analizador de JSON, un revisor visual, un verificador de transcripciones y una cola de aprobación de video son sistemas de verificación diferentes.
- ¿Qué fallo es realmente recuperable? Los límites de tasa, los tiempos de espera, las entradas no válidas, las rechazos de seguridad y las salidas de baja calidad necesitan acciones diferentes.
- ¿Puede el respaldo preservar el contrato? Una ruta de respaldo solo es segura cuando preserva la modalidad, la forma de la salida, el presupuesto de latencia, el tope de coste y la ruta de revisión.
La regla práctica es simple: el respaldo se mantiene dentro de la clase de flujo de trabajo salvo que una capa humana o de política apruebe explícitamente el cambio.
Por qué los reintentos genéricos fallan para texto, imagen, audio y video
Los reintentos genéricos tratan cada solicitud fallida como un problema de transporte. Eso es demasiado superficial para el enrutamiento de agentes multimodales.
| Modalidad | Forma común de fallo | Por qué el reintento genérico es arriesgado |
|---|---|---|
| Texto | Tiempo de espera agotado, límite de tasa, fallo del analizador, desajuste en la llamada a herramientas, respuesta débil | Reintentar puede ser seguro, pero cambiar de modelo puede romper esquemas, citas, herramientas o tono. |
| Imagen | Bloqueo de seguridad, relación de aspecto incorrecta, desajuste de marca, baja fidelidad, mala adherencia a la edición | Otro modelo de imagen puede devolver un archivo válido que aun así no pase la revisión creativa. |
| Audio | Formato no compatible, transcripción deficiente, idioma incorrecto, desajuste de voz, pico de latencia | La transcripción, la traducción y la salida de voz son trabajos separados con reglas de respaldo separadas. |
| Video | Cola larga, tarea fallida, recurso caducado, movimiento inconsistente, salida rechazada costosa | Reenviar a ciegas puede crear trabajos duplicados, gasto duplicado y más recursos para revisar. |
El enrutador necesita saber si un fallo es un evento de servicio apto para reintento, una solicitud no válida, un resultado de seguridad o política, o un fallo de calidad. Esas categorías llevan a acciones distintas.
Empiece con clases de ruta, no con nombres de modelos
El enrutamiento de respaldo más seguro para las APIs de LLM comienza con clases de ruta. Los modelos pueden entrar y salir de una clase a medida que cambian la disponibilidad y la calidad; la política del flujo de trabajo debe permanecer estable.
| Clase de ruta | Trabajos principales | Clase de verificación | Comportamiento de respaldo predeterminado |
|---|---|---|---|
| Razonamiento de texto | Extracción, clasificación, resumen, programación, salida estructurada, llamadas a herramientas | Comprobaciones de esquema, pruebas del analizador, muestreo con rúbrica, éxito de la herramienta | Se puede permitir el respaldo automático cuando la copia de seguridad conserva la forma de la respuesta y el comportamiento de la herramienta. |
| Comprensión visual | Análisis de imágenes, revisión de documentos, interpretación de capturas de pantalla | Comprobaciones de la salida de texto más cobertura de la entrada visual | Hacer respaldo a otra ruta de razonamiento con capacidad visual, no a una ruta de generación de imágenes. |
| Generación o edición de imágenes | Imágenes nuevas, ediciones, variantes de producto, borradores creativos | QA visual, comprobaciones de marca, revisión de plantillas de prompt | Hacer respaldo solo a una ruta de imagen aprobada con relación de aspecto, estilo y reglas de revisión coincidentes. |
| Entrada de audio | Transcripción, traducción, resúmenes de reuniones, QA de llamadas | Comprobaciones de precisión de la transcripción, comprobaciones de idioma, revisión de marcas de tiempo | Hacer respaldo a otra ruta de transcripción o comprensión de audio con los mismos límites de entrada. |
| Salida de audio | Síntesis de voz, respuesta de agente de voz, narración | QA de reproducción, política de voz, presupuesto de latencia | Hacer respaldo a una ruta de voz aprobada; mantenerla separada del respaldo de transcripción. |
| Generación de video | Texto a video, imagen a video, clips de vista previa, recursos creativos | Aprobación humana, comprobaciones de duración/fidelidad, supervisión de la cola | Mantener el respaldo restringido; a menudo fallar a revisión manual en lugar de crear automáticamente otro trabajo. |
Este mapa de clases de ruta evita un error común: tratar "modelo multimodal" como un único conjunto de capacidades. Un modelo que acepta imágenes para análisis no necesariamente genera imágenes. Un modelo que entiende audio no es automáticamente un modelo de voz listo para producción. Un modelo que puede producir un video en una demo no es automáticamente seguro para automatización orientada al cliente.
Use una matriz de decisión de respaldo antes de escribir código
Una matriz de decisión ofrece a producto, ingeniería y operaciones una política compartida. Comience con la matriz de abajo y sustituya los ejemplos por sus propios modelos, proveedores y reglas de aprobación.
| Condición | Acción para texto | Acción para imagen | Acción para audio | Acción para video |
|---|---|---|---|---|
| Tiempo de espera de la ruta principal antes de que comience la salida | Reintentar dentro del presupuesto y luego hacer fallback a la ruta de texto aprobada | Reintentar una vez si no se creó ningún recurso, luego hacer fallback a la ruta de imagen aprobada | Reintentar o hacer fallback dentro del mismo tipo de trabajo de audio | Primero verifique el estado de la tarea; no cree un trabajo duplicado hasta que se conozca el estado original. |
| Error de límite de tasa o de capacidad | Hacer fallback cuando la copia de respaldo cumpla con el esquema y los límites de costo | Hacer fallback cuando la copia de respaldo cumpla con los límites de prompt, tamaño y revisión | Hacer fallback cuando la copia de respaldo admita el mismo formato de archivo e idioma | Hacer fallback solo si el costo duplicado y el comportamiento de la cola son aceptables. |
| Solicitud inválida o entrada no compatible | Detener y corregir la solicitud | Detener y corregir el prompt, el tipo de entrada, el tamaño o la relación de aspecto | Detener y corregir el formato multimedia, la duración, el idioma o la frecuencia de muestreo | Detener y corregir la duración, el medio de referencia, el prompt o los campos del endpoint. |
| Rechazo por seguridad o política | No ocultar el rechazo con fallback | No eludir la política con otro modelo | No eludir la política con otro proveedor de audio | No eludir la política con otro proveedor de video. |
| La salida no pasa la verificación automatizada | Hacer fallback si el contrato se puede comprobar mediante máquina | Enviar a revisión visual o regenerar bajo la política de ruta aprobada | Enviar a revisión de transcripción/reproducción o hacer fallback dentro del mismo tipo de trabajo | Enviar a revisión humana; use reglas de regeneración, no failover ciego. |
| La salida parcial en streaming ya llegó al usuario | Por lo general, detener y reconciliar; evitar el cambio transparente de modelo | No aplica para la mayoría de las rutas de imagen | Detener y reconciliar el estado visible para el usuario | No cambie de forma invisible después de que exista un estado visible del trabajo. |
| La llamada a una herramienta puede haber creado efectos secundarios | Reconciliar la idempotencia antes de reintentar o hacer fallback | Reconciliar cualquier escritura de activos/almacenamiento | Reconciliar el estado de transcripción, llamada o sesión de voz | Reconciliar primero el ID de la tarea, el almacenamiento, la facturación y el estado de aprobación. |
Esta matriz es el principal activo de valor del artículo. Convierte el enrutamiento de respaldo para APIs de LLM de una idea tardía de ingeniería en una política que puede revisarse antes de que el tráfico de producción se traslade.
Una arquitectura de referencia para el enrutamiento de agentes multimodales
Un enrutador de producción no necesita ser complicado, pero sí necesita límites claros.
flowchart LR
    A[Solicitud del agente] --> B[Clasificar flujo de trabajo]
    B --> C[Seleccionar ruta primaria]
    C --> D[Llamar al proveedor o gateway]
    D --> E[Verificar artefacto]
    E -->|pass| F[Devolver y registrar]
    E -->|retryable failure| G[Política de respaldo]
    E -->|policy or invalid input| H[Detener con error accionable]
    G --> I[Ruta de respaldo aprobada]
    I --> D
    G --> J[Revisión humana o cola manual]
Los elementos clave son:
- Clasificador de flujo de trabajo: etiqueta el trabajo como texto, visión, generación de imágenes, entrada de audio, salida de audio o generación de video antes de seleccionar la ruta.
- Registro de capacidades: registra qué rutas admiten cada modalidad, endpoint, formato de entrada, forma de salida, contexto máximo, comportamiento de streaming y clase de costo.
- Política de respaldo: define errores recuperables, respaldos permitidos, reglas anti-elusión y número máximo de intentos.
- Capa de verificación: comprueba el artefacto antes de devolverlo al usuario o enviarlo al siguiente paso.
- Libro mayor y observabilidad: registra modelo, ruta, propietario, estado, motivo del respaldo, latencia, uso, costo y resultado del revisor.
Flatkey puede situarse en la capa de proveedor o gateway cuando un equipo quiere un solo router compatible con OpenAI, un saldo compartido y un lugar para revisar las rutas de modelos admitidas. Tu aplicación sigue siendo responsable de la política: qué clase de modalidad puede recurrir a respaldo, cuándo detenerse y cuándo debe decidir una persona.
Define la política como datos
Mantén la política de enrutamiento fuera de instrucciones if dispersas. Un pequeño objeto de datos es más fácil de revisar y más seguro de cambiar.
{
  "workflow": "support_ticket_with_screenshot",
  "route_class": "vision_understanding",
  "primary_model": "primary-vision-reasoning-route",
  "fallback_models": ["backup-vision-reasoning-route"],
  "fallback_on": ["timeout_before_output", "rate_limit", "upstream_5xx"],
  "do_not_fallback_on": ["safety_rejection", "invalid_input", "partial_stream_sent"],
  "verification": {
    "type": "structured_text",
    "required_fields": ["summary", "severity", "evidence"]
  },
  "max_attempts": 2,
  "max_incremental_cost_usd": 0.05,
  "log_fields": [
    "request_id",
    "workspace_id",
    "route_class",
    "model",
    "fallback_reason",
    "latency_ms",
    "cost_usd",
    "verification_status"
  ]
}
La misma estructura puede representar flujos de trabajo multimedia:
{
  "workflow": "product_video_preview",
  "route_class": "video_generation",
  "primary_model": "primary-video-route",
  "fallback_models": ["approved-video-preview-route"],
  "fallback_on": ["provider_5xx", "capacity_unavailable"],
  "do_not_fallback_on": ["client_timeout_without_task_state", "safety_rejection", "asset_created"],
  "verification": {
    "type": "human_review",
    "checks": ["duration", "motion", "brand_safety", "reference_consistency"]
  },
  "max_attempts": 1,
  "manual_queue_after_failure": true
}
Observa la diferencia: la política de texto puede a menudo recurrir automáticamente porque el resultado se puede verificar mediante máquina. La política de video es más limitada porque una segunda generación no es simplemente un reintento; es otro artefacto y otro evento de coste.
Reglas de respaldo por modalidad
Texto: preservar el contrato de respuesta
El texto es el punto de partida más sencillo porque la verificación puede automatizarse. Para el enrutamiento de respaldo para APIs de LLM, un respaldo de texto debería preservar:
- la forma del endpoint;
- la forma de los eventos de streaming, si se utiliza;
- el comportamiento JSON o de salida estructurada;
- el comportamiento de llamadas a herramientas;
- los requisitos de citas o recuperación;
- el techo de latencia;
- el techo de coste.
El error es pasar de una ruta estructurada y predecible de salida estructurada a un modelo más creativo que suena mejor pero rompe el análisis posterior. Si la ruta sirve para automatización de producto, la estabilidad del parser importa más que el estilo de la prosa.
Visión: separar la comprensión de imágenes de la generación de imágenes
Los trabajos de visión a menudo producen texto sobre una imagen. Los trabajos de generación de imágenes producen un nuevo artefacto visual. No deberían compartir el mismo grupo de respaldo.
OpenAI, Google Gemini y Anthropic documentan capacidades de API de comprensión de imágenes o relacionadas con imágenes, pero esas documentaciones describen superficies de solicitud y comportamientos de modelo diferentes. Para el enrutamiento de agentes multimodales, la cuestión de la política no es simplemente "¿puede esta ruta manejar imágenes?" sino "¿maneja esta ruta este trabajo de imagen con las mismas restricciones de entrada y el mismo contrato de salida?"
Por ejemplo, un flujo de trabajo de triaje de capturas de pantalla puede necesitar una ruta de razonamiento con capacidad de visión que devuelva texto estructurado. Un flujo de trabajo creativo de marca necesita una ruta de generación de imágenes que devuelva un archivo y pase una revisión visual. Esas son clases de ruta separadas.
Generación de imágenes: no omitir la revisión creativa
El respaldo de imágenes debe proteger el contrato creativo:
- relación de aspecto;
- resolución o clase de tamaño;
- edición frente a generación totalmente nueva;
- compatibilidad con plantillas de prompt;
- revisión de marca y cumplimiento;
- almacenamiento y ciclo de vida del recurso;
- coste por recurso aceptado.
Si la ruta primaria de imágenes falla porque la entrada no es válida, el respaldo es la decisión incorrecta. Corrige la solicitud. Si falla porque el proveedor no está disponible temporalmente antes de que se haya creado cualquier recurso, el respaldo puede ser razonable cuando la ruta de respaldo ya ha superado la QA visual.
Audio: separar transcripción, comprensión y voz
El enrutamiento de audio suele ocultar tres trabajos diferentes:
- Speech-to-text: convertir audio en transcripción.
- Audio understanding: razonar sobre el contenido de audio, la intención del hablante o el contexto de la reunión.
- Text-to-speech: generar salida hablada.
Esos trabajos tienen diferentes modos de fallo. Una ruta de transcripción puede evaluarse por la tasa de error de palabras, el vocabulario del dominio, las etiquetas de hablante, las marcas de tiempo y la latencia. Una ruta de voz se evalúa por la calidad de la voz, la pronunciación, la latencia, la política de voces permitidas y la experiencia de reproducción.
El respaldo debe permanecer dentro del tipo específico de trabajo de audio. No uses "audio-capable" como una sola etiqueta de política.
Video: trata el respaldo como otro evento de producción
El video suele ser la modalidad de mayor riesgo para el respaldo automático porque una solicitud fallida o lenta puede haber creado ya una tarea del lado del proveedor. Antes de crear otra tarea, tu sistema debe saber:
- si la tarea original existe;
- si está en cola, en procesamiento, completada con éxito, fallida o expirada;
- si se creó una URL de salida;
- si se registró algún uso o costo;
- si un revisor ha visto el activo;
- si una segunda generación violaría el presupuesto o el flujo de aprobación.
Para la generación de video, un valor predeterminado seguro es: reintentar el transporte solo antes de que exista una tarea, consultar la tarea existente hasta un estado terminal y luego usar una ruta de regeneración manual o estrechamente aprobada.
Qué registrar cuando ocurre el respaldo
El respaldo que es invisible en los registros se vuelve imposible de mejorar. Como mínimo, cada solicitud debería registrar:
| Campo | Por qué importa |
|---|---|
request_id |
Vincula el comportamiento visible para el usuario con evidencias del proveedor y de la pasarela. |
route_class |
Muestra si el trabajo era de texto, visión, imagen, audio o video. |
primary_model y final_model |
Revela qué ruta respondió o produjo el artefacto. |
fallback_reason |
Distingue entre tiempo de espera, límite de tasa, error del upstream, fallo de verificación o anulación manual. |
attempt_count |
Evita bucles de reintento sin límite. |
latency_ms |
Muestra si el respaldo ayudó o perjudicó la experiencia del usuario. |
usage y cost |
Hace visible la economía de la ruta de respaldo. |
verification_status |
Conecta el respaldo con la calidad de salida, no solo con el éxito de la API. |
reviewer_outcome |
Necesario para el seguimiento de aceptación de imágenes, audio y video. |
Para los equipos de producto de IA, la métrica más útil a menudo no es el tiempo de actividad bruto. Es la tasa de salida aceptada después del respaldo. Una ruta de respaldo que responde rápido pero produce activos rechazados no es fiable en términos de producto.
Dónde encaja Flatkey
Flatkey es relevante para el enrutamiento de respaldo de APIs de LLM porque el dolor operativo es mayor que una sola llamada a la API. Los productos multimodales suelen acumular claves específicas de proveedor, cuentas de facturación directas, IDs de modelo dispersos, manejo de errores inconsistente y paneles separados para experimentos de texto, imagen, audio y video.
La documentación pública y el sitio de Flatkey ofrecen a los equipos una única URL de router compatible con OpenAI para las llamadas a modelos admitidas, un catálogo de modelos, registros de uso, un único saldo y una única vista de facturación. El sitio en vivo también enmarca la fiabilidad en torno al failover automático y a las superficies públicas de estado/SLA. Eso no elimina la necesidad de su propia política de modalidad. Le da a la política un único lugar donde operar en lugar de dispersar la elección de rutas por el código de funciones.
Use Flatkey cuando quiera:
- un punto final de router mientras compara rutas de modelos admitidas;
- un solo lugar para comprobar la disponibilidad de modelos y el contexto comercial;
- un único saldo y factura en lugar de cuentas de proveedores dispersas;
- registros de uso para revisión de modelo, token, coste, latencia y propietario;
- gobernanza de rutas a medida que más agentes y flujos de trabajo adoptan APIs de IA.
Use cuentas directas de proveedores cuando un proveedor sea el único requisito, la carga de trabajo no necesite fallback y la ruta de proveedor más simple sea más importante que el control entre modelos.
Lista de verificación de despliegue para enrutamiento de respaldo para APIs de LLM
Antes de habilitar el fallback automático en un producto multimodal, complete esta lista de verificación:
- Inventarie las modalidades. Enumere cada flujo de trabajo que produce texto, analiza imágenes, genera imágenes, acepta audio, habla o genera video.
- Asigne clases de ruta. No permita que una sola etiqueta "multimodal" cubra diferentes tipos de artefactos.
- Defina la verificación. Cada clase de ruta necesita un método de aprobado/suspenso antes de que se pueda confiar en el fallback.
- Separe reintento de fallback. El reintento repite la misma ruta. El fallback cambia de ruta. La regeneración crea un nuevo artefacto.
- Escriba reglas anti-bypass. Las rechazos de seguridad, las entradas inválidas, los efectos secundarios y las salidas parciales visibles no deben hacer fallback silenciosamente.
- Establezca límites de coste. Un fallback que salva la solicitud pero rompe el presupuesto sigue siendo un fallo del producto.
- Registre la decisión de ruta. Almacene la ruta primaria, la ruta final, el motivo del fallo, el coste, la latencia y el resultado de la verificación.
- Pruebe la inyección de fallos. Simule timeouts, límites de tasa, errores 5xx, entradas inválidas, fallos de parser, imágenes rechazadas, transcripciones deficientes y trabajos de video lentos.
- Empiece con un flujo de trabajo de bajo riesgo. No active el fallback entre modalidades en todo el producto de una vez.
- Revise semanalmente la tasa de salidas aceptadas. Optimice para resultados utilizables, no solo para respuestas HTTP exitosas.
Esta es la diferencia entre un enrutamiento de respaldo fiable para APIs de LLM y reintentos ciegos entre rutas incompatibles.
Preguntas frecuentes
¿Qué es el enrutamiento de respaldo para APIs de LLM?
El enrutamiento de respaldo para APIs de LLM es la política que decide cuándo una ruta de modelo fallida, degradada o no disponible debe reintentarse, cambiarse a una copia de seguridad aprobada, detenerse con un error accionable o pasar a revisión humana.
¿Por qué el enrutamiento de agentes multimodales es más difícil que el enrutamiento solo de texto?
El enrutamiento de agentes multimodales es más difícil porque las salidas de texto, imagen, audio y video tienen diferentes métodos de verificación, curvas de coste, expectativas de latencia y riesgos de revisión. Una regla genérica de fallback no puede cubrir de forma segura las cuatro.
¿Puede una única puerta de enlace API gestionar texto, imagen, audio y video?
Sí, una sola pasarela puede centralizar el acceso y la revisión del uso en todas las rutas admitidas. La aplicación sigue necesitando clases de ruta separadas y políticas de respaldo para cada modalidad y flujo de trabajo.
¿Cuándo debería ser automático el respaldo?
El respaldo automático es más seguro cuando el contrato de salida se puede comprobar automáticamente, la ruta de respaldo ya se ha probado, ninguna salida parcial llegó al usuario, no hay efectos secundarios inciertos y el respaldo se mantiene dentro de los límites de latencia y costo.
¿Cuándo debería seguir siendo manual el respaldo?
El respaldo debería seguir siendo manual cuando el artefacto requiere revisión subjetiva, es posible que la solicitud haya creado efectos secundarios, el costo del trabajo duplicado es alto o se produjo un rechazo por política/seguridad. La generación de video y la generación de imágenes sensibles a la marca suelen pertenecer a esta categoría.
¿Es lo mismo reintentar que usar respaldo?
No. Reintentar envía la misma solicitud a la misma ruta otra vez. El fallback cambia la ruta. La regeneración crea un nuevo artefacto. Trátelos como acciones de política separadas porque tienen implicaciones distintas de costo y calidad.
¿Cómo deberían medir los equipos la calidad del respaldo?
Mida la tasa de éxito, la tasa de fallback, la latencia, el costo incremental, los fallos del analizador, la aceptación del revisor, la tasa de salida rechazada y la tasa de salida aceptada después del fallback. HTTP 200 es solo el comienzo de la medición.
Construya la política de enrutamiento antes del próximo cambio de modelo
La razón más sólida para formalizar el enrutamiento de respaldo para las APIs de LLM es que el acceso a los modelos cambia más rápido que la arquitectura de la aplicación. Seguirán apareciendo nuevas rutas de texto, imagen, audio y video. Algunas desaparecerán, se ralentizarán, cambiarán de precio o se comportarán de forma diferente bajo carga.
Si su producto tiene clases de ruta, reglas de verificación, límites de costo y decisiones de respaldo observables, agregar o eliminar un modelo es una actualización controlada de la política. Si su lógica de enrutamiento está oculta en el código de funciones, cada cambio de modelo se convierte en un riesgo de migración.
Empiece con un flujo de trabajo contenido, defina su modalidad y su clase de verificación, pruebe los respaldos aprobados y luego amplíe. Cuando esté listo para centralizar el acceso y la facturación en las rutas admitidas, use la guía de inicio rápido de la API de Flatkey, revise el flujo de trabajo de API unificada de IA y compare la disponibilidad actual de modelos en el directorio de modelos de Flatkey.


