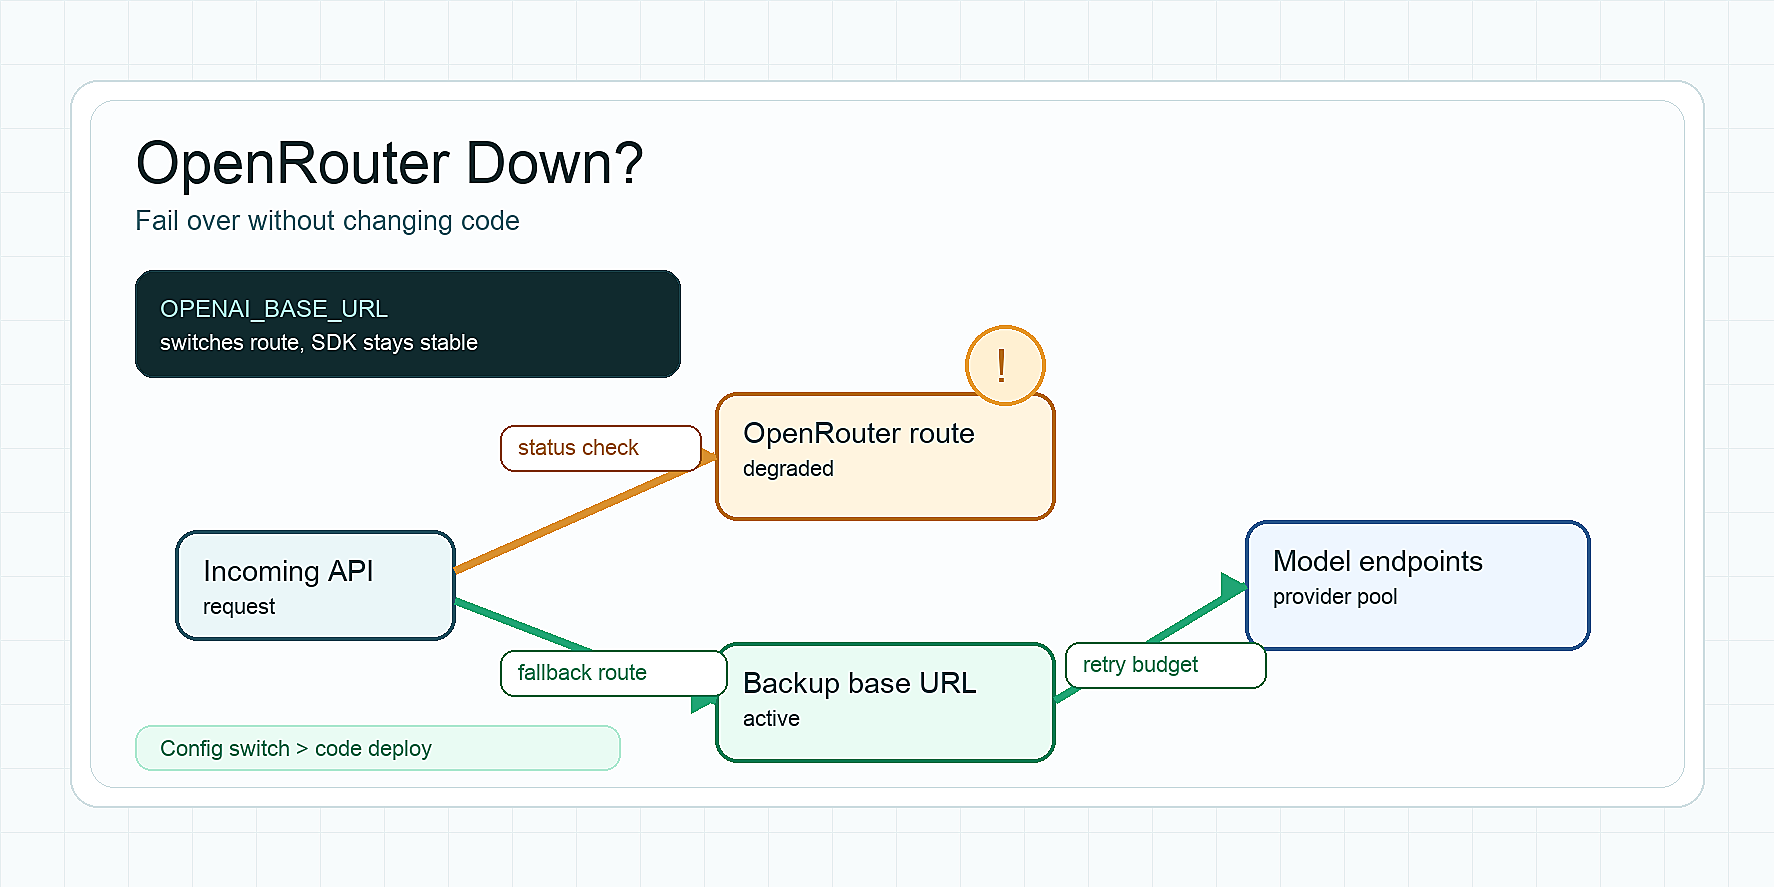
Lorsque les gens recherchent OpenRouter en panne, ils ont généralement besoin de deux réponses rapides : OpenRouter est-il réellement en panne, et comment faire avancer les requêtes sans réécrire mon application ?
La réponse la plus sûre n’est pas de basculer les modèles à chaud dans le code. Commencez par confirmer si le problème concerne l’ensemble d’OpenRouter, un fournisseur spécifique, un compte spécifique, ou votre propre file de réessais. Ensuite, déplacez le failover dans la configuration : vérifications d’état, budgets de réessais, fallback de fournisseur, fallback de modèle, et un base_url OpenAI-compatible interchangeable.
Date de vérification : 13 octobre 2026. Ne considérez pas cet article comme une preuve qu’OpenRouter est en panne en ce moment. Consultez la page de statut OpenRouter et vos propres journaux avant de lancer un incident.
La réponse courte
Si OpenRouter est en panne, ou si une route OpenRouter échoue, utilisez cet ordre :
- Consultez
https://status.openrouter.ai/et vos journaux d’erreurs. - Distinguez les erreurs de la plateforme OpenRouter des erreurs du modèle/fournisseur en amont.
- Respectez
Retry-Afterpour les réponses429,503et certaines réponses402liées au budget en vol. - Laissez
provider.allow_fallbacksactivé sauf si une règle de conformité exige le contraire. - Ajoutez des fallbacks de modèle via la configuration de la requête lorsque le contrat de qualité de réponse l’autorise.
- Placez votre passerelle API ou votre point de terminaison de secours derrière une variable d’environnement afin de pouvoir changer
base_urlsans modifier le code de l’application.
Ce dernier point est la vraie solution « sans changer de code ». Votre application doit lire le point de terminaison depuis la configuration :
OPENAI_BASE_URL=https://openrouter.ai/api/v1
OPENAI_API_KEY=...
Pendant un incident, votre changement opérationnel devient :
OPENAI_BASE_URL=https://router.flatkey.ai/v1
OPENAI_API_KEY=...
Votre code SDK reste identique.
OpenRouter est-il en panne ?
N’en déduisez pas OpenRouter en panne à partir d’une seule requête échouée. Une requête échouée peut signifier :
| Symptôme | Portée probable | Ce qu’il faut vérifier en premier |
|---|---|---|
| Incident sur la page de statut | Plateforme OpenRouter | Page de statut, chronologie de l’incident, mises à jour publiques |
502 Bad Gateway |
Le modèle/fournisseur choisi est peut-être en panne | Modèle, métadonnées du fournisseur, éligibilité au fallback |
503 Service Unavailable |
Aucun fournisseur ne satisfait vos règles de routage | Contraintes du fournisseur, only, ZDR, exigences de paramètres |
429 Too Many Requests |
Limite de débit ou capacité du fournisseur | Retry-After, concurrence de la file, fallback de fournisseur |
402 Payment Required |
Crédits ou budget de dépenses en vol | Retry-After, solde du compte, limites de clé |
403 Forbidden |
Budget, autorisations, modération, garde-fou | error.metadata, politique d’espace de travail/de clé |
| Le streaming démarre, puis un événement d’erreur apparaît | Le fournisseur a échoué après HTTP 200 |
Inspectez le corps SSE, pas seulement le statut HTTP initial |
La documentation des erreurs d’OpenRouter indique que 502 peut signifier que le modèle choisi est en panne ou a renvoyé une réponse invalide, tandis que 503 peut signifier qu’aucun fournisseur de modèle disponible ne satisfait les exigences de routage. La même documentation indique qu’OpenRouter peut renvoyer Retry-After sur les réponses 429, 503 et certaines réponses 402 liées au budget en vol. Source : Erreurs et débogage OpenRouter.
OpenRouter a déjà connu des pannes publiques. Son post-mortem des 17 et 19 février 2026 décrit des échecs d’API dus à une dépendance de cache tierce et note que certains utilisateurs ont vu des erreurs 401 trompeuses pendant l’incident. Cet article historique est utile comme contexte, mais il ne constitue pas une preuve d’une panne actuelle. Source : Post-mortem de la panne OpenRouter.
Les cinq premières minutes : triage d’OpenRouter en panne
Utilisez cette liste de contrôle avant de basculer le trafic.
| Minute | Action | Décision |
|---|---|---|
| 0-1 | Vérifiez la page de statut OpenRouter et votre chronologie d’alertes. | Si la page de statut confirme un incident, passez à la préparation du failover. |
| 1-2 | Regroupez les erreurs par code de statut, modèle, fournisseur, route et SDK. | Si un seul modèle/fournisseur échoue, évitez les suppositions à l’échelle de la plateforme. |
| 2-3 | Vérifiez Retry-After, le nombre de réessais et la concurrence de la file. |
Arrêtez les tempêtes de réessais avant d’ajouter davantage de trafic de fallback. |
| 3-4 | Comparez les charges de travail payantes, gratuites, batch et agents. | Préservez le trafic interactif avant les tâches d’arrière-plan. |
| 4-5 | Choisissez la plus petite action de failover qui restaure le travail visible par l’utilisateur. | Préférez le fallback de fournisseur avant le fallback inter-modèles ; préférez le changement de configuration avant le déploiement de code. |
L’erreur principale lors d’un incident OpenRouter en panne est de faire réessayer immédiatement chaque worker. Une tempête de réessais peut transformer une erreur de fournisseur en problème de file d’attente à l’échelle de la plateforme dans votre propre application.
Basculement sans changer de code
Le schéma sans changement de code est simple : conservez une utilisation stable du SDK et rendez l’itinéraire configurable.
import OpenAI from "openai";

export const ai = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: process.env.OPENAI_BASE_URL,
});
Puis gardez la sélection de l’endpoint dans l’environnement, la configuration de déploiement, les feature flags ou votre gestionnaire de secrets :
ai_gateway:
  primary:
    base_url: https://openrouter.ai/api/v1
    key_env: OPENROUTER_API_KEY
  backup:
    base_url: https://router.flatkey.ai/v1
    key_env: FLATKEY_API_KEY
  switch_policy:
    trigger: confirmed_platform_incident_or_error_budget_exhausted
    owner: on_call_engineer
    rollback: after_30_minutes_below_error_threshold
Cela fonctionne parce que le guide de démarrage rapide d'OpenRouter indique que son API peut être utilisée via le SDK OpenAI en pointant le SDK vers OpenRouter. La même forme d’intégration est exactement ce qui rend pratique une passerelle OpenAI compatible de secours. Source : Guide de démarrage rapide OpenRouter.
Utilisez le fallback du fournisseur avant de changer de modèle
Si OpenRouter est joignable mais qu’un fournisseur rencontre des difficultés, le fallback du fournisseur est l’option la moins risquée. Vous conservez le même contrat de modèle et laissez le routage essayer un autre fournisseur éligible.
La documentation sur le routage des fournisseurs d’OpenRouter indique que les requêtes sont réparties par défaut entre les principaux fournisseurs pour maximiser la disponibilité, et que l’objet provider inclut allow_fallbacks, avec une valeur par défaut à true. La documentation avertit aussi que définir sort ou order modifie le comportement d’équilibrage de charge, et que des filtres de fournisseur stricts peuvent réduire la marge de routage. Source : Routage des fournisseurs OpenRouter.
Commencez avec ceci :
{
  "model": "anthropic/claude-sonnet-4.5",
  "messages": [{ "role": "user", "content": "..." }],
  "provider": {
    "allow_fallbacks": true
  }
}
Faites attention à cela pendant un incident :
{
  "provider": {
    "only": ["one-provider"],
    "allow_fallbacks": false
  }
}
Un routage strict peut être approprié pour la conformité, la conservation des données, la région ou la politique tarifaire. Mais le routage strict n’est pas un réglage de fiabilité. Si vous avez besoin d’un routage strict pour des charges de travail sensibles, créez un chemin séparé non sensible qui peut basculer plus librement.
Ajoutez le fallback de modèle uniquement lorsque les sorties sont interchangeables
Le fallback de modèle est plus puissant que le fallback du fournisseur. Il peut maintenir l’application en service lorsque le modèle principal est indisponible, soumis à des limites de débit ou bloqué, mais il peut aussi modifier le style de sortie, la latence, le coût, la longueur du contexte, le comportement des outils et les résultats d’évaluation.
La documentation sur le fallback de modèle d’OpenRouter indique que le paramètre models permet de fournir des identifiants de modèles par ordre de priorité. Si le premier modèle renvoie une erreur, OpenRouter essaie le modèle suivant. La documentation cite notamment la limitation de débit et les interruptions de service parmi les erreurs pouvant déclencher un fallback. Source : Fallbacks de modèle OpenRouter.
Utilisez le fallback de modèle pour les tâches avec un contrat d’équivalence souple :
{
  "models": [
    "anthropic/claude-sonnet-4.5",
    "openai/gpt-4o",
    "google/gemini-2.5-pro"
  ],
  "messages": [{ "role": "user", "content": "Résumez ce fil d’assistance." }]
}
Évitez un fallback de modèle silencieux pour les tâches où le modèle exact fait partie de la garantie produit :
| Charge de travail | Position sur le fallback de modèle |
|---|---|
| Résumé interne | Généralement sûr avec évaluation et journalisation |
| Planification d’un agent de codage | Possible, mais testez le comportement d’appel d’outil et le suivi des instructions |
| Extraction structurée | Uniquement si les schémas et la validation passent |
| Texte créatif visible par le client | Possible, mais attendez-vous à des différences de style |
| Sortie réglementée ou contractuelle | Ne changez pas de modèle silencieusement |
| Benchmarking ou évaluations | Ne faites pas de fallback sauf si le fallback est le sujet du test |
Une politique d’incident pratique
Cette politique est volontairement banale. Elle maintient le travail de réponse à OpenRouter Down dans un cadre opérationnel plutôt que dramatique.
openrouter_down_policy:
  status_checks:
    - openrouter_status_page
    - synthetic_chat_completion
    - provider_error_rate_by_model
    - queue_retry_rate

  retry_budget:
    max_attempts: 3
    honor_retry_after: true
    jitter: true
    stop_retrying_on:
      - invalid_credentials
      - spent_budget
      - moderation_block
      - bad_request

  provider_fallback:
    default_allow_fallbacks: true
    loosen_provider_constraints_for:
      - non_sensitive_batch_jobs
      - internal_tools
      - support_summaries

  model_fallback:
    require_contract: equivalent_quality_or_validated_schema
    log_selected_model: true
    disallow_for:
      - evals
      - compliance_outputs
      - customer_promises_about_exact_model

  base_url_failover:
    primary: OPENAI_BASE_URL
    backup_env: OPENAI_BACKUP_BASE_URL
    switch_owner: on_call_engineer
    switch_requires:
      - confirmed_status_incident_or_internal_error_budget
      - rollback_plan
      - public_request_log_enabled
Les champs clés à consigner sont :
| Champ | Pourquoi c’est important |
|---|---|
base_url |
Prouve quelle passerelle a traité la requête |
requested_model |
Montre le modèle prévu par l’appelant |
served_model |
Montre le modèle réellement utilisé après le basculement |
provider |
Distincte les problèmes de plateforme des problèmes de fournisseur |
status_code |
Déclenche les décisions de retry/basculement |
retry_after |
Empêche les tempêtes de retries |
attempt |
Montre si les retries amplifient le trafic |
fallback_reason |
Rend possible l’examen d’incident |
cost |
Confirme que le basculement n’a pas créé une hausse de dépenses inattendue |
request_id |
Permet au support et à l’ingénierie de tracer une requête |
Où Flatkey s’intègre
Flatkey est utile lorsque vous souhaitez que le playbook OpenRouter Down vive en dehors du code applicatif. Le positionnement produit de Flatkey est une passerelle LLM unifiée : une clé, un solde, et un endpoint compatible OpenAI pour router entre les modèles texte, image et vidéo officiels. Dans ce schéma d’incident, la valeur pratique est opérationnelle :
- Gardez votre application sur une forme de client compatible OpenAI.
- Routez une charge de travail via un
base_urlde secours sans modifier la logique de l’application. - Centralisez les allowlists de modèles, les sous-clés, les journaux de requêtes, les contrôles de budget et la politique de repli.
- Comparez le comportement de la passerelle à l’aide de preuves de requêtes plutôt que d’anecdotes.
N’utilisez pas le basculement pour toutes les charges de travail lors d’un incident mineur. Déplacez d’abord une charge représentative, surveillez le taux d’erreur, la latence, le modèle sélectionné, la raison du repli et le coût, puis décidez s’il faut élargir le basculement.
Lectures suivantes utiles :
- Limites de débit OpenRouter
- Routage de repli de l’API LLM
- Stratégie de repli de modèle
- Gestion des quotas de l’API IA
- Démarrage rapide de l’API Flatkey
FAQ OpenRouter Down
OpenRouter est-il en panne en ce moment ?
Consultez d’abord la page d’état d’OpenRouter. Cet article explique comment réagir lorsque les recherches OpenRouter Down correspondent à un incident réel ou à une panne locale d’un fournisseur ; il n’affirme pas qu’OpenRouter est en panne en ce moment.
Que dois-je faire en premier si OpenRouter est en panne ?
Suspendez les retries agressifs, inspectez les codes d’état et préservez le trafic interactif. Si l’incident est confirmé, privilégiez le fallback du fournisseur avant le fallback du modèle, et privilégiez un changement de configuration base_url avant un déploiement de code.
Puis-je basculer depuis OpenRouter sans changer de code ?
Oui, si votre application lit déjà l’endpoint compatible OpenAI depuis la configuration. Placez baseURL ou base_url derrière une variable d’environnement, conservez la forme de l’appel SDK, et changez l’endpoint dans la configuration de déploiement.
Dois-je utiliser les fallbacks de modèle OpenRouter pendant une panne ?
Utilisez les fallbacks de modèle uniquement lorsque le modèle de repli est acceptable pour la tâche. Ils conviennent à de nombreux workflows internes, mais pas aux évaluations, aux sorties réglementées, ni aux cas où les clients ont été promis à un modèle spécifique.
Quelle est la correction à long terme la plus sûre pour le risque OpenRouter Down ?
Concevez la portabilité au niveau du routage : base_url configurable, journalisation au niveau des requêtes, budgets de retry, fallback du fournisseur, contrats de fallback de modèle testés, et chemin de secours vers une passerelle compatible OpenAI. L’objectif n’est pas d’éviter chaque panne ; c’est de rendre le basculement banal.