
Fiabilité et routage
Derniers articles dans Fiabilité et routage.

Qu’est-ce que le routage LLM ? Règles, pondérations et politiques tenant compte des coûts
Qu’est-ce que le routage LLM ? Découvrez comment les règles, scores pondérés, filtres de capacités, solutions de repli et évaluations rendent les API multi-modèles plus fiables.
API proxy CLI : accès, tarification, intégration et guide de production
Découvrez le fonctionnement d’une API proxy CLI, l’accès et les coûts de CLIProxyAPI, comment la tester en toute sécurité et quand une passerelle gérée convient à la production.
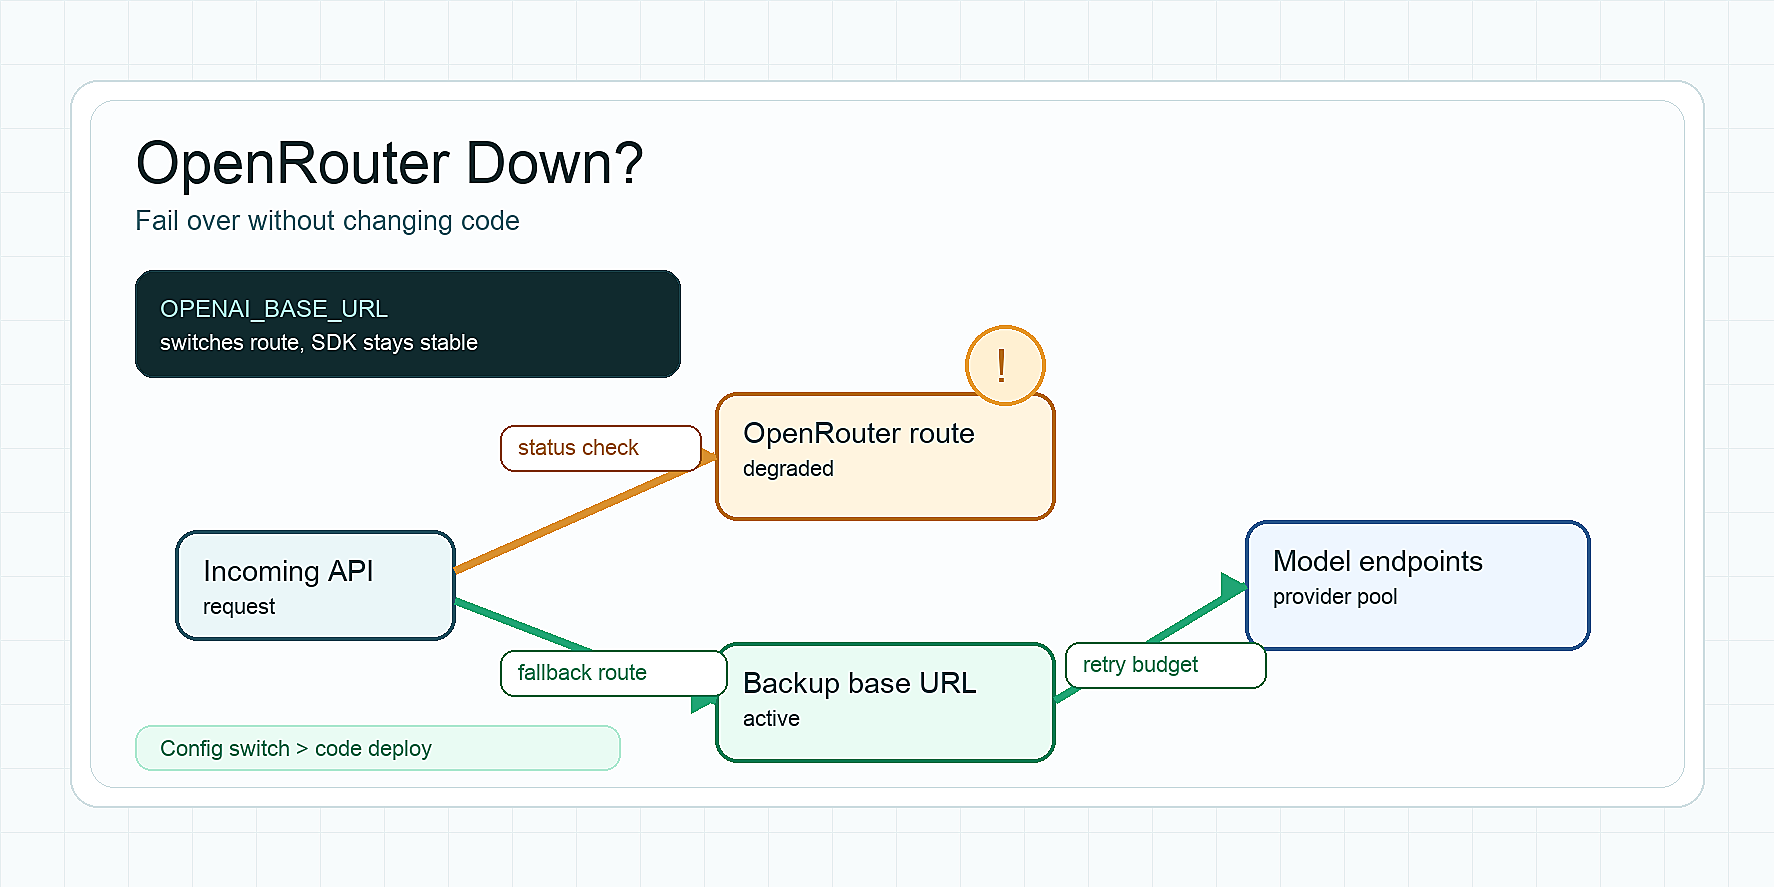
OpenRouter en panne ? Comment basculer sans changer de code
Vérifiez si OpenRouter est en panne, distinguez les erreurs de fournisseur des incidents de plateforme, et mettez en place un basculement avec base_url, retries, provider fallback et model fallback.
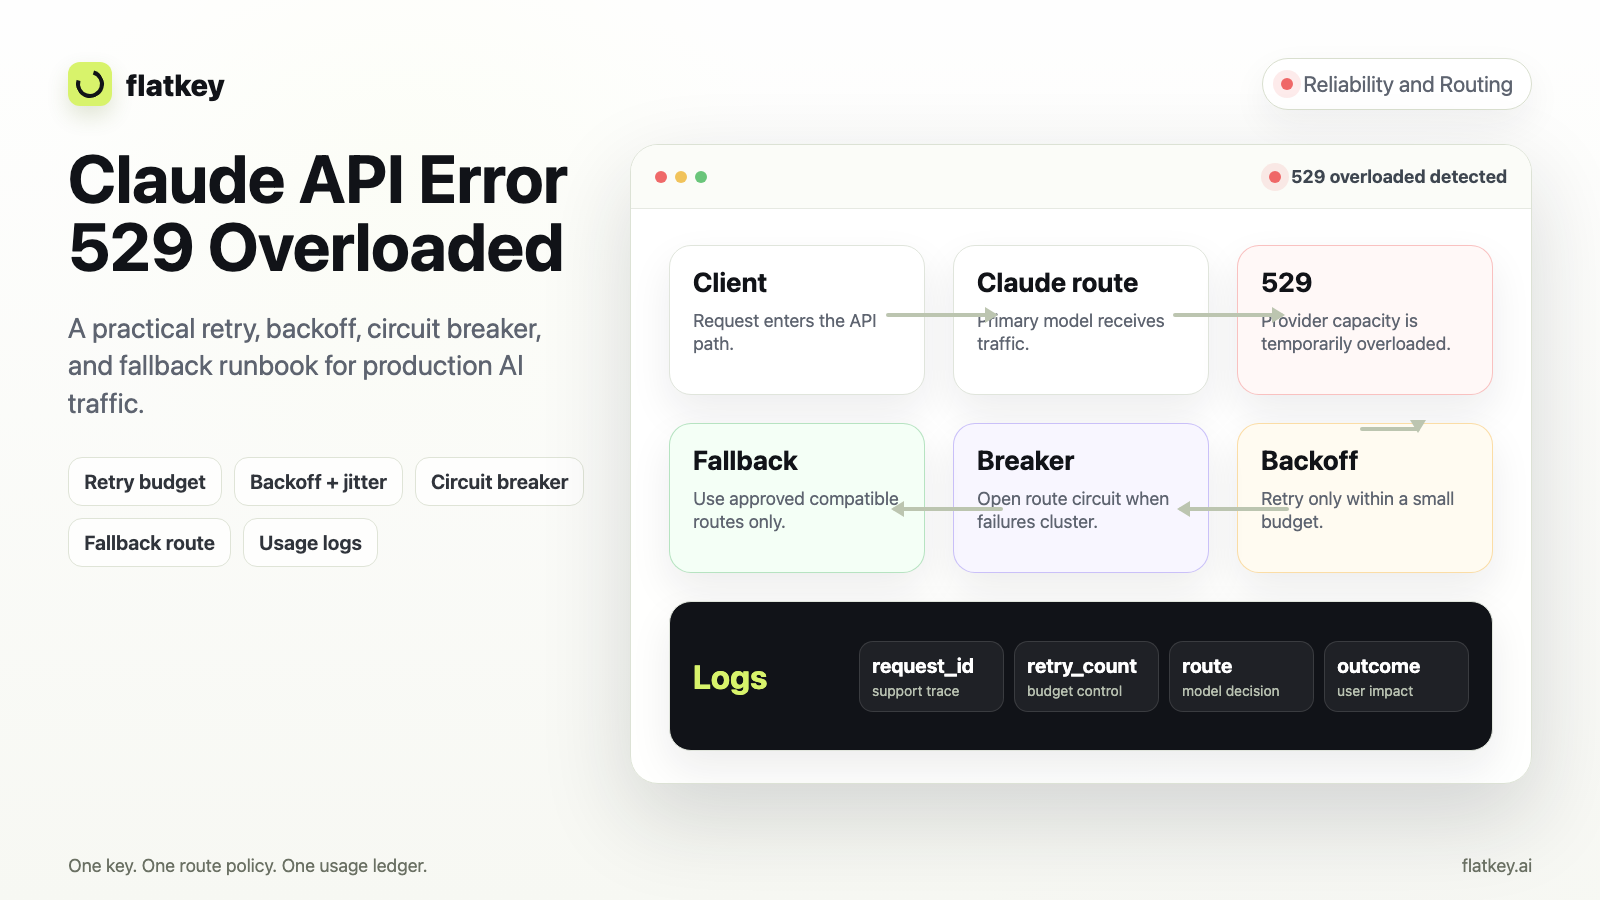
Erreur Claude API 529 de surcharge : guide d’intervention pour retry, backoff et fallback
Un guide d’intervention en production pour les erreurs de surcharge Claude API 529 : classer l’échec, définir des budgets de retry, ajouter du backoff et du jitter, protéger les effets de bord, couper les boucles de surcharge avec un circuit breaker et choisir des routes de fallback sûres.
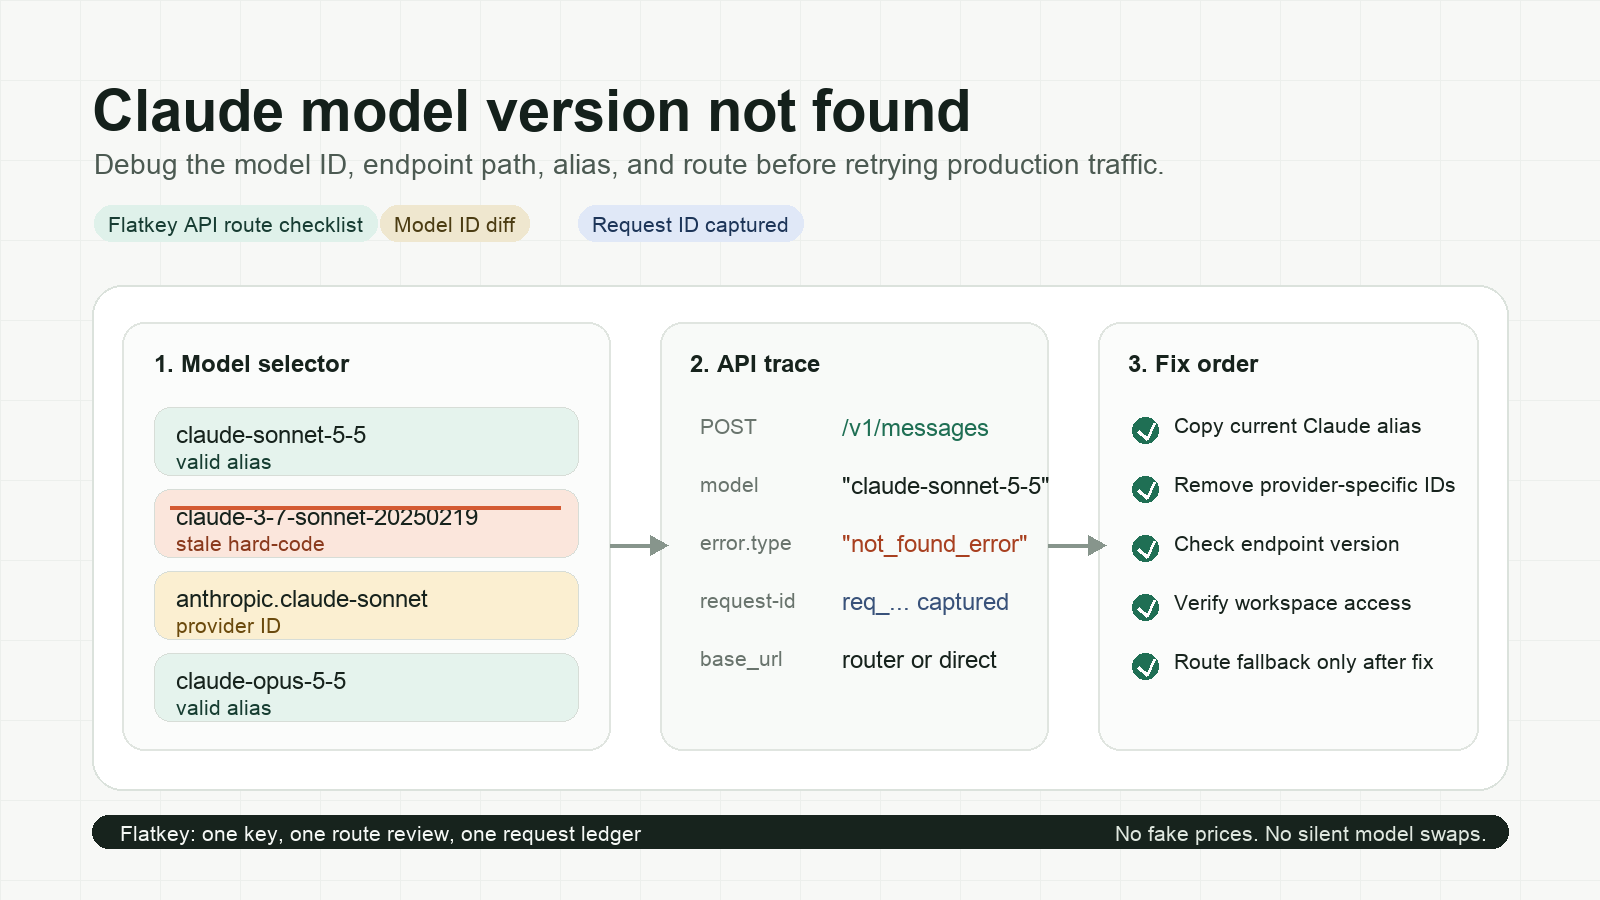
Claude Model Version Not Found : corriger les mauvais ID de modèle, alias et routes API
Un guide pratique de débogage pour les erreurs « model version not found » de Claude, couvrant les API natives d’Anthropic, les routeurs, les IDs des fournisseurs cloud, les configurations d’agents et les solutions de repli en production.
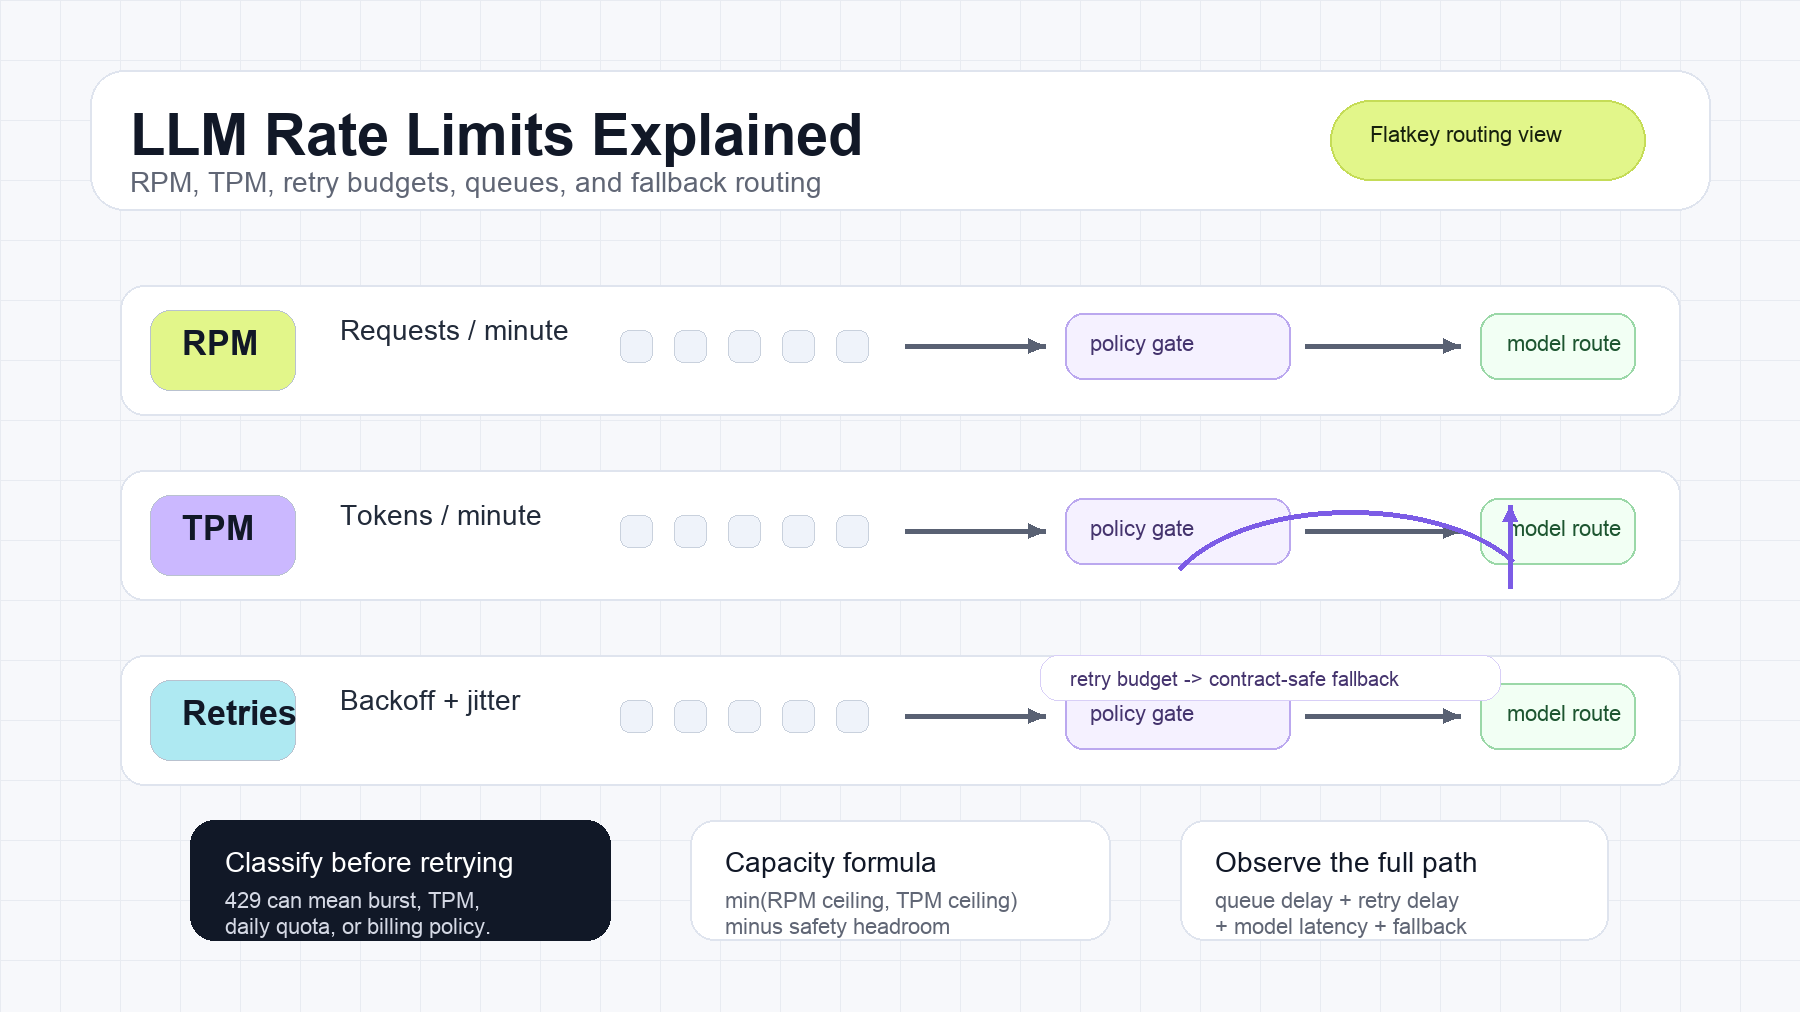
Comprendre les limites de débit des LLM : RPM, TPM et retries
Comprenez les limites de débit des LLM, RPM, TPM, les erreurs 429, Retry-After, l'exponential backoff, les budgets de retry, les files d'attente et le routage de secours.
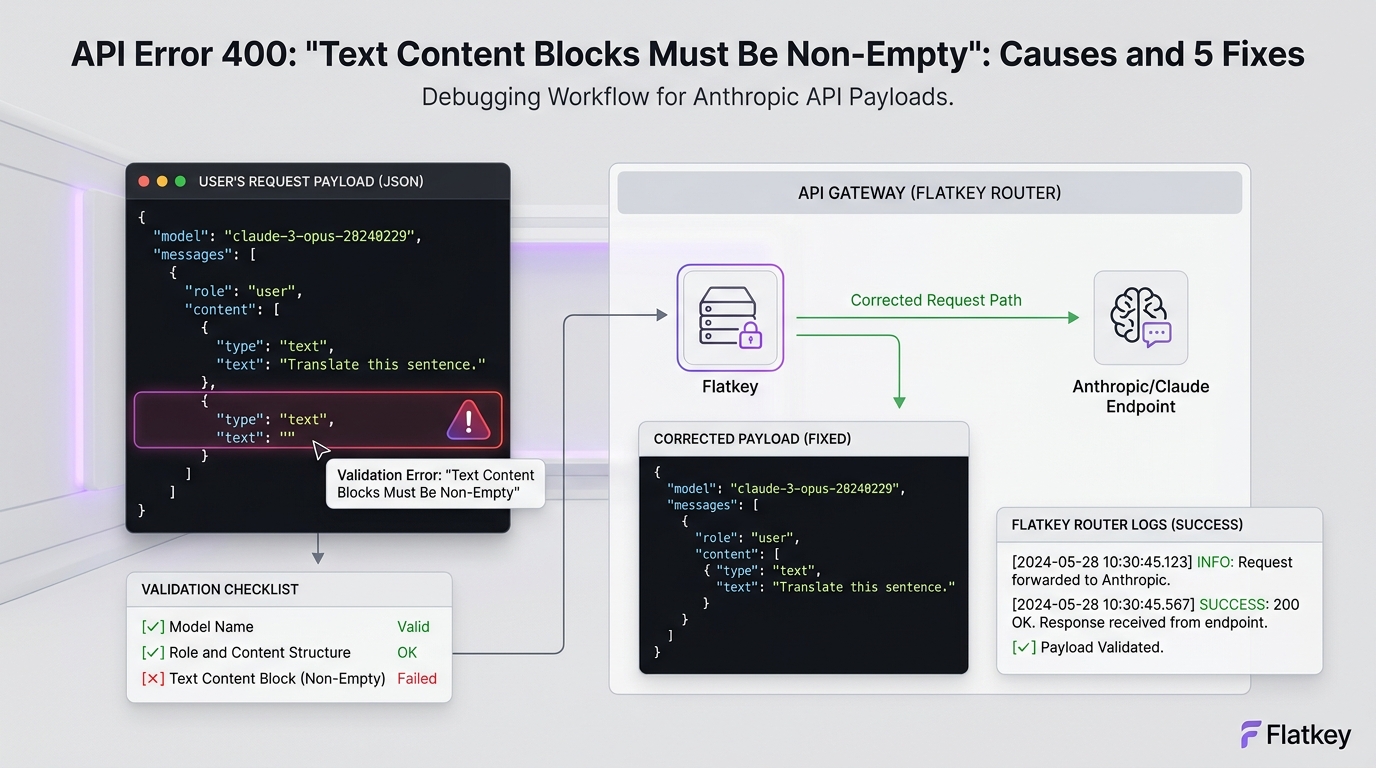
Erreur API 400 « Les blocs de contenu texte doivent être non vides » : causes et 5 solutions
Corrigez l’erreur API 400 « Text Content Blocks Must Be Non-Empty » dans les requêtes Anthropic grâce à des vérifications de charge utile, du code de nettoyage, des exemples SDK et des étapes de contrôle qualité.
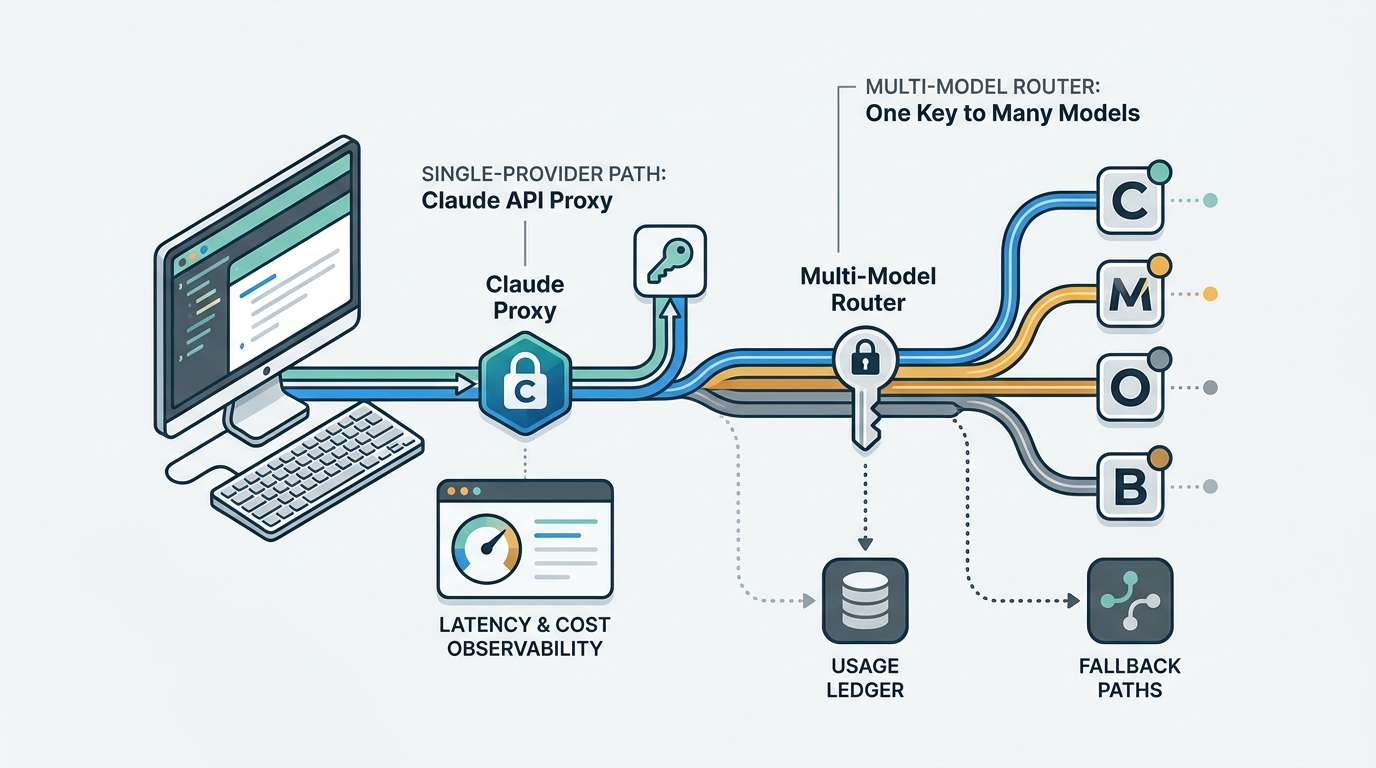
Proxy API Claude vs routeur multi-modèles : quand une seule clé l’emporte
Comparez un proxy API Claude à un routeur multi-modèles. Utilisez le tableau de score, la checklist de migration et le test de validation Flatkey pour décider quand une seule clé l’emporte.
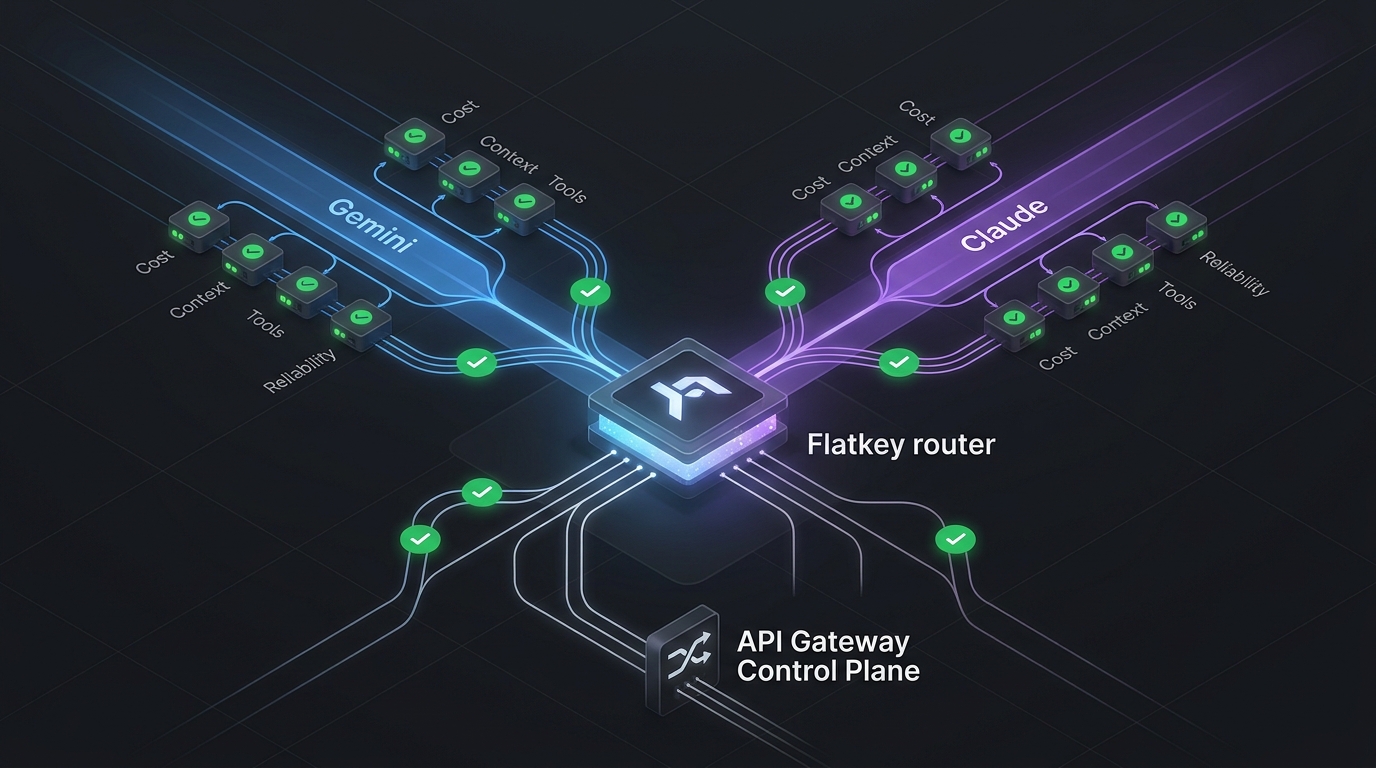
Gemini vs Claude (2026) : quelle IA choisir ?
Claude l'emporte en rédaction et en code agentique ; Gemini en Google Workspace, en recherche et en multimédia. Comparez offres, modèles et tarifs officiels de l'API (octobre 2026), puis testez les deux avec une seule clé.
Les métriques d’API LLM qui comptent vraiment
Une grille d’évaluation pratique pour mesurer la fiabilité, la latence, le coût, les relances, les solutions de repli, l’efficacité du contexte et l’auditabilité d’une API LLM.
Les métriques d’API de routage IA qui comptent vraiment
Un tableau de bord pratique pour les opérateurs afin de mesurer si une API de routage IA améliore la fiabilité, la qualité des bascules, la latence, les coûts et l’observabilité.
Les métriques d’API de génération d’images qui comptent vraiment
Utilisez des métriques pratiques pour une API de génération d’images, comme le coût par image acceptée, le respect du prompt, le taux de réussite des modifications, la latence, le taux de retry et l’impact business.
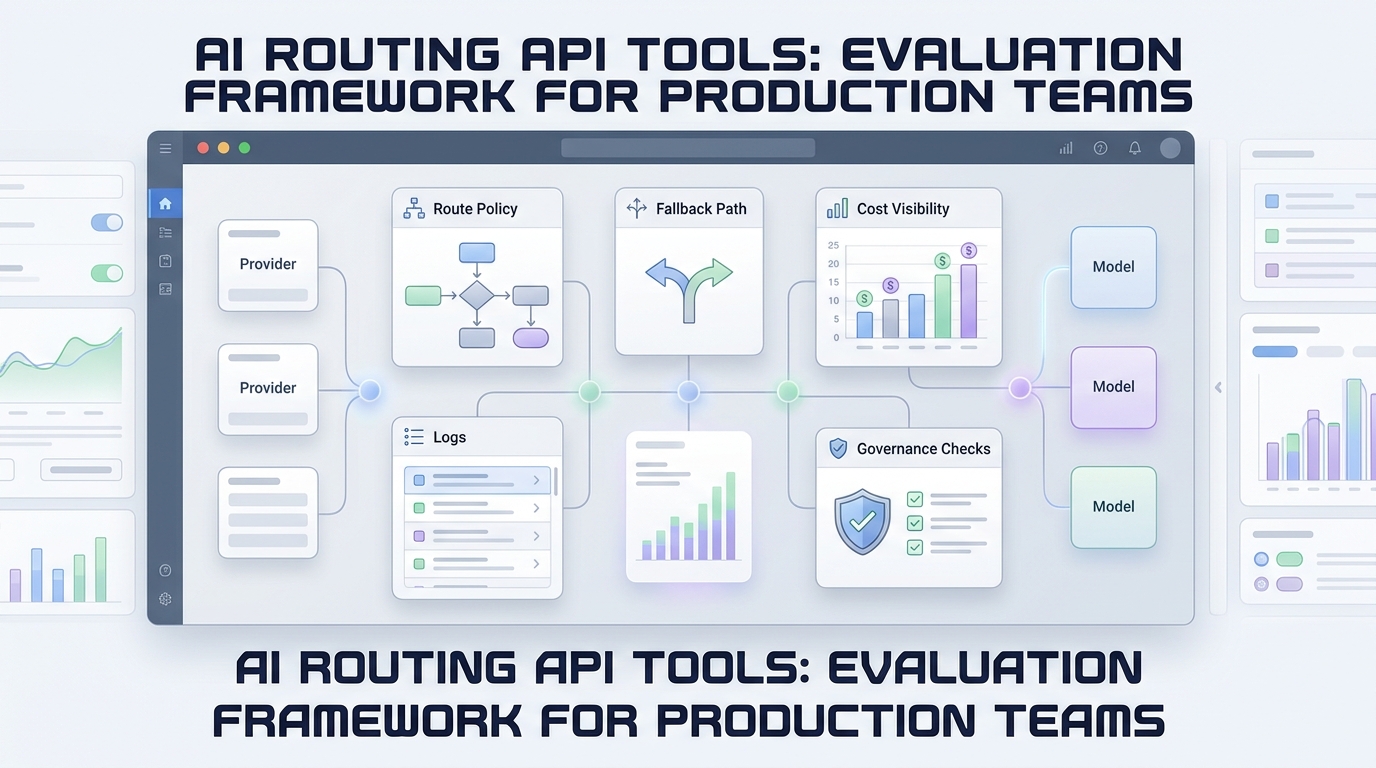
Outils d’API de routage IA : cadre d’évaluation pour les équipes de production
Un cadre d’évaluation pratique pour choisir des outils d’API de routage IA capables de gérer le trafic de production, le contrôle des dépenses et la gouvernance du routage.
Stratégie de repli des modèles : un playbook en 3 workflows
Un playbook de repli des modèles en production avec policy as code, exercices d’échec, un game day de 60 minutes, des garde-fous de release, des déclencheurs de rollback et des règles de récupération sûres.
Checklist de mise en œuvre de l’observabilité de l’IA : 20 étapes de production
Une checklist de mise en œuvre de l’observabilité de l’IA en production avec 20 étapes de lancement, un contrat de télémétrie, un modèle de code, un runbook d’alertes, des tests d’acceptation et une passation de responsabilité.
Observabilité des API LLM : métriques, traces, logs et coût
Un guide de production pour surveiller les API LLM avec des métriques de succès validées, des traces distribuées, des logs structurés sûrs, des SLO, des alertes et le coût par tâche acceptée.
Routage de repli pour API LLM : guide de bascule en production
Un guide de production pour décider quand les requêtes LLM doivent réessayer, basculer vers un autre modèle, changer de modèle ou s’arrêter — sans casser les flux, les outils, les schémas ni les budgets de latence.
Checklist de préparation à la production de l’API Gemini pour les équipes backend
Une checklist de préparation à la production pour les équipes backend qui intègrent l’API Gemini, couvrant les identifiants, les contrats de réponse, les retries, l’observabilité, les coûts, le déploiement et les incidents.
Construisez plus vite avec une seule passerelle IA.
Utilisez flatkey.ai pour gérer modèles, clés, facturation et observabilité depuis une plateforme API.
Commencer