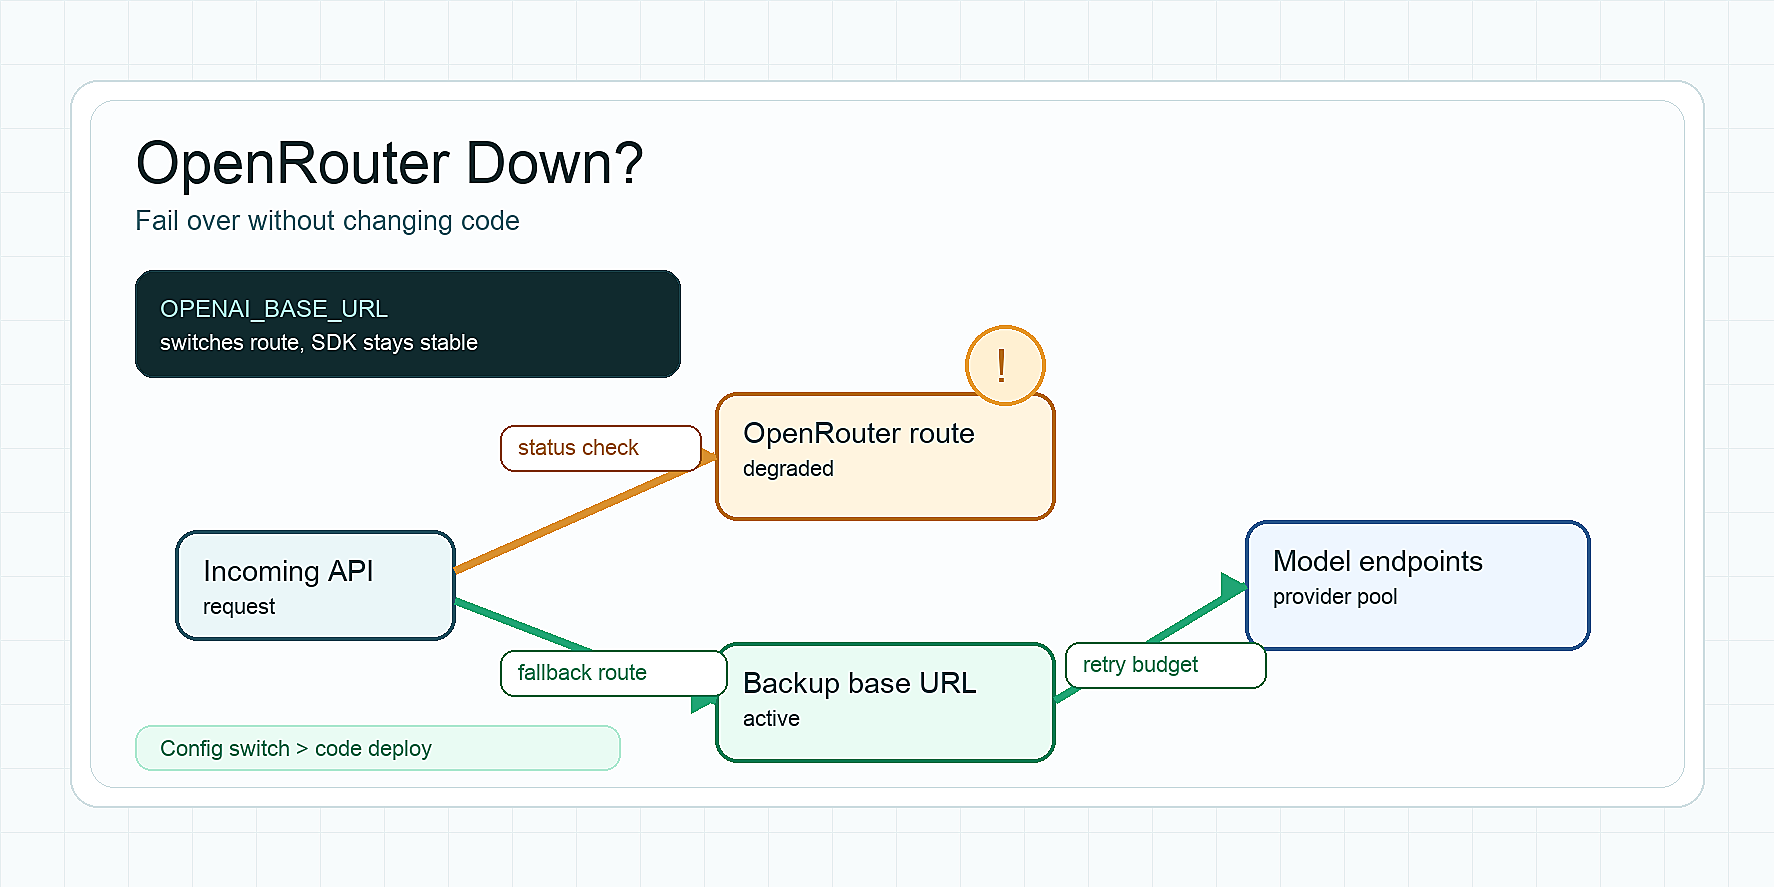
Cuando la gente busca OpenRouter Down, normalmente necesita dos respuestas rápidas: ¿OpenRouter realmente está caído y cómo mantengo las solicitudes en curso sin reescribir mi aplicación?
La respuesta más segura es no cambiar modelos en el código de forma precipitada. Primero confirme si el problema es de toda la plataforma OpenRouter, de un proveedor específico, de una cuenta específica o de su propia cola de reintentos. Luego lleve el failover a la configuración: comprobaciones de estado, presupuestos de reintentos, fallback de proveedor, fallback de modelo y un base_url intercambiable compatible con OpenAI.
Fecha de verificación: 13 de octubre de 2026. No tome este artículo como prueba de que OpenRouter esté caído ahora mismo. Consulte la página de estado de OpenRouter y sus propios registros antes de iniciar un incidente.
La respuesta corta
Si OpenRouter está caído, o si una ruta de OpenRouter está fallando, siga este orden:
- Compruebe
https://status.openrouter.ai/y sus registros de errores. - Separe los errores de la plataforma OpenRouter de los errores del modelo/proveedor upstream.
- Respete
Retry-Afteren respuestas429,503y algunas respuestas de402con presupuesto en vuelo. - Mantenga habilitado
provider.allow_fallbackssalvo que una norma de cumplimiento exija lo contrario. - Añada fallbacks de modelo mediante la configuración de la solicitud cuando el contrato de calidad de la respuesta lo permita.
- Ponga su gateway de API o endpoint de respaldo detrás de una variable de entorno para poder cambiar
base_urlsin editar el código de la aplicación.
Ese último punto es la verdadera forma de hacerlo "sin cambiar código". Su aplicación debe leer el endpoint desde la configuración:
OPENAI_BASE_URL=https://openrouter.ai/api/v1
OPENAI_API_KEY=...
Durante un incidente, su cambio operativo se convierte en:
OPENAI_BASE_URL=https://router.flatkey.ai/v1
OPENAI_API_KEY=...
El código de su SDK permanece igual.
¿Está caído OpenRouter?
No infiera OpenRouter Down a partir de una sola solicitud fallida. Una solicitud fallida puede significar:
| Síntoma | Alcance probable | Qué comprobar primero |
|---|---|---|
| Incidente en la página de estado | Plataforma OpenRouter | Página de estado, cronología del incidente, actualizaciones públicas |
502 Bad Gateway |
El modelo/proveedor elegido puede estar caído | Modelo, metadatos del proveedor, elegibilidad para fallback |
503 Service Unavailable |
Ningún proveedor cumple sus reglas de enrutamiento | Restricciones del proveedor, only, ZDR, requisitos de parámetros |
429 Too Many Requests |
Límite de tasa o capacidad del proveedor | Retry-After, concurrencia de la cola, fallback de proveedor |
402 Payment Required |
Créditos o presupuesto de gasto en vuelo | Retry-After, saldo de la cuenta, límites de la clave |
403 Forbidden |
Presupuesto, permisos, moderación, guardrail | error.metadata, política del workspace/clave |
| La transmisión empieza y luego aparece un evento de error | El proveedor falló después de HTTP 200 |
Inspeccione el cuerpo SSE, no solo el estado HTTP inicial |
La documentación de errores de OpenRouter indica que 502 puede significar que el modelo elegido está caído o devolvió una respuesta inválida, mientras que 503 puede significar que ningún proveedor de modelos disponible cumple los requisitos de enrutamiento. La misma documentación dice que OpenRouter puede devolver Retry-After en 429, 503 y algunas respuestas de 402 con presupuesto en vuelo. Fuente: Errores y depuración de OpenRouter.
OpenRouter ha tenido interrupciones públicas antes. Su postmortem del 17 y 19 de febrero de 2026 describe fallos de la API debidos a una dependencia de caché de terceros y señala que algunos usuarios vieron errores confusos 401 durante el incidente. Esa publicación histórica es útil como contexto, pero no es evidencia de una interrupción actual. Fuente: Postmortem de la interrupción de OpenRouter.
Primeros cinco minutos: triaje de OpenRouter Down
Use esta lista de verificación antes de cambiar el tráfico.
| Minuto | Acción | Decisión |
|---|---|---|
| 0-1 | Compruebe la página de estado de OpenRouter y la cronología de sus alertas. | Si la página de estado confirma un incidente, pase a la preparación del failover. |
| 1-2 | Agrupe los errores por código de estado, modelo, proveedor, ruta y SDK. | Si falla un solo modelo/proveedor, evite suposiciones a nivel de plataforma. |
| 2-3 | Compruebe Retry-After, el número de reintentos y la concurrencia de la cola. |
Detenga las tormentas de reintentos antes de añadir más tráfico de fallback. |
| 3-4 | Compare las cargas de trabajo de pago, gratuitas, por lotes y de agentes. | Preserve el tráfico interactivo antes que los trabajos en segundo plano. |
| 4-5 | Elija la acción de failover más pequeña que restablezca el trabajo visible para el usuario. | Prefiera el fallback de proveedor antes que el fallback entre modelos; prefiera el cambio de configuración antes que el despliegue de código. |
El principal error durante un incidente de OpenRouter Down es hacer que todos los workers reintenten de inmediato. Una tormenta de reintentos puede convertir un error de un proveedor en un problema de cola a nivel de plataforma dentro de su propia aplicación.
Failover sin cambiar código
El patrón sin cambio de código es simple: mantenga estable el uso del SDK y haga que la ruta sea configurable.
import OpenAI from "openai";

export const ai = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
  baseURL: process.env.OPENAI_BASE_URL,
});
Luego mantén la selección del endpoint en el entorno, la configuración de despliegue, los feature flags o tu gestor de secretos:
ai_gateway:
  primary:
    base_url: https://openrouter.ai/api/v1
    key_env: OPENROUTER_API_KEY
  backup:
    base_url: https://router.flatkey.ai/v1
    key_env: FLATKEY_API_KEY
  switch_policy:
    trigger: confirmed_platform_incident_or_error_budget_exhausted
    owner: on_call_engineer
    rollback: after_30_minutes_below_error_threshold
Esto funciona porque el quickstart de OpenRouter dice que su API puede usarse a través del SDK de OpenAI apuntando el SDK a OpenRouter. La misma forma de integración es exactamente lo que hace práctico un gateway de respaldo compatible con OpenAI. Fuente: OpenRouter quickstart.
Usa fallback de proveedor antes de cambiar de modelo
Si OpenRouter es accesible pero un proveedor está teniendo problemas, el fallback de proveedor es la opción de menor riesgo. Mantienes el mismo contrato de modelo y dejas que el enrutamiento pruebe con otro proveedor elegible.
La documentación de enrutamiento de proveedores de OpenRouter dice que las solicitudes se balancean entre los principales proveedores por defecto para maximizar el tiempo de actividad, y que el objeto provider incluye allow_fallbacks, cuyo valor predeterminado es true. La documentación también advierte que establecer sort o order cambia el comportamiento del balanceo de carga, y que los filtros estrictos de proveedor pueden reducir el margen de enrutamiento. Fuente: Enrutamiento de proveedores de OpenRouter.
Empieza con esto:
{
  "model": "anthropic/claude-sonnet-4.5",
  "messages": [{ "role": "user", "content": "..." }],
  "provider": {
    "allow_fallbacks": true
  }
}
Ten cuidado con esto durante un incidente:
{
  "provider": {
    "only": ["one-provider"],
    "allow_fallbacks": false
  }
}
El enrutamiento estricto puede ser correcto para cumplimiento, retención de datos, región o política de precios. Pero el enrutamiento estricto no es una configuración de fiabilidad. Si necesitas enrutamiento estricto para cargas de trabajo sensibles, crea una ruta separada no sensible que pueda hacer failover con más libertad.
Añade fallback de modelo solo cuando los resultados sean intercambiables
El fallback de modelo es más fuerte que el fallback de proveedor. Puede mantener la aplicación en funcionamiento cuando el modelo primario está caído, limitado por tasa o bloqueado, pero también puede cambiar el estilo de salida, la latencia, el costo, la longitud del contexto, el comportamiento de las herramientas y los resultados de evaluación.
La documentación de fallback de modelos de OpenRouter dice que el parámetro models permite proporcionar IDs de modelo en orden de prioridad. Si el primer modelo devuelve un error, OpenRouter prueba con el siguiente. La documentación enumera la limitación por tasa y el tiempo de inactividad entre los errores que pueden activar el fallback. Fuente: Fallbacks de modelos de OpenRouter.
Usa fallback de modelo para tareas con un contrato de equivalencia flexible:
{
  "models": [
    "anthropic/claude-sonnet-4.5",
    "openai/gpt-4o",
    "google/gemini-2.5-pro"
  ],
  "messages": [{ "role": "user", "content": "Resume este hilo de soporte." }]
}
Evita el fallback silencioso de modelo para tareas en las que el modelo exacto forma parte de la garantía del producto:
| Carga de trabajo | Postura sobre fallback de modelo |
|---|---|
| Resumen interno | Generalmente seguro con evaluación y registro |
| Planificación de agente de programación | Posible, pero prueba el comportamiento de llamadas a herramientas y el seguimiento de instrucciones |
| Extracción estructurada | Solo si los esquemas y la validación pasan |
| Texto creativo visible para el cliente | Posible, pero espera diferencias de estilo |
| Salida regulada o contractual | No cambies de modelo en silencio |
| Benchmarking o evaluaciones | No hagas fallback a menos que el fallback sea el sujeto de la prueba |
Una política práctica para incidentes
Esta política es intencionadamente aburrida. Mantiene el trabajo de respuesta a OpenRouter no funciona operativo en lugar de dramático.
openrouter_down_policy:
  status_checks:
    - openrouter_status_page
    - synthetic_chat_completion
    - provider_error_rate_by_model
    - queue_retry_rate

  retry_budget:
    max_attempts: 3
    honor_retry_after: true
    jitter: true
    stop_retrying_on:
      - invalid_credentials
      - spent_budget
      - moderation_block
      - bad_request

  provider_fallback:
    default_allow_fallbacks: true
    loosen_provider_constraints_for:
      - non_sensitive_batch_jobs
      - internal_tools
      - support_summaries

  model_fallback:
    require_contract: equivalent_quality_or_validated_schema
    log_selected_model: true
    disallow_for:
      - evals
      - compliance_outputs
      - customer_promises_about_exact_model

  base_url_failover:
    primary: OPENAI_BASE_URL
    backup_env: OPENAI_BACKUP_BASE_URL
    switch_owner: on_call_engineer
    switch_requires:
      - confirmed_status_incident_or_internal_error_budget
      - rollback_plan
      - public_request_log_enabled
Los campos clave que hay que registrar son:
| Campo | Por qué importa |
|---|---|
base_url |
Demuestra qué gateway gestionó la solicitud |
requested_model |
Muestra el modelo previsto por quien llama |
served_model |
Muestra el modelo realmente utilizado después del fallback |
provider |
Separa los problemas de la plataforma de los problemas del proveedor |
status_code |
Impulsa las decisiones de reintento/failover |
retry_after |
Evita tormentas de reintentos |
attempt |
Muestra si los reintentos están amplificando el tráfico |
fallback_reason |
Hace posible la revisión del incidente |
cost |
Confirma que el fallback no creó un pico inesperado de gasto |
request_id |
Permite a soporte e ingeniería rastrear una solicitud |
Dónde encaja Flatkey
Flatkey es útil cuando quieres que el plan de acción para OpenRouter no funciona viva fuera del código de la aplicación. El posicionamiento del proyecto para Flatkey es una puerta de enlace unificada para API de LLM: una clave, un saldo y un endpoint compatible con OpenAI para enrutar entre modelos oficiales de texto, imagen y vídeo. En este patrón de incidente, el valor práctico es operativo:
- Mantén tu app con una forma de cliente compatible con OpenAI.
- Enruta una carga de trabajo a través de un
base_urlde respaldo sin cambiar la lógica de la app. - Centraliza listas de अनुमति de modelos, subclaves, registros de solicitudes, controles de presupuesto y políticas de fallback.
- Compara el comportamiento del gateway usando evidencias de solicitudes en lugar de anécdotas.
No muevas todas las cargas de trabajo durante un incidente pequeño. Mueve primero una carga de trabajo representativa, observa la tasa de error, la latencia, el modelo seleccionado, el motivo del fallback y el coste, y luego decide si ampliar el cambio.
Lecturas útiles a continuación:
- Límites de velocidad de OpenRouter
- Enrutamiento de fallback para API de LLM
- Estrategia de fallback de modelos
- Gestión de cuotas de API de IA
- Inicio rápido de la API de Flatkey
FAQ de OpenRouter no funciona
¿OpenRouter no funciona ahora mismo?
Consulta primero la página de estado de OpenRouter. Este artículo explica cómo responder cuando las búsquedas de OpenRouter no funciona corresponden a un incidente real o a un fallo local del proveedor; no afirma que OpenRouter no funcione en este momento.
¿Qué debo hacer primero si OpenRouter no funciona?
Pausa los reintentos agresivos, inspecciona los códigos de estado y preserva el tráfico interactivo. Si se confirma el incidente, prioriza el fallback de proveedor antes que el fallback de modelo, y prioriza un cambio de configuración de base_url antes que un despliegue de código.
¿Puedo hacer failover desde OpenRouter sin cambiar código?
Sí, si tu app ya lee el endpoint compatible con OpenAI desde la configuración. Coloca baseURL o base_url detrás de una variable de entorno, mantén estable la forma de la llamada del SDK y cambia el endpoint en la configuración del despliegue.
¿Debería usar fallbacks de modelo de OpenRouter durante una interrupción?
Usa fallbacks de modelo solo cuando el modelo de respaldo sea aceptable para la tarea. Son apropiados para muchos flujos de trabajo internos, pero no para evals, salidas reguladas ni casos en los que a los clientes se les prometió un modelo específico.
¿Cuál es la solución a largo plazo más segura para el riesgo de OpenRouter no funciona?
Diseña para la portabilidad a nivel de ruta: base_url configurable, registro a nivel de solicitud, presupuestos de reintentos, fallback de proveedor, contratos de fallback de modelo probados y una ruta de gateway de respaldo compatible con OpenAI. El objetivo no es evitar cada interrupción; es hacer que el failover sea algo rutinario.