Cara membuat kecerdasan buatan bergantung pada apa yang ingin Anda bangun. Chatbot untuk pelanggan, pengklasifikasi dokumen, dan model bahasa yang dilatih dari nol adalah proyek yang berbeda. Bagi sebagian besar tim produk, langkah pertama yang layak adalah membuat aplikasi yang menggunakan model yang sudah ada melalui API, menguji tugas nyata, serta mengendalikan data, biaya, dan kualitas. Melatih model dari bobot awal hanya masuk akal ketika Anda memiliki data, pengalaman, dan kapasitas komputasi untuk membenarkan pilihan tersebut.
Jawaban singkat: tentukan tugas yang terukur, kumpulkan 30 hingga 100 contoh yang representatif, buat prototipe dengan model yang sudah ada, evaluasi kesalahannya, lalu baru putuskan apakah Anda memerlukan pengambilan dokumen, penyempurnaan fine-tuning, atau pelatihan sendiri. “Membuat AI” tidak mengharuskan versi pertama melatih model baru.
Pilih jenis proyek sebelum memilih teknologi
| Tujuan | Jalur awal yang masuk akal | Siapa yang memelihara model? | Risiko utama |
|---|---|---|---|
| Menjawab pertanyaan atau menghasilkan teks dalam produk | Mengintegrasikan API model | Penyedia API | Jawaban yang salah, biaya, dan pengiriman data |
| Menjawab berdasarkan dokumen perusahaan | API model ditambah pencarian/pengambilan | Penyedia model; tim Anda memelihara indeks | Dokumen kedaluwarsa atau akses tidak semestinya |
| Menyesuaikan model untuk tugas tertentu | Fine-tuning model yang diizinkan | Tim Anda atau layanan yang dipilih | Data yang buruk dan peningkatan yang lebih kecil dari harapan |
| Membuat model bahasa dari awal | Melatih bobot sendiri | Tim Anda | Data, GPU, evaluasi, dan operasi dalam skala besar |
Antarmuka chat dapat menjadi “AI Anda” bahkan ketika model dasarnya berasal dari pemasok. Nilai produk terletak pada tugas yang diselesaikannya, pengalaman, aturan akses, integrasi dengan data, dan evaluasi berkelanjutan. pengantar praktis Google tentang machine learning adalah titik awal yang baik untuk memahami pelatihan, validasi, dan metrik sebelum berinvestasi dalam infrastruktur.
Langkah 1: jelaskan tugas yang kecil dan dapat diverifikasi
Hindari memulai dengan “AI yang melakukan segalanya”. Pilih sesuatu seperti “mengklasifikasikan email dukungan ke dalam lima kategori”, “meringkas tiket dengan langkah selanjutnya”, atau “menjawab pertanyaan tentang basis bantuan”. Untuk setiap tugas, tentukan masukan, keluaran, pengguna, batasan, dan kondisi keberhasilan.
Buat kumpulan awal contoh nyata, tanpa data pribadi yang tidak diperlukan. Catat hasil yang diharapkan dan kasus sulit: bahasa campuran, permintaan tidak lengkap, konten yang tidak ada dalam basis, instruksi berbahaya, dan dokumen yang saling bertentangan. Pisahkan contoh pengembangan dan pengujian. Jika Anda menyesuaikan prompt menggunakan semua contoh, Anda kemudian tidak akan memiliki sampel independen untuk mengetahui apakah sistem membaik.
Pilih metrik yang sesuai dengan tugas. Klasifikasi dapat menggunakan presisi per kategori dan tingkat peninjauan manusia. Jawaban dukungan mungkin memerlukan ketepatan faktual, sitasi sumber, waktu respons, dan biaya per kasus yang diselesaikan. Jumlah token saja tidak mengukur kegunaan.
Langkah 2: buat prototipe dengan API model
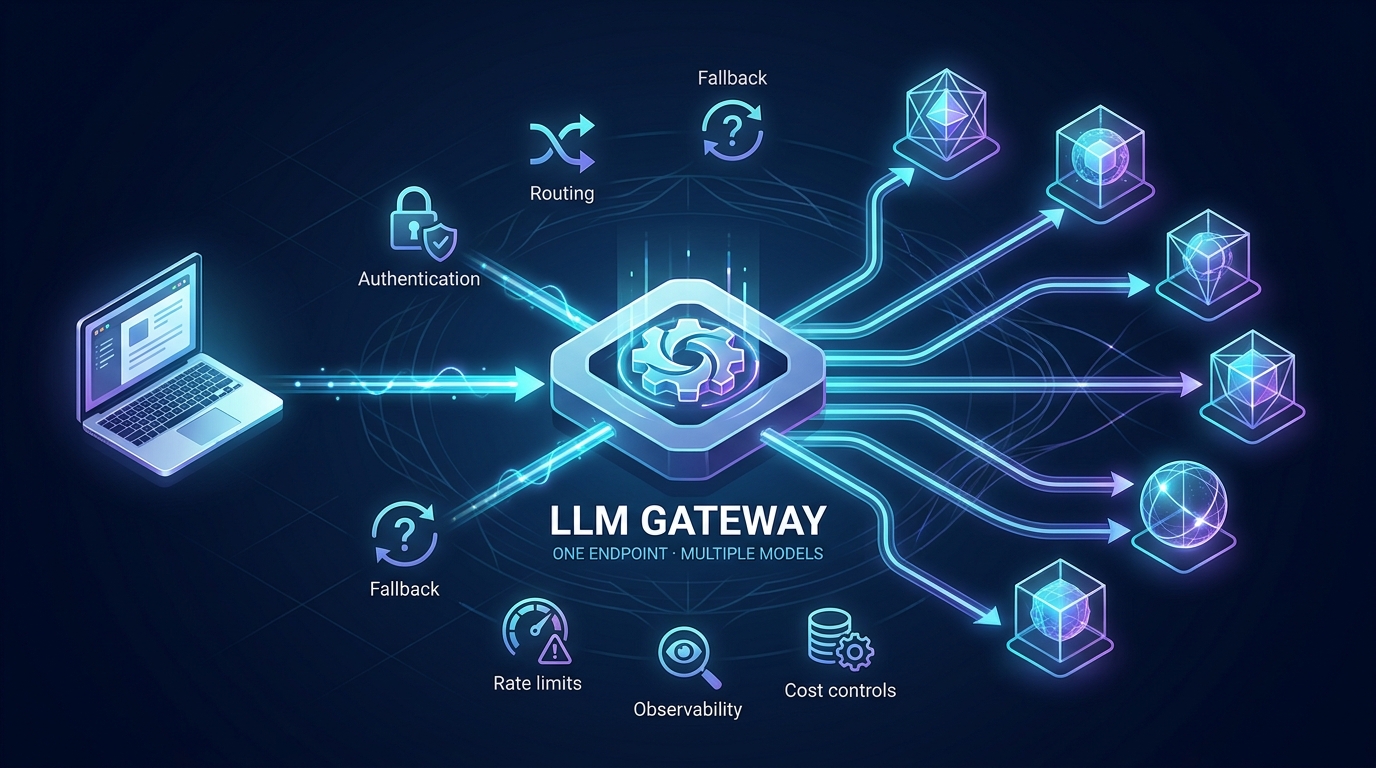
API mengurangi pekerjaan awal untuk menghosting GPU dan menyajikan model. API tidak menghilangkan keputusan produk: tim Anda tetap perlu melindungi kunci, memformat masukan, memvalidasi keluaran, dan menangani kegagalan. antarmuka kompatibel Flatkey mendokumentasikan https://router.flatkey.ai/v1 untuk panggilan chat completions dengan SDK OpenAI. Gunakan kunci yang diterbitkan oleh Flatkey dan alias model terkini dari katalog; jangan keliru membedakan kunci ini dengan kredensial yang diterbitkan langsung oleh OpenAI.
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.flatkey.ai/v1",
    api_key=os.environ["FLATKEY_API_KEY"],
)

answer = client.chat.completions.create(
    model=os.environ["FLATKEY_MODEL"],
    messages=[
        {"role": "system", "content": "Classifique a mensagem em: compra, suporte, cobrança ou outro. Responda apenas com uma categoria."},
        {"role": "user", "content": "Não consigo encontrar a fatura do mês passado."},
    ],
)
print(answer.choices[0].message.content)
Kode ini adalah pengujian integrasi, bukan aplikasi siap pakai.
Validasikan kategori yang dikembalikan terhadap daftar yang diizinkan, catat hanya
data yang diperlukan, tetapkan timeout, dan uji error 400,
401, 429, dan 5xx. Simpan kunci di
server atau di pengelola rahasia; jangan pernah mendistribusikannya dalam
JavaScript publik atau di aplikasi seluler.
Jika memilih untuk memanggil penyedia secara langsung, baca referensi terkini untuk endpoint-nya. Endpoint yang disebut “kompatibel” dapat mencakup permukaan yang berbeda: periksa model, format alat, streaming, batas, dan penagihan. Untuk pengujian pertama, panggilan kecil lebih berguna daripada memigrasikan seluruh trafik sekaligus.
Langkah 3: tingkatkan hasil sebelum melatih
Saat prototipe gagal, klasifikasikan penyebabnya. Apakah permintaannya ambigu? Apakah data kurang? Apakah model menerima terlalu banyak konteks? Apakah respons tidak mengikuti format? Penyebab-penyebab ini memerlukan solusi yang berbeda.
- Prompt dan format: minta keluaran yang singkat dan dapat divalidasi, berikan contoh masukan dan keluaran, lalu periksa skema hasilnya.
- Data eksternal: untuk kebijakan, dokumen, dan katalog yang berubah, ambil informasi terkini dari sistem Anda dan kirimkan hanya cuplikan yang relevan. Evaluasi juga kontrol akses; pencarian yang baik dengan izin yang buruk dapat mengekspos data.
- Alur aplikasi: pecah tugas kompleks menjadi tahap-tahap yang dapat diverifikasi. Gunakan aturan bisnis di luar model ketika aturan tersebut harus deterministik.
- Model: bandingkan lebih dari satu model dalam rangkaian pengujian yang sama. Model yang lebih besar tidak secara otomatis lebih baik untuk klasifikasi singkat.
Pertimbangkan fine-tuning hanya setelah menguji opsi-opsi ini dan mengumpulkan contoh berlabel yang cukup. dokumentasi Hugging Face tentang fine-tuning menjelaskan bahwa proses ini melanjutkan pelatihan model yang telah dilatih sebelumnya pada data untuk tugas atau domain tertentu; hal ini berbeda dengan membuat semua bobot dari nol. Periksa lisensi model, asal data, biaya pelatihan, dan prosedur evaluasi.
Langkah 4: tentukan apakah Anda benar-benar memerlukan model sendiri
Melatih model dari nol memerlukan pengumpulan dan pembersihan data, tokenisasi, arsitektur, GPU, penyimpanan, eksperimen, checkpoint, keamanan, serta tim yang mampu mengevaluasi regresi. Bahkan setelah pelatihan, Anda perlu menyajikan model dengan latensi dan ketersediaan yang dapat diterima. Untuk banyak produk, biaya ini tidak dapat dibenarkan sebelum ada kebutuhan terbukti yang tidak dapat dipenuhi oleh API atau model terbuka.
Jika persyaratannya adalah kontrol atas bobot atau eksekusi pada infrastruktur Anda, bandingkan model terbuka yang sudah dilatih dengan prototipe API Anda. Ukur kualitas, throughput, memori GPU, biaya per tugas, dan upaya operasional. area GPU Compute Flatkey dapat menjadi titik awal untuk meninjau infrastruktur, tetapi ketersediaan, harga, dan konfigurasi harus diperiksa pada saat pengambilan keputusan. Jangan menghitung penghematan dengan asumsi GPU selalu sibuk ketika beban nyata Anda memiliki lonjakan dan jam-jam menganggur.
Arsitektur hibrida juga dimungkinkan: tugas yang dapat diprediksi pada model terbuka di bawah kendali Anda dan kasus sulit pada API model eksternal. Ini memerlukan perutean dan observabilitas yang jelas, bukan sekadar dua endpoint yang dikonfigurasi.
Langkah 5: siapkan aplikasi untuk penggunaan nyata
Sebelum merilisnya kepada pengguna, lakukan peninjauan sederhana:
- Data dan akses: data apa yang masuk ke prompt? Siapa yang dapat mengakses setiap dokumen? Apa yang masuk ke log?
- Kualitas: evaluasi secara terpisah kasus umum, langka, dan adversarial; dokumentasikan tingkat kesalahan yang dapat diterima dan kapan harus mengeskalasi ke seseorang.
- Biaya: perkirakan token input dan output, panggilan per tugas, percobaan berulang, dan harga model saat ini. Pantau biaya per hasil yang berguna.
- Operasi: tentukan timeout, batas, backoff untuk
429, fallback, dan cara untuk menonaktifkan fungsi tanpa memengaruhi bagian produk lainnya. - Perubahan: uji kembali saat mengganti model, prompt, dokumen, SDK, atau penyedia. Versikan konfigurasi yang menghasilkan setiap hasil.
Respons HTTP 200 tidak membuktikan bahwa produk telah menyelesaikan tugas dengan benar. Untuk pengklasifikasi, bandingkan dengan label yang diharapkan. Untuk respons berdasarkan dokumen, periksa apakah kutipan benar-benar mendukung pernyataan tersebut. Untuk konten yang dihasilkan, mintalah peninjauan manusia pada titik dengan dampak terbesar.
Berapa biaya untuk membuat kecerdasan buatan?
Tidak ada satu harga tunggal. Prototipe melalui API dapat dimulai dengan trafik rendah, tetapi biaya meningkat seiring dengan panggilan, token, model yang lebih mahal, alat, dan retry. Sistem dengan retrieval menambahkan pencarian, penyimpanan, dan pemeliharaan dokumen. Fine-tuning dan self-hosting menambahkan GPU dan operasional. Pelatihan dari nol memperbesar kebutuhan ini lebih jauh.
Buat spreadsheet dengan lima variabel: pengguna aktif, tugas per pengguna, panggilan per tugas, token per panggilan, dan tingkat pengulangan. Kalikan dengan harga saat ini dari model yang dipilih dan tambahkan penyimpanan, pencarian, GPU, dan pekerjaan operasional jika ada. Bandingkan alternatif dengan kumpulan pengujian yang sama dan definisi tugas selesai yang sama. halaman harga Flatkey adalah sumber untuk tarif rute Anda; jika menggunakan penyedia lain, lihat halamannya.
Pertanyaan umum
Apakah saya perlu tahu pemrograman untuk membuat AI?
Untuk membuat prototipe sebuah ide, alat visual dapat membantu. Untuk mengintegrasikan AI ke dalam produk dengan data pengguna, seseorang perlu menangani autentikasi, rahasia, validasi, biaya, dan kesalahan. Mengetahui pemrograman atau bekerja dengan tim teknis membuat kontrol ini dapat diverifikasi.
Apa perbedaan antara membuat AI dan melatih AI?
Membuat aplikasi AI berarti membangun alur yang berguna di sekitar sebuah model. Melatih berarti mengubah parameter model dengan data dan komputasi. Sebuah produk dapat menjadi baru dan bernilai tanpa melatih model dari nol.
Bisakah saya membuat AI hanya menggunakan API?
Ya, untuk banyak tugas. API menyediakan kemampuan model, tetapi aplikasi Anda tetap bertanggung jawab atas antarmuka, data, aturan, evaluasi, dan keamanan. Jika memerlukan dokumen yang diperbarui, tambahkan tahap retrieval alih-alih mengasumsikan bahwa model mengetahui informasi internal Anda.
Langkah berikutnya: pilih satu tugas, pisahkan contoh pengujian, dan lakukan panggilan kecil. Perluas cakupan hanya ketika Anda dapat mengukur kualitas dan biaya. Jika aplikasi yang sama perlu menguji beberapa model melalui satu integrasi, pertimbangkan rute chat completions Flatkey dengan model dan batas saat ini dari akun Anda.