Panduan Pemula LLM Gateway: Dari Permintaan Pertama hingga Produksi
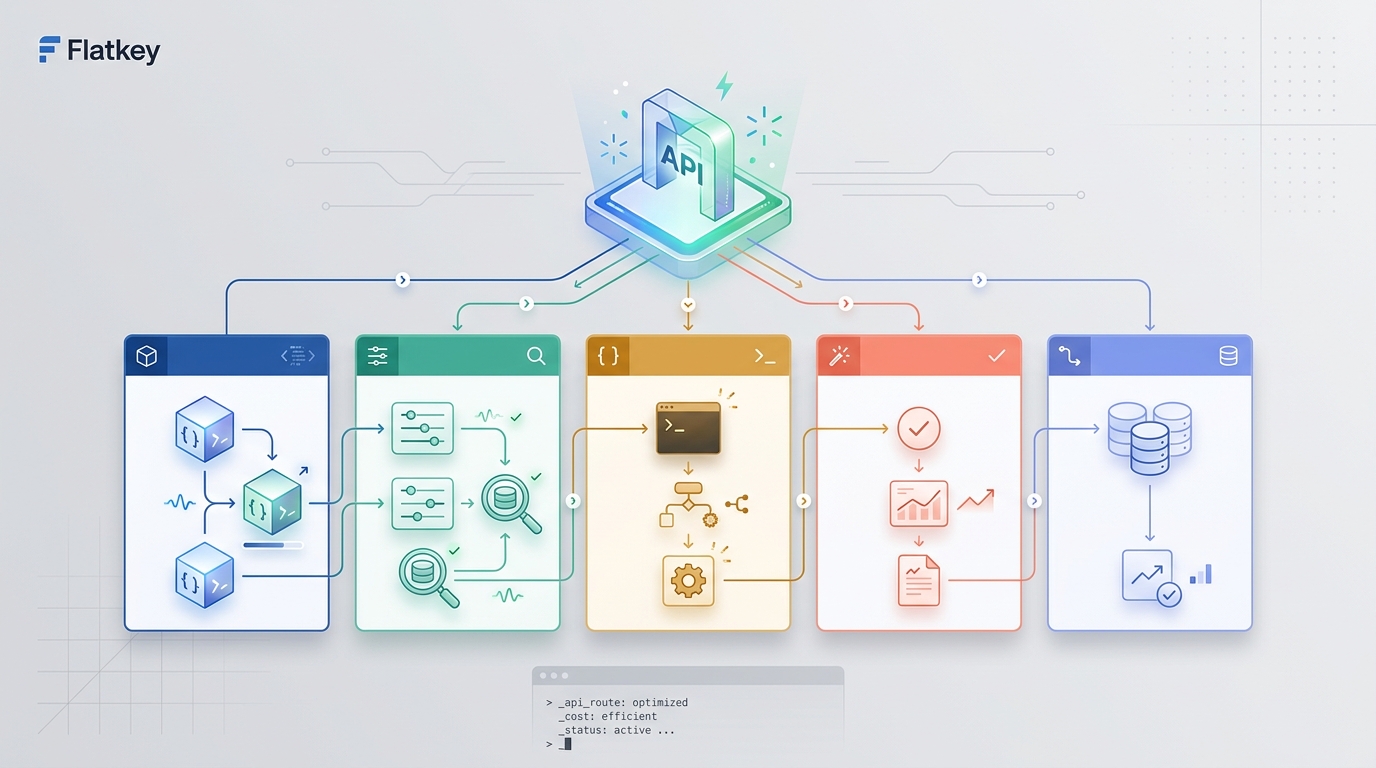
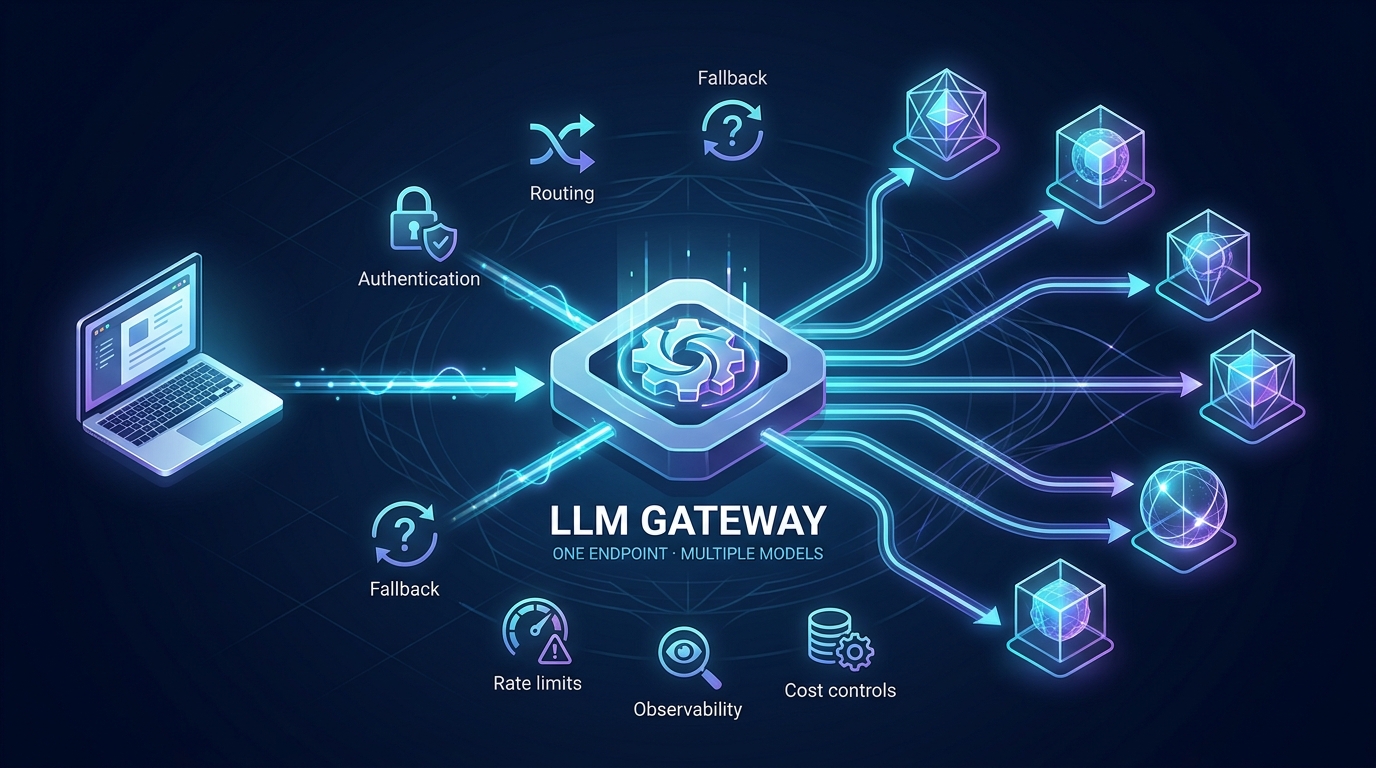
LLM gateway adalah lapisan kontrol antara aplikasi Anda dan satu atau beberapa penyedia model AI. Aplikasi Anda mengirim permintaan ke gateway alih-alih terhubung secara terpisah ke setiap penyedia. Gateway kemudian mengautentikasi permintaan, menerapkan kebijakan, memilih model atau koneksi upstream, meneruskan panggilan, dan mencatat hasilnya.
Itu terdengar seperti plumbing API biasa, tetapi solusi ini menyelesaikan masalah yang cepat muncul dalam produk AI nyata: integrasi model pertama itu sederhana; yang kelima tidak. Setiap penyedia dapat menambahkan kunci, SDK, format permintaan, kebijakan batas laju, bentuk error, halaman penggunaan, dan tagihan baru.
Panduan pemula LLM gateway ini menjelaskan apa yang dilakukan lapisan ini, bagaimana sebuah permintaan melewatinya, bagaimana perbedaannya dari alat-alat di sekitarnya, kapan Anda membutuhkannya, dan bagaimana mengimplementasikan integrasi gateway pertama tanpa overengineering. Panduan ini juga memberi Anda scorecard build-versus-buy, rencana rollout bertahap, dan kriteria penerimaan yang terukur untuk menentukan apakah gateway benar-benar menciptakan nilai bisnis.
Diperbarui 4 Agustus 2026: Panduan ini sekarang mencakup lab 100 permintaan pertama dengan request envelope, tiga batch pengujian, acceptance ledger, dan kriteria keluar produksi, bersama quickstart 15 menit dan checklist rollout.
Keputusan Pemula 60 Detik
Anda kemungkinan belum membutuhkan LLM gateway jika satu aplikasi memanggil satu penyedia, beban kerja masih bersifat eksperimen, dan gangguan singkat atau rotasi kunci manual tidak akan berdampak pada pelanggan.
Anda sebaiknya mengevaluasi gateway ketika dua atau lebih dari pernyataan berikut benar:
- aplikasi Anda menggunakan, atau diperkirakan akan menggunakan, lebih dari satu penyedia model;
- beberapa layanan memerlukan kredensial AI dan kontrol penggunaan;
- batas laju atau insiden penyedia dapat mengganggu alur kerja pelanggan;
- tim finance tidak dapat merekonsiliasi biaya model ke tim, produk, atau pelanggan;
- mengganti model memerlukan deployment aplikasi;
- Anda memerlukan allowlist, kuota, audit trail, atau kebijakan fallback bersama;
- developer membangun ulang adapter penyedia yang sama di beberapa repositori.
Kesalahan pemula adalah mengadopsi gateway karena diagram arsitektur terlihat matang. Adopsilah ketika gateway menghilangkan pekerjaan operasional yang berulang atau menciptakan kontrol yang bisa Anda ukur.
Apa Itu LLM Gateway?
LLM gateway, juga disebut LLM API gateway atau AI gateway, memberi aplikasi antarmuka yang stabil untuk mengakses model AI. Dalam bentuk paling sederhananya, ia menyediakan:
- satu endpoint untuk permintaan model;
- satu batas autentikasi;
- kontrak permintaan dan respons yang konsisten;
- catatan penggunaan terpusat;
- aturan routing yang menentukan ke mana permintaan diarahkan.
Gateway yang lebih canggih juga dapat memberlakukan anggaran, membatasi model yang diizinkan, menangani retry terbatas, melakukan failover antar rute yang setara, menambahkan request ID, menormalkan error, dan mengeluarkan telemetry latensi, token, dan biaya.
Ide penting dalam panduan pemula LLM gateway ini adalah pemisahan tanggung jawab. Kode produk Anda seharusnya menjelaskan pekerjaan yang perlu diselesaikan. Gateway seharusnya menangani akses penyedia, kebijakan routing, dan kontrol operasional.
Application
    │
    │ satu permintaan terautentikasi
    ▼
LLM gateway
    ├── pemeriksaan kebijakan dan kuota
    ├── pemilihan model atau rute
    ├── permintaan ke penyedia
    ├── retry atau fallback aman
    └── catatan penggunaan dan error
             │
             ├── Penyedia A / Model 1
             ├── Penyedia B / Model 2
             └── Penyedia C / Model 3
Mengapa Tidak Memanggil Setiap Penyedia Model Secara Langsung?
Integrasi langsung sering kali merupakan titik awal yang tepat. Jika sebuah prototipe menggunakan satu model, memiliki lalu lintas rendah, dan tidak memerlukan kontrol bersama, menambahkan gateway mungkin justru menambah permukaan tanpa nilai yang sepadan.
Trade-off ini berubah ketika aplikasi membutuhkan beberapa penyedia atau harus beroperasi dengan andal di produksi.
| Aspek | Integrasi penyedia langsung | LLM gateway |
|---|---|---|
| Kredensial | Kunci terpisah di setiap lingkungan | Satu kunci atau identitas yang menghadap aplikasi |
| Kode klien | Klien dan adapter khusus penyedia | Kontrak klien yang stabil bila didukung |
| Pergantian model | Perubahan aplikasi atau konfigurasi per penyedia | Perubahan kebijakan rute atau model secara terpusat |
| Batas rate | Ditangani terpisah untuk tiap penyedia | Batas, antrean, dan kebijakan retry yang terkoordinasi |
| Pelacakan penggunaan | Terpisah di dashboard masing-masing penyedia | Catatan permintaan, token, latensi, dan biaya secara terpusat |
| Failover | Logika kustom di setiap aplikasi | Kebijakan fallback bersama yang memahami kontrak |
| Tata kelola | Diulang di setiap layanan | Allowlist model, kuota, dan bidang audit terpusat |
Gateway tidak membuat perbedaan antar penyedia menghilang. Model masih dapat memiliki kemampuan, batas konteks, skema alat, perilaku streaming, kebijakan keamanan, dan harga yang berbeda. Gateway yang baik membuat perbedaan itu menjadi eksplisit dan mudah dikelola, alih-alih berpura-pura bahwa setiap model bisa saling dipertukarkan.
Cara Kerja LLM Gateway, Langkah demi Langkah
1. Aplikasi mengirim satu permintaan
Aplikasi memanggil base URL yang stabil dan menyediakan kredensial gateway. Dengan gateway yang kompatibel dengan OpenAI, klien OpenAI yang sudah ada mungkin hanya membutuhkan base_url, API key, dan pengenal model yang berbeda.
2. Gateway mengautentikasi dan mengotorisasinya
Gateway memverifikasi proyek, lingkungan, pengguna, atau workload yang memanggil. Setelah itu gateway dapat memeriksa allowlist, kuota, anggaran, atau kebijakan jumlah token maksimum sebelum biaya upstream apa pun terjadi.
3. Aturan routing memilih tujuan
Permintaan mungkin menyebutkan model tertentu. Permintaan juga mungkin menggunakan alias yang dikendalikan tim seperti support-fast. Atau permintaan dapat masuk ke kebijakan routing yang mempertimbangkan kapabilitas, kesehatan, wilayah, latensi, atau biaya.
Untuk implementasi pertama, prioritaskan pemilihan model yang eksplisit atau alias sederhana. Routing dinamis memang berguna, tetapi sebaiknya dilakukan setelah Anda memiliki data evaluasi dan observabilitas.
4. Gateway hanya menerjemahkan apa yang dapat dipertahankannya
Beberapa gateway menampilkan kontrak yang kompatibel dengan OpenAI di berbagai penyedia. Gateway memetakan field ke API penyedia yang dipilih dan menormalkan respons sejauh memungkinkan.
Kompatibilitas memiliki batas. Sebelum mengganti model, uji output terstruktur, pemanggilan tool, gambar, streaming, alasan selesai, penghitungan token, dan perilaku error. “Kompatibel” seharusnya berarti kontrak yang Anda perlukan telah lolos pengujian, bukan sekadar permintaan mengembalikan HTTP 200.
5. Gateway menangani kebijakan operasional
Gateway dapat menerapkan timeout, mematuhi anggaran retry, menjeda rute yang tidak sehat, atau memilih fallback. Retry harus dibatasi. Fallback harus mempertahankan kontrak tugas. Permintaan dengan efek samping tool atau output yang hanya sebagian ter-streaming mungkin memerlukan jalur stop-and-reconcile alih-alih replay otomatis.
Untuk desain produksi yang lebih mendalam, gunakan playbook strategi fallback model dan panduan batas rate LLM.
6. Gateway mencatat apa yang terjadi
Rekaman yang berguna mencakup request ID, aplikasi, lingkungan, model yang diminta, provider dan model yang dipilih, latensi, status, jumlah retry, token input dan output, serta perkiraan biaya.
Jangan log prompt dan respons mentah secara default. Log metadata yang mendukung operasi, dan perlakukan logging konten sebagai keputusan keamanan dan privasi yang terpisah.
Quickstart LLM Gateway 15 Menit
Cara tercepat untuk memahami gateway adalah dengan merutekan satu permintaan yang tidak kritis melaluinya. Gunakan skrip pengujian sisi server, model yang eksplisit, dan prompt dengan hasil yang diharapkan secara jelas. Jangan mulai dengan routing otomatis atau agen produksi.
Langkah 1: Catat baseline provider langsung
Sebelum mengubah apa pun, simpan lima fakta dari panggilan langsung saat ini:
- apakah respons memenuhi tugas;
- latensi total dan waktu ke token pertama jika streaming;
- jumlah token input dan output;
- request ID provider dan bentuk error;
- perkiraan biaya untuk hasil yang diterima.
Ini memberi Anda sesuatu yang konkret untuk dibandingkan. Migrasi gateway tidak berhasil hanya karena mengembalikan HTTP 200.
Langkah 2: Ubah koneksinya, bukan workload-nya
Untuk gateway yang kompatibel dengan OpenAI, perubahan yang terlihat oleh aplikasi biasanya adalah API key gateway, base URL gateway, dan identifier model yang didukung. Nama variabel lingkungan yang tepat bergantung pada client dan gateway.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["LLM_GATEWAY_API_KEY"],
    base_url=os.environ["LLM_GATEWAY_BASE_URL"],
)

response = client.chat.completions.create(
    model=os.environ["LLM_GATEWAY_MODEL"],
    messages=[
        {"role": "system", "content": "Kembalikan hanya JSON yang valid."},
        {"role": "user", "content": "Klasifikasikan tiket ini sebagai billing, bug, atau fitur: Saya dikenakan biaya dua kali."},
    ],
    temperature=0,
)

print(response.choices[0].message.content)
Simpan kredensial di server. Jangan pernah menempatkan master key gateway di JavaScript browser, binary mobile, repositori publik, atau tangkapan layar bersama.
Langkah 3: Bandingkan kontrak respons
Periksa lebih dari sekadar kualitas teks. Konfirmasikan field yang benar-benar digunakan aplikasi Anda:
- ID respons dan nama model;
- alasan selesai;
- penggunaan token;
- urutan event streaming;
- perilaku output terstruktur;
- pengidentifikasi dan argumen panggilan alat;
- status HTTP dan badan error;
- perilaku pembatalan dan timeout.
Kompatibilitas OpenAI mengurangi pekerjaan migrasi, tetapi tidak menjamin bahwa setiap fitur penyedia berperilaku identik. Uji kontrak yang menjadi andalan kode Anda.
Langkah 4: Paksa satu kegagalan yang aman
Gunakan lingkungan pengujian untuk memicu satu kegagalan yang dapat diprediksi, seperti nama model yang tidak valid, timeout yang sengaja sangat singkat, atau kuota pengembangan. Verifikasi bahwa gateway mengembalikan ID permintaan yang dapat dilacak dan error yang dapat diklasifikasikan aplikasi Anda.
Jangan menguji gangguan penyedia dengan membuat beban produksi yang tak terkendali. Tujuannya adalah membuktikan bahwa aplikasi Anda dapat membedakan kegagalan autentikasi, batas laju, timeout, upstream, dan validasi.
Langkah 5: Putuskan dengan tabel penerimaan
| Periksa | Aturan penerimaan pemula |
|---|---|
| Output | Lolos validasi tugas yang sama seperti panggilan langsung |
| Latensi | Berada dalam anggaran yang dinyatakan untuk beban kerja |
| Penggunaan | Field token tersedia atau ketidakhadirannya didokumentasikan |
| Pelacakan | Satu ID permintaan menghubungkan aplikasi, gateway, dan rekaman upstream |
| Error | Aplikasi dapat mengklasifikasikan kegagalan yang dapat di-retry dan yang tidak |
| Biaya | Diukur per hasil yang diterima, bukan per permintaan mentah |
| Rollback | Beralih kembali ke rute langsung didokumentasikan dan diuji |
Jika gateway gagal pada salah satu baris yang disyaratkan, jangan bawa pengujian ke produksi sampai celahnya diperbaiki atau diterima secara eksplisit.
100 Permintaan Gateway Pertama Anda: Laboratorium Pemula
Permintaan pertama yang berhasil membuktikan konektivitas. Itu tidak membuktikan bahwa gateway aman untuk produksi. Tonggak berikutnya yang berguna adalah serangkaian kecil dan terkendali dari 100 permintaan representatif yang menguji kompatibilitas, keterlacakan, penanganan kegagalan, dan disiplin operasional.
Lab ini sengaja dibuat sederhana. Ini tidak memerlukan routing dinamis, platform evaluasi yang kompleks, atau migrasi produksi berskala besar. Lab ini memberikan bukti yang cukup bagi pemula untuk memutuskan apakah akan melanjutkan, memperbaiki celah tertentu, atau kembali ke jalur provider langsung.
Mulailah dengan request envelope
Sebelum mengirim traffic, definisikan metadata yang ikut dalam setiap request atau muncul dalam record gateway yang соответствен. Request envelope minimal dapat terlihat seperti ini:
{
  "request_id": "gw_test_0001",
  "environment": "staging",
  "workload": "support_ticket_classification",
  "requested_route": "ticket-classifier-v1",
  "customer_tier": "internal-test",
  "contains_sensitive_data": false,
  "timeout_ms": 12000,
  "max_attempts": 2,
  "evaluation_case_id": "ticket_014"
}
Gateway Anda mungkin menggunakan header, tag, field metadata, atau konteks sisi server alih-alih JSON persis ini. Bagian pentingnya adalah aplikasi, gateway, dan record evaluasi berbagi identitas request yang stabil.
Jangan menempatkan secret mentah, prompt lengkap, data pribadi, atau teks pelanggan yang rahasia dalam routing tag. Pisahkan metadata operasional dari konten. Jika workload berisi data sensitif, catat klasifikasinya dan terapkan kebijakan logging yang sesuai, alih-alih menyalin kontennya ke field observability.
Batch 1: 40 request normal
Gunakan 40 input representatif yang seharusnya berhasil pada rute utama. Sertakan kasus mudah, umum, dan batasan, bukan mengulangi satu prompt demo.
Untuk setiap request, catat:
- apakah output lolos validasi spesifik tugas;
- ID request gateway dan upstream;
- alias yang diminta dan provider/model yang dipilih;
- latensi total dan waktu ke token pertama jika berlaku;
- token input dan output bila tersedia;
- jumlah retry atau fallback;
- estimasi biaya;
- keputusan akhir: diterima, ditolak, atau ditinjau manual.
Tujuannya bukan skor sempurna. Tujuannya adalah menemukan apakah kegagalan terlihat dan dapat dijelaskan. Output yang ditolak dengan trace lengkap lebih berguna daripada output yang tampak masuk akal tetapi tanpa catatan rute atau penggunaan.
Batch 2: 30 request edge kontrak
Gunakan 30 request berikutnya untuk menguji fitur persis yang dibutuhkan aplikasi Anda. Pilih dari:
- context panjang mendekati batas input yang disetujui;
- output JSON ketat atau dibatasi skema;
- awal streaming, pembatalan, dan penyelesaian;
- tool call dengan argumen valid dan tidak valid;
- input gambar, audio, atau dokumen jika workload menggunakannya;
- prompt multibahasa;
- request kosong, salah format, atau terlalu besar;
- konten yang seharusnya ditolak oleh kebijakan aplikasi.
Jangan berasumsi endpoint yang kompatibel dengan OpenAI membuat setiap perilaku edge identik. Gateway hanya meloloskan batch ini ketika aplikasi Anda dapat mengonsumsi respons dengan benar dan mengklasifikasikan perilaku yang tidak didukung tanpa merusak alur kerja secara diam-diam.
Batch 3: 30 request kegagalan terkontrol
Gunakan lingkungan non-produksi untuk menguji perilaku kegagalan yang terbatas. Sertakan kasus aman seperti:
- nama model atau rute yang tidak valid;
- kredensial pengembangan yang hilang atau dicabut;
- timeout yang sengaja dibuat sangat singkat;
- kondisi kuota pengembangan atau batas laju;
- satu error upstream yang dapat dicoba ulang dan disimulasikan;
- satu kandidat fallback yang sengaja tidak kompatibel dengan kontrak tugas.
Kasus terakhir itu penting. Gateway tidak boleh mengalihkan rute hanya karena ada model lain yang tersedia. Jika rute alternatif tidak dapat mempertahankan output terstruktur, perilaku tool, kebijakan data, atau persyaratan kualitas, tindakan yang benar adalah berhenti dan mengembalikan error terklasifikasi.
Untuk kebijakan kegagalan yang lebih mendalam, gunakan panduan workflow strategi fallback model dan panduan batas laju LLM.
Simpan buku besar penerimaan satu baris per permintaan
Anda bisa memulai dengan spreadsheet atau tabel basis data. Hindari dashboard yang menyembunyikan kasus-kasus dasar sebelum Anda memahaminya.
| Field | Apa yang dijelaskannya |
|---|---|
| Request ID | Menghubungkan bukti aplikasi, gateway, dan upstream |
| Evaluation case | Menunjukkan input mana dan perilaku yang diharapkan yang diuji |
| Requested route | Mencatat apa yang diminta oleh aplikasi |
| Resolved route | Mengungkap penyedia dan model yang benar-benar melayaninya |
| Validation result | Membedakan completion yang berguna dari keberhasilan pada level HTTP |
| Error class | Membedakan kasus stop, retry, reroute, dan rekonsiliasi |
| Attempts | Mengungkap amplifikasi retry tersembunyi |
| Latency | Memastikan beban kerja tetap berada dalam anggaran yang dilihat pengguna |
| Estimated cost | Mendukung perbandingan per hasil yang diterima |
| Rollback needed | Mengidentifikasi kasus yang akan menghalangi perluasan ke produksi |
Hitung setidaknya empat metrik ringkasan setelah 100 permintaan:
accepted completion rate = accepted results / total requests

trace coverage = requests with complete route and request IDs / total requests

retry amplification = total upstream attempts / total gateway requests

cost per accepted result = total estimated cost / accepted results
Jangan membandingkan gateway hanya berdasarkan harga permintaan mentah. Permintaan murah yang gagal validasi, memicu percobaan berulang, atau memerlukan perbaikan manual dapat lebih mahal daripada permintaan dengan harga lebih tinggi yang menyelesaikan tugas dengan benar.
Gunakan kriteria keluar produksi yang eksplisit
Sebelum laboratorium dimulai, tandai setiap kriteria sebagai wajib, opsional, atau tidak berlaku. Lalu putuskan dengan bukti, bukan dengan antusiasme.
| Kriteria keluar | Contoh aturan pemula |
|---|---|
| Kompatibilitas kontrak | Setiap bidang respons dan fitur yang diperlukan lolos |
| Penyelesaian yang diterima | Tidak ada regresi material dari baseline penyedia langsung |
| Pelacakan | Setiap permintaan memiliki ID aplikasi dan ID permintaan gateway |
| Visibilitas rute | Penyedia/model yang terselesaikan tersedia untuk setiap permintaan yang selesai |
| Klasifikasi kegagalan | Kegagalan yang diharapkan dipetakan ke berhenti, coba lagi, alihkan rute, atau rekonsiliasi |
| Anggaran percobaan ulang | Tidak ada permintaan yang melebihi anggaran percobaan atau latensi yang dideklarasikan |
| Logging sensitif | Konten mentah dimatikan kecuali disetujui dan diatur secara terpisah |
| Visibilitas biaya | Biaya per hasil yang diterima dapat dihitung |
| Rollback | Rute langsung dapat dipulihkan tanpa penulisan ulang kode |
Gunakan salah satu dari tiga hasil:
- Lanjut: semua kriteria yang diperlukan lolos; pindahkan satu beban kerja berisiko rendah ke canary kecil.
- Perbaiki: gateway layak digunakan, tetapi ada kekurangan kompatibilitas, telemetri, keamanan, atau kebijakan kegagalan yang teridentifikasi yang menghalangi produksi.
- Berhenti: lapisan ini menambah risiko atau pekerjaan operasional tanpa menyelesaikan masalah yang ada dan terukur.
Lab selesai hanya ketika seseorang memiliki keputusan tersebut, bukti tersimpan, dan jalur rollback tetap tersedia. Itu mengubah “kami terhubung ke LLM gateway” menjadi hasil rekayasa yang dapat diulang.
Tujuh Tugas Inti LLM Gateway
1. Abstraksi penyedia
Gateway menciptakan batas yang stabil antara kode aplikasi dan API penyedia. Ini mengurangi integrasi berulang dan memudahkan migrasi untuk diuji.
2. Autentikasi dan manajemen kunci
Aplikasi melakukan autentikasi ke gateway, sementara kredensial penyedia tetap berada di belakangnya. Ini dapat mengurangi jumlah secret upstream yang didistribusikan di seluruh repositori dan lingkungan deployment. Ini tidak menghilangkan kebutuhan akan rotasi, pembatasan cakupan, redaksi, dan respons insiden. Ikuti panduan manajemen API key yang aman khusus.
3. Routing model
Routing bisa sesederhana “kirim alias ini ke model ini.” Kebijakan yang lebih canggih dapat menggunakan kapabilitas, kesehatan, latensi, wilayah, atau biaya. Jaga agar keputusan tetap dapat dijelaskan: setiap permintaan harus merekam alasan rute dipilih.
4. Kontrol keandalan
Gateway dapat memusatkan timeout, anggaran retry, circuit breaker, health check, dan fallback yang aman. Pemusatan mencegah setiap tim aplikasi menciptakan kebijakan kegagalan yang berbeda.
5. Koordinasi rate limit
Penyedia umumnya membatasi permintaan dan token seiring waktu. Gateway dapat mengoordinasikan konkurensi, antrean, backoff, dan kapasitas rute alih-alih membiarkan banyak layanan bersaing secara membabi buta untuk kuota upstream yang sama.
6. Observabilitas dan alokasi biaya
Gateway melihat setiap permintaan, jadi ini adalah tempat yang alami untuk menambahkan telemetry yang konsisten. Ukur lebih dari sekadar biaya token mentah. Lacak tingkat tugas yang diterima, latensi, retry, dan biaya per tugas yang diterima agar rute yang murah tetapi tidak andal tidak terlihat efisien.
Panduan optimasi biaya AI API menjelaskan cara membandingkan rute menggunakan hasil beban kerja, bukan hanya harga daftar.
7. Kebijakan dan tata kelola
Tim dapat menggunakan gateway untuk membatasi model, menetapkan anggaran, membatasi penggunaan token, memisahkan kunci pengembangan dan produksi, serta membuat catatan penggunaan yang siap diaudit. Kontrol ini menjadi semakin berguna seiring semakin banyak aplikasi dan agen yang berbagi lapisan akses model yang sama.
LLM Gateway vs. Alat Serupa
Pemula sering menggunakan “gateway,” “router,” “orchestration framework,” dan “reverse proxy” secara bergantian. Istilah-istilah ini saling tumpang tindih, tetapi tidak sama.
| Alat | Tugas utama | Biasanya tidak bertanggung jawab atas |
|---|---|---|
| LLM gateway | Akses, kebijakan, routing, keandalan, dan telemetry di seluruh panggilan model | Seluruh alur kerja aplikasi |
| Model router | Memilih model atau rute upstream | Autentikasi, penagihan, tata kelola, atau observabilitas penuh kecuali jika digabungkan |
| Orchestration framework | Mengoordinasikan prompt, alat, memori, agen, dan alur kerja multi-langkah | Akun penyedia pusat dan kontrol penagihan secara default |
| Reverse proxy | Meneruskan lalu lintas jaringan, mengakhiri TLS, dan menerapkan kontrol HTTP generik | Batas token yang sadar model, kontrak fallback, atau pencatatan penggunaan AI secara default |
| Provider SDK | Memanggil API satu penyedia dengan fitur native penyedia | Routing lintas penyedia dan kontrol terpadu |
Anda dapat menggabungkan lapisan-lapisan ini. Sebuah framework agen dapat memanggil LLM gateway. Gateway tersebut dapat menggunakan router di dalamnya. Reverse proxy dapat berada di depan gateway untuk kontrol jaringan.
Kapan Anda Membutuhkan LLM Gateway?
Gunakan panduan pemula LLM gateway ini sebagai tes keputusan. Gateway layak dievaluasi ketika dua atau lebih dari pernyataan ini benar:
- Anda mendukung lebih dari satu penyedia model.
- Beberapa layanan atau agen membutuhkan akses model.
- Kunci penyedia diduplikasi di seluruh lingkungan.
- Tim tidak dapat menjawab aplikasi mana yang menghasilkan biaya.
- Penanganan rate limit berbeda antar codebase.
- Gangguan penyedia atau rute yang menurun mengganggu alur kerja kritis.
- Anda membutuhkan allowlist model, kuota, atau anggaran tingkat lingkungan.
- Beralih model memerlukan perubahan SDK atau deployment yang berulang.
- Operasi memerlukan satu request ID di seluruh lapisan aplikasi dan penyedia.
Anda mungkin belum membutuhkan gateway jika Anda hanya memiliki satu prototipe berisiko rendah, satu penyedia, satu pemilik, dan tidak ada kebutuhan keandalan produksi atau tata kelola. Mulailah dengan akses langsung, tetapi simpan panggilan penyedia di balik adapter aplikasi kecil agar migrasi di masa depan tetap terkendali.
Membangun vs. Membeli LLM Gateway: Skor Praktis
Pertanyaan evaluasi bisnis yang paling penting bukanlah apakah sebuah gateway berguna. Melainkan bagian mana yang harus dimiliki tim Anda. Anda dapat membangun gateway, mengadopsi layanan terkelola, menjalankan proxy open-source, atau mengombinasikannya.
Gunakan scorecard berbobot, bukan memilih dari daftar fitur. Nilai setiap opsi dari 1 sampai 5, kalikan dengan bobotnya, lalu bandingkan totalnya. Bobot di bawah ini adalah titik awal, bukan aturan universal.
| Kriteria | Bobot yang disarankan | Pertanyaan untuk diajukan |
|---|---|---|
| Kesesuaian beban kerja | 25% | Apakah ini mempertahankan streaming, output terstruktur, tools, gambar, detail kesalahan, dan pencatatan token? |
| Keandalan | 20% | Apakah timeout, retry, health check, aturan fallback, dan visibilitas insiden dijelaskan secara eksplisit? |
| Keamanan dan tata kelola | 15% | Bisakah Anda mengisolasi tenant, membatasi model, merotasi kredensial, menyensor konten, dan mengaudit akses? |
| Observabilitas | 15% | Bisakah Anda melacak rute yang diminta, rute yang diputuskan, percobaan, latensi, penggunaan, validasi, dan biaya? |
| Beban operasional | 10% | Siapa yang menangani upgrade, perubahan penyedia, penskalaan, respons on-call, dan retensi data? |
| Kecocokan komersial | 10% | Apakah penagihan mudah dipahami, dapat diekspor, dapat diatribusikan, dan kompatibel dengan pola penggunaan yang Anda harapkan? |
| Jalur keluar | 5% | Bisakah Anda mengekspor konfigurasi dan telemetri, mempertahankan kontrak aplikasi, dan beralih tanpa penulisan ulang? |
Bangun ketika kontrol adalah produknya
Membangun bisa masuk akal ketika perilaku routing merupakan keunggulan kompetitif inti, regulasi mengharuskan model deployment yang tidak dapat dipenuhi layanan yang tersedia, atau skala trafik Anda membenarkan tim platform khusus. Namun, “build” mencakup lebih dari meneruskan permintaan HTTP. Itu berarti memiliki autentikasi, adapter penyedia, perbedaan skema, streaming, normalisasi kesalahan, kuota, observabilitas, manajemen rilis, review keamanan, dan respons insiden.
Beli ketika akses dan operasional bersifat tidak terdiferensiasi
Gateway terkelola biasanya lebih cocok ketika tujuannya adalah menjangkau beberapa penyedia lebih cepat, mengonsolidasikan penagihan dan kredensial, atau memberi beberapa aplikasi control plane bersama. Evaluasinya tetap harus mencakup jalur keluar. Letakkan gateway di belakang adapter aplikasi, pertahankan pengujian kemampuan model, dan hindari menanam asumsi spesifik penyedia di seluruh kode produk.
Gunakan open source ketika Anda dapat mengoperasikannya
Gateway atau proxy open-source dapat memberikan fleksibilitas dan visibilitas kode, tetapi self-hosting memindahkan ketersediaan, penskalaan, upgrade, penyimpanan telemetri, dan patch keamanan ke tim Anda. Bandingkan total kewajiban operasional, bukan hanya lisensi perangkat lunaknya.
Rollout LLM Gateway Empat Tahap
Rollout yang aman membuktikan satu lapisan pada satu waktu. Jangan memulai dengan routing biaya dinamis di seluruh beban kerja.
Tahap 1: Uji bayangan kompatibilitas
Kirimkan set evaluasi yang representatif melalui gateway kandidat tanpa mengubah perilaku produksi. Verifikasi field request, respons, streaming, panggilan alat, output terstruktur, field penggunaan, dan error. Catat setiap ketidaksesuaian. Respons HTTP yang berhasil saja tidak cukup jika kontrak aplikasi berubah.
Kondisi keluar: gateway memenuhi fitur dan pemeriksaan kualitas yang diperlukan oleh beban kerja tanpa kehilangan kontrak yang tidak terjelaskan.
Tahap 2: Satu beban kerja berisiko rendah
Pindahkan satu beban kerja non-kritis yang dapat dibatalkan ke satu rute model yang eksplisit. Pertahankan jalur direct-provider sebelumnya tetap tersedia sebagai rollback. Tambahkan ID request dan telemetry rute yang ter-resolve sebelum menambahkan retry atau fallback.
Kondisi keluar: tim dapat menjelaskan setiap request yang gagal, merekonsiliasi penggunaan, dan melakukan rollback tanpa rilis kode.
Tahap 3: Kebijakan keandalan
Tambahkan timeout terbatas, klasifikasi retry, dan satu fallback yang telah diuji untuk mode kegagalan yang benar-benar Anda amati. Jangan melakukan fallback antar model hanya karena keduanya menerima JSON yang mirip. Rute alternatif harus memenuhi kontrak beban kerja yang sama.
Untuk desain pemulihan yang lebih mendalam, gunakan playbook strategi fallback model dan panduan batas rate LLM.
Kondisi keluar: drill kegagalan menunjukkan bahwa retry dan fallback meningkatkan completion yang diterima tanpa menyebabkan side effect ganda, latensi yang tak terkendali, atau pengeluaran yang tidak terkontrol.
Tahap 4: Control plane produksi bersama
Perluas hanya setelah beban kerja pertama memiliki pengukuran yang stabil. Tambahkan kuota tenant, allowlist model, pemisahan environment, peringatan anggaran, dan proses yang didokumentasikan untuk mengubah rute. Tinjau siapa yang dapat mengubah kebijakan dan bagaimana perubahan diaudit.
Kondisi keluar: beberapa aplikasi dapat menggunakan gateway tanpa kehilangan atribusi biaya, pelacakan insiden, batasan keamanan, atau kontrol rollback.
Peta Error Pemula: Retry, Reroute, atau Berhenti?
Keandalan gateway lebih bergantung pada pengambilan keputusan yang tepat untuk setiap kegagalan daripada jumlah model fallback. Gunakan peta sederhana ini sebagai titik awal.
| Kegagalan | Arti umum | Tindakan pemula |
|---|---|---|
| 400 atau error validasi | Kontrak permintaan tidak valid atau tidak didukung | Hentikan, perbaiki permintaan, dan jangan coba ulang tanpa perubahan |
| 401 atau 403 | Masalah kredensial, izin, allowlist model, atau akun | Hentikan dan beri peringatan; jangan pernah berganti-ganti kunci secara acak |
| 404 model atau route | Pengidentifikasi yang dikonfigurasi tidak tersedia atau salah | Hentikan atau gunakan route ekuivalen yang disetujui secara eksplisit |
| 408 atau timeout klien | Budget latensi pemanggil telah habis | Batalkan jika memungkinkan; coba ulang hanya saat tugas bersifat idempotent |
| 429 rate limit | Kapasitas atau kuota terlampaui | Patuhi panduan retry, antrekan, atau gunakan route ekuivalen yang telah diuji |
| 5xx sebelum output | Gateway atau upstream gagal sebelum respons yang dapat digunakan | Gunakan retry terbatas atau failover yang telah diuji |
| Stream terputus di tengah output | Konten parsial mungkin sudah ada | Hentikan dan rekonsiliasi; jangan asal memutar ulang efek samping |
| Panggilan tool mungkin telah dieksekusi | Status eksternal bisa saja berubah | Periksa idempotency key atau status tool sebelum mencoba ulang |
Kata terbatas itu penting. Setiap workflow membutuhkan jumlah retry maksimum, budget waktu total, dan state terminal. Tanpa itu, sebuah gateway dapat mengubah satu insiden provider menjadi aksi tool duplikat, biaya yang membengkak, dan gangguan yang lebih besar.
Untuk implementasi yang lebih mendalam, gunakan playbook strategi fallback model.
Cara Mengukur Apakah Gateway Berfungsi
Keberhasilan gateway bukanlah jumlah provider yang terhubung. Melainkan peningkatan pada outcome yang diterima dan kontrol operasional.
| Metrik | Hal yang diungkap | Perhitungan ramah pemula |
|---|---|---|
| Accepted completion rate | Apakah pengguna menerima hasil yang dapat digunakan | hasil yang diterima ÷ workflow dimulai |
| Gateway-attributable failure rate | Apakah lapisan baru menciptakan kegagalan | kegagalan gateway ÷ permintaan gateway |
| p95 end-to-end latency | Apakah policy dan failover merugikan pengalaman pengguna | persentil ke-95 dari awal aplikasi hingga hasil diterima |
| Fallback recovery rate | Apakah fallback menyelesaikan kegagalan nyata | hasil fallback yang diterima ÷ percobaan fallback |
| Cost per accepted result | Apakah panggilan yang lebih murah menghasilkan outcome yang lebih murah | total biaya model dan retry ÷ hasil yang diterima |
| Route explainability | Apakah insiden dan tagihan dapat dilacak | permintaan dengan field route yang diminta dan diselesaikan ÷ total permintaan |
| Policy rejection accuracy | Apakah tata kelola memblokir traffic yang dimaksud | permintaan yang ditolak dengan benar ÷ penolakan yang ditinjau |
Tetapkan baseline sebelum migrasi. Lalu bandingkan workload, set evaluasi, segmen traffic, dan jendela waktu yang sama. Jika kualitas turun, latensi meningkat, atau biaya menjadi lebih sulit direkonsiliasi, harga token headline yang lebih rendah bukanlah hasil gateway yang sukses.
Untuk analisis biaya, lanjutkan dengan panduan optimasi biaya API AI. Untuk rencana telemetri yang lebih lengkap, gunakan checklist implementasi observabilitas AI.
Implementasi Pemula: Lima Langkah Praktis
Langkah 1: Tulis kontrak tugas
Pilih satu beban kerja nyata, seperti meringkas tiket dukungan atau mengekstrak field dari faktur. Tentukan:
- input dan output yang diperlukan;
- latensi yang dapat diterima;
- aturan validasi;
- apakah streaming diperlukan;
- apakah tools dapat menimbulkan efek samping;
- apa yang dihitung sebagai hasil yang diterima.
Kontrak ini menentukan apakah fallback aman dan apakah model lain benar-benar setara.
Langkah 2: Pilih antarmuka klien yang stabil
Jika aplikasi Anda sudah menggunakan SDK yang kompatibel dengan OpenAI, gateway yang kompatibel dapat mengurangi pekerjaan migrasi. Flatkey, misalnya, mendokumentasikan base URL yang kompatibel dengan OpenAI di https://router.flatkey.ai/v1.
curl -X POST "https://router.flatkey.ai/v1/chat/completions" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-model",
    "messages": [
      {"role": "user", "content": "Jelaskan error ini dalam bahasa Inggris yang sederhana."}
    ]
  }'
Gunakan secret manager atau variabel lingkungan sisi server untuk kuncinya. Jangan pernah mengirimkannya di kode browser atau klien seluler.
Langkah 3: Mulai dengan routing yang eksplisit
Arahkan beban kerja ke satu model yang sudah diuji. Jika Anda menginginkan independensi aplikasi, petakan alias internal ke model tersebut dalam konfigurasi. Hindari router “model termurah” atau “model terbaik” yang tidak transparan sampai Anda memiliki set evaluasi yang dapat diulang.
Langkah 4: Tambahkan telemetri minimum yang layak
Catat:
- ID permintaan gateway;
- beban kerja dan lingkungan;
- alias yang diminta;
- provider dan model yang ter-resolve;
- status dan latensi;
- jumlah retry dan fallback;
- token input dan output;
- estimasi biaya;
- hasil validasi.
Ini sudah cukup untuk men-debug masalah produksi pertama dan membandingkan alternatif nanti.
Langkah 5: Tambahkan satu kebijakan kegagalan yang dibatasi
Mulailah dengan timeout dan anggaran retry kecil untuk kegagalan sementara. Tambahkan fallback hanya setelah memverifikasi bahwa rute alternatif lolos kontrak tugas yang sama. Untuk streaming atau panggilan tool yang menimbulkan efek samping, tentukan bagaimana aplikasi mendeteksi penyelesaian parsial dan merekonsiliasi state.
Minggu Pertama Anda dengan LLM Gateway
Gunakan rencana adopsi tujuh hari alih-alih memindahkan setiap aplikasi sekaligus.
Hari 1: Inventarisasi satu beban kerja
Catat provider saat ini, model, SDK, kredensial, fitur yang diperlukan, traffic, anggaran latensi, sensitivitas data, dan penanggung jawab rollback.
Hari 2: Jalankan tes kompatibilitas
Kirim prompt yang representatif melalui jalur langsung dan jalur gateway. Sertakan input panjang, output terstruktur, streaming, tools, dan kasus error yang diharapkan jika beban kerja menggunakannya.
Hari 3: Tambahkan identitas request dan catatan penggunaan
Pastikan aplikasi menyimpan ID request gateway dan dapat menghubungkannya ke model, route provider, latensi, token, jumlah retry, dan hasil validasi tanpa mencatat konten sensitif secara default.
Hari 4: Definisikan kebijakan kegagalan
Klasifikasikan error menjadi stop, retry, failover ekuivalen, fallback lintas model, dan rekonsiliasi manual. Tetapkan anggaran total untuk retry dan latensi.
Hari 5: Kirim canary produksi kecil
Gunakan satu beban kerja berisiko rendah dan porsi traffic yang sengaja kecil. Pertahankan jalur langsung tetap tersedia. Bandingkan tingkat completion yang diterima, latensi p95, dan biaya per hasil yang diterima.
Hari 6: Tinjau kontrol keamanan dan pengeluaran
Pisahkan kredensial development dan produksi, batasi model yang diizinkan, tetapkan kuota, dan verifikasi siapa yang dapat melihat atau mengubah kebijakan routing. Gunakan panduan pengelolaan API key yang aman untuk checklist kontrol yang lebih lengkap.
Hari 7: Buat keputusan go, fix, atau stop
- Go: pemeriksaan kontrak yang diperlukan lulus dan canary memenuhi ambang penerimaannya.
- Fix: arsitekturnya baik, tetapi ada satu celah yang terukur yang menghalangi perluasan.
- Stop: gateway menambah risiko operasional atau biaya tanpa manfaat kontrol saat ini.
Dokumentasikan keputusan dan tanggal peninjauan berikutnya. Stop yang terkontrol lebih baik daripada migrasi yang tidak terukur.
Kesalahan Umum Pemula
Menganggap setiap model dapat saling menggantikan
Meski sintaks request sudah dinormalisasi, kemampuan dan perilaku output tetap berbeda. Uji fitur spesifik yang digunakan workload Anda.
Melakukan routing sebelum mengukur
Routing dinamis tanpa data evaluasi memindahkan logika keputusan ke kotak hitam. Tetapkan baseline terlebih dahulu, lalu perkenalkan kebijakan yang terukur.
Melakukan retry pada setiap error
Error autentikasi, request invalid, budget habis, dan fitur yang tidak didukung bukan bersifat sementara. Retry hanya error yang mungkin berhasil nanti, dan gunakan exponential backoff dengan jitter bila sesuai.
Mencatat konten sensitif secara default
Prompt dapat berisi data pelanggan, source code, atau data bisnis. Pisahkan observabilitas metadata dari retensi konten.
Menyembunyikan route yang terselesaikan
Jika aplikasi meminta alias, catat provider dan model aktual yang digunakan. Jika tidak, insiden, regresi kualitas, dan perubahan biaya akan sulit dijelaskan.
Mengukur harga alih-alih hasil
Harga token yang lebih rendah tidak menjamin biaya workload yang lebih rendah. Sertakan kegagalan validasi dan retry dalam perhitungan biaya Anda.
Bagaimana Flatkey Sesuai dengan Pola Gateway
Flatkey menyediakan lapisan akses model dan alat terpadu dengan satu kunci, catatan penggunaan bersama, dan endpoint model yang kompatibel dengan OpenAI. Untuk klien yang sudah kompatibel, jalur migrasinya adalah mengubah base URL, menggunakan kunci Flatkey, memilih model yang didukung, dan menguji kontrak beban kerja.
Itu membuat Flatkey relevan ketika Anda ingin mengurangi penyebaran akun penyedia tanpa membangun dan mengoperasikan sendiri lapisan agregasi. Jika Anda mengevaluasi desainnya alih-alih mencari gambaran umum untuk pemula, baca panduan arsitektur AI API gateway yang mendetail. Jika Anda siap memigrasikan klien, gunakan daftar periksa API gateway yang kompatibel dengan OpenAI.
Jelajahi model Flatkey, tinjau dokumentasinya, atau buat kunci API ketika Anda siap menguji beban kerja nyata.
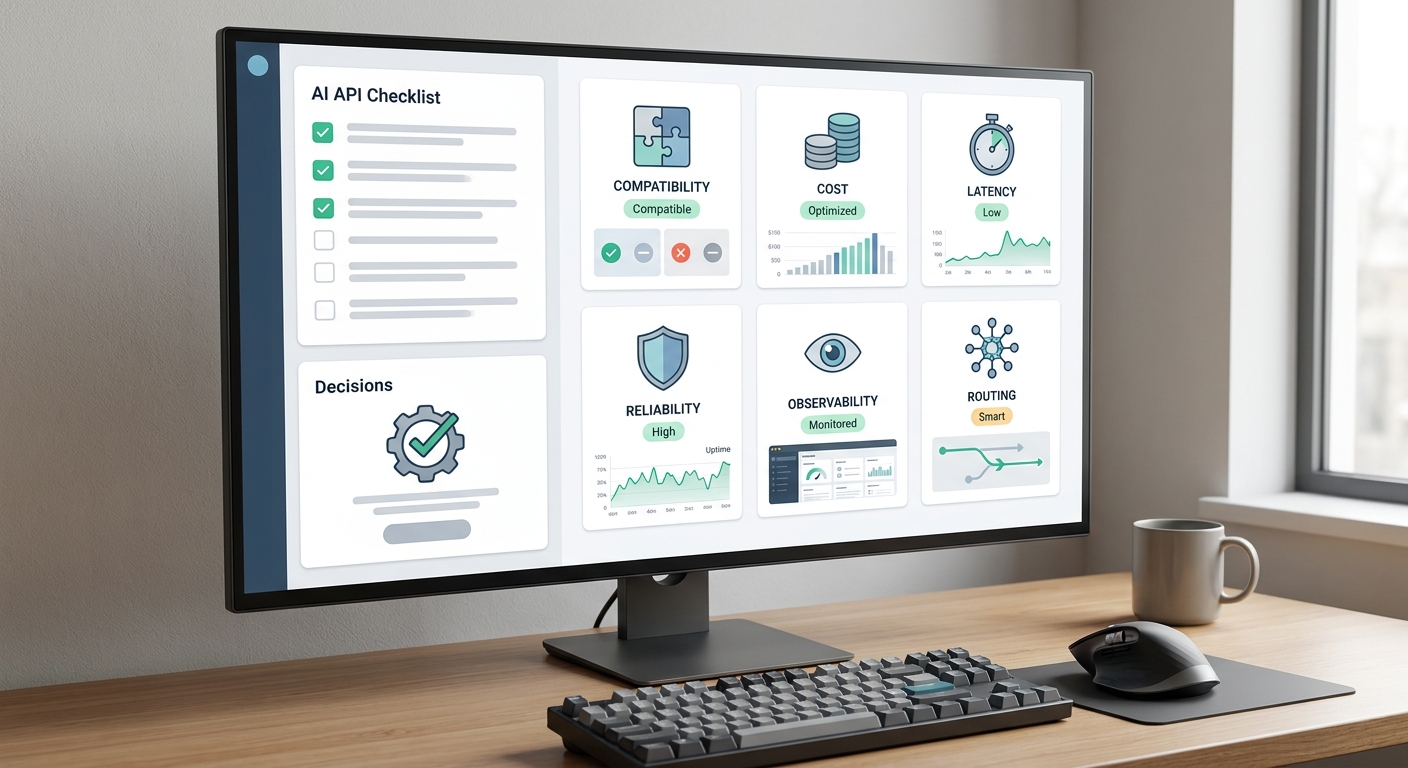
Daftar Periksa Panduan Pemula LLM Gateway
Sebelum mengirim traffic produksi melalui LLM gateway, pastikan:
- [ ] Satu kontrak beban kerja telah mendefinisikan kriteria keberhasilan.
- [ ] Aplikasi menggunakan kredensial gateway sisi server.
- [ ] Model yang dipilih telah lulus pengujian representatif.
- [ ] Output terstruktur, alat, dan streaming telah diuji jika digunakan.
- [ ] Timeout dan error yang dapat dicoba ulang didefinisikan secara eksplisit.
- [ ] Fallback mempertahankan kontrak beban kerja.
- [ ] Setiap permintaan menerima ID permintaan yang dapat dilacak.
- [ ] Provider dan model yang diselesaikan dicatat.
- [ ] Token, latensi, percobaan ulang, validasi, dan biaya diukur.
- [ ] Kuota pengembangan dan produksi dipisahkan.
- [ ] Pencatatan konten mentah dinonaktifkan atau diatur secara sengaja.
- [ ] Jalur rollback langsung didokumentasikan.
- [ ] Ada baseline untuk completion yang diterima, latensi, dan biaya per hasil yang diterima.
- [ ] Opsi build, hosted, dan self-hosted dibandingkan berdasarkan beban operasional dan jalur keluar.
- [ ] Peluncuran pertama menggunakan satu rute eksplisit sebelum routing dinamis diperkenalkan.
Pertanyaan yang Sering Diajukan
Apakah LLM gateway sama dengan API gateway?
Ini adalah API gateway khusus untuk traffic model AI. Ia dapat menyediakan fungsi API gateway standar seperti autentikasi dan rate limiting, ditambah routing yang sadar model, penggunaan token, normalisasi error khusus AI, dan fallback yang sadar kontrak.
Apakah LLM gateway meng-host model?
Tidak selalu. Beberapa gateway merutekan ke provider eksternal, beberapa terintegrasi dengan infrastruktur inferensi, dan beberapa mendukung keduanya. Tanyakan di mana inferensi terjadi, provider mana yang benar-benar melayani setiap model, dan bagaimana rute itu muncul dalam catatan penggunaan.
Apakah LLM gateway mengurangi biaya?
Ini dapat membantu dengan memusatkan data penggunaan, menerapkan kuota, mengurangi integrasi duplikat, dan memungkinkan perubahan rute yang terukur. Penghematan tidak otomatis. Bandingkan biaya per tugas yang diterima, termasuk percobaan ulang dan kegagalan kualitas.
Apakah saya bisa menggunakan LLM gateway dengan OpenAI SDK?
Ya, jika gateway mengekspos endpoint yang kompatibel dengan OpenAI dan mendukung fitur yang digunakan aplikasi Anda. Ubah base URL dan kredensialnya, lalu uji kontrak beban kerja secara lengkap, alih-alih berasumsi kompatibilitas yang sempurna.
Apakah gateway merupakan single point of failure?
Bisa. Evaluasi arsitektur deployment-nya, health check, failover upstream, perilaku timeout, observabilitas, komitmen layanan, dan jalur rollback. Memusatkan kontrol meningkatkan leverage operasional, jadi gateway itu sendiri harus diperlakukan sebagai infrastruktur produksi.
Haruskah startup membangun atau membeli LLM gateway?
Bangun jika perilaku gateway adalah pembeda inti, Anda memerlukan kendala deployment yang tidak biasa, atau Anda memiliki tim untuk mengoperasikannya. Beli jika tujuan utamanya adalah akses yang lebih cepat, lebih sedikit integrasi provider, penggunaan yang terpadu, dan kontrol yang dibagikan. Tim kecil juga bisa mulai langsung dan bermigrasi nanti jika panggilan ke provider sudah diisolasi di balik adapter.
Apa yang harus saya uji sebelum memindahkan traffic produksi?
Uji kontrak beban kerja yang tepat: streaming, output terstruktur, tools, input media, batas konteks, perilaku error, penanganan timeout, field penggunaan, dan kualitas output. Lalu jalankan canary berisiko rendah dengan jalur rollback langsung dan bandingkan completion yang diterima, latensi p95, serta biaya per hasil yang diterima terhadap baseline sebelum gateway.
Model Mental Sederhana
Versi paling singkat dari panduan pemula LLM gateway ini adalah:
Aplikasi Anda meminta pekerjaan AI. Gateway memutuskan apakah permintaan diizinkan, ke mana harus diarahkan, bagaimana kegagalan harus ditangani, dan apa yang harus dicatat.
Mulailah dengan satu beban kerja, satu antarmuka yang stabil, routing yang eksplisit, telemetry minimum yang layak, dan satu kebijakan kegagalan yang terbatas. Tambahkan routing yang canggih hanya setelah Anda dapat mengukur kualitas, latensi, keandalan, dan biaya.