AI API料金比較(2026年10月):OpenAI vs Claude vs Gemini vs Qwen vs DeepSeek vs Kimi
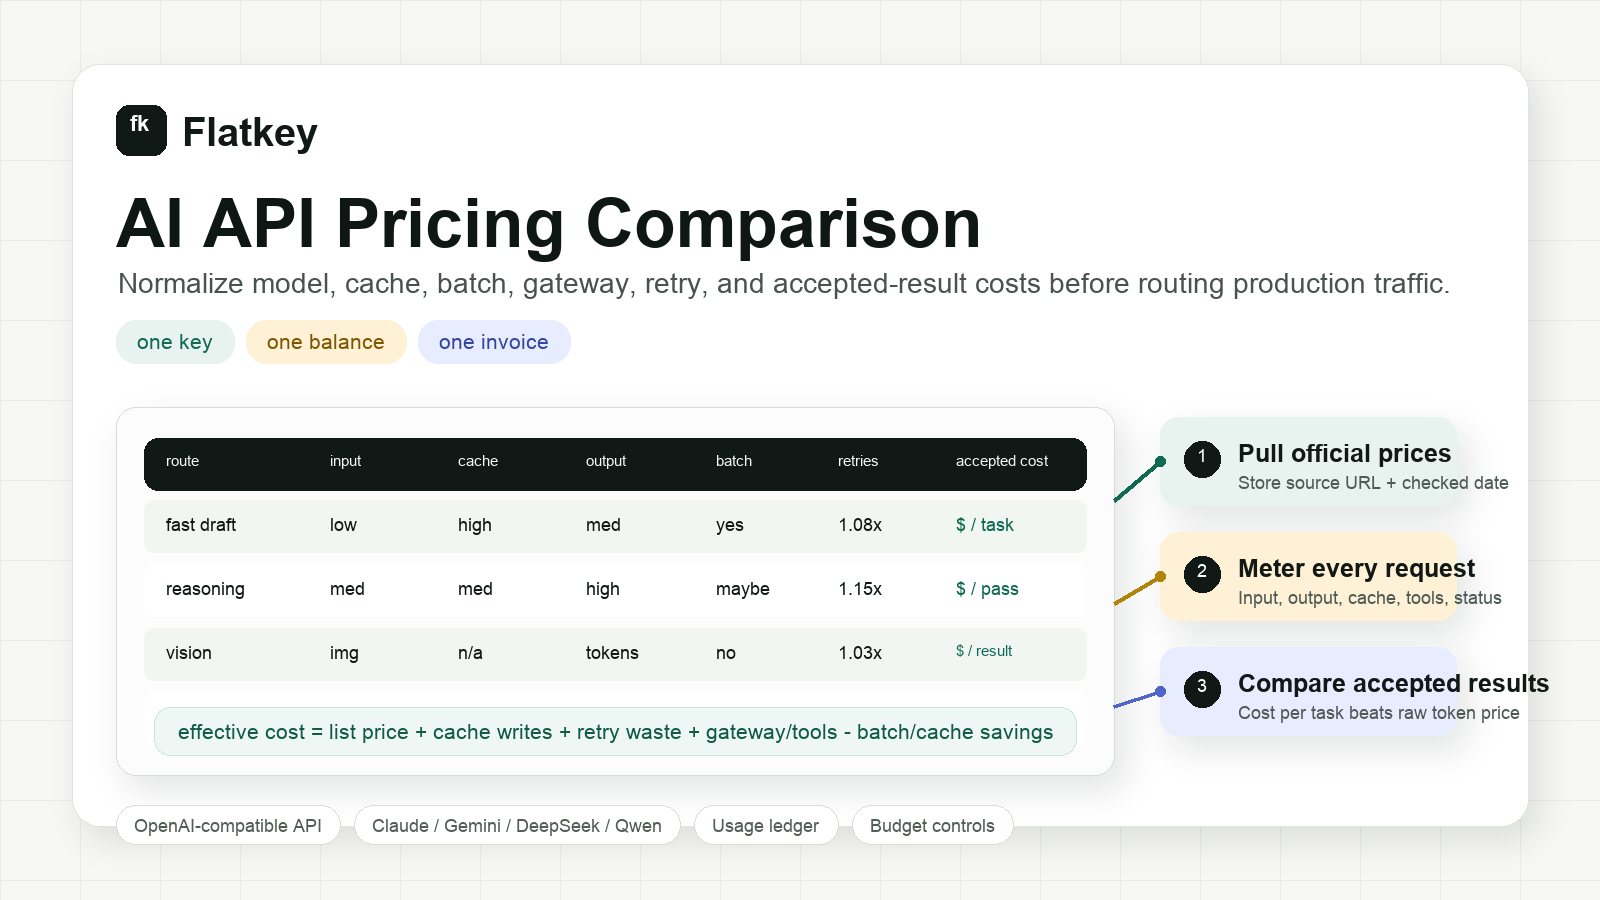
2026年10月のAI API料金には100倍の開きがあります。OpenAI gpt-6-lunaやClaude Haiku 5.5などの低価格モデルは入力100万トークンあたり$0.10、出力100万トークンあたり$0.50、gpt-6-solやClaude Sonnet 5.5などの実用的な中位モデルは$2 / $10、gpt-6-astraやClaude Fable 5.1などの最上位モデルは$10 / $50です。 Gemini、Qwen、DeepSeek、Kimiは、ほとんどの価格帯でこれらを下回り、DeepSeekのflashモデルはオフピーク時に$0.15 / $0.60、Qwen 3.8 Maxは$2 / $6です。Geminiの2つの料金は期間限定のキャンペーン価格で、December 1, 2026とJanuary 1, 2027にそれぞれ2倍になるため、現時点の比較には日付の明記が欠かせません。
このページは、トークン単位で料金を支払い、6社の料金ページを行き来せずに1つの表で比較したい個人開発者や小規模チーム向けです。以下の数値はすべて各社の公式料金ページに基づき、2026年10月22日に確認しています。価格帯別の比較表、順位を左右する割引(キャッシュ、バッチ、オフピーク)、3種類のワークロードの月額費用の計算例、料金計算ツール、選び方をまとめました。
AI API料金表:6社を一覧で比較
100万トークン(MTok)あたりの米ドル建て料金。標準のリアルタイム処理、短いコンテキストの場合です。
| プロバイダー | 最上位(入力 / 出力) | 中位(入力 / 出力) | 低価格(入力 / 出力) |
|---|---|---|---|
| OpenAI | gpt-6-astra $10 / $50 | gpt-6-sol, gpt-6.1-sol $2 / $10 | gpt-6-luna $0.10 / $0.50 |
| Anthropic Claude | Fable 5.1 $10 / $50; Opus 5.5 $4 / $20 | Sonnet 5.5 $2 / $10 | Haiku 5.5 $0.10 / $0.50(100Kまでのプロンプト) |
| Google Gemini | Gemini 4 Argon:Nov 30, 2026まで$2 / $10、その後は$4 / $20 | Gemini 3.8 Flash:Dec 31, 2026まで$0.75 / $3.75、その後は$1.50 / $7.50 | Gemini 3.1 Flash-Lite $0.25 / $1.50 |
| Alibaba Qwen(国際版) | qwen3.8-max $2 / $6 | qwen3.7-plus $0.40 / $1.60 | qwen3.8-flash $0.15 / $0.47 |
| DeepSeek | deepseek-v4-pro:オフピーク$0.66 / $1.98(ピーク$1.32 / $3.96) | 該当なし | deepseek-flash:オフピーク$0.15 / $0.60(ピーク$0.30 / $1.20) |
| Moonshot Kimi | kimi-k3 $3 / $15 | kimi-k2.6 $0.95 / $4 | 該当なし |
出典は最初の列にリンクしています。すべて2026年10月22日に確認済みです。「最上位」「中位」「低価格」は、各社の位置付けに基づく独自の分類であり、品質のベンチマークではありません。モデルの実行検証は行っておらず、料金のみの比較です。
注目すべきポイント
- OpenAIとAnthropicは現在、各価格帯の料金が同じです。 最上位は$10 / $50、中位は$2 / $10、低価格は$0.10 / $0.50です。両社を選び分ける基準は、料金よりも自分のタスクでの品質になります。
- OpenAI、Claude、Gemini 4 Argon、Kimi K3では、出力料金が入力の5倍です。 Qwen 3.8 Max(3倍)とDeepSeek(3倍から4倍)は差が小さく、長い回答を生成する用途に有利です。
- Geminiの現在の料金はキャンペーン価格です。 Gemini 4 ArgonはDecember 1, 2026に、Gemini 3.8 FlashはJanuary 1, 2027に2倍になります。その日付を超えてサービスを運用するなら、改定後の料金で予算を組みましょう。
- DeepSeekは時間帯別料金を採用しています。 ピーク時間帯(月曜日から金曜日の01:00から04:00および06:00から10:00 UTC)は、オフピーク料金の2倍です。
比較結果を左右する割引
実際の支払額が定価どおりになることは、あまりありません。以下は2026年10月22日に確認した、各社の公式な割引の仕組みです。
| プロバイダー | キャッシュ済み入力 | バッチ / 非同期 | その他 |
|---|---|---|---|
| OpenAI | キャッシュ読み取りは入力料金の5%から10%(gpt-6.1-solは$0.10、gpt-6-solは$0.20)。キャッシュ書き込みは1.25倍(30分)または2.5倍(12時間) | BatchとFlex:50%割引 | 高速処理:2倍。地域別データレジデンシーエンドポイント:+10%。272Kトークンを超えるプロンプト:入力2倍、出力1.5倍 |
| Claude | 読み取りは入力料金の2.5%から10%。書き込みは1.25倍(5分)または2倍(1時間) | バッチ:50%割引 | 米国内限定の推論:1.1倍 |
| Gemini | MTokあたりArgonは$0.10、3.8 Flashは$0.075 | バッチ:50%割引 | Flashモデルに無料枠あり(データは製品改善に使用) |
| Qwen | キャッシュヒット時は入力料金の10% | バッチ:50%割引 | 一部モデルで期間限定割引あり |
| DeepSeek | キャッシュヒット時はオフピークでMTokあたり$0.003から | 該当なし | オフピークはピークの半額 |
| Kimi | K3のキャッシュ済み入力は$0.30 | バッチ:標準料金の60% | 累計$5のチャージで$5のクーポン |
実務上、次の2点が重要です。
- 処理を待てるワークロードなら、プロバイダーを切り替えるよりバッチ処理が有効です。 Claude Sonnet 5.5のバッチ料金は$1 / $5で、November 30までのGemini 4 Argonのバッチ料金と同じです。
- 長いコンテキストを繰り返し送信するエージェントでは、入力料金よりキャッシュ料金が重要です。 50Kトークンのプレフィックスをキャッシュから読み取る場合、Sonnet 5.5やgpt-6.1-solでは$0.005ですが、キャッシュなしでは$0.10かかります。プロンプトキャッシュのROIガイドをご覧ください。
3種類のワークロードで見る月額費用の計算例
すべて2026年10月22日時点の定価、標準ティア、キャッシュなしで計算しています。
ワークロードA:サポート問い合わせの分類。 リクエスト数は100万件、1件あたり入力800トークン、出力50トークン(入力800M、出力50M)。
| モデル | 月額費用 |
|---|---|
| gpt-6-luna | $105 |
| Claude Haiku 5.5 | $105 |
| qwen3.8-flash | $143.50 |
| deepseek-flash(オフピーク) | $150 |
| Gemini 3.1 Flash-Lite | $275 |
ワークロードB:RAGによる回答。 リクエスト数は200,000件、1件あたり入力4,000トークン、出力500トークン(入力800M、出力100M)。
| モデル | 月額費用 |
|---|---|
| qwen3.7-plus | $480 |
| Gemini 3.8 Flash(キャンペーン価格) | $975 |
| Kimi K2.6 | $1,160 |
| gpt-6-sol / Claude Sonnet 5.5 | $2,600 |
ワークロードC:コーディングエージェント。 セッション数は5,000件、1件あたり入力200,000トークン、出力20,000トークン(入力1,000M、出力100M)。
| モデル | 月額費用 |
|---|---|
| deepseek-v4-pro(オフピーク) | $858 |
| qwen3.8-max | $2,600 |
| Gemini 4 Argon(キャンペーン価格、Nov 30まで) | $3,000 |
| Kimi K3 | $4,500 |
| Claude Opus 5.5 | $6,000 |
| gpt-6-astra / Claude Fable 5.1 | $15,000 |
コーディングエージェントでは通常、キャッシュヒット率が70%から90%に達するため、上記の費用のうち入力にかかる部分を大幅に削減できます。以下の計算ツールに実際のキャッシュヒット率を入力してみてください。
AI API料金計算ツール
# List prices per 1M tokens (input, output), checked Oct 22, 2026 on each provider's pricing page
PRICES = {
    "gpt-6-astra": (10.00, 50.00), "gpt-6-sol": (2.00, 10.00), "gpt-6-luna": (0.10, 0.50),
    "claude-fable-5-1": (10.00, 50.00), "claude-opus-5-5": (4.00, 20.00),
    "claude-sonnet-5-5": (2.00, 10.00), "claude-haiku-5-5": (0.10, 0.50),
    "gemini-4-argon": (2.00, 10.00),      # $4 / $20 from Dec 1, 2026
    "gemini-3.8-flash": (0.75, 3.75),     # $1.50 / $7.50 from Jan 1, 2027
    "gemini-3.1-flash-lite": (0.25, 1.50),
    "qwen3.8-max": (2.00, 6.00), "qwen3.7-plus": (0.40, 1.60), "qwen3.8-flash": (0.15, 0.47),
    "deepseek-v4-pro-offpeak": (0.66, 1.98), "deepseek-flash-offpeak": (0.15, 0.60),
    "kimi-k3": (3.00, 15.00), "kimi-k2.6": (0.95, 4.00),
}

def monthly(model, requests, tokens_in, tokens_out, batch=False):
    pin, pout = PRICES[model]
    cost = requests * (tokens_in * pin + tokens_out * pout) / 1_000_000
    return cost * (0.5 if batch else 1.0)

for m in ["gpt-6-luna", "claude-haiku-5-5", "qwen3.8-flash", "deepseek-flash-offpeak"]:
    print(f"{m:26s} ${monthly(m, 1_000_000, 800, 50):,.2f}")
リクエストに実際にいくらかかったかを確認するには、APIが返すusageフィールドを参照します。
curl -s https://api.openai.com/v1/chat/completions \
  -H "Authorization: Bearer $OPENAI_API_KEY" -H "Content-Type: application/json" \
  -d '{"model":"gpt-6-luna","messages":[{"role":"user","content":"Say hi"}]}' \
  | python3 -c "import sys,json; print(json.load(sys.stdin)['usage'])"
// Node: same check with the OpenAI SDK
import OpenAI from "openai";
const client = new OpenAI();
const r = await client.chat.completions.create({
  model: "gpt-6-luna",
  messages: [{ role: "user", content: "Say hi" }],
});
console.log(r.usage); // { prompt_tokens, completion_tokens, ... }
余計な費用をかけずに選ぶには
- 最安のセルではなく、用途から考えましょう。 分類や抽出に最上位モデルが必要になることはほとんどありません。$0.10のモデルなら、月1Mリクエストで費用は約$100です。
- 自分の入力・出力比率で比較しましょう。 長い回答を生成するワークロードでは、出力料金の倍率が低いQwen 3.8 MaxとDeepSeekが有利です。
- 日付の欄を確認しましょう。 Geminiのキャンペーン価格とDeepSeekのピーク時間帯は、コードを変更しなくても請求額を変動させます。
- モデルごとにトークン数を計測しましょう。 トークナイザーはモデルによって異なります。Anthropicによると、Claude 4.7+のトークナイザーは、同じテキストでも旧Claudeモデルよりトークン数が約30%多くなります。
- 処理の段階ごとにモデルを振り分けましょう。 ルーティングには安価なモデルを使い、難しい処理にだけ高性能なモデルを使います。詳しくはモデルルーティングポリシーのガイドで解説しています。
1つのキーで比較:Flatkeyの料金
Flatkeyは、前払いクレジット方式で、OpenAIとAnthropicに互換性のある1つのAPIキーを通じて6社すべてのモデルを提供しています。2026年10月22日時点のFlatkeyモデル一覧には、以下の料金が掲載されていました。
| モデル | プロバイダー定価(入力 / 出力) | Flatkey(入力 / 出力) |
|---|---|---|
| Claude Sonnet 5.5 | $2 / $10 | $1.60 / $8 |
| gpt-6-sol | $2 / $10 | $1.20 / $6 |
| Gemini 4 Argon | $2 / $10(キャンペーン価格) | $1.60 / $8 |
| qwen3.8-max | $2 / $6 | $1.60 / $4.80 |
| Kimi K3 | $3 / $15 | $1.80 / $9 |
| Gemini 3.8 Flash | $0.75 / $3.75(キャンペーン価格) | $1.20 / $6 |
最後の行に注目してください。Googleの3.8 Flashのキャンペーン期間中は、Flatkey経由よりGoogleを直接呼び出すほうが安くなります。請求を1つにまとめたい場合や、フォールバック、ベンダーをまたいで使える1つのSDKが必要な場合には、ゲートウェイを利用する価値があります。ゲートウェイ自体の料金については、AIゲートウェイの料金をご覧ください。
各プロバイダーの詳しい解説
- Anthropic API料金:Claude全モデル、キャッシュ、バッチ、利用額の上限
- Gemini API料金:キャンペーン期間と無料枠
- DeepSeek API料金:ピーク・オフピーク料金
- Qwen APIガイド:リージョンとOpenAI互換の設定
- Kimi API料金とK3ガイド
よくある質問
2026年10月時点で最も安いAI APIはどれですか?
ここで取り上げた6社のうち、入力の最低定価は100万トークンあたり$0.10(gpt-6-lunaとClaude Haiku 5.5)で、出力の最低料金はqwen3.8-flashの$0.47です。DeepSeekのキャッシュヒット時の料金は、オフピークで100万トークンあたり$0.003からです。
AI API料金はどのように計算されますか?
トークン単位の従量課金です。入力トークン数に入力単価を掛けた金額と、出力トークン数に出力単価を掛けた金額を合計します。単価はいずれも100万トークンあたりです。キャッシュ済み入力、バッチ処理、長いコンテキストへの追加料金、Web検索などのツール呼び出しによって、合計額が変わります。
ClaudeはOpenAIより高いですか?
2026年10月時点の定価では、そうではありません。両社とも3つの価格帯が$10 / $50、$2 / $10、$0.10 / $0.50です。Claude Opus 5.5($4 / $20)と直接対応する料金のOpenAIモデルはありません。
出力トークンが最も安いAI APIはどれですか?
qwen3.8-flashが出力100万トークンあたり$0.47で最安です。続いてgpt-6-lunaとClaude Haiku 5.5が$0.50、deepseek-flashのオフピーク料金が$0.60です。
これらの料金にはプロンプトキャッシュが含まれていますか?
いいえ。メインの表はキャッシュなしの標準料金です。キャッシュ済み入力の料金は、OpenAIとAnthropicでは入力料金の2.5%から10%、Qwenでは10%です。Gemini、DeepSeek、Kimiについては別途記載しています。
AI APIの料金はどのくらいの頻度で変わりますか?
頻繁に変わります。Geminiの2つの料金は今後3か月以内の決まった日付に変更され、新しいモデルのリリース時にも通常、新たな料金が設定されます。予算を確定する前に公式ページを再確認してください。
出典
- OpenAI API料金、Anthropic料金、Gemini API料金、Alibaba Model Studio料金、DeepSeek料金、Kimi料金、すべて2026年10月22日に確認
- Flatkeyモデル一覧、2026年10月22日に確認