VRAM-Leitfaden für 32B- und 70B-Modelle: Single-GPU- und Multi-GPU-Optionen
Die praktische Antwort auf 70b model vram requirements lautet: Ein 70B-Modell kann mit gängiger 4-Bit-Quantisierung ungefähr 35 GB bis 45 GB belegen, mit 8-Bit-Quantisierung und Laufzeit-Overhead etwa 70 GB bis 90 GB, und mehr als 140 GB vor Overhead bei FP16 oder BF16. Ein 32B-Modell ist einfacher, benötigt aber ebenfalls Planung: etwa 18 GB bis 24 GB für 4-Bit-Inferenz, 32 GB bis 45 GB für 8-Bit-Inferenz und mehr als 64 GB vor Overhead bei FP16 oder BF16.
Diese Zahlen sind nur das Minimum. Die tatsächlichen 70b model vram requirements hängen von der Kontextlänge, der Batch-Größe, dem KV-Cache, der Serving-Engine, Tensor Parallelism, LoRA-Adaptern, dem Optimizer-Status und davon ab, wie viel Sicherheitsreserve Sie benötigen, bevor der Produktionsverkehr mit Out-of-Memory-Fehlern ausfällt.
Dieser Leitfaden richtet sich an KI-Ingenieure, Plattformteams und technische Einkäufer, die entscheiden, ob ein 32B- oder 70B-Workload auf eine einzelne GPU passt, mehrere GPUs benötigt oder lieber über eine Model-API statt über gemietete GPU-Kapazität bereitgestellt werden sollte.
Geprüft am 13. Oktober 2026.
70b model vram requirements: die schnelle Antwort
Verwenden Sie dies als ersten Größenansatz und benchmarken Sie dann Ihr exaktes Modell, das Kontextfenster und Ihren Serving-Stack.
| Workload | 32B-Ausgangspunkt | 70B-Ausgangspunkt | Praktischer Hinweis |
|---|---|---|---|
| 4-Bit Local Inference | 24 GB können funktionieren, 48 GB sind komfortabler | 48 GB können einige quantisierte Modelle laden, 80 GB sind sicherer | Gut für Entwicklung, Demos, interne Tools und Serving mit geringer Parallelität. |
| 8-Bit-Inferenz | 48 GB oder 80 GB | 80 GB Minimum, 96 GB oder 141 GB sicherer | Laufzeit-Overhead und KV-Cache entscheiden oft darüber, ob der Endpunkt stabil ist. |
| FP16/BF16-Inferenz | 80 GB | 2x80 GB, 141 GB, 180 GB oder größere Multi-GPU-Systeme | Allein der Speicher für die Gewichte beträgt etwa 2 Byte pro Parameter. |
| Ollama-ähnliches Single-User-Local-Serving | 24 GB bis 48 GB | 48 GB bis 80 GB | Die Frage nach den ollama 70b model vram requirements dreht sich hauptsächlich um quantisierte Modellgröße plus Kontext. |
| Produktion mit vLLM- oder SGLang-Serving | 48 GB bis 80 GB | 80 GB, 96 GB, 141 GB oder Multi-GPU | Lassen Sie Spielraum für KV-Cache, Batching und die Wiederherstellung nach fehlgeschlagenen Requests. |
| QLoRA-Fine-Tuning | 48 GB für eingeschränkte Läufe, 80 GB sicherer | 48 GB ist eine Forschungsuntergrenze; 80 GB oder Multi-GPU ist sicherer | Die qlora 70b model vram requirements hängen stark von Sequenzlänge und Batch-Strategie ab. |
Die Abkürzung für Käufer:
- Wählen Sie 24 GB nur für 32B-quantisierte Experimente oder sehr eingeschränkte 70B-CPU/GPU-Split-Workflows.
- Wählen Sie 48 GB für 32B-Komfort, 70B 4-Bit-Local-Inference oder eng abgestimmte QLoRA-Experimente.
- Wählen Sie 80 GB für ernsthafte 70B-Inferenz, größere Kontextfenster oder zuverlässigeres QLoRA.
- Wählen Sie 96 GB, 141 GB, 180 GB oder Multi-GPU, wenn Sie Produktionsspielraum, längere Kontexte, höhere Parallelität oder FP16/BF16 benötigen.
Wenn das Produkt nur Modellausgaben und keine direkte Hardwarekontrolle benötigt, vergleichen Sie einen Model/API-Weg, bevor Sie einen GPU-Vertrag unterschreiben. Flatkey gibt Teams einen Schlüssel, ein Guthaben, eine Rechnung und ein Nutzungsprotokoll über Hunderte offizieller Modelle und Tools hinweg, was eine sauberere Grundlage sein kann, wenn die Auslastung ungewiss ist.
Warum Modellgewichte nicht der vollständige VRAM-Bedarf sind
Die einfachste Speicherabschätzung lautet:
model_weight_memory = parameter_count x bytes_per_parameter
Das ergibt eine nützliche Untergrenze:
| Modellgröße | FP16/BF16-Untergrenze | 8-Bit-Untergrenze | 4-Bit-Untergrenze |
|---|---|---|---|
| 32B | etwa 64 GB | etwa 32 GB | etwa 16 GB |
| 70B | etwa 140 GB | etwa 70 GB | etwa 35 GB |
Aber ein laufendes LLM benötigt mehr als nur Gewichte:
| Speicherkomponente | Warum sie wichtig ist |
|---|---|
| Quantisierungsmetadaten | 4-Bit- und 8-Bit-Formate benötigen Skalierungen, Gruppenmetadaten und Framework-Puffer. |
| KV-Cache | Längere Kontextfenster und mehr gleichzeitige Anfragen verbrauchen zusätzlichen Speicher. |
| Laufzeit-Puffer | vLLM, SGLang, TensorRT-LLM, llama.cpp und Ollama reservieren jeweils unterschiedlich Speicher. |
| CUDA Graphs und Kernels | Serving-Engines können Arbeitsbereich für Geschwindigkeit und Stabilität reservieren. |
| LoRA-Adapter | Feinabgestimmte Adapter benötigen weniger Speicher als vollständige Gewichte, brauchen aber dennoch Budget. |
| Sicherheitsreserve | Produktionsendpunkte brauchen Platz für Prompt-Variationen, Wiederholungen und Deployment-Abweichungen. |
Deshalb ist 70b model vram requirements quantized nicht dasselbe wie „die 4-Bit-Datei ist 35 GB“. Ein quantisiertes 70B-Modell mit 35 GB bis 45 GB kann auf einer 48-GB-GPU laden, aber ein längerer Kontext, ein größerer Batch oder ein schwererer Runtime-Stack kann trotzdem fehlschlagen.
Single-GPU-Optionen für 32B- und 70B-Modelle
24-GB-GPUs
24-GB-Karten sind nützlich für 32B-Modelle in 4-Bit-Form, kleinere 70B-Tests mit teilweiser CPU-Auslagerung und Entwicklerexperimente, bei denen Latenz nicht das Hauptziel ist.
Betrachten Sie 24 GB nicht als komfortable Antwort auf 70b model vram requirements. Es kann mit aggressiver Quantisierung, reduziertem Kontext, CPU-Offload oder lokalem Testen im Stil von llama.cpp nützlich sein, ist aber in der Regel kein Produktions-Tier für 70B-Serving.
Am besten geeignet für:
- 32B-Inferenz mit 4 Bit.
- Kleine Kontextfenster.
- Lokales Testen durch einen einzelnen Benutzer.
- Prototypevaluation, bevor größere GPUs gemietet werden.
Zu beachten:
- 70B erfordert oft CPU-Offload oder sehr enge Einstellungen.
- Lange Prompts können den KV-Cache schnell erschöpfen.
- Der Durchsatz ist begrenzt.
48-GB-GPUs
48GB ist die erste ernstzunehmende Single-GPU-Klasse für quantisierte 70B-Arbeiten. Sie kann viele 70B-Inferenz-Workloads mit 4 Bit ausführen, wenn Kontext und Parallelität kontrolliert werden. Sie ist außerdem eine praktische Untergrenze für viele QLoRA-Experimente, im Einklang mit dem ursprünglichen QLoRA-Ergebnis, das ein großes Fine-Tuning der 65B-Klasse auf einer einzelnen 48GB-GPU zeigt.
Am besten geeignet für:
- Lokale 70B-Inferenz mit 4 Bit.
- 32B-Inferenz mit 8 Bit.
- 32B-Fine-Tuning mit Spielraum für Adapter und längeren Kontext.
- Enge qlora fine-tuning 70b model vram requirements-Experimente.
Zu beachten:
- 70B mit 8 Bit hat in der Regel nicht genug Spielraum.
- Bereitstellung mit langem Kontext kann ein 70B-4-Bit-Modell an seine Grenzen bringen.
- Die Batchgröße ist begrenzt.
80-GB-GPUs
80GB ist die gängigste praktische Antwort für ernsthafte 70B-Arbeiten. A100-80GB- und H100-80GB-Klasse-GPUs können viele quantisierte 70B-Inferenz-Workloads mit mehr Kontextspielraum als 48GB bewältigen, und sie sind ein deutlich komfortablerer Ausgangspunkt für QLoRA.
Am besten geeignet für:
- 70B-Inferenz mit 4 Bit und Produktion-ähnlichen Kontexttests.
- 70B-Inferenz mit 8 Bit, wenn Runtime und Kontext passen.
- 32B-Inferenz mit FP16/BF16 und Overhead.
- 70B-QLoRA mit eingeschränkten, aber realistischen Einstellungen.
Zu beachten:
- 70B mit FP16/BF16 benötigt in der Regel mehr als eine 80GB-GPU.
- Hohe Parallelität erfordert weiterhin sorgfältige KV-Cache-Planung.
- Die Node-Form und der Preis des Anbieters können ebenso wichtig sein wie der VRAM.
96GB-, 141GB- und 180GB-GPUs
Neuere High-Memory-Beschleuniger verändern die Frage nach der Single-GPU. Eine 96GB-Karte bietet mehr Spielraum für 70B mit 8 Bit oder größere quantisierte Kontexte. H200-Klasse-Speicher mit 141GB kann viele 70B-Workloads mit deutlich mehr Spielraum unterbringen. B200-Klasse-Konfigurationen mit 180GB treiben die Single-GPU- oder Single-Node-Grenze weiter nach oben, insbesondere wenn der Serving-Stack neuere Niedrigpräzisionspfade nutzen kann.
Am besten geeignet für:
- 70B-Inferenz mit langem Kontext.
- Höhere Batchgrößen und Parallelität.
- Serving mit 8 Bit oder gemischter Präzision.
- Reduzierung der Sharding-Komplexität für große Modelle.
Zu beachten:
- Verfügbarkeit und Mietpreis können die theoretische Eignung überwiegen.
- Die Software-Reife unterscheidet sich zwischen GPU-Generationen.
- Sie benötigen weiterhin einen Benchmark für die Kosten pro akzeptierter Ausgabe.
Für angrenzende Hardware-Vergleiche siehe B200 vs H200, H200 vs H100 und beste GPU für LLM-Inferenz.
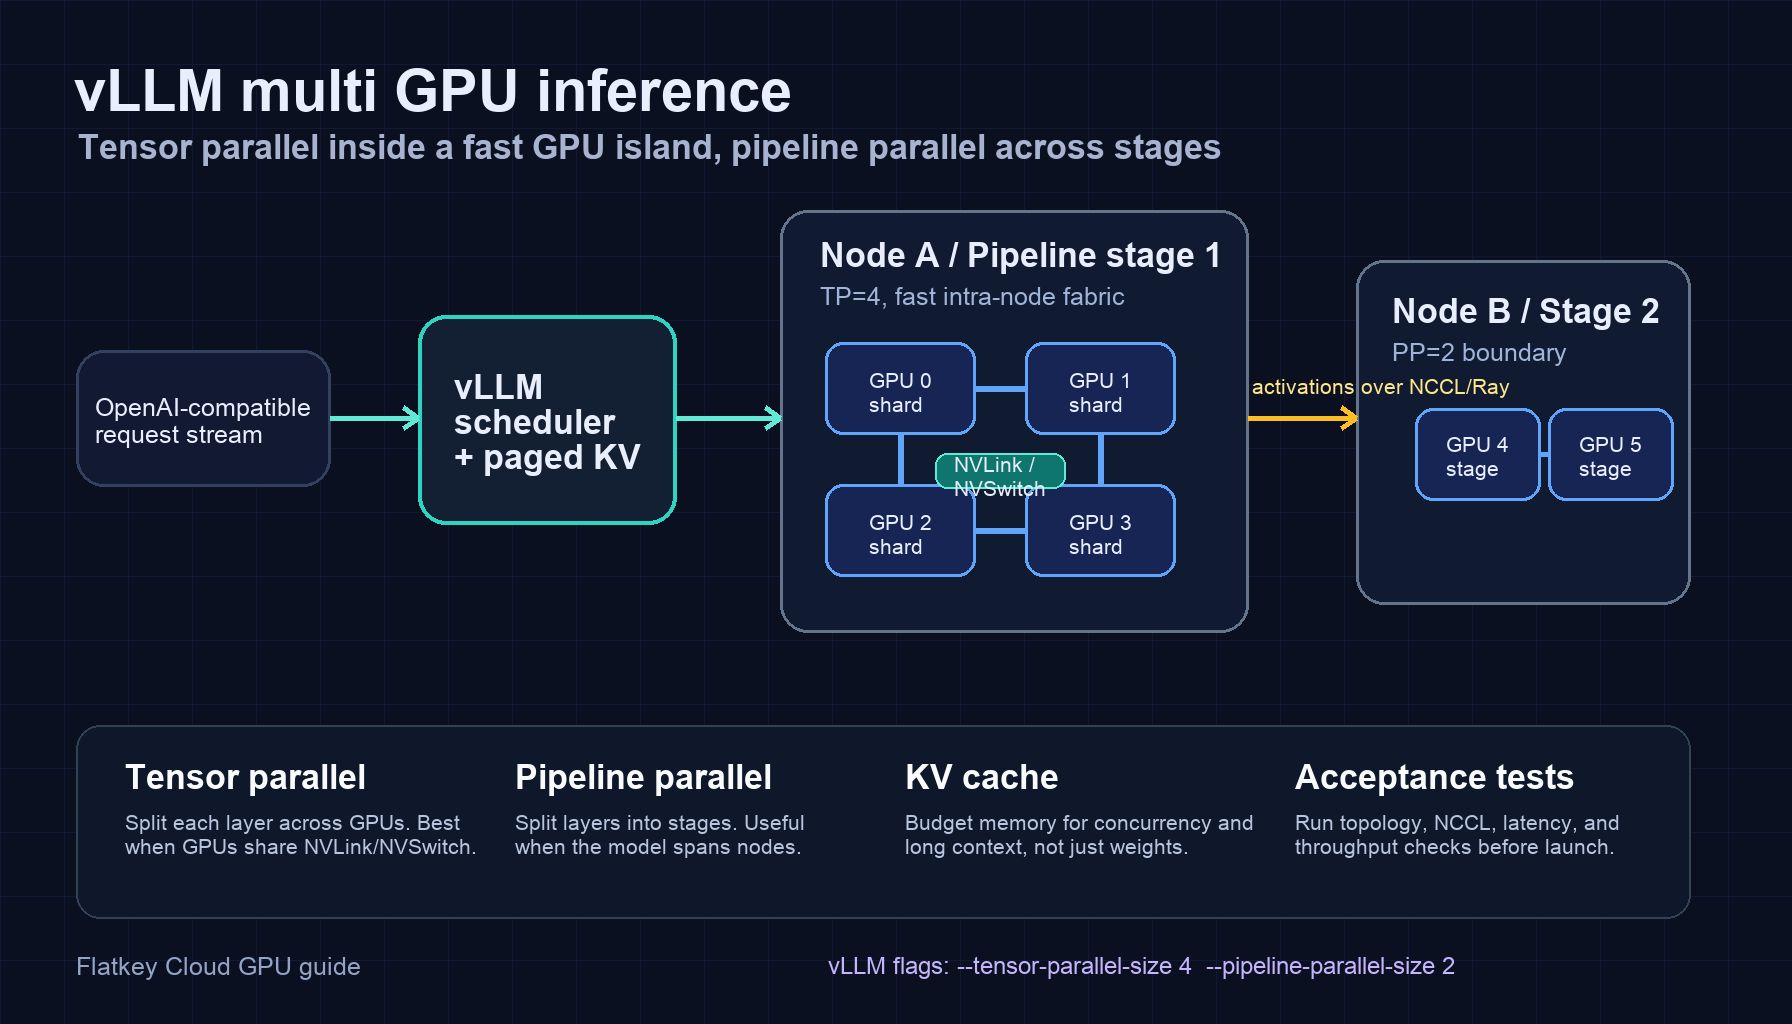
Multi-GPU-Optionen für 70B-Modelle
Multi-GPU-Serving ist nicht nur „mehr VRAM“. Es bringt auch Kommunikations-Overhead, Topologiefragen, Platzierungsrisiken und Softwarekomplexität mit sich.
Multi-GPU verwenden, wenn:
- Das Modell passt bei der benötigten Präzision nicht auf eine GPU.
- Langer Kontext oder hohe Parallelität mehr KV-Cache-Speicher benötigen.
- Sie FP16/BF16-70B-Serving benötigen.
- Sie einen Durchsatz brauchen, den eine GPU nicht liefern kann.
- Sie Tensor-Parallelismus und Interconnect-Performance validieren können.
| Option | Wann sie sinnvoll ist | Was zu prüfen ist |
|---|---|---|
| 2x48GB | 70B-Serving mit Quantisierung und mehr Spielraum als eine einzelne 48GB-Karte | Interconnect, Support für Tensor Parallelism, Fehlverhalten. |
| 2x80GB | 70B-FP16/BF16-Experimente oder quantisiertes Serving mit großem Spielraum | Ob Sharding bei Latenz und Kosten besser ist als eine größere GPU. |
| 4x80GB | Schwereres 70B-Serving, größere Kontexte, mehrere Replikate oder Fine-Tuning | NVLink/NVSwitch, Batch-Policy, Auslastung, Checkpoint-Strategie. |
| 8x80GB oder mehr | Gemeinsamer Produktionscluster, mehrere Endpunkte oder Modelle größer als 70B | Scheduler, Speicher, Observability und Kostenaufteilung. |
Für Multi-Node-Deployments ist das Clusterdesign entscheidend. Nutzen Sie den Leitfaden zur GPU-Cluster-Architektur, um Compute-, Netzwerk-, Speicher- und Control-Plane-Anforderungen vor dem Kapazitätskauf zu prüfen.
VRAM-Anforderungen für Ollama-70B-Modelle
Die Antwort auf ollama 70b model vram requirements hängt vom Modell-Tag und der Quantisierung ab. Ollama-Modelseiten führen quantisierte 70B-Artefakte häufig im Bereich von Dutzenden Gigabytes auf, nicht 140GB, weil der Standardpfad für lokales Serving meist quantisiert statt FP16 ist.
Eine praktische Faustregel:
- 48GB können ausreichen, um einige quantisierte 70B-Modelle zu laden und zu testen.
- 64GB bis 80GB schaffen mehr Spielraum für Kontext und weniger OOM-Überraschungen.
- 24GB bedeutet meist kleinere Modelle, kürzere Kontexte, starken Offload oder langsame Experimente.
- Wenn Sie Produktionslatenz oder mehrere Benutzer benötigen, dimensionieren Sie für Serving-Spielraum, nicht nur für die heruntergeladene Modellgröße.
Für lokale Tests sollten Sie den genauen Modell-Tag, die Quantisierung, die Kontextlänge, die GPU-Layer und die beobachtete Speichernutzung erfassen. Schreiben Sie nicht einfach „70B funktioniert auf meiner GPU“, ohne diese Details anzugeben. Dieselbe 70B-Familie kann mehrere quantisierte Varianten mit unterschiedlichem Speicherverhalten haben.
VRAM-Anforderungen für QLoRA-Fine-Tuning von 70B-Modellen
Die Frage nach qlora fine-tuning 70b model vram requirements hat zwei Antworten:
- Die Forschungsuntergrenze kann überraschend niedrig sein, weil QLoRA das Basismodell einfriert, es quantisiert und kleine Low-Rank-Adapter trainiert.
- Die Produktions-Wohlfühlzone ist höher, weil Sequenzlänge, Batch-Größe, Gradient Checkpointing, Datenpipeline, Evaluierungsfrequenz und Adapterverwaltung alle zusätzlichen praktischen Speicherdruck verursachen.
Verwenden Sie diese Planungstabelle:
| Fine-Tuning-Setup | 32B-Ausgangspunkt | 70B-Ausgangspunkt | Hinweise |
|---|---|---|---|
| Minimales QLoRA-Experiment | 24 GB bis 48 GB | 48 GB | Halten Sie Sequenzlänge und Batch-Größe moderat. |
| Praktischer QLoRA-Lauf | 48 GB bis 80 GB | 80 GB | Mehr Spielraum für Daten, Evaluation und weniger Neustarts. |
| Längere Sequenz oder größere effektive Batch | 80 GB oder Multi-GPU | 2x80 GB oder größer | Der Speicherbedarf wächst mit Sequenzlänge und Trainingsstrategie. |
| Full Fine-Tuning | Multi-GPU | Multi-GPU-Cluster | Der Optimizer-Zustand macht Full Fine-Tuning zu einem anderen Problem. |
Wenn Ihre Anfrage qlora fine-tune 70b model vram requirements lautet, beginnen Sie damit, einen einzigen eingeschränkten Lauf auf 48 GB oder 80 GB zu beweisen, und skalieren Sie dann Sequenzlänge und effektive Batch erst, nachdem Sie die tatsächliche Peak-Speichernutzung protokolliert haben. Für einen Produktions-Fine-Tuning-Workflow sind 80 GB oder Multi-GPU-Kapazität in der Regel einfacher zu betreiben als ein einmaliges Setup mit minimalem Speicherbedarf.
KV-Cache und Kontextlänge können die Antwort verändern
Ein 70B-Modell, das bei 4K Kontext passt, passt möglicherweise nicht bei 32K Kontext. Der KV-Cache wächst mit:
- Anzahl der Schichten.
- KV-Head-Anzahl und Head-Dimension.
- Kontextlänge.
- Batch-Größe oder aktive Sequenzen.
- Bytes pro KV-Cache-Element.
Serving-Engines verwalten dies unterschiedlich. vLLM stellt Speicherauslastung und KV-Cache-Verhalten als zentrale Serving-Aspekte bereit. llama.cpp und lokale Serving-Setups im Ollama-Stil bieten Kontext- und Offload-Optionen, die ein Modell passend machen können, jedoch mit Performance-Kompromissen.
Der praktische Ablauf:
- Laden Sie das Modell mit der vorgesehenen Quantisierung.
- Setzen Sie die tatsächliche Kontextlänge, nicht die Standardlänge.
- Führen Sie eine Prompt-Verteilung aus, die der Produktion entspricht.
- Erhöhen Sie die Parallelität, bis Latenz oder Speicher versagen.
- Protokollieren Sie Peak-VRAM, fehlgeschlagene Anfragen, Tokens pro Sekunde und akzeptierte Ausgabequalität.
Dimensionieren Sie 70b model vram requirements nicht anhand eines leeren Ladetests. Dimensionieren Sie anhand des Kontexts und der Parallelität, die Sie tatsächlich ausführen werden.
Ein einfaches VRAM-Arbeitsblatt
Verwenden Sie dieses Arbeitsblatt, bevor Sie Kapazität mieten oder reservieren.
model_family:
parameter_count: 32B | 70B | other
precision: fp16 | bf16 | int8 | 4-bit | mixed
serving_engine: Ollama | llama.cpp | vLLM | SGLang | TensorRT-LLM | other
target_context_window:
input_tokens_p50:
input_tokens_p95:
output_tokens_p50:
output_tokens_p95:
target_concurrency:
batching_policy:
fine_tuning_method: none | LoRA | QLoRA | full fine-tune
gpu_candidate:
gpu_memory:
observed_idle_load_vram:
observed_peak_vram:
oom_failures:
tokens_per_second:
accepted_outputs_per_hour:
cost_per_accepted_output:
Für die Kostenplanung kombinieren Sie das Arbeitsblatt mit GPU-Mietpreise, versteckte GPU-Cloud-Kosten und GPU-Cluster-TCO.
Wann eine Modell-API besser ist als das Mieten von GPUs
GPU-Kapazität ist sinnvoll, wenn Sie direkte Kontrolle über Gewichte, Quantisierung, Bereitstellung, benutzerdefinierte Adapter, private Bereitstellung oder nachhaltige Auslastung benötigen.
Eine Modell-API kann besser sein, wenn:
- Der Traffic spitzenförmig ist.
- Das Produkt häufig die Modelle wechselt.
- Das Team keine Serving-Infrastruktur betreiben möchte.
- Die Stückkosten pro Anfrage leichter zu verwalten sind als pro GPU-Stunde.
- Sie schnellen Zugriff auf mehrere Modellfamilien statt auf eine feste Bereitstellung benötigen.
Flatkey gehört auf die API-Seite dieser Entscheidung. Es bietet Entwicklern einen OpenAI-kompatiblen Endpoint, einen Schlüssel, ein Guthaben, eine Rechnung und ein Nutzungsprotokoll über offizielle Modelle und Tools hinweg. Wenn Ihr Arbeitsblatt zu 70b model vram requirements geringe Auslastung, fragile OOM-Spielräume oder hohen Betriebsaufwand zeigt, benchmarken Sie eine Modell/API-Basislinie, bevor Sie sich auf GPU-Miete festlegen. Der Leitfaden GPU-Cloud vs. Modell-API liefert den Entscheidungsrahmen.
Offizielle Quellen und Dokumentationen, die Sie geöffnet lassen sollten
| Quelle | Warum es wichtig ist |
|---|---|
| QLoRA-Paper und QLoRA-Repository | Referenzwert für speicherschonendes Adapter-Fine-Tuning großer Modelle. |
| Hugging Face bitsandbytes-Dokumentation zur Quantisierung | Praktisches Ladeverhalten für 8-Bit- und 4-Bit-Modelle in Transformers. |
| vLLM-Dokumentation | Speicher-, Batching- und KV-Cache-Verhalten beim Serving. |
| llama.cpp-Repository | GGUF, CPU/GPU-Offload und Verhalten bei lokaler Inferenz. |
| Ollama-Modellbibliothek | Modell-Tags, Größen quantisierter Artefakte und Optionen für lokales Serving. |
| NVIDIA A100, H100, H200 und DGX B200 | Offizielle GPU-Speicherstufen, die bei Größenentscheidungen verwendet werden. |
Fazit
Für 32B-Modelle sollten Sie mit 24GB für 4-Bit-Experimente, 48GB für komfortable Inferenz und 80GB beginnen, wenn Sie FP16/BF16, längeren Kontext oder Spielraum für Fine-Tuning möchten.
Für 70B-Modelle gilt 48GB als eingeschränkter 4-Bit-Ausgangspunkt, 80GB als praktische Stufe für ernsthafte Inferenz und 96GB bis 180GB oder Multi-GPU als Produktionsstufe mit ausreichendem Spielraum. Für FP16/BF16-70B sollten Sie Multi-GPU oder GPUs mit sehr hohem Speicher einplanen.
Die beste Antwort auf 70b model vram requirements ist keine einzelne GPU-Zahl. Es ist eine messbar konfigurierte Lösung: Modell, Quantisierung, Kontextlänge, Parallelität, Serving-Engine, Fine-Tuning-Methode und Kosten pro akzeptierter Ausgabe.
Häufig gestellte Fragen
Wie viel VRAM benötigt ein 70B-Modell?
Ein 70B-Modell benötigt etwa 140GB nur für FP16- oder BF16-Gewichte, etwa 70GB vor Overhead bei 8-Bit und ungefähr 35GB bis 45GB für viele 4-Bit-quantisierte Varianten. In der Praxis sind die 70b model vram requirements höher, sobald KV-Cache, Laufzeitpuffer, Kontextlänge und Parallelität berücksichtigt werden.
Kann ein 70B-Modell auf einer 48GB-GPU laufen?
Ja, ein 70B-Modell kann auf einer 48GB-GPU laufen, wenn es stark quantisiert ist und Kontext/Parallelität kontrolliert werden. Das ist eine brauchbare Stufe für lokale Inferenz und eingeschränkte Tests, aber 80GB oder mehr sind für produktionsähnliches Serving sicherer.
Was sind die VRAM-Anforderungen für Ollama-70B-Modelle?
Für ollama 70b model vram requirements sollten Sie das genaue Modell-Tag und die Größe des quantisierten Artefakts prüfen. 48GB können für einige quantisierte 70B-Modelle ausreichen, aber 64GB bis 80GB bieten mehr Spielraum für Kontext und führen zu weniger OOM-Fehlern.
Was sind die VRAM-Anforderungen für QLoRA-70B-Modelle?
Für qlora 70b model vram requirements sind 48GB eine praktische Untergrenze für eingeschränkte Experimente, während 80GB oder Multi-GPU-Kapazität sicherer für längere Sequenzen, größere effektive Batches und Produktions-Fine-Tuning-Workflows sind.
Reichen 24GB für ein 70B-Modell aus?
24GB reichen in der Regel nicht für komfortable 70B-GPU-Inferenz aus. Es kann mit starker Quantisierung, CPU-Offload, kleinen Kontextfenstern oder langsamen Experimenten funktionieren, wird aber besser als quantisierte 32B-Klasse betrachtet.
Reichen 80GB für ein 70B-Modell aus?
80GB reichen für viele 70B-quantisierte Inferenz-Workloads und eingeschränkte QLoRA-Läufe aus. Für vollständige FP16/BF16-70B-Inferenz auf einer GPU nach Overhead reichen sie normalerweise nicht, und es kann dennoch zu Fehlern kommen, wenn das Kontextfenster oder die Parallelität zu groß ist.