
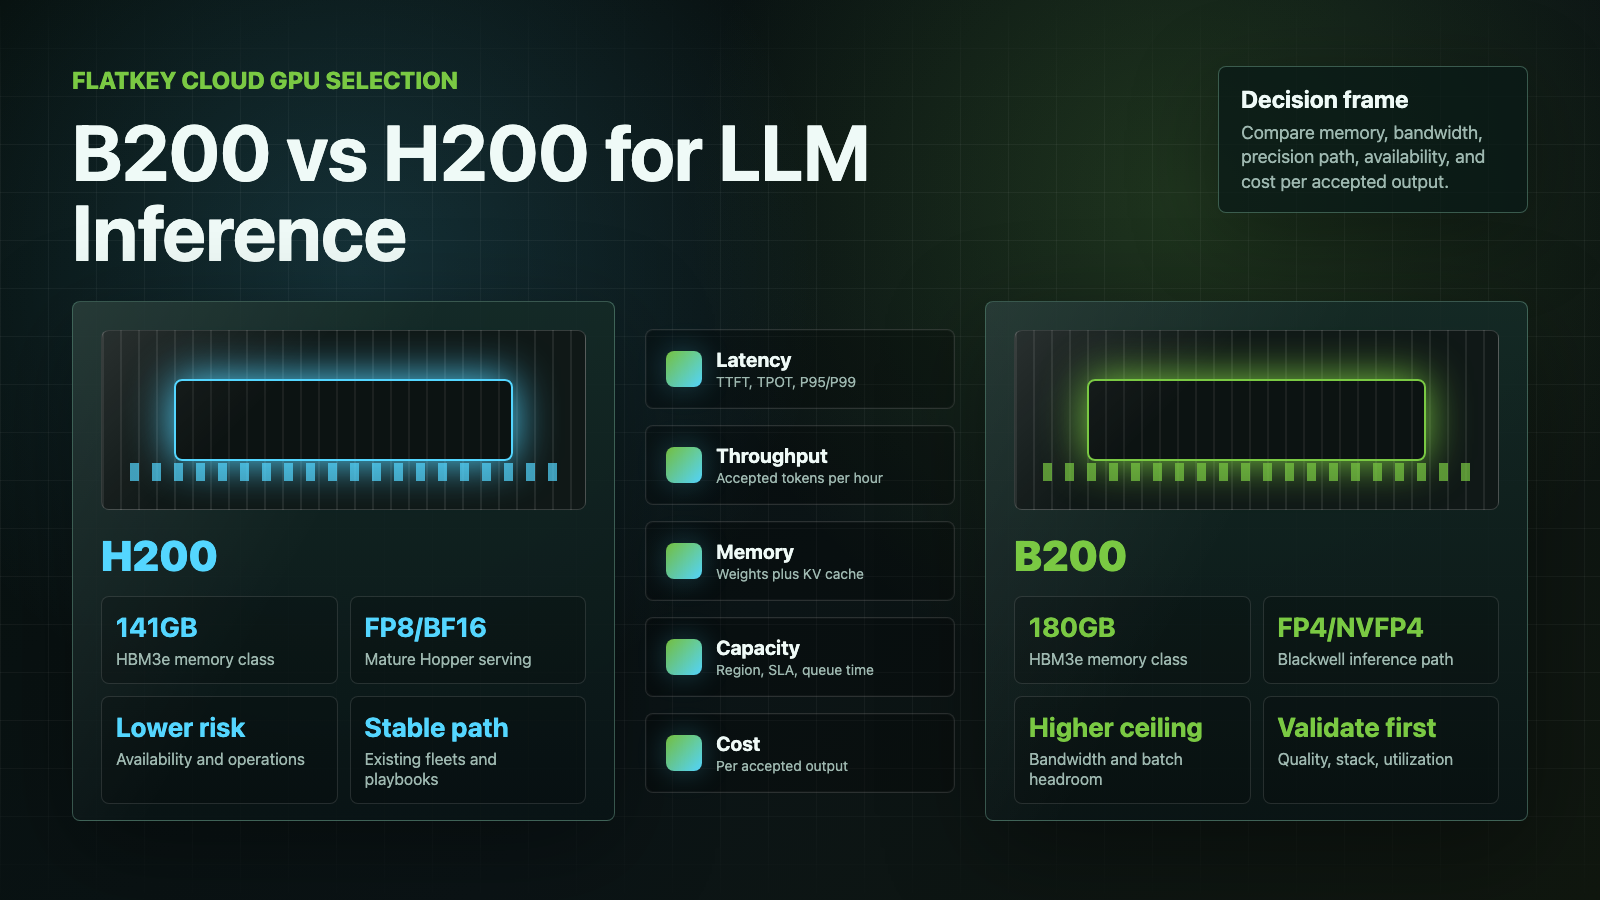
NVIDIA B200 vs H200: Welche GPU ist besser für LLM-Inference?
B200 vs. H200 ist keine einfache Entscheidung nach dem Motto „die neuere GPU gewinnt“. Die NVIDIA B200 hat das höhere Potenzial für LLM-Inference, wenn Ihr Stack die Low-Precision-Pfade von Blackwell nutzen kann, insbesondere FP4/NVFP4, und wenn der Speicherbandbreitenbedarf der Engpass ist. Die NVIDIA H200 ist in der Regel die risikoärmere Wahl, wenn Sie verfügbare Kapazitäten benötigen, ausgereifte Hopper-Serving-Unterstützung, stabiles FP8/BF16-Verhalten und heute eine einfachere Preisfindung wünschen.
Dieser Leitfaden richtet sich an Enterprise-AI-Teams, die Cloud-GPU-Kapazitäten für LLM-Inference vergleichen, nicht an Chip-Sammler. Die praktische Frage lautet: Welche GPU bietet die beste Latenz, den besten Durchsatz, die höchste Zuverlässigkeit und die geringsten Kosten pro akzeptierter Ausgabe für Ihr Modell, Ihre Kontextlänge, Ihr Traffic-Muster und Ihren Serving-Stack?
Geprüft am 13. Oktober 2026.
B200 vs. H200: die kurze Antwort
Wählen Sie B200, wenn Ihr Workload durch Durchsatz, Speicherbandbreite oder Blackwell-optimierte Low Precision begrenzt ist. Sie ist die bessere zukunftsorientierte Inference-Plattform für High-Volume-Serving von 70B+ Modellen, Workloads mit langem Kontext und Teams, die TensorRT-LLM, FP4/NVFP4 und modernes Batching vor einer Kapazitätsbindung ernsthaft benchmarken können.
Wählen Sie H200, wenn Sie Kapazität schneller benötigen, Ihre Workloads bereits gut auf Hopper laufen, Ihr Stack auf FP8/BF16 basiert oder die Beschaffung einen ausgereifteren Cloud-GPU-Markt erfordert. Die H200 ist weiterhin eine starke GPU für LLM-Inference, da sie Hopper-Software-Reife mit 141 GB HBM3e-Speicher und hoher Speicherbandbreite kombiniert.
Der Käufer-Kurzvergleich:
| Entscheidung | Besserer Ausgangspunkt | Warum |
|---|---|---|
| Neuer LLM-Inference-Cluster mit hohem Durchsatz | B200 | Mehr Speicher pro GPU, höhere Speicherbandbreite, Blackwell-Low-Precision-Pfad, neuere Systemdesigns. |
| Erweiterung einer bestehenden Hopper-Flotte | H200 | Einfachere operative Kontinuität von H100/H200, weniger Stack-Änderungen, ausgereifte Serving-Setups. |
| FP4- oder NVFP4-Evaluierung | B200 | Blackwell ist für den neueren Low-Precision-Inference-Pfad ausgelegt. |
| FP8/BF16-Produktivbetrieb | zuerst H200, dann B200 benchmarken | Die Unterstützung für Hopper ist ausgereift; die B200 benötigt weiterhin workloadspezifische Validierung. |
| Knappes Kapazitätsfenster zum Launch | Der Anbieter, der verlässliche Kapazität vertraglich zusichern kann | Wartezeit und SLA können wichtiger sein als das theoretische GPU-Maximum. |
| Niedrigstes Beschaffungsrisiko | H200 | Vertrautere Cloud-Beschaffung und Preisreferenzen. |
| Bester langfristiger Spielraum | B200 | Mehr Headroom, wenn Software, Auslastung und Verfügbarkeit zusammenpassen. |
Spezifikationsvergleich für LLM-Inference
Nutzen Sie diese Tabelle als ersten Filter und führen Sie dann Ihren eigenen Benchmark durch. Kaufen Sie B200 oder H200 nicht nur auf Basis theoretischer Spitzenwerte.
| Kategorie | NVIDIA H200 | NVIDIA B200 | Warum das für LLM-Inference wichtig ist |
|---|---|---|---|
| Architektur | Hopper | Blackwell | B200 ergänzt Blackwell-Serving-Features und Low-Precision-Beschleunigung; H200 profitiert von der Hopper-Reife. |
| Speicherkapazität | 141 GB HBM3e | 180 GB HBM3e in gängigen SXM/DGX-B200-Konfigurationen | Mehr Speicher hilft bei größeren Modellen, längeren Kontextfenstern, größerem KV-Cache und höheren Batchgrößen. |
| Speicherbandbreite | Bis zu 4,8 TB/s | Bis zu etwa 8 TB/s in B200-SXM-Klassensystemen | Token-Generierung und attention-lastige Workloads können durch Speicherbandbreite begrenzt werden. |
| Low Precision | FP8, BF16, FP16, TF32 und andere unterstützte Modi | FP4/NVFP4, FP8, BF16, FP16, TF32 und andere unterstützte Modi | Der Vorteil der B200 ist am größten, wenn Modell und Serving-Stack Blackwell-Low-Precision ohne Qualitätsverlust nutzen können. |
| Software-Reife | Sehr ausgereiftes Hopper-Ökosystem | Schnell reifendes Blackwell-Ökosystem | Die H200 hat ein geringeres Einführungsrisiko; die B200 kann mehr Benchmarking und Tuning erfordern. |
| Beschaffungsstatus | Breiteres H100/H200-Cloud-Muster | Neuer und oft kapazitätsärmer | Verfügbarkeit kann die Antwort entscheiden, noch bevor Benchmarks es tun. |
Wichtige Quellen, die Sie während der Evaluierung geöffnet lassen sollten: NVIDIA H200, NVIDIA DGX B200, NVIDIAs Tensor-Core-GPU-Datenblatt und die TensorRT-LLM-Leistungsübersicht.
Warum die B200 die H200 bei LLM-Inference schlagen kann
Das stärkste Argument für B200 vs. H200 ist nicht nur die rohe Rechenleistung. Es ist die Kombination aus Speicherkapazität, Speicherbandbreite, neueren Interconnect-/Systemdesigns und Blackwell-Low-Precision-Inference.
1. Mehr Speicher-Headroom
Die H200 hat bereits einen deutlichen Speicher-Vorteil gegenüber früheren H100-80-GB-Deployments. Die B200 erweitert diesen Headroom noch weiter. Das ist wichtig, weil Produktions-LLM-Inference nicht nur aus Modellgewichten besteht. Sie benötigen außerdem Platz für den KV-Cache, Laufzeit-Overhead, Batching, Framework-Puffer, den Zustand des Speculative Decoding und Sicherheitsreserven für lange Prompts.
Für Modelle der 70B-Klasse kann eine gut abgestimmte H200 ausreichen. Für größere Modelle, höhere Parallelität, längere Kontextfenster oder Multi-Tenant-Endpunkte kann der zusätzliche Speicher der B200 den Sharding-Druck verringern und höhere Batchgrößen realistischer machen.
2. Höhere Speicherbandbreite
Viele LLM-Inference-Pfade werden eher durch Speicherbewegungen als nur durch den reinen Tensor-Durchsatz begrenzt. Während der Generierung kann jedes Token wiederholte Bewegungen von Gewichten und KV-Cache-Daten erfordern. Eine höhere Speicherbandbreite kann den Durchsatz verbessern, wenn die Serving-Engine, Quantisierung, Attention-Kernels und Batch-Policy die GPU effizient auslasten können.
Deshalb sollte ein Leistungsvergleich zwischen B200 und H200 sowohl Latenz als auch Durchsatz erfassen. Eine GPU, die bei der maximalen Anzahl Tokens pro Sekunde gewinnt, muss nicht Ihr P95-Latenzziel erreichen, und eine GPU, die pro Stunde teuer aussieht, kann pro Million akzeptierter Tokens günstiger sein, wenn die Auslastung hoch ist.
3. Niedrigpräzisionspfade von Blackwell
B200 ist besonders überzeugend, wenn Sie Blackwell-optimierte Präzisionsmodi validieren können. FP4/NVFP4 kann die Kostenseite für einige Inference-Workloads erheblich verändern, aber die Einsparungen sind nicht automatisch. Sie müssen Qualität, Ablehnungsverhalten, Genauigkeit von Tool-Aufrufen, Zusammenfassungsdrift, Empfindlichkeit bei Retrieval und Verhalten bei langem Kontext testen, bevor Sie einen kundenfacing Endpoint umstellen.
Wenn Ihre Produktionsrichtlinie heute BF16 oder FP8 erfordert, kann H200 der besser vorhersehbare erste Rollout sein. Wenn Sie die nächste Inference-Plattform aufbauen und in modelspezifische Kalibrierung und Benchmarking investieren können, verdient B200 den ersten Benchmark-Slot.
Warum H200 immer noch der bessere Kauf sein kann
H200 ist keine Legacy-GPU in dem Sinne, wie A100 heute oft für Frontier-LLM-Serving betrachtet wird. Es ist ein Hopper-Modell mit viel Speicher, einem ausgereiften Softwarepfad, breiter Vertrautheit mit den Operatoren und genug Speicher für viele ernsthafte LLM-Inference-Workloads.
1. Verfügbarkeit kann Spitzenleistung schlagen
Die „beste GPU“ ist nutzlos, wenn Sie sie während eines Launch-Fensters nicht sichern können. Bei der Beschaffung von Cloud-GPUs gehören Warteschlangenzeit, Reservierungsbedingungen, Support-Reaktionszeit, Region, Netzwerkanbindung und Kündigungsrisiko zur Performance. Wenn ein Anbieter jetzt zuverlässige H200-Kapazität liefern kann, während B200-Kapazität nur auf Anfrage verfügbar oder nachbestellt ist, kann H200 die bessere Geschäftsentscheidung sein.
Aktuelle Preise finden Sie auf Anbieter-Seiten wie RunPod pricing, Lambda GPU Cloud pricing, Vast.ai pricing und Massed Compute pricing. Betrachten Sie diese Seiten als Live-Quellenprüfungen, nicht als dauerhafte Preislisten.
2. Hopper-Serving ist operativ vertraut
Viele Teams wissen bereits, wie man vLLM, SGLang, TensorRT-LLM, TGI, Ray Serve, Kubernetes-Operatoren, Monitoring und Autoscaling rund um Hopper-Klasse-GPUs betreibt. Das reduziert das Migrationsrisiko. Wenn Ihr H100- oder H200-Cluster bereits bekannte Images, Kernel, Alarmgrenzen, Auslastungsziele und Incident-Playbooks hat, kann eine Erweiterung um H200 besser sein als eine überhastete B200-Migration.
3. H200 kann für 70B-Production-Inference ausreichen
Für 7B-, 8B-, 14B-, 32B- und viele 70B-Deployments hat H200 oft genug Speicher und Durchsatz, wenn der Workload optimiert ist. Die harte Frage ist nicht: „Kann H200 dieses Modell bedienen?“ Die harte Frage ist: „Kann H200 dieses Modell mit unserer Ziel-Latenz, Kontextlänge, Batchgröße, Verfügbarkeitsanforderung und Kosten pro akzeptierter Antwort bedienen?“
Wenn die Antwort ja ist, muss B200 sich durch bessere tatsächlich gelieferte Wirtschaftlichkeit rechtfertigen, nicht nur durch bessere Spezifikationen.
DGX B200 vs H200: Vergleichen Sie das System, nicht nur die GPU
Das Stichwort „DGX B200 vs H200“ vermischt normalerweise zwei Vergleichsebenen:
- GPU-Vergleich: B200-GPU versus H200-GPU.
- Systemvergleich: DGX B200- oder HGX B200-ähnliche Systeme versus H200-Systeme.
Für die Beschaffung ist die Systemebene wichtiger. Ein Server mit acht B200-GPUs ist nicht nur acht isolierte Beschleuniger. Er umfasst das CPU-Host-Design, Speicher, NVLink-/NVSwitch-Topologie, Netzwerkanbindung, Storage, Stromversorgung, Kühlung, Herstellersupport und Cluster-Integration.
Beim Vergleich von DGX B200 vs H200-Kapazität sollten Sie Folgendes anfordern:
| Systemfrage | Warum das wichtig ist |
|---|---|
| Anzahl und Formfaktor der GPUs | PCIe-, SXM-, HGX-, DGX- und NVL-Systeme haben unterschiedliche Leistung und Wartungsfreundlichkeit. |
| NVLink-/NVSwitch-Topologie | Multi-GPU-Tensor-Parallelism und Modell-Sharding hängen von der Qualität der Verbindung ab. |
| Netzwerk-Fabric | Multi-Node-Inference und Training benötigen InfiniBand-, RoCE- oder eine vergleichbare Fabric-Planung. |
| Strombedarf und Rack-Dichte | B200-Systeme können Rack-Design, Kühlung und den Bereitstellungszeitplan verändern. |
| Storage-Pfad | Modell-Ladezeit und Checkpoint-Übertragung beeinflussen die abrechenbare Startzeit. |
| Support- und Austausch-SLA | Ausfallzeit ist Teil der Kosten pro akzeptierter Ausgabe. |
Wenn ein Anbieter „B200“-Kapazität angibt, bestätigen Sie das tatsächliche System. Ein B200-PCIe-Node, ein HGX-B200-Node und ein DGX-B200-System sind keine austauschbaren Beschaffungseinheiten.
B200 vs H200 Performance: Was Sie benchmarken sollten
Kein öffentlicher Benchmark kann Ihre B200-vs-H200-Entscheidung allein beantworten. Ein nützlicher NVIDIA-B200-vs-H200-Leistungsvergleich braucht einen reproduzierbaren Benchmark mit Ihrem Modell, Tokenizer, Ihrer Kontextverteilung, Ihrem Traffic-Muster und Ihrem Qualitätsgrenzwert.
Verwenden Sie drei Benchmark-Modi:
| Modus | Was er beweist | Häufiger Fehler |
|---|---|---|
| Latenz bei Einzelanfragen | Zeit bis zum ersten Token und Reaktionsfähigkeit pro Nutzer | Eine Anfrage optimieren und annehmen, dass dies den Produktionsdurchsatz vorhersagt. |
| Sättigender Durchsatz | Maximale Anzahl ausgegebener Tokens pro Sekunde unter Last | P95/P99-Latenz und Queueing-Verhalten ignorieren. |
| Produktions-Replay | Kosten und Latenz bei realen Prompt-Längen und Parallelität | Synthetische Prompts verwenden, die kürzer sind als echter Nutzerverkehr. |
Verfolgen Sie diese Felder:
model_id:
weights_precision:
runtime: vLLM | SGLang | TensorRT-LLM | TGI | custom
gpu: H200 | B200
gpu_count:
context_input_p50:
context_input_p95:
output_tokens_p50:
output_tokens_p95:
target_ttft_ms:
target_tpot_ms:
concurrency:
batching_policy:
kv_cache_policy:
quality_eval_suite:
hourly_gpu_cost:
tokens_per_second:
accepted_answers_per_hour:
cost_per_1m_accepted_output_tokens:
Die wichtigste Kennzahl ist Kosten pro akzeptiertem Output, nicht Tokens pro Sekunde allein. Wenn die B200 schneller ist, aber pro zuverlässiger reservierter Stunde deutlich mehr kostet, kann die H200 trotzdem gewinnen. Wenn die B200 eine deutlich größere Batch-Größe, niedrigere Präzision mit akzeptabler Qualität oder weniger GPUs pro Endpunkt ermöglicht, kann die B200 auch bei einem höheren Stundensatz gewinnen.
Für ein umfassenderes Kosten-Arbeitsblatt kombinieren Sie diesen Benchmark mit GPU-Mietpreise, Vergleich der Preise von KI-Modellen und wie man KI-Modellpreise vergleicht.
Empfehlung nach Workload
| Workload | Besserer erster Benchmark | Begründung |
|---|---|---|
| 8B- oder kleines Modell, latenzsensitives API | H200 | Der Workload benötigt möglicherweise nicht den Speicher-Spielraum der B200; die Reife der Software ist wichtig. |
| 70B FP8/BF16 Serving | H200 und B200 | Die H200 kann ausreichen; die B200 kann gewinnen, wenn Speicherbandbreite und Batching dominieren. |
| 70B FP4 Serving | B200 | Der Präzisionspfad begünstigt Blackwell, aber eine Qualitätsvalidierung ist zwingend erforderlich. |
| 405B- oder sehr großes Modell-Serving | B200 | Mehr Speicher und neuere Systembandbreite sind wertvoll, auch wenn die Multi-GPU-Topologie dominiert. |
| Long-Context RAG-Endpunkt | B200 | KV-Cache-Druck und Bandbreite können die B200 attraktiv machen. |
| Batch-Offline-Inferenz | B200, wenn die Auslastung hoch ist | Die Durchsatzobergrenze ist wichtig, wenn Jobs die GPU ausgelastet halten. |
| Stoßweise kundennahe Inferenz | H200 oder zuerst Modell-API | Ungenutzte B200-Kapazität kann teuer sein, wenn der Traffic sprunghaft ist. |
| Bestehende H100/H200-Plattform | Zuerst H200-Erweiterung | Operative Kontinuität kann eine Migration auf einen neuen Stack übertreffen. |
Preis- und Verfügbarkeits-Checkliste
Vergleichen Sie B200 vs. H200 nicht nur über den Stundenpreis. Vergleichen Sie die Wirtschaftlichkeit abgeschlossener Workloads.
| Feld | Erfassung H200 | Erfassung B200 |
|---|---|---|
| Anbieter | Cloud, Marktplatz, dedizierter Cluster, Colocation-System | Cloud, Marktplatz, dedizierter Cluster, Colocation-System |
| Vertragsmodell | On-Demand, reserviert, zugesagt, privater Cluster | On-Demand, reserviert, zugesagt, privater Cluster |
| Tatsächliches System | H200 PCIe, H200 SXM, H200 NVL, DGX/HGX | B200 PCIe, B200 SXM, HGX, DGX B200, GB200-Option |
| Region | Latenz, Datenvorgaben, Verfügbarkeit | Latenz, Datenvorgaben, Verfügbarkeit |
| Stündliche oder monatliche Kosten | Speicher, Support, Egress, Leerlaufzeit einbeziehen | Speicher, Support, Egress, Leerlaufzeit einbeziehen |
| Auslastung | Tatsächliche GPU-Aktivzeit | Tatsächliche GPU-Aktivzeit |
| Kosten für Fehler und Wiederholungen | OOM, Eviction, fehlerhaftes Image, Netzwerkproblem | OOM, Migrationsfehler, Tuning-Fehler |
| Akzeptierte Ausgaberate | Antworten, Tokens, Jobs oder Anfragen, die QA bestehen | Antworten, Tokens, Jobs oder Anfragen, die QA bestehen |
Bitten Sie für die Beschaffung die Anbieter, dieselbe Workload-Einheit anzubieten:
Bitte nennen Sie Kapazitäten für:
- Modell und Präzision
- Zieltraffic
- Verteilung der Input-/Output-Tokens
- Ziel-P95-Latenz
- erforderliche Region
- Vertragslaufzeit
- Support/SLA
- Annahmen zu Speicher und Netzwerk
- erwartete Kosten pro 1 Mio. akzeptierten Output-Tokens
Die letzte Zeile ist wichtig. Wenn der Anbieter nicht dabei helfen kann, GPU-Kosten in Ausgabekosten abzubilden, trägt Ihr Team das gesamte Modellierungsrisiko.
Wenn weder B200 noch H200 die richtige Antwort ist
Manchmal ist die richtige Antwort überhaupt kein GPU-Cluster. Wenn die Auslastung niedrig ist, die Nachfrage sprunghaft ist, das Produkt häufig Modelle wechselt oder das Team keine Serving-Infrastruktur betreiben möchte, kann eine Modell-API günstiger und schneller sein als GPUs zu mieten.
Flatkey sitzt auf der API-Seite dieser Entscheidung. Es gibt Teams einen Schlüssel, ein Guthaben, eine Rechnung und ein Nutzungsprotokoll über 300+ offizielle Modelle und 1.000+ Tools hinweg. Wenn Ihr B200-vs.-H200-Arbeitsblatt eine geringe Auslastung oder hohe Betriebskosten zeigt, vergleichen Sie einen Modell-API-Pfad, bevor Sie einen Clustervertrag unterschreiben. Für Governance-, Budget- und Routing-Kontrollen siehe AI-gateway pricing, AI API spend management und AI API quota controls.
Das bedeutet nicht, dass Modell-APIs GPUs immer schlagen. Es bedeutet, dass die GPU-Entscheidung anhand derselben Metrik für akzeptierte Ausgaben gegen eine API-Alternative gemessen werden sollte.
Endempfehlung
Für die meisten Enterprise-AI-Teams lautet die praktische B200-vs.-H200-Antwort:
- Beginnen Sie mit H200, wenn Sie schnell zuverlässige Kapazität benötigen, bereits Hopper einsetzen oder FP8/BF16-Workloads mit ausgereifter Tooling-Landschaft bedienen.
- Beginnen Sie mit B200, wenn Sie eine neue High-Throughput-LLM-Inference-Plattform aufbauen, die Qualität von FP4/NVFP4 validieren können und genügend Kapazität sichern können, um die GPUs stark auszulasten.
- Verpflichten Sie sich auf keine der beiden GPUs, bevor Sie die Kosten pro akzeptierter Ausgabe mit Ihren tatsächlichen Prompts, Kontextlängen und Ihrer Parallelität benchmarken.
Wenn B200 zu einer vernünftigen vertraglich gebundenen Rate verfügbar ist und Ihr Software-Stack Blackwell ausnutzen kann, ist es die stärkere langfristige LLM-Inference-Plattform. Wenn Verfügbarkeit, Preis und Betriebsrisiko die Kaufentscheidung dominieren, bleibt H200 eine sehr glaubwürdige und oft praktischere Wahl.
Häufig gestellte Fragen
Ist B200 besser als H200 für LLM-Inference?
B200 ist in der Regel besser für LLM-Inference-Workloads mit höchstem Durchsatz, hoher Speicherbandbreite und Blackwell-Optimierung. H200 kann besser sein, wenn Hopper-Software-Reife, sofort verfügbare Kapazität und ein vorhersehbarer Preis wichtiger sind.
Was ist der größte Unterschied in der Leistung von NVIDIA B200 vs. H200?
Der größte Unterschied in der Leistung von NVIDIA B200 vs. H200 ist die Kombination aus B200s größerem Speicher, höherer Speicherbandbreite und der Blackwell-Unterstützung für niedrige Präzision. Die tatsächliche Lücke hängt von Modellgröße, Präzision, Serving-Engine, Batching und Latenzziel ab.
Sollte ich mich bei einem 70B-Modell für H200 vs. B200 entscheiden?
Bei H200 vs. B200 für ein 70B-Modell sollten Sie nach Möglichkeit beide benchmarken. H200 kann für FP8/BF16-Serving mit ausgereiften Tools ausreichen. B200 ist attraktiver für hohe Parallelität, langen Kontext oder FP4/NVFP4-Serving nach der Qualitätsvalidierung.
Ändert DGX B200 vs. H200 die Antwort?
Ja. DGX B200 vs. H200 ist eine Entscheidung auf Systemebene, nicht nur eine GPU-Entscheidung. Vergleichen Sie GPU-Anzahl, NVLink/NVSwitch-Topologie, Netzwerk, Rack-Strom, Kühlung, Storage, Support und Bedingungen für vertraglich gebundene Kapazität.
Ist B200 immer günstiger pro Token als H200?
Nein. B200 kann pro Token günstiger sein, wenn es stark ausgelastet ist und der Serving-Stack Blackwell effizient nutzt. H200 kann günstiger sein, wenn B200-Stundensätze, Warteschlangenzeit, Migrationsaufwand oder Unterauslastung den Leistungsvorteil ausgleichen.
Was sollte ich messen, bevor ich B200- oder H200-Kapazität kaufe?
Messen Sie Zeit bis zum ersten Token, Tokens pro Ausgabe-Sekunde, P95/P99-Latenz, akzeptierte Antworten pro Stunde, GPU-Auslastung, Fehlerrate, Neustartkosten, Storage, Egress, Support und Kosten pro 1 Mio. akzeptierten Ausgabetokens.


