Panduan VRAM Model 32B dan 70B: Opsi Single-GPU dan Multi-GPU
Jawaban praktis untuk kebutuhan VRAM model 70b adalah: model 70B dapat dimuat dengan kira-kira 35GB hingga 45GB dengan kuantisasi 4-bit yang umum, sekitar 70GB hingga 90GB dengan kuantisasi 8-bit dan overhead runtime, serta lebih dari 140GB sebelum overhead pada FP16 atau BF16. Model 32B lebih mudah, tetapi tetap memerlukan perencanaan: sekitar 18GB hingga 24GB untuk inferensi 4-bit, 32GB hingga 45GB untuk inferensi 8-bit, dan lebih dari 64GB sebelum overhead pada FP16 atau BF16.
Angka-angka tersebut hanya batas bawah. Kebutuhan VRAM model 70b yang sesungguhnya bergantung pada panjang konteks, ukuran batch, KV cache, mesin serving, tensor parallelism, adapter LoRA, status optimizer, dan seberapa besar margin keamanan yang Anda butuhkan sebelum trafik produksi mulai gagal dengan error out-of-memory.
Panduan ini ditujukan untuk engineer AI, tim platform, dan pembeli teknis yang memutuskan apakah beban kerja 32B atau 70B cocok di satu GPU, memerlukan beberapa GPU, atau sebaiknya disajikan melalui API model alih-alih kapasitas GPU sewaan.
Diperiksa pada 13 Oktober 2026.
kebutuhan VRAM model 70b: jawaban cepat
Gunakan ini sebagai penentuan ukuran awal, lalu benchmark model, jendela konteks, dan stack serving Anda yang sebenarnya.
| Beban kerja | Titik awal 32B | Titik awal 70B | Catatan praktis |
|---|---|---|---|
| Inferensi lokal 4-bit | 24GB bisa bekerja, 48GB lebih nyaman | 48GB dapat memuat beberapa model terkuantisasi, 80GB lebih aman | Bagus untuk pengembangan, demo, alat internal, dan serving dengan konkurensi rendah. |
| Inferensi 8-bit | 48GB atau 80GB | 80GB minimum, 96GB atau 141GB lebih aman | Overhead runtime dan KV cache sering menentukan apakah endpoint stabil. |
| Inferensi FP16/BF16 | 80GB | 2x80GB, 141GB, 180GB, atau sistem multi-GPU yang lebih besar | Memori bobot saja sekitar 2 byte per parameter. |
| Serving lokal satu pengguna gaya Ollama | 24GB hingga 48GB | 48GB hingga 80GB | Pertanyaan kebutuhan VRAM model ollama 70b terutama tentang ukuran model yang dikuantisasi plus konteks. |
| Serving produksi vLLM atau SGLang | 48GB hingga 80GB | 80GB, 96GB, 141GB, atau multi-GPU | Berikan ruang cadangan untuk KV cache, batching, dan pemulihan request yang gagal. |
| Fine-tuning QLoRA | 48GB untuk run terbatas, 80GB lebih aman | 48GB adalah batas bawah riset; 80GB atau multi-GPU lebih aman | kebutuhan VRAM model qlora 70b sangat bergantung pada panjang sequence dan strategi batch. |
Shortcut untuk pembeli:
- Pilih 24GB hanya untuk eksperimen 32B yang dikuantisasi atau workflow split CPU/GPU 70B yang sangat terbatas.
- Pilih 48GB untuk kenyamanan 32B, inferensi lokal 70B 4-bit, atau eksperimen QLoRA yang disetel ketat.
- Pilih 80GB untuk inferensi 70B yang serius, jendela konteks yang lebih besar, atau QLoRA yang lebih andal.
- Pilih 96GB, 141GB, 180GB, atau multi-GPU ketika Anda membutuhkan ruang cadangan produksi, konteks lebih panjang, konkurensi lebih tinggi, atau FP16/BF16.
Jika produk hanya membutuhkan output model dan bukan kontrol hardware langsung, bandingkan jalur model/API sebelum menandatangani kontrak GPU. Flatkey memberi tim satu key, satu saldo, satu invoice, dan ledger penggunaan di ratusan model dan alat resmi, yang dapat menjadi baseline yang lebih bersih ketika utilisasi masih tidak pasti.
Mengapa bobot model bukan seluruh kebutuhan VRAM
Estimasi memori paling sederhana adalah:
model_weight_memory = parameter_count x bytes_per_parameter
Itu memberi batas bawah yang berguna:
| Ukuran model | Batas bawah FP16/BF16 | Batas bawah 8-bit | Batas bawah 4-bit |
|---|---|---|---|
| 32B | sekitar 64GB | sekitar 32GB | sekitar 16GB |
| 70B | sekitar 140GB | sekitar 70GB | sekitar 35GB |
Tetapi LLM yang berjalan membutuhkan lebih dari sekadar bobot:
| Komponen memori | Mengapa penting |
|---|---|
| Metadata kuantisasi | Format 4-bit dan 8-bit memerlukan skala, metadata grup, dan buffer framework. |
| KV cache | Jendela konteks yang lebih panjang dan lebih banyak request bersamaan mengonsumsi memori tambahan. |
| Buffer runtime | vLLM, SGLang, TensorRT-LLM, llama.cpp, dan Ollama masing-masing mengalokasikan memori secara berbeda. |
| CUDA graphs dan kernel | Mesin serving dapat menyisihkan workspace untuk kecepatan dan stabilitas. |
| Adapter LoRA | Adapter yang di-fine-tune menambah memori lebih sedikit daripada bobot penuh, tetapi tetap membutuhkan budget. |
| Margin keamanan | Endpoint produksi membutuhkan ruang untuk variasi prompt, retry, dan perubahan deployment. |
Itulah sebabnya kebutuhan VRAM model 70b yang dikuantisasi tidak sama dengan "file 4-bit berukuran 35GB." Model 70B terkuantisasi berukuran 35GB hingga 45GB mungkin dapat dimuat di GPU 48GB, tetapi konteks yang lebih panjang, batch yang lebih besar, atau runtime yang lebih berat tetap bisa gagal.
Opsi single-GPU untuk model 32B dan 70B
GPU 24GB
Kartu 24GB berguna untuk model 32B dalam bentuk 4-bit, pengujian 70B yang lebih kecil dengan partial CPU offload, dan eksperimen developer di mana latensi bukan tujuan utama.
Jangan menganggap 24GB sebagai jawaban yang nyaman untuk kebutuhan VRAM model 70b. Ini bisa berguna dengan kuantisasi agresif, konteks yang dikurangi, CPU offload, atau pengujian lokal ala llama.cpp, tetapi biasanya bukan tier serving 70B untuk produksi.
Paling cocok untuk:
- Inferensi 32B 4-bit.
- Jendela konteks kecil.
- Pengujian lokal untuk satu pengguna.
- Evaluasi prototipe sebelum menyewa GPU yang lebih besar.
Hal yang perlu diwaspadai:
- 70B sering memerlukan CPU offload atau pengaturan yang sangat ketat.
- Prompt yang panjang dapat menghabiskan cache KV dengan cepat.
- Throughput akan terbatas.
GPU 48GB
48GB adalah tier single-GPU serius pertama untuk pekerjaan 70B terkuantisasi. Ini dapat menjalankan banyak beban kerja inferensi 70B 4-bit jika konteks dan konkurensi dikendalikan. Ini juga merupakan batas praktis bawah untuk banyak eksperimen QLoRA, sejalan dengan hasil asli QLoRA yang menunjukkan fine-tuning kelas 65B besar pada satu GPU 48GB.
Paling cocok untuk:
- Inferensi lokal 70B 4-bit.
- Inferensi 32B 8-bit.
- Fine-tuning 32B dengan ruang untuk adapter dan konteks yang lebih panjang.
- Eksperimen qlora fine-tuning 70b model vram requirements yang ketat.
Hal yang perlu diwaspadai:
- 70B pada 8-bit biasanya tidak memiliki ruang cadangan yang cukup.
- Layanan dengan konteks panjang dapat mendorong model 70B 4-bit melewati batas.
- Ukuran batch terbatas.
GPU 80GB
80GB adalah jawaban praktis yang paling umum untuk pekerjaan 70B serius. GPU kelas A100 80GB dan H100 80GB dapat menangani banyak beban kerja inferensi 70B terkuantisasi dengan ruang konteks yang lebih lega dibanding 48GB, dan merupakan titik awal yang jauh lebih nyaman untuk QLoRA.
Paling cocok untuk:
- Inferensi 70B 4-bit dengan pengujian konteks mirip produksi.
- Inferensi 70B 8-bit jika runtime dan konteksnya cocok.
- Inferensi 32B FP16/BF16 dengan overhead.
- QLoRA 70B dengan pengaturan yang dibatasi tetapi realistis.
Hal yang perlu diwaspadai:
- 70B FP16/BF16 biasanya membutuhkan lebih dari satu GPU 80GB.
- Konkurensi tinggi tetap memerlukan perencanaan KV-cache yang cermat.
- Bentuk node dan harga yang spesifik per penyedia bisa sama pentingnya dengan VRAM.
GPU 96GB, 141GB, dan 180GB
Akselerator memori tinggi yang lebih baru mengubah pertanyaan single-GPU. Kartu 96GB memberi lebih banyak ruang untuk 70B 8-bit atau konteks terkuantisasi yang lebih besar. Memori 141GB kelas H200 dapat membuat banyak beban kerja 70B muat dengan ruang cadangan yang jauh lebih besar. Konfigurasi 180GB kelas B200 mendorong batas single-GPU atau single-node lebih jauh, terutama ketika stack serving dapat memanfaatkan jalur presisi rendah yang lebih baru.
Paling cocok untuk:
- Inferensi 70B dengan konteks panjang.
- Ukuran batch dan konkurensi yang lebih tinggi.
- Layanan 8-bit atau presisi campuran.
- Mengurangi kompleksitas sharding untuk model besar.
Hal yang perlu diwaspadai:
- Ketersediaan dan harga sewa dapat lebih penting daripada kecocokan teoritis.
- Kematangan perangkat lunak berbeda antar generasi GPU.
- Anda tetap memerlukan benchmark untuk biaya per output yang diterima.
Untuk perbandingan perangkat keras terkait, lihat B200 vs H200, H200 vs H100, dan GPU terbaik untuk inferensi LLM.
Opsi multi-GPU untuk model 70B
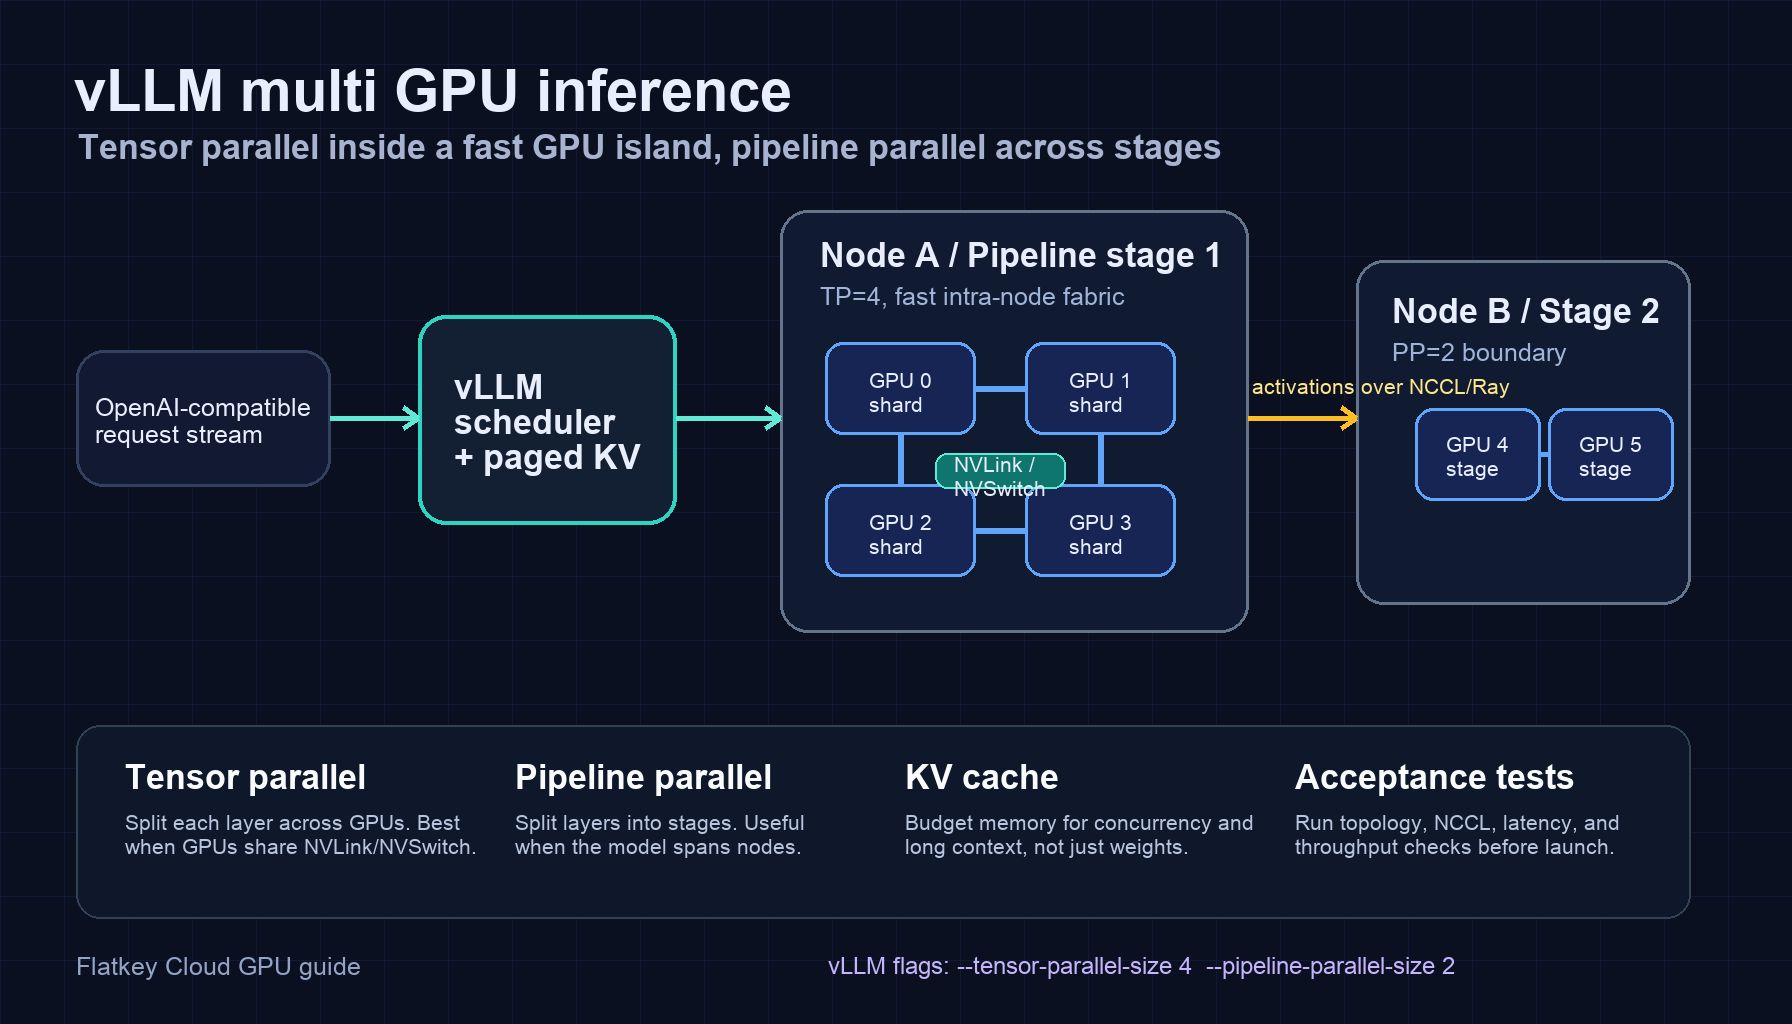
Serving multi-GPU bukan hanya "VRAM lebih banyak." Ini juga menambah overhead komunikasi, pertimbangan topologi, risiko penempatan, dan kompleksitas perangkat lunak.
Gunakan multi-GPU ketika:
- Model tidak muat di satu GPU pada presisi yang Anda butuhkan.
- Konteks panjang atau konkurensi tinggi membutuhkan lebih banyak ruang KV-cache.
- Anda memerlukan serving 70B FP16/BF16.
- Anda memerlukan throughput yang tidak bisa diberikan oleh satu GPU.
- Anda dapat memvalidasi tensor parallelism dan performa interkoneksi.
| Opsi | Kapan masuk akal | Apa yang perlu diverifikasi |
|---|---|---|
| 2x48GB | Serving 70B terkuantisasi dengan ruang cadangan lebih besar daripada satu kartu 48GB | Interkoneksi, dukungan tensor-parallel, perilaku kegagalan. |
| 2x80GB | Eksperimen 70B FP16/BF16 atau serving terkuantisasi dengan ruang cadangan tinggi | Apakah sharding mengalahkan satu GPU yang lebih besar pada latensi dan biaya. |
| 4x80GB | Serving 70B yang lebih berat, konteks lebih besar, beberapa replika, atau fine-tuning | NVLink/NVSwitch, kebijakan batch, utilisasi, strategi checkpoint. |
| 8x80GB atau lebih besar | Klaster produksi bersama, beberapa endpoint, atau model yang lebih besar dari 70B | Scheduler, penyimpanan, observabilitas, dan alokasi biaya. |
Untuk deployment multi-node, desain klaster sangat penting. Gunakan panduan arsitektur klaster GPU untuk meninjau kebutuhan komputasi, jaringan, penyimpanan, dan control plane sebelum membeli kapasitas.
Persyaratan VRAM model Ollama 70B
Jawaban untuk ollama 70b model vram requirements bergantung pada tag model dan kuantisasi. Halaman model Ollama biasanya mencantumkan artefak 70B terkuantisasi dalam kisaran puluhan gigabyte, bukan 140GB, karena jalur local-serving default biasanya terkuantisasi, bukan FP16.
Aturan praktis:
- 48GB bisa cukup untuk memuat dan menguji beberapa model 70B terkuantisasi.
- 64GB hingga 80GB memberi lebih banyak ruang untuk konteks dan lebih sedikit kejutan OOM.
- 24GB biasanya berarti model yang lebih kecil, konteks lebih pendek, offload berat, atau eksperimen lambat.
- Jika Anda memerlukan latensi produksi atau banyak pengguna, ukuran untuk ruang cadangan serving, bukan hanya ukuran model yang diunduh.
Untuk pengujian lokal, catat tag model yang tepat, kuantisasi, panjang konteks, lapisan GPU, dan penggunaan memori yang teramati. Jangan menulis "70B berjalan di GPU saya" tanpa detail itu. Keluarga 70B yang sama dapat memiliki beberapa varian terkuantisasi dengan perilaku memori yang berbeda.
Persyaratan VRAM model QLoRA fine-tuning 70B
Pertanyaan qlora fine-tuning 70b model vram requirements memiliki dua jawaban:
- Landasan riset bisa jadi sangat rendah karena QLoRA membekukan model dasar, melakukan kuantisasi, dan melatih adapter low-rank kecil.
- Zona nyaman produksi lebih tinggi karena panjang sekuens, ukuran batch, gradient checkpointing, pipeline data, frekuensi evaluasi, dan manajemen adapter semuanya menambah tekanan memori praktis.
Gunakan tabel perencanaan ini:
| Setup fine-tuning | Titik awal 32B | Titik awal 70B | Catatan |
|---|---|---|---|
| Eksperimen QLoRA minimal | 24GB hingga 48GB | 48GB | Jaga panjang sekuens dan ukuran batch tetap moderat. |
| Jalankan QLoRA yang praktis | 48GB hingga 80GB | 80GB | Lebih banyak ruang untuk data, evaluasi, dan lebih sedikit restart. |
| Sekuens lebih panjang atau effective batch lebih besar | 80GB atau multi-GPU | 2x80GB atau lebih besar | Memori bertambah seiring panjang sekuens dan strategi pelatihan. |
| Full fine-tuning | Multi-GPU | Klaster multi-GPU | Status optimizer membuat full fine-tuning menjadi masalah yang berbeda. |
Jika kueri Anda adalah qlora fine-tune 70b model vram requirements, mulailah dengan membuktikan satu run yang dibatasi pada 48GB atau 80GB, lalu naikkan panjang sekuens dan effective batch hanya setelah mencatat penggunaan memori puncak yang sebenarnya. Untuk workflow fine-tuning produksi, kapasitas 80GB atau multi-GPU biasanya lebih mudah dioperasikan daripada setup minimum-memory sekali pakai.
KV cache dan panjang konteks dapat mengubah jawaban
Model 70B yang muat pada konteks 4K mungkin tidak muat pada konteks 32K. KV cache bertambah seiring:
- Jumlah layer.
- KV heads dan dimensi head.
- Panjang konteks.
- Ukuran batch atau sequence aktif.
- Jumlah byte per elemen KV-cache.
Mesin serving mengelola ini secara berbeda. vLLM menampilkan utilisasi memori dan perilaku KV-cache sebagai perhatian utama dalam serving. llama.cpp dan serving lokal bergaya Ollama menampilkan opsi konteks dan offload yang dapat membuat model muat, tetapi dengan tradeoff performa.
Workflow praktisnya:
- Muatan model pada kuantisasi yang dituju.
- Setel panjang konteks yang nyata, bukan default.
- Jalankan distribusi prompt yang sesuai dengan produksi.
- Tingkatkan concurrency sampai latensi atau memori gagal.
- Catat VRAM puncak, request yang gagal, token per detik, dan kualitas output yang diterima.
Jangan menentukan ukuran 70b model vram requirements dari uji muat kosong. Tentukan ukuran dari konteks dan concurrency yang benar-benar akan Anda jalankan.
Lembar kerja VRAM sederhana
Gunakan lembar kerja ini sebelum menyewa atau mencadangkan kapasitas.
model_family:
parameter_count: 32B | 70B | other
precision: fp16 | bf16 | int8 | 4-bit | mixed
serving_engine: Ollama | llama.cpp | vLLM | SGLang | TensorRT-LLM | other
target_context_window:
input_tokens_p50:
input_tokens_p95:
output_tokens_p50:
output_tokens_p95:
target_concurrency:
batching_policy:
fine_tuning_method: none | LoRA | QLoRA | full fine-tune
gpu_candidate:
gpu_memory:
observed_idle_load_vram:
observed_peak_vram:
oom_failures:
tokens_per_second:
accepted_outputs_per_hour:
cost_per_accepted_output:
Untuk perencanaan biaya, padukan lembar kerja ini dengan harga sewa GPU, biaya tersembunyi cloud GPU, dan TCO klaster GPU.
Kapan model API lebih baik daripada menyewa GPU
Kapasitas GPU masuk akal ketika Anda membutuhkan kontrol langsung atas bobot, kuantisasi, deployment, adapter kustom, serving privat, atau utilisasi yang berkelanjutan.
Model API bisa lebih baik ketika:
- Lalu lintas bersifat bursty.
- Produk sering berganti model.
- Tim tidak ingin mengoperasikan infrastruktur serving.
- Ekonomi unit lebih mudah dikelola per request daripada per jam GPU.
- Anda membutuhkan akses cepat ke beberapa keluarga model, bukan satu deployment tetap.
Flatkey berada di sisi API dari keputusan tersebut. Platform ini memberi developer endpoint yang kompatibel dengan OpenAI, satu kunci, satu saldo, satu faktur, dan ledger penggunaan di seluruh model serta alat resmi. Jika lembar kerja 70b model vram requirements Anda menunjukkan utilisasi rendah, margin OOM yang rapuh, atau overhead operasional yang berat, benchmark baseline model/API sebelum berkomitmen pada sewa GPU. Panduan GPU cloud vs model API memberikan kerangka keputusan.
Sumber resmi dan dokumentasi yang perlu tetap dibuka
| Sumber | Mengapa ini penting |
|---|---|
| Makalah QLoRA dan repositori QLoRA | Dasar untuk fine-tuning adapter ber-memori rendah pada model besar. |
| Dokumentasi quantization bitsandbytes Hugging Face | Perilaku loading 8-bit dan 4-bit yang praktis di Transformers. |
| Dokumentasi vLLM | Perilaku memori serving, batching, dan KV-cache. |
| Repositori llama.cpp | GGUF, offload CPU/GPU, dan perilaku inferensi lokal. |
| Pustaka model Ollama | Tag model, ukuran artefak terkuantisasi, dan opsi serving lokal. |
| NVIDIA A100, H100, H200, dan DGX B200 | Tingkat memori GPU resmi yang digunakan dalam keputusan sizing. |
Rekomendasi akhir
Untuk model 32B, mulailah dengan 24GB untuk eksperimen 4-bit, 48GB untuk inferensi yang nyaman, dan 80GB jika Anda menginginkan FP16/BF16, context yang lebih panjang, atau ruang untuk fine-tuning.
Untuk model 70B, anggap 48GB sebagai titik awal 4-bit yang terbatas, 80GB sebagai tier praktis untuk inferensi serius, dan 96GB hingga 180GB atau multi-GPU sebagai tier ruang produksi. Untuk FP16/BF16 70B, rencanakan multi-GPU atau GPU dengan memori sangat besar.
Jawaban terbaik untuk 70b model vram requirements bukanlah satu angka GPU. Ini adalah konfigurasi yang terukur: model, quantization, panjang context, concurrency, mesin serving, metode fine-tuning, dan biaya per output yang diterima.
Pertanyaan yang Sering Diajukan
Berapa banyak VRAM yang dibutuhkan model 70B?
Model 70B membutuhkan sekitar 140GB hanya untuk bobot FP16 atau BF16, sekitar 70GB sebelum overhead pada 8-bit, dan kira-kira 35GB hingga 45GB untuk banyak varian terkuantisasi 4-bit. Dalam praktiknya, 70b model vram requirements menjadi lebih tinggi setelah KV cache, buffer runtime, panjang context, dan concurrency diperhitungkan.
Apakah model 70B dapat berjalan di GPU 48GB?
Ya, model 70B dapat berjalan di GPU 48GB ketika dikuantisasi secara agresif dan context/concurrency dikendalikan. Itu adalah tier yang layak untuk inferensi lokal dan pengujian terbatas, tetapi 80GB atau lebih besar lebih aman untuk serving seperti produksi.
Apa saja kebutuhan VRAM model 70B untuk Ollama?
Untuk ollama 70b model vram requirements, periksa tag model yang tepat dan ukuran artefak terkuantisasi. 48GB bisa cukup untuk beberapa model 70B terkuantisasi, tetapi 64GB hingga 80GB memberi ruang lebih untuk context dan mengurangi kegagalan OOM.
Apa saja kebutuhan VRAM model 70B untuk QLoRA?
Untuk qlora 70b model vram requirements, 48GB adalah batas bawah praktis untuk riset dengan eksperimen terbatas, sementara kapasitas 80GB atau multi-GPU lebih aman untuk panjang sequence yang lebih panjang, batch efektif yang lebih besar, dan alur kerja fine-tuning produksi.
Apakah 24GB cukup untuk model 70B?
24GB biasanya tidak cukup untuk inferensi GPU 70B yang nyaman. Ini mungkin bekerja dengan quantization berat, CPU offload, window context kecil, atau eksperimen lambat, tetapi lebih baik dianggap sebagai tier terkuantisasi 32B.
Apakah 80GB cukup untuk model 70B?
80GB cukup untuk banyak beban kerja inferensi 70B terkuantisasi dan run QLoRA yang terbatas. Biasanya tidak cukup untuk inferensi 70B FP16/BF16 penuh pada satu GPU setelah overhead, dan tetap bisa gagal jika window context atau concurrency terlalu besar.