
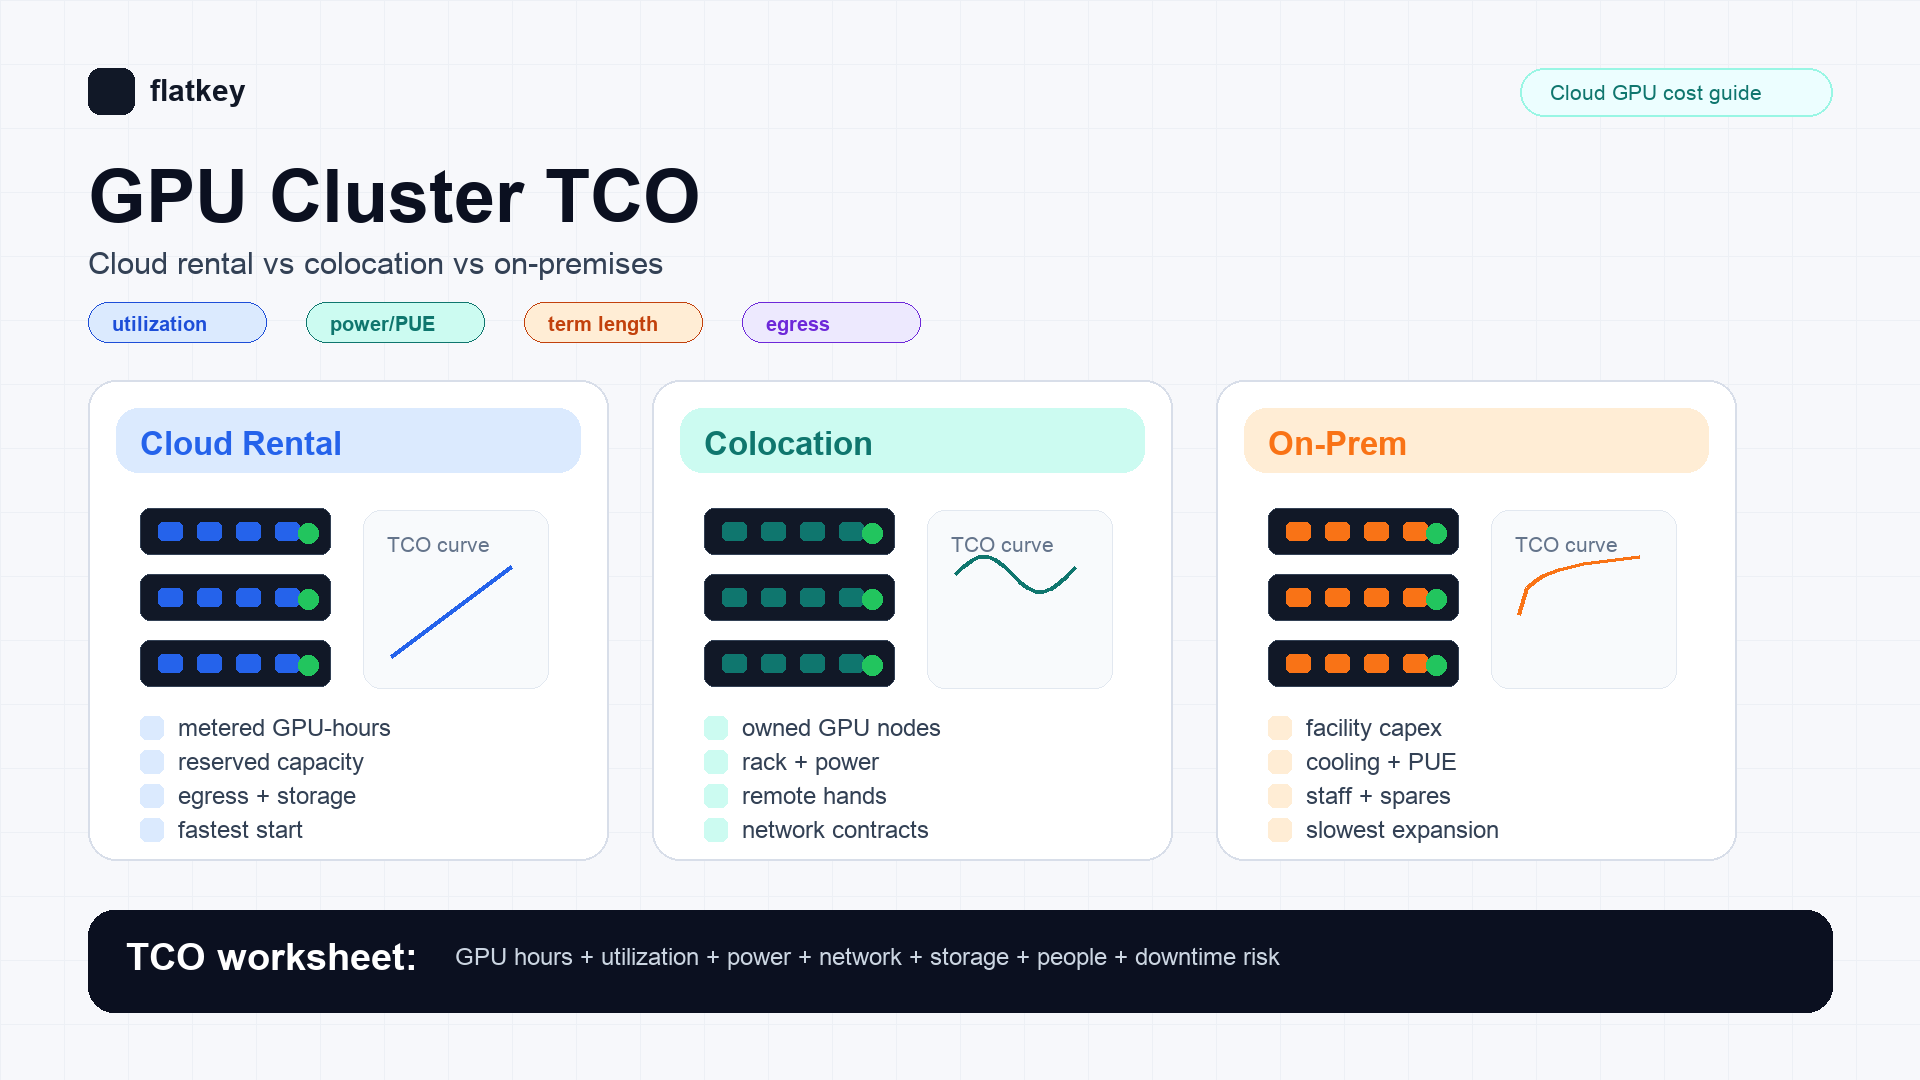
Die meisten TCO-Vergleiche für GPU-Cluster scheitern aus demselben Grund: Sie vergleichen einen stündlichen Cloud-Tarif mit einem Hardware-Bestellauftrag. Das ist nicht die Entscheidung.
Die eigentliche Entscheidung ist, ob Ihr KI-Team Flexibilität kaufen, Hardware kaufen oder die Kontrolle über die Infrastruktur kaufen sollte. Ein seriöses TCO-Modell für GPU-Cluster muss Cloud-Miete, Colocation und On-Premises auf dieselbe Ausgabe normieren: abgeschlossene Trainingsläufe, akzeptierte Inferenz-Tokens, erzeugte Media-Jobs oder reservierte Kapazitätsmonate.
Für die meisten Teams gewinnt die GPU-Miete in der Cloud, wenn die Auslastung unsicher ist, die Geschwindigkeit der Bereitstellung zählt oder sich die Workload je nach Modellfamilie ändert. Colocation beginnt zu gewinnen, wenn die Nachfrage konstant ist, das Team Hardware betreiben kann und der Vertrag lang genug ist, um GPUs, Netzwerke, Ersatzteile und Remote Hands zu amortisieren. On-Premises erfordert in der Regel die stärkste Begründung: sehr hohe und vorhersehbare Auslastung, vorhandene Rechenzentrumsbetriebe, harte Anforderungen an die Datenlokalität oder ein strategisches Mandat, die Facility-Ebene zu besitzen.
Die praktische Regel von Flatkey: Starten Sie mit der Workload, nicht mit dem Rack. Wenn die Workload durch eine verwaltete Modell-API bedient werden kann, vergleichen Sie zuerst das. Wenn Sie wirklich dedizierte GPUs benötigen, kalkulieren Sie Cloud-Miete, Colocation und On-Premises mit demselben Arbeitsblatt, bevor Sie einen Kapazitätsvertrag unterschreiben.
GPU-Cluster-TCO Kurzantwort
Nutzen Sie diese erste Entscheidungstabelle, bevor Sie das vollständige Modell aufbauen.
| Situation | Normalerweise starten mit | Warum |
|---|---|---|
| Prototyping, sprunghaftes Fine-Tuning, kurzes Benchmark-Fenster | Cloud-GPU-Miete | Niedrigste Verpflichtung und schnellster Weg zur Kapazität. |
| Stetiger Inferenz-Fuhrpark über mehrere Monate mit bekanntem Modellmix | Reservierte Cloud-Kapazität oder Colocation | Die Auslastung ist hoch genug, um Laufzeitpreise auszuhandeln, aber das Eigentumsrisiko lässt sich möglicherweise noch vermeiden. |
| Große Trainingsjobs mit strengen Anforderungen an die Netzwerktopologie | Dedizierter Cloud-Cluster oder Colocation | Sie benötigen vorhersehbare Node-Platzierung, Netzwerk-Fabric, Speicherlokalität und Benchmark-Abnahme. |
| Mehrjährige Auslastung oberhalb Ihrer internen Hürdenrate | Colocation oder On-Premises | Hardware-Amortisation kann die stündliche Miete nur schlagen, wenn Leerlauf, Betrieb, Strom und Ausfallzeiten ehrlich mitgerechnet werden. |
| Regulatorische Datenlokalität oder Mandat zur Kontrolle der Infrastruktur | On-Premises oder kontrollierte Colocation | Die TCO-Entscheidung umfasst Compliance und Kontrolle, nicht nur den Compute-Preis. |
| Die App benötigt nur Modell-Outputs, keine GPU-Kontrolle | Modell-API oder GPU-Marktangebot | Der Kauf eines Clusters kann überdimensioniert sein, wenn die Geschäftskennzahl Kosten pro akzeptiertem Output ist. |
Der Rest dieses Leitfadens zeigt, wie Sie ein GPU-Cluster-TCO-Arbeitsblatt erstellen, das Beschaffung, Plattform-Engineering und Finance gemeinsam nutzen können.
Jede Option auf eine Einheit normieren
Vergleichen Sie nicht "H100 pro Stunde" mit "Serverkaufpreis". Wählen Sie einen Nenner und zwingen Sie jede Option in diese Einheit.
Nützliche Nenner sind unter anderem:
- Kosten pro abgeschlossenem Trainingslauf: am besten für periodisches Fine-Tuning, Pretraining-Experimente und Batch-Jobs.
- Kosten pro akzeptiertem Output: am besten für LLM-Inferenz, Codegenerierung, Bilderzeugung und Video-Pipelines, bei denen Wiederholungen zählen.
- Kosten pro reserviertem GPU-Monat: am besten für Plattformteams, die interne Kapazität für mehrere Produktteams einkaufen.
- Kosten pro SLA-qualifiziertem Token oder Job: am besten, wenn Ausfallzeiten, Preemption oder Warteschlangenverzögerungen die sichtbare Zuverlässigkeit verändern.
Für Inferenz ist der sauberste Nenner oft:
effective_cost_per_accepted_output =
  total_monthly_cluster_cost
  / accepted_outputs_after_retries_and_quality_filters
Dieser Nenner erfasst zwei Dinge, die der Stundenpreis verdeckt: fehlgeschlagene Jobs und ungenutzte Kapazität.
GPU-Cluster-TCO-Formel
Verwenden Sie dieses Modell, bevor Sie anbieterspezifische Details hinzufügen:
monthly_gpu_cluster_tco =
  capacity_cost
  + storage_cost
  + data_transfer_cost
  + network_and_interconnect_cost
  + software_and_observability_cost
  + labor_and_operations_cost
  + support_and_warranty_cost
  + financing_or_depreciation_cost
  + downtime_and_retry_waste
Konvertieren Sie es dann in die Einheit, die Sie interessiert:
unit_cost =
  monthly_gpu_cluster_tco
  / useful_work_completed_per_month
Das ist wichtig, weil ein günstiger GPU-Stundenpreis trotzdem teuer sein kann, wenn der Cluster unterausgelastet ist, Jobs in der Warteschlange warten, Speicher in der falschen Region liegt oder fehlgeschlagene Läufe volle Zeitkosten verursachen.
Kostenkomponenten nach Bereitstellungsmodell
| Kostenposition | Cloud-Miete | Colocation | On-Premises |
|---|---|---|---|
| GPU-Kapazität | On-Demand, Spot, Reserved, Dedicated oder Marktangebot. | Hardwarekauf oder -leasing plus Rack-Vertrag. | Hardwarekauf oder -leasing plus interne Zuordnung von Facility-Kosten. |
| Strom und Kühlung | Meist im Tarif enthalten, aber nicht kostenlos. | Vertraglich vereinbarter Strom, gemessener Strom, Kühl-Overhead und Grenzen der Leistungsdichte. | Netzstrom, USV, Generator, Kälteanlage und PUE-Risiko. |
| Netzwerk | Datenausgang, private Verbindungen, öffentliche IPs, Cross-Region-Traffic, Interconnect. | Transit, Cross-Connects, private Verbindungen, Remote-Zugriff, DDoS-/Sicherheitsdienste. | WAN, Internet-Transit, private Verbindungen, Firewalls, Switching, redundante Pfade. |
| Speicher | Block, Object, Filesystem, Snapshots, Backups, IOPS-Tiers. | Lokale NVMe, Shared Storage, Backup-Ziel, Remote-Replikation. | Storage-Hardware, Backup, Replikation, Medienersatz, Lifecycle-Operationen. |
| Betrieb | Meist Plattformintegration und Kostenkontrollen. | Hardware-Lebenszyklus, Remote Hands, Abnahmetests, Ersatzteile, RMA-Koordination. | Voller Facility- und Hardware-Betrieb, physischer Zugriff, Ersatzteile, Abdeckung außerhalb der Geschäftszeiten. |
| Bindungsrisiko | Niedrig bei On-Demand; höher bei Reserved- oder Dedicated-Verträgen. | Mittel bis hoch. Vertragsausstieg und Wiederverkauf der Hardware sind wichtig. | Am höchsten. Facility- und Geräteentscheidungen können die Roadmap des Modells überdauern. |
Cloud-Miete wirkt einfach, weil viele Kosten im Tarif gebündelt sind. Colocation und On-Premises wirken günstiger, wenn die Tabelle die Kosten für Personal, Strom, Netzwerk und Ausfälle vergisst.
Cloud-Miete: was zu berücksichtigen ist
Cloud-Miete ist die sauberste Ausgangsbasis für die TCO eines GPU-Clusters, weil sie Kapazität in einen gemessenen Service umwandelt. Das bedeutet nicht, dass der Stundensatz die vollständigen Kosten darstellt.
Berücksichtigen:
- Stundensatz für GPU-Instanzen oder Bare-Metal.
- Bedingungen für reservierte, zugesagte oder dedizierte Kapazität.
- Dem Cluster zugeordneter Speicher.
- Object Storage und Snapshot-Aufbewahrung.
- Datentransfer und Datenausgang.
- Private Vernetzung, Load Balancer, öffentliche IPs und NAT.
- Scheduler, Kubernetes, Slurm, Observability, Logging und Alerting.
- Leerlaufzeit durch Warteschlangenlücken, fehlgeschlagene Deployments, Cold Starts und schlechtes Bin Packing.
- Bei Nutzung von Spot oder unterbrechbaren Instanzen: Wiederholungsaufwand durch Unterbrechungen.
- Supportplan- und Account-Management-Kosten.
Cloud-Miete gewinnt in der Regel, wenn die Nachfragekurve des Teams ungewiss ist. Sie liefert der Beschaffung außerdem einen aktuellen Preismaßstab. Öffentliche Anbieterseiten von AWS, Google Cloud, Lambda, RunPod und anderen GPU-Clouds sind nützlich als Quellencheck, aber die einzige Zahl, die für einen großen Cluster zählt, ist das Angebot, das Sie tatsächlich für die benötigte Region, Topologie und Laufzeit reservieren können.
Nutzen Sie offizielle Seiten als Orientierungspunkte:
- AWS beschreibt P5-Infrastruktur für KI-Workloads im großen Maßstab auf seiner EC2-P5-Instanzseite.
- Google Cloud veröffentlicht GPU-Preise und weist darauf hin, dass die Preisgestaltung von GPU-Typ, Region und Nutzungsmodell abhängt.
- Lambda und RunPod veröffentlichen Preisstrukturen für GPU-Clouds, die für schnelle Marktchecks nützlich sind.
- Flatkey Compute veröffentlicht einen Live-Preisindex für GPU-Stunden und ermöglicht Käufern, anonyme GPU-Anfragen zu stellen, auf die verifizierte Anbieter bieten können.
Behandeln Sie jeden Preis als zeitgestempelt. Verfügbarkeit und Stundensätze für GPUs verändern sich schneller als gewöhnliche SaaS-Preise.
Colocation: was zu berücksichtigen ist
Colocation ist nicht einfach „Cloud, aber billiger“. Es verlagert einen großen Teil des Betriebsaufwands vom Anbieter auf Ihr Team.
Berücksichtigen:
- GPU-Server, Netzwerkadapter, Switches, Optiken, Kabel und Speicher.
- Rack- oder Cage-Gebühren.
- Vertraglich vereinbarter Strom und gemessener Strom.
- Kühlung und Einschränkungen der Dichte.
- Cross-Connects, Internet-Transit, private Verbindungen und Netzwerksicherheit.
- Remote Hands, Versand, Wareneingang, Installation, Inventarisierung und RMA-Abwicklung.
- Ersatz-GPUs, Netzteile, NICs, Optiken, Lüfter und Speichermedien.
- Hardware-Abschreibung, Leasingkosten, Finanzierungskosten und Annahmen zum Wiederverkaufswert.
- Facility-SLA, Wartungsfenster und Zugriffsverfahren.
- Plattformbetrieb: Images, Treiber, CUDA-Stack, Kubernetes oder Slurm, Observability, Sicherheitspatches und Incident Response.
Colocation beginnt sinnvoll zu werden, wenn die Auslastung vorhersehbar und hoch ist, das Team echte Infrastruktur-Betriebskompetenz besitzt und der Vertrag genug Leistungsdichte für die geplante GPU-Generation bietet. Sie scheitert, wenn Teams zwar die Hardware kaufen, aber Remote Hands, Netzwerk, Leistungsgrenzen, Ersatzteile und langsame Erweiterungen unterschätzen.
Für GPU-Cluster ist das Netzwerk-Backbone oft die Position, die die Architektur entscheidet. Ein Cluster, der eng gekoppelte Trainings benötigt, ist nicht gleichzusetzen mit einer Reihe isolierter Inferenz-Knoten. Wenn der Workload von InfiniBand, RoCE, NVLink, NVSwitch oder einem bestimmten Storage-Layout abhängt, sollte das Teil des Angebots und des Abnahmetests sein.
On-Premises: was zu berücksichtigen ist
Die TCO eines On-Premises-GPU-Clusters sollte als Facility-Projekt behandelt werden, nicht als Serverkauf.
Berücksichtigen:
- Alles aus dem Colocation-Modell.
- Flächenzuordnung im Rechenzentrum oder Ausbau.
- Elektroarbeiten, USV, Generator, Stromverteilung und Brandschutz.
- Kapazität und Wartung der Kälteanlage.
- Physische Sicherheit und Zutrittskontrolle.
- Facility-Personal und Eskalation außerhalb der Geschäftszeiten.
- Versicherung, Compliance-Audits und Sicherheitsverfahren.
- Langfristige Kapazitätsplanung für die nächste GPU-Generation.
- Opportunitätskosten des in Facility und Hardware gebundenen Kapitals.
On-Premises kann für Organisationen mit bestehender Rechenzentrumsinfrastruktur, hoher Auslastung, strengen Anforderungen an den Standort oder strategischen Kontrollvorgaben sinnvoll sein. Es ist die schwächste Wahl, wenn das Team noch Modellmix, Kontextlänge, Durchsatzziel und Product-Market-Fit ermittelt.
Das versteckte Risiko ist der Generationswechsel bei GPUs. Eine Entscheidung für eine Anlage kann länger Bestand haben als die Modellarchitektur, die Sie darauf betreiben. Wenn Ihr TCO davon abhängt, dass eine Modellfamilie drei Jahre lang dominant bleibt, testen Sie diese Annahme unter Stress.
Break-even-Auslastung
Die zentrale Break-even-Frage lautet:
required_utilization =
  owned_monthly_cost
  / equivalent_cloud_monthly_cost_at_100_percent_use
Wenn die eigene Infrastruktur monatlich $X kostet und die entsprechende Cloud-Miete bei voller Auslastung monatlich $Y kostet, dann lohnt sich Eigentum nur, wenn die nutzbare Auslastung über X / Y liegt. Nutzbare Auslastung bedeutet Arbeit, für die andernfalls bezahlt worden wäre. Sie schließt ungenutzte Kapazität, fehlgeschlagene Jobs, Warteschlangenpuffer und für seltene Spitzen reservierte Kapazität aus.
Führen Sie das Modell in drei Szenarien aus:
| Szenario | Was zu testen ist |
|---|---|
| Basisfall | Erwartete Arbeitslast, erwartete Auslastung, erwartete Laufzeit. |
| Negativfall | Niedrigere Auslastung, verzögerte Produktnutzung, schwächerer Wiederverkauf, höhere Stromkosten, langsamere Akzeptanz. |
| Stresstest | Das neue Modell passt nicht in den Speicher, die Netzwerktopologie ist falsch, oder die Nachfrage verlagert sich auf eine verwaltete API. |
Wenn der Negativfall die Wirtschaftlichkeit zerstört, sind Cloud-Miete oder ein kürzerer dedizierter Vertrag in der Regel der sicherere erste Schritt.
Kopierbares TCO-Arbeitsblatt für GPU-Cluster
Verwenden Sie dieses Arbeitsblatt in Ihrem Beschaffungsdokument. Füllen Sie es einmal für Cloud-Miete, einmal für Colocation und einmal für On-Premises aus.
| Feld | Cloud-Miete | Colocation | On-Premises |
|---|---|---|---|
| GPU-Modell und Anzahl | |||
| Vertragslaufzeit | |||
| Erwartete nutzbare Auslastung | |||
| Monatliche GPU-Kapazitätskosten | |||
| Speicher und Backup | |||
| Datenübertragung und Netzwerk | |||
| Strom und Kühlung | Inbegriffen oder angeboten | ||
| Rack-, Cage- oder Anlagenzuweisung | N. z. | ||
| Hardware-Abschreibung oder Leasing | N. z. | ||
| Remote Hands / Personal | |||
| Support, Garantie und Ersatzteile | |||
| Observability und Plattform-Tools | |||
| Ausfallzeit und Retry-Verschwendung | |||
| Geschätzter monatlicher TCO | |||
| Einheitskosten-Nenner | |||
| Kosten pro akzeptierter Ausgabe | |||
| Vorlaufzeit für Erweiterung | |||
| Ausstiegskosten |
Überspringen Sie die letzten zwei Zeilen nicht. Vorlaufzeit für Erweiterung und Ausstiegskosten sind die Stellen, an denen attraktive Hardware-Ökonomie oft teuer wird.
Beschaffungsfragen, die Sie jedem Anbieter stellen sollten
Für Cloud-Miete:
- Ist die angebotene Kapazität geteilt, reserviert, dediziert oder Bare Metal?
- Welche Region, Availability Zone und Node-Platzierung sind garantiert?
- Welches exakte GPU-Modell, welche Speichergröße, Interconnect, CPU, RAM, lokaler Speicher und welches Netzwerk-Fabric sind enthalten?
- Sind Speicher, Snapshots, Objektspeicher, Bandbreite, öffentliche IPs und Support enthalten?
- Was passiert, wenn der Cluster während der Laufzeit nicht verfügbar ist?
- Kann der Anbieter vor Beginn der Verpflichtung einen Abnahme-Benchmark ausführen?
- Wie werden fehlgeschlagene Jobs, Plattformausfälle und Wartungsfenster gutgeschrieben?
Für Colocation:
- Welche Leistungsdichte ist pro Rack vertraglich vereinbart?
- Wird Strom gemessen, zugesagt oder in den Rack-Preis eingerechnet?
- Welche Remote-Hands-Arbeiten sind enthalten, und was ist abrechenbar?
- Welche Carrier und privaten Verbindungen sind verfügbar?
- Wie schnell können zusätzliche Racks, Strom und Cross-Connects bereitgestellt werden?
- Wer besitzt Ersatzteile, RMAs und Firmware-Wartung?
- Welcher Abnahmetest bestätigt, dass der Cluster produktionsreif ist?
Für On-Premises:
- Unterstützt die Anlage bereits die angestrebte Leistungsdichte?
- Ist Kühlkapazität ohne Ausbau verfügbar?
- Wer ist für die 24/7-Hardware-Reaktion verantwortlich?
- Wie sieht der Freigabeprozess für elektrische, Netzwerk- und Sicherheitsänderungen aus?
- Wie lang ist der Abschreibungszeitraum, und welcher Wiederverkaufswert wird angenommen?
- Was passiert, wenn das nächste Modell mehr Speicher, mehr Bandbreite oder einen anderen Serving-Stack benötigt?
Entscheidungsmatrix
| Kriterium | Cloud-Miete | Colocation | On-Premises |
|---|---|---|---|
| Startgeschwindigkeit | Am besten | Mittel | Am langsamsten |
| Vorabkapital | Am niedrigsten | Mittel bis hoch | Am höchsten |
| Betriebsaufwand | Am niedrigsten | Mittel | Am höchsten |
| Langfristige Wirtschaftlichkeit bei gleichmäßiger Auslastung | Mittel | Stark, wenn gut betrieben | Stark nur bei ausgereifter Infrastruktur |
| Flexibilität nach GPU-Generation | Am besten | Mittel | Am niedrigsten |
| Kontrolle über die Einrichtung | Niedrig | Mittel | Am höchsten |
| Rückabwickelbarkeit der Beschaffung | Am besten | Mittel | Am niedrigsten |
| Benchmark-Anforderung | Wichtig | Kritisch | Kritisch |
Die am besten vertretbare Antwort lautet selten "immer Cloud" oder "immer kaufen". Es ist normalerweise ein gestufter Ansatz: für die Erkundung mieten, für stetige Nachfrage reservieren, bei nachgewiesener Auslastung colokieren und On-Premises nur dann wählen, wenn die Kontrolle über die Einrichtung Teil der Anforderung ist.
Häufige Fehler in GPU-Cluster-TCO-Modellen
Listenpreis mit Best-Case-Eigentum vergleichen
Ein fairer GPU-Cluster-TCO-Modell vergleicht echte Angebote mit den tatsächlichen Betriebskosten des Eigentums. Der Listenpreis in der Cloud ist nicht dasselbe wie reservierte oder ausgehandelte Kapazität. Der Kaufpreis der Hardware ist nicht dasselbe wie die Kosten eines betriebenen Clusters.
Auslastung ignorieren
Ein eigener Cluster mit 40 % nutzbarer Auslastung kann gegen einen Cloud-Cluster mit einem deutlich höheren Stundensatz verlieren. Messen Sie die tatsächlich geleistete Arbeit, nicht die installierten GPUs.
Netzwerktopologie als Nebensache behandeln
Die reine GPU-Anzahl definiert keinen Cluster. Training, Fine-Tuning und Inferenz mit hohem Durchsatz können sehr unterschiedliche Anforderungen an Netzwerk und Speicher haben.
Retry-Verschwendung vergessen
Wiederholungen, fehlgeschlagene Deployments, Preemptions und Ausgaben von geringer Qualität erhöhen alle die Stückkosten. Berücksichtigen Sie Retry-Verschwendung im Nenner, nicht nur im Zähler.
Personalkosten unterschätzen
Treiber, CUDA-Versionen, Container-Images, Scheduler, Monitoring, Firmware, Sicherheits-Patching und Incident Response sind Teil der GPU-Cluster-TCO. Jemand bezahlt dafür, auch wenn sie nicht im Angebot stehen.
Wann eine Model-API einen GPU-Cluster schlägt
Ein dedizierter GPU-Cluster ist nicht immer die richtige Abstraktion. Wenn Ihr Produkt nur Modellausgaben benötigt, nicht die Hardwarekontrolle, vergleichen Sie die Cluster-TCO mit einem API-Ansatz.
Model-APIs können gewinnen, wenn:
- Der Traffic unregelmäßig ist.
- Sich der Modell-Mix häufig ändert.
- Sie Zugriff auf mehrere Frontier- und Open-Modelle benötigen.
- Das Team GPUs nicht hoch auslasten kann.
- Qualitätsfilter und Wiederholungen auf der Request-Ebene leichter zu verwalten sind.
- Die Finanzabteilung Nutzungsnachweise pro Request statt eines Infrastrukturpools möchte.
Flatkey ist hier relevant, weil derselbe Käufer oft beide Wege benötigt. Flatkey Compute hilft Teams dabei, live verfügbare GPU-Stundenkapazitäten zu vergleichen, anonym GPU-Nachfrage zu posten und Lieferantenangebote zu erhalten. Die Modell- und Tool-API-Schicht von Flatkey bietet Teams eine Möglichkeit, KI-Workloads über einen Schlüssel, ein Guthaben und ein Nutzungsjournal zu routen, wenn der Besitz der GPU-Schicht unnötig ist.
Der praktische Ablauf ist:
- Den Workload auf gemieteten GPUs benchmarken.
- Die Kosten pro akzeptierter Ausgabe berechnen.
- Denselben Workload über Model-APIs vergleichen.
- Nur dann reservieren oder colokieren, wenn dedizierte Hardware unter pessimistischen Annahmen klar gewinnt.
Quellen-Checkliste für Ihr GPU-Cluster-TCO-Modell
Verwenden Sie aktuelle Quellseiten und Angebotsdokumente, anstatt veraltete Tarife aus einem anderen Artikel zu übernehmen.
| Quellentyp | Was zu prüfen ist |
|---|---|
| Seiten von Cloud-GPU-Anbietern | Instanztyp, GPU-Anzahl, Region, Speicher, Netzwerk und ob der Preis On-Demand, Reserved, Spot oder Dedicated ist. |
| System-Spezifikationen des GPU-Herstellers | Leistung, Speicher, Interconnect, Server-Formfaktor und unterstützte Topologie. |
| Colocation-Angebot | Rack/Cage, Strom, Remote Hands, Cross-Connects, Netzwerk, Installationskosten und Ausbaugrenzen. |
| Versorgungs- oder Energiedaten | Annahmen zum Strompreis und zur Preissteigerung. |
| Interne Plattformdaten | Tatsächliche Auslastung, Warteschlangenverzögerung, Fehlerrate, Retry-Rate, Volumen der akzeptierten Ausgaben und Mitarbeiterzeit. |
| Finanzannahmen | Abschreibungszeitraum, Kapitalkosten, steuerliche Behandlung, Restwert und Kosten des Vertragsausstiegs. |
Nützliche Ausgangspunkte:
- Flatkey Compute für aktuellen Markt-Kontext zu GPU-Stunden und das Veröffentlichen von Nachfrage.
- Flatkey Compute Preisindex für stündliche Markt-Referenzprüfungen.
- AWS EC2 P5 instances für Kontext zur H100-Cloud-Cluster-Infrastruktur.
- Google Cloud GPU pricing für die GPU-Preisgestaltungsmethodik nach Typ und Region.
- Lambda GPU Cloud für Kontext zur Preisgestaltung spezialisierter Cloud-GPUs.
- RunPod pricing für Markt- und Cloud-Preisprüfungen bei GPUs.
- NVIDIA DGX H100 und NVIDIA DGX B200 für System-Spezifikationen des Herstellers.
- U.S. Energy Information Administration electricity data für Annahmen zu Stromkosten.
- FinOps FOCUS, falls Ihr Finance-Team standardisierte Cloud-Kostenfelder benötigt.
Häufig gestellte Fragen
Was ist GPU-Cluster-TCO?
GPU-Cluster-TCO sind die Gesamtkosten, um aus einem Cluster nützliche KI-Rechenleistung bereitzustellen. Dazu gehören GPU-Kapazität, Speicher, Netzwerktechnik, Strom, Kühlung, Personal, Software, Support, Ausfallzeiten, Wiederholungsaufwand sowie Kapital- oder Vertragsrisiken.
Ist die Anmietung von GPUs in der Cloud immer teurer als der Kauf von GPUs?
Nein. Die Miete von GPUs in der Cloud kann günstiger sein, wenn die Auslastung ungewiss ist, der Workload nur kurz läuft, dem Team operative Kapazitäten fehlen oder sich der Modell-Stack schnell ändert. Der Kauf oder die Unterbringung von GPUs in Colocation lohnt sich nur, wenn die nutzbare Auslastung hoch genug ist, um Betrieb, Strom, Netzwerk, Finanzierung und Exit-Risiko auszugleichen.
Wann schlägt Colocation die Cloud-Miete?
Colocation kann die Cloud-Miete übertreffen, wenn die Nachfrage stabil ist, die Vertragslaufzeit lang ist, die Leistungsdichte ausreichend ist, die Hardware gut ausgelastet ist und das Team den Cluster betreiben kann. Sie ist nicht deshalb besser als die Cloud-Miete, weil der Kaufpreis der Hardware niedriger aussieht als ein Cloud-Listenpreis.
Wann sollte sich ein Team für On-Premises-GPUs entscheiden?
Entscheiden Sie sich für On-Premises-GPUs, wenn Kontrolle über die Einrichtung, Datenlokalität, Compliance oder strategischer Besitz der Infrastruktur den operativen Aufwand wert ist. Für die meisten KI-Produktteams ist On-Premises die letzte Option, die sich rechtfertigen lässt, nicht der Standard.
Wie sollten FinOps-Teams GPU-Cluster-Optionen vergleichen?
FinOps-Teams sollten Optionen nach Kosten pro nutzbarem Output vergleichen, nicht nur nach dem Stundensatz. Das Arbeitsblatt sollte Auslastung, Wiederholungsaufwand, Speicher, Datentransfer, Personalkosten, Strom, Vertragslaufzeit, Vorlaufzeit für Erweiterungen und Exit-Kosten umfassen.
Welche Rolle spielt Flatkey im GPU-Cluster-TCO?
Flatkey hilft Teams, nicht die falsche Abstraktion zu kaufen. Verwenden Sie Flatkey Compute, wenn Sie marktpreisbasierte GPU-Kapazität oder Anbieterangebote benötigen. Verwenden Sie die Modell- und Tool-API-Schicht von Flatkey, wenn Sie nur Modellausgaben, einen Schlüssel, ein Guthaben und ein nutzungsbezogenes Protokoll auf Anfrageebene benötigen.
Unterm Strich
Das beste GPU-Cluster-TCO-Modell ist nicht die längste Tabelle. Es ist dasjenige, das drei Entscheidungen klar macht:
- Ob der Workload überhaupt dedizierte GPUs benötigt.
- Ob Cloud-Miete, Colocation oder On-Premises die beste risikobereinigte Kostenoption hat.
- Ob der Vertrag auch dann noch funktioniert, wenn sich Auslastung, Modellmix, Strom und Verfügbarkeit ändern.
Beginnen Sie mit gemieteter Kapazität oder einem Live-Angebot aus dem GPU-Markt, benchmarken Sie den tatsächlichen Workload, normalisieren Sie nach akzeptiertem Output und gehen Sie erst dann in Richtung Colocation oder On-Premises, wenn die Rechnung zur nutzbaren Auslastung auch im Downside-Szenario aufgeht.
Wenn die Antwort weiterhin ungewiss ist, behalten Sie den Optionswert. GPU-Cluster-TCO belohnt Teams, die Kapazität schrittweise kaufen, statt sich vor dem Nachweis des Workloads an Hardware zu binden.


