Aktualisiert am 15. September 2026.
Imagen API-Preis- und Routing-Checks für OpenAI-kompatible Workflows beginnen jetzt mit einer Migrationsprüfung, nicht mit einer Preisabfrage. Googles aktuelle Bildgenerierungsdokumentation sagt, dass die Legacy-Imagen-Modelle veraltet sind und am 17. August 2026 abgeschaltet wurden, und Googles Deprecation-Tabelle führt imagen-4.0-generate-001, imagen-4.0-ultra-generate-001 und imagen-4.0-fast-generate-001 mit gemini-3.1-flash-image als empfohlener Ersatz auf.
Für Teams, die immer noch nach „Imagen API pricing“ suchen, lautet die praktische Frage: Welches aktuelle Bildmodell sollte diesen Pfad ersetzen, nach welcher Einheit wird es abgerechnet, und kann Ihr OpenAI-kompatibler Workflow es tatsächlich über den Endpoint aufrufen, den Sie verwenden möchten?
Flatkey hilft beim operativen Teil: ein Schlüssel, ein Guthaben, eine Rechnung und ein Modellverzeichnis für aktuelle Routen. Aber die Routing-Prüfung bleibt wichtig. Flatkeys Bildleitfaden trennt OpenAI-Images-kompatible Routen für gpt-image-2 von nativen Gemini-generateContent-Routen für Gemini-Bildmodelle und warnt, dass Gemini-Bildmodelle nicht über /v1/images/generations oder /v1/images/edits aufgerufen werden können.
Die kurze Antwort: Imagen ist jetzt ein Migrationsstichwort
Wenn Ihr Backlog „Imagen API“ sagt, behandeln Sie es als Legacy-Bezeichnung und prüfen Sie vor dem Start das aktuelle Gemini-Bildmodell. Am 15. September 2026 sind die quellengestützten Prüfungen:
| Prüfung | Was zu verifizieren ist | Warum das wichtig ist |
|---|---|---|
| Modelllebenszyklus | Die Modell-IDs von Imagen 4 sind abgeschaltet; gemini-2.5-flash-image ist veraltet und wird am 2. Oktober 2026 abgeschaltet. | Eine veraltete Modell-ID kann Code-Review bestehen und zur Laufzeit fehlschlagen. |
| Aktueller Ersatz | Google verweist Imagen-4-Nutzer auf gemini-3.1-flash-image; Google listet außerdem gemini-3.1-flash-lite-image und gemini-3-pro-image für unterschiedliche Kosten- und Qualitätsanforderungen. | Die Wahl des Ersatzes verändert sowohl Kosten- als auch Qualitätserwartungen. |
| Preiseinheit | Gemini-Bildausgabe wird nach Image-Output-Tokens bepreist, mit Beispielen pro Bild nach Auflösung. | Eine Planungszahl pro Bild kann die Kosten für Prompt, Bearbeitung, abgelehnte Ausgaben und Wiederholungen verschleiern. |
| Endpoint-Familie | Flatkeys OpenAI-Images-kompatible Endpunkte sind für gpt-image-2; Gemini-Bildmodelle verwenden natives Gemini generateContent. | „OpenAI-kompatibel“ bedeutet nicht, dass jedes Bildmodell auf /v1/images/generations gehört. |
| Routenstatus | Bestätigen Sie vor dem Release die aktuelle Flatkey-Modellzeile, die Endpoint-Typen, die Preisformel und die öffentliche Statusseite. | Modellkataloge und Upstream-Verfügbarkeit ändern sich schneller als Produkt-Roadmaps. |
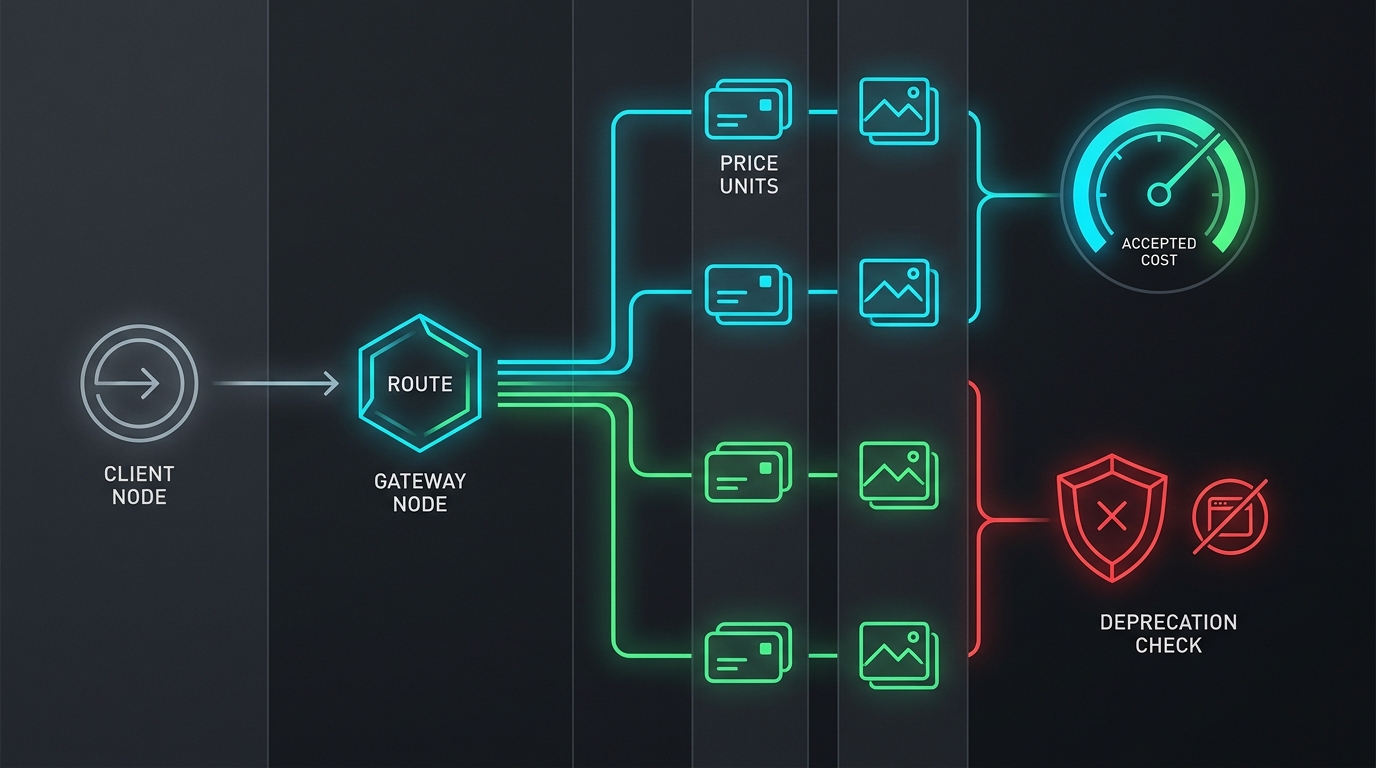
Das ist der Kern von Imagen API-Preis- und Routing-Checks für OpenAI-kompatible Workflows: normalisieren Sie die Preiseinheit, wählen Sie das aktuelle Modell aus und testen Sie dann exakt die Route, die Ihr Code verwenden wird.
Aktuelle Google-Bildmodellpreise, die zu normalisieren sind
Verwenden Sie die Anbieterpreise als Quelle der Wahrheit für die Planung und vergleichen Sie sie dann mit Ihrem Flatkey-Dashboard und dem Nutzungsprotokoll, bevor Sie ein Budget fest zusagen. Auf Googles Preisseite sind diese aktuellen Bildzeilen aufgeführt:
| Aktuelles Modell | Google-Bezeichnung | Bezahlter Eingabepreis | Bezahlter Bildausgabepreis | Google-Beispiele pro Bild |
|---|---|---|---|---|
gemini-3.1-flash-image | Nano Banana 2 | $0.50 pro 1 Mio. Text-/Bild-Tokens | $60.00 pro 1 Mio. Bildausgabe-Tokens | $0.045 bei 0.5K, $0.067 bei 1K, $0.101 bei 2K, $0.151 bei 4K |
gemini-3.1-flash-lite-image | Nano Banana 2 Lite | $0.25 pro 1 Mio. Text-/Bild-/Video-Tokens | $30.00 pro 1 Mio. Bildausgabe-Tokens | $0.0336 pro 1K Bild; Batch-Ausgabe $0.0168 pro 1K Bild |
gemini-3-pro-image | Nano Banana Pro | $2.00 pro 1 Mio. Text-/Bild-Tokens; Bild-Eingabeäquivalent $0.0011 pro Bild | $120.00 pro 1 Mio. Bildausgabe-Tokens | $0.134 pro 1K/2K Bild; $0.24 pro 4K Bild |
gemini-2.5-flash-image | Legacy Nano Banana | Veraltet | Vor der Verwendung prüfen | Google warnt, dass es am 2. Oktober 2026 abgeschaltet wird |
Die Entscheidung ist nicht „welche Zeile am günstigsten ist“. Medien-Teams sollten jedes Modell einer Auftragsklasse zuordnen:
- Verwenden Sie
gemini-3.1-flash-lite-imagefür die Erstellung von Entwürfen mit hohem Volumen, bei denen Latenz und Kosten die harten Einschränkungen sind. - Verwenden Sie
gemini-3.1-flash-imageals allgemeinen Ersatzpfad, wenn Sie stärkere Textdarstellung, Konsistenz und Ausgabeoptionen bis 4K benötigen. - Verwenden Sie
gemini-3-pro-imagefür komplexe Produktions-Assets, bei denen Lokalisierung, Grounding, Markenkonsistenz und kreative Kontrolle so wichtig sind, dass der höhere Preis pro Ausgabe-Token gerechtfertigt ist.
Führen Sie dann denselben Prompt-Satz über jeden Kandidaten aus und vergleichen Sie die Kosten pro akzeptiertem Bild, nicht nur den angegebenen Ausgabepreis.
Warum der angegebene Token-Preis nicht den Kosten pro akzeptiertem Bild entspricht
Bild-Workflows haben mehr versteckte Kosten als Text-Workflows. Ein Prompt kann ein nutzbares Bild, fünf abgelehnte Bilder oder gar kein lieferbares Ergebnis erzeugen, weil ein Safety-Block, ein Routing-Mismatch, ein Timeout oder ein Fehler in der Art Direction aufgetreten ist. Bearbeitungs-Workflows verursachen außerdem Bild-Eingabekosten und zusätzliche Wiederholungen.
Verwenden Sie für jede Kandidaten-Route diese Formel:
accepted_image_cost =
  (successful_request_cost + failed_request_cost + retry_cost + edit_input_cost)
  / accepted_assets
Verfolgen Sie die Eingaben getrennt:
| Metrik | Definition | Wo prüfen |
|---|---|---|
| Erfolgreiche Anforderungskosten | Kosten von Anfragen, die mindestens einen Bildkandidaten zurückgegeben haben. | Anbieterrechnung und Flatkey-Nutzungsprotokoll. |
| Kosten fehlgeschlagener Anfragen | Kosten von Routing-Fehlern, Safety-Blocks, leeren Bildteilen und Client-Timeouts, die trotzdem Nutzung verursacht haben. | Fehlerprotokolle, Statusseite und Nutzungsprotokoll. |
| Wiederholungs-Kosten | Kosten für die erneute Generierung nach Fehlern bei Prompt, Seed, Größe, Safety oder Markenprüfung. | Creative-QA-Queue und Laufprotokolle. |
| Kosten für Eingabebilder bei Bearbeitung | Kosten für Referenzbilder, Masken und frühere Ausgaben, die bei Bearbeitungen verwendet werden. | Anforderungs-Payload-Protokolle und Modellnutzung. |
| Akzeptierte Assets | Bilder, die menschliche oder automatisierte Creative-QA bestanden haben und in die Kampagne, die Produktoberfläche oder die Asset-Bibliothek übernommen wurden. | DAM, CMS, Kampagnen-Tracker oder Review-Board. |
Für die Produktionsplanung sollten Sie im Launch-Dokument zwei Zahlen festhalten: die angegebene Anbieter-Kosten pro geplantem Output und die gemessenen Kosten pro akzeptiertem Bild aus Ihrem eigenen Prompt-Set.
Routing-Checks für OpenAI-kompatible Workflows
OpenAI-kompatibles Text-Routing ist oft nur eine base_url-Änderung in einer Zeile. Image-Routing benötigt ein zusätzliches Gate, weil Image-APIs nicht austauschbar sind.
Die OpenAI-Images-kompatible API-Referenz von Flatkey dokumentiert:
POST https://router.flatkey.ai/v1/images/generations
POST https://router.flatkey.ai/v1/images/edits
Diese Routen akzeptieren Request-Strukturen im OpenAI-Images-Stil für Modelle, die über diesen Kanal bereitgestellt werden, wie etwa gpt-image-2. In Flatkeys Gemini-Leitfaden wird die Gemini-Bildgenerierung über Folgendes dokumentiert:
POST https://router.flatkey.ai/v1beta/models/{model}:generateContentDie Anfrage muss die Bildausgabe in der Antwortkonfiguration einschließen, und generierte Bilder werden in Gemini-Antwortteilen als Inline-Bilddaten zurückgegeben. Wenn Sie ein Gemini-Bildmodell an den OpenAI-Images-Endpunkt senden, warnen Flatkeys Dokumente, dass die Anfrage get_channel_failed zurückgeben kann.
Vor dem Launch sollten Sie die Endpunktfamilie in Ihrem Integrationsvertrag festhalten:
| Workload | Modellfamilie | Flatkey-Routenfamilie | Hauptprüfung |
|---|---|---|---|
| OpenAI-Images-Stil-Generierung | gpt-image-2 | /v1/images/generations | Bestätigen Sie, dass das Bild in data[0].b64_json zurückgegeben wird. |
| OpenAI-Images-Stil-Bearbeitungen | gpt-image-2 | /v1/images/edits | Bestätigen Sie den multipart-Bild-Upload, optional eine Maske und die Verarbeitung des base64-Ergebnisses. |
| Gemini-Bildgenerierung oder -Bearbeitungen | gemini-3.1-flash-image, gemini-3.1-flash-lite-image, gemini-3-pro-image | /v1beta/models/{model}:generateContent | Bestätigen Sie die Bildmodalität in der Anfrage und Inline-Bilddaten in der Antwort. |
| Legacy-Imagen-Backlog-Item | Alte imagen-*-IDs | Gehen Sie nicht von einer Verfügbarkeit der Route aus | Ersetzen Sie dies durch eine aktuelle Gemini/Nano-Banana-Zeile und testen Sie die exakte Modell-ID per Smoke-Test. |
Diese Routing-Tabelle sollte neben Ihrer Preistabelle stehen. Eine Kostenschätzung ist erst dann launchbereit, wenn die Routenfamilie verifiziert ist.
Flatkey-Checks, bevor Sie ausliefern
Verwenden Sie Flatkey als Kontrollpunkt-Check, nicht als Ersatz für die Verifizierung an der Quelle. Eine praktische Release-Prüfung sollte Folgendes umfassen:
- Öffnen Sie das Flatkey-Modellverzeichnis und suchen Sie nach der exakten Modell-ID.
- Bestätigen Sie den Anbieter, den Routenstatus, die unterstützten Endpunkttypen und die Preisanzeige.
- Vergleichen Sie die aktuelle Modellzeile in Flatkey mit der Preisseite von Google.
- Prüfen Sie die Flatkey-Statusseite auf aktive Störungen oder beeinträchtigtes Routing.
- Führen Sie eine Smoke-Anfrage aus derselben Umgebung aus, die auch die Produktion verwenden wird.
- Bestätigen Sie das von Ihrer Anwendung erwartete Ergebnisformat:
b64_jsonfür OpenAI-Images-Stil-Ausgabe oder Inline-Bilddaten für Gemini-Ausgabe. - Dokumentieren Sie Request-ID, Modell-ID, Endpunkt, Latenz, Ausgabegröße und Kosten im Release-Ticket.
- Fügen Sie vor dem Start des kreativen Batch-Jobs eine Allowlist oder Budget-Leitplanke hinzu.
Das Ziel ist nicht, Ihr Team an einen einzigen Anbieter zu binden. Das Ziel ist, den Modellwechsel langweilig zu machen: aktuelle Modellzeilen, explizite Endpunktfamilien, ein Nutzungs-Ledger und klare Fallback-Kriterien.
Eine Launch-Checkliste für Imagen-Migrationsarbeiten
Verwenden Sie diese Checkliste, wenn Sie alte Imagen-Aufrufe ersetzen oder einer OpenAI-kompatiblen App eine neue Gemini-Bildroute hinzufügen.
| Schritt | Bestandene Bedingung |
|---|---|
| Lifecycle-Check | Kein aktiver Codepfad verweist auf imagen-4.0-generate-001, imagen-4.0-ultra-generate-001 oder imagen-4.0-fast-generate-001. |
| Ersetzungs-Check | Das Release-Ticket nennt ein aktuelles Modell wie gemini-3.1-flash-image, gemini-3.1-flash-lite-image oder gemini-3-pro-image. |
| Endpunkt-Check | Der Code verwendet Flatkey /v1beta/models/{model}:generateContent für Gemini-Bildmodelle, nicht /v1/images/generations. |
| Preis-Check | Das Budgetblatt enthält den Preis für Ausgabe-Token des Anbieters, die erwartete Auflösung, das Retry-Verhältnis und die Kosten für akzeptierte Bilder. |
| Rate-Limit-Check | Der Batch-Plan berücksichtigt RPM-, TPM-, RPD- und IPM-Limits; Preview- oder Experimental-Limits werden als strenger behandelt. |
| Response-Check | Der Parser verarbeitet Textteile, Bildteile, leere Bildergebnisse und Safety-Blocks. |
| Watermark-Check | Die Stakeholder wissen, dass Google angibt, dass von Gemini erzeugte Bilder ein SynthID-Watermarking enthalten. |
| Fallback-Check | Die Fallback-Route wird mit demselben Prompt-Vertrag und denselben Prüfkriterien getestet. |
| Ledger-Check | Die Flatkey-Nutzungsprotokolle werden nach dem Smoke-Test und nach dem ersten Produktionsbatch geprüft. |
Wenn eine Zeile fehlschlägt, behandeln Sie das nicht als kreatives Problem. Behandeln Sie es als Problem der Produktionsreife.
So führen Sie Imagen API-Preis- und Routing-Checks für OpenAI-kompatible Workflows aus
Führen Sie die Checks in dieser Reihenfolge aus:
- Beginnen Sie mit Googles Seiten zu Gemini-API-Preisgestaltung, Gemini-Abkündigungen, Nano Banana-Bildgenerierung und Ratenlimits.
- Vergleichen Sie diese Anbieter-Fakten mit der aktuellen Flatkey-Modellzeile für
gemini-3.1-flash-image. - Bestätigen Sie das Routing-Verhalten in Flatkeys Leitfaden zur Bildgenerierung und der OpenAI-Images-kompatiblen API-Referenz.
- Führen Sie den Smoke-Test aus und vergleichen Sie dann die Kosten in Ihrem Flatkey-Nutzungs-Ledger mit Ihrer Anzahl akzeptierter Bilder.
Diese Reihenfolge hält Imagen API-Preis- und Routing-Checks für OpenAI-kompatible Workflows auf offizielle Preise, den aktuellen Modell-Lifecycle und die tatsächliche Route gestützt, die Ihre Anwendung aufrufen wird.
Interne Links für tiefere Prüfungen
Wenn Sie weiterhin Modellfamilien vergleichen, beginnen Sie mit GPT Image vs Imagen API und GPT Image vs Gemini Image API. Wenn Sie das breitere Betriebsmodell benötigen, nutzen Sie den praktischen Leitfaden zur Image-Generation-API und den Leitfaden zu Metriken der Image-Generation-API.
Für Teams, die agentische Medien-Pipelines aufbauen, kombinieren Sie diese Checkliste mit dem Playbook für multimodales Agent-Routing und dem Leitfaden zum KI-Modellkatalog. Prüfen Sie dann vor dem Rollout das aktuelle Flatkey-Modellverzeichnis, die Preisseite, die Statusseite und die Flatkey-Dokumentation zur Bildgenerierung.
Häufig gestellte Fragen
Ist die Imagen API noch der richtige Weg für neue Vorhaben?
Meistens nein. In den aktuellen Google-Dokumenten sind Imagen-Modelle als veraltet markiert, und es wird angegeben, dass sie am 17. August 2026 abgeschaltet werden. Für neue Vorhaben sollten Sie mit den aktuellen Gemini-/Nano-Banana-Bildmodellen beginnen und vor der Implementierung die genaue Modell-ID prüfen.
Kann ich Gemini-Bildmodelle über einen mit OpenAI Images kompatiblen Endpoint aufrufen?
Nicht über die Routen /v1/images/generations oder /v1/images/edits von Flatkey. In der Flatkey-Dokumentation heißt es, dass Gemini-Bildmodelle das native Gemini-generateContent verwenden; die mit OpenAI Images kompatiblen Routen sind für Bildmodelle gedacht, die über diese Endpoint-Familie bereitgestellt werden, wie etwa gpt-image-2.
Welches aktuelle Modell sollte Imagen 4 ersetzen?
In Googles Abschreibungstabelle ist gemini-3.1-flash-image als Ersatz für die Modell-IDs von Imagen 4 aufgeführt. In der Praxis sollten Teams gemini-3.1-flash-image, gemini-3.1-flash-lite-image und gemini-3-pro-image mit ihrem eigenen Prompt-Set testen, da Kosten, Latenz und die Akzeptanzrate kreativer Ergebnisse je nach Workload variieren.
Was sollte die Finanzabteilung vor der Freigabe eines Batches prüfen?
Bitten Sie um den Preis pro Output-Token des Anbieters, die erwartete Auflösung, die Bildanzahl, die Retry-Quote, die Quote abgelehnter Ausgaben, die Nutzung von Bearbeitung/Referenzbildern und die gemessenen Kosten pro akzeptiertem Bild. Eine einzelne Preisangabe pro Bild reicht für eine Produktionskampagne nicht aus.
Fazit
Die Preis- und Routing-Checks der Imagen API für OpenAI-kompatible Workflows sollten mit einem Routentest enden, nicht mit einer Tabellenkalkulation. Imagen 4 liegt hinter seinem Abschaltdatum, gemini-2.5-flash-image befindet sich auf einem veralteten Abschreibungspfad, und aktuelle Gemini-Bildmodelle verwenden eine andere Routenfamilie als die mit OpenAI Images kompatiblen Endpoints von Flatkey.
Nutzen Sie Flatkey, um Modellzugriff, Abrechnung und Nutzungsprüfungen an einem Ort zu bündeln. Stellen Sie dann vor dem Start sicher, dass jeder Bild-Workflow vier Dinge nachweist: aktuelle Modell-ID, aktuelle Preiseinheit, richtige Endpoint-Familie und gemessene Kosten pro akzeptiertem Bild.