Actualizado el 15 de septiembre de 2026.
Las comprobaciones de precios y enrutamiento de Imagen API para flujos de trabajo compatibles con OpenAI ahora comienzan con una verificación de migración, no con una consulta de precios. La documentación actual de generación de imágenes de Google indica que los modelos heredados de Imagen están obsoletos y se cerraron el 17 de agosto de 2026, y la tabla de obsolescencia de Google enumera imagen-4.0-generate-001, imagen-4.0-ultra-generate-001 y imagen-4.0-fast-generate-001 con gemini-3.1-flash-image como reemplazo recomendado.
Para los equipos que siguen buscando "precios de Imagen API", la pregunta práctica es: ¿qué modelo de imagen actual debe reemplazar esa ruta, sobre qué unidad se factura y su flujo de trabajo compatible con OpenAI realmente puede llamarlo a través del endpoint que planea usar?
Flatkey ayuda con la parte operativa: mantener una sola clave, un solo saldo, una sola factura y un solo directorio de modelos para las rutas actuales. Pero la verificación de enrutamiento sigue siendo importante. La guía de imágenes de Flatkey separa las rutas compatibles con OpenAI Images para gpt-image-2 de las rutas nativas de Gemini generateContent para los modelos de imágenes de Gemini, y advierte que los modelos de imágenes de Gemini no pueden llamarse a través de /v1/images/generations ni de /v1/images/edits.
La respuesta rápida: Imagen ahora es una palabra clave de migración
Si su backlog dice "Imagen API", considérelo una etiqueta heredada y verifique el modelo de imagen de Gemini actual antes del lanzamiento. El 15 de septiembre de 2026, las comprobaciones respaldadas por la fuente son:
| Comprobación | Qué verificar | Por qué importa |
|---|---|---|
| Ciclo de vida del modelo | Los IDs de modelo de Imagen 4 están cerrados; gemini-2.5-flash-image está obsoleto y se cerrará el 2 de octubre de 2026. | Un ID de modelo desactualizado puede pasar la revisión de código y fallar en tiempo de ejecución. |
| Reemplazo actual | Google dirige a los usuarios de Imagen 4 a gemini-3.1-flash-image; Google también enumera gemini-3.1-flash-lite-image y gemini-3-pro-image para diferentes necesidades de coste y fidelidad. | La elección del reemplazo cambia tanto el coste como las expectativas de calidad. |
| Unidad de precio | La salida de imagen de Gemini se factura por tokens de salida de imagen, con ejemplos por imagen según la resolución. | Una cifra de planificación por imagen puede ocultar el coste del prompt, la edición, las salidas rechazadas y los reintentos. |
| Familia de endpoint | Los endpoints compatibles con OpenAI Images de Flatkey son para gpt-image-2; los modelos de imágenes de Gemini usan el Gemini nativo generateContent. | "Compatible con OpenAI" no significa que todos los modelos de imagen pertenezcan a /v1/images/generations. |
| Estado de la ruta | Confirme la fila actual del modelo de Flatkey, los tipos de endpoint, la expresión de precios y la página pública de estado antes del lanzamiento. | Los catálogos de modelos y la disponibilidad del proveedor cambian más rápido que las hojas de ruta del producto. |
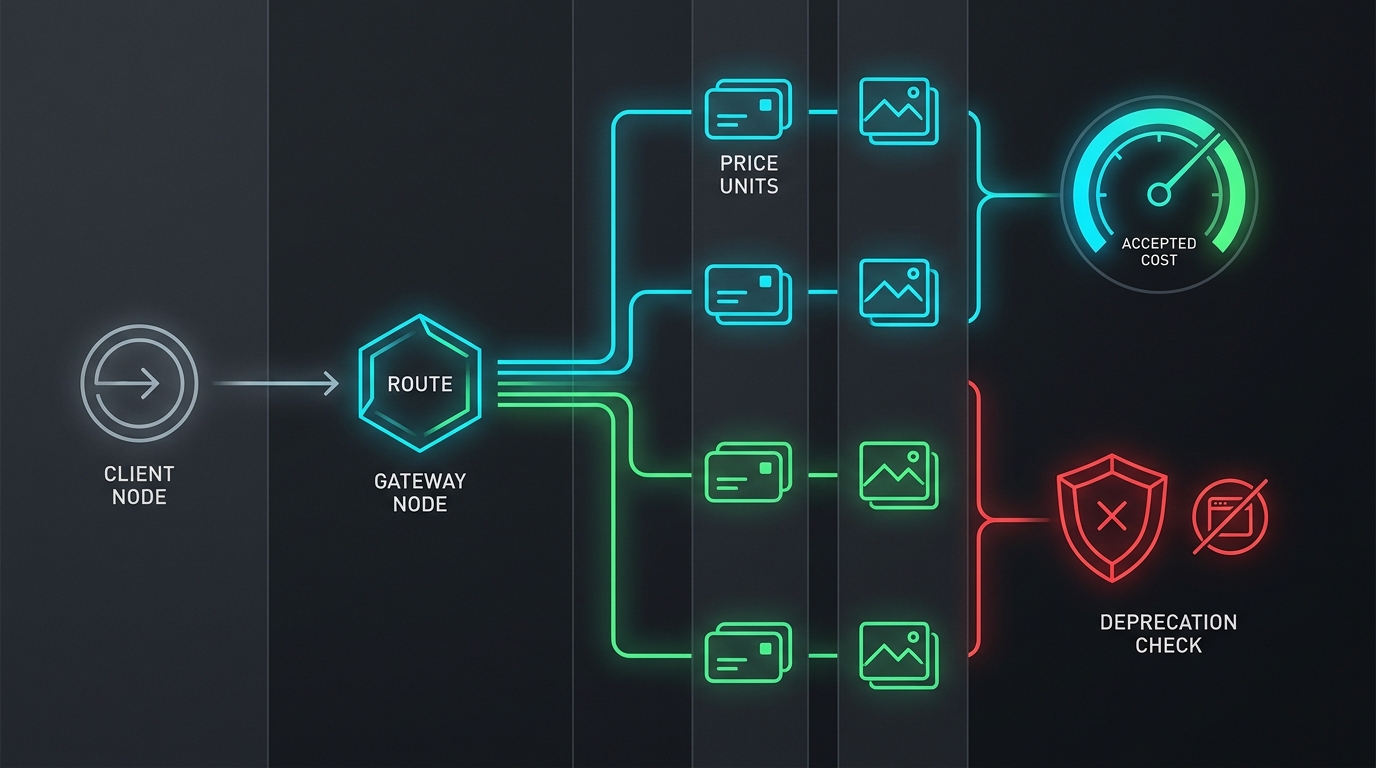
Este es el núcleo de las comprobaciones de precios y enrutamiento de Imagen API para flujos de trabajo compatibles con OpenAI: normalizar la unidad de precio, elegir el modelo actual y luego probar la ruta exacta que usará su código.
Precios actuales de los modelos de imagen de Google que hay que normalizar
Use los precios del proveedor como fuente de verdad para la planificación y luego compárelos con su panel de Flatkey y su libro mayor de uso antes de comprometer el presupuesto. La página de precios de Google enumera estas filas de imagen actuales:
| Modelo actual | Nomenclatura de Google | Precio de entrada de pago | Precio de salida de imagen de pago | Ejemplos por imagen de Google |
|---|---|---|---|---|
gemini-3.1-flash-image | Nano Banana 2 | $0.50 por 1M de tokens de texto/imagen | $60.00 por 1M de tokens de salida de imagen | $0.045 a 0.5K, $0.067 a 1K, $0.101 a 2K, $0.151 a 4K |
gemini-3.1-flash-lite-image | Nano Banana 2 Lite | $0.25 por 1M de tokens de texto/imagen/video | $30.00 por 1M de tokens de salida de imagen | $0.0336 por 1K imagen; salida por lotes $0.0168 por 1K imagen |
gemini-3-pro-image | Nano Banana Pro | $2.00 por 1M de tokens de texto/imagen; equivalente de entrada de imagen $0.0011 por imagen | $120.00 por 1M de tokens de salida de imagen | $0.134 por imagen de 1K/2K; $0.24 por imagen de 4K |
gemini-2.5-flash-image | Nano Banana legacy | Obsoleto | Verificar antes de usar | Google advierte que se cerrará el 2 de octubre de 2026 |
La decisión no es "qué fila es la más barata". Los equipos de medios deben asignar cada modelo a una clase de trabajo:
- Use
gemini-3.1-flash-lite-imagepara generación de borradores de alto volumen, donde la latencia y el coste son las restricciones principales. - Use
gemini-3.1-flash-imagecomo la ruta de reemplazo generalista cuando necesite una renderización de texto más sólida, coherencia y opciones de salida de hasta 4K. - Use
gemini-3-pro-imagepara activos de producción complejos donde la localización, la grounding, la coherencia de marca y el control creativo sean lo suficientemente importantes como para justificar la tarifa más alta de tokens de salida.
Después, ejecute el mismo conjunto de prompts a través de cada candidato y compare el coste por imagen aceptada, no solo el precio de salida indicado.
Por qué el precio de token indicado no es el coste por imagen aceptada
Los flujos de trabajo de imágenes tienen más coste oculto que los flujos de trabajo de texto. Un prompt puede generar una imagen utilizable, cinco imágenes rechazadas o ningún entregable debido a un bloqueo de seguridad, un desajuste de ruta, un tiempo de espera o un fallo de dirección artística. Los flujos de trabajo de edición también añaden coste de imagen de entrada y reintentos adicionales.
Use esta fórmula para cada ruta candidata:
accepted_image_cost =
  (successful_request_cost + failed_request_cost + retry_cost + edit_input_cost)
  / accepted_assets
Realice un seguimiento de las entradas por separado:
| Métrica | Definición | Dónde verificar |
|---|---|---|
| Successful request cost | Coste de las solicitudes que devolvieron al menos un candidato de imagen. | Factura del proveedor y libro mayor de uso de Flatkey. |
| Failed request cost | Coste de errores de ruta, bloqueos de seguridad, partes de imagen vacías y tiempos de espera del cliente que aun así consumieron uso. | Registros de errores, página de estado y libro mayor de uso. |
| Retry cost | Coste de regeneración tras fallo de prompt, seed, tamaño, seguridad o revisión de marca. | Cola de QA creativo y registros de ejecución. |
| Edit input cost | Coste de imágenes de referencia, máscaras y resultados anteriores usados en ediciones. | Registros de carga útil de solicitudes y uso del modelo. |
| Accepted assets | Imágenes que pasaron el QA creativo humano o automatizado y se publicaron en la campaña, la superficie del producto o la biblioteca de activos. | DAM, CMS, rastreador de campañas o comité de revisión. |
Para la planificación de producción, mantén dos cifras en el documento de lanzamiento: el coste del proveedor indicado por salida planificada y el coste medido de imagen aceptada a partir de tu propio conjunto de prompts.
Comprobaciones de enrutamiento para flujos de trabajo compatibles con OpenAI
El enrutamiento de texto compatible con OpenAI suele ser un cambio de base_url de una sola línea. El enrutamiento de imágenes necesita una puerta adicional porque las API de imágenes no son intercambiables.
La referencia de la API compatible con OpenAI Images de Flatkey documenta:
POST https://router.flatkey.ai/v1/images/generations
POST https://router.flatkey.ai/v1/images/edits
Esas rutas aceptan formatos de solicitud al estilo OpenAI Images para los modelos expuestos en ese canal, como gpt-image-2. La guía de Gemini de Flatkey documenta la generación de imágenes de Gemini a través de:
POST https://router.flatkey.ai/v1beta/models/{model}:generateContentLa solicitud debe incluir la salida de imagen en la configuración de la respuesta, y las imágenes generadas se devuelven como datos de imagen inline en las partes de la respuesta de Gemini. Si envías un modelo de imagen de Gemini al endpoint de OpenAI Images, la documentación de Flatkey advierte que la solicitud puede devolver get_channel_failed.
Antes del lanzamiento, escribe la familia de endpoint en tu contrato de integración:
| Carga de trabajo | Familia de modelos | Familia de rutas de Flatkey | Verificación principal |
|---|---|---|---|
| Generación al estilo OpenAI Images | gpt-image-2 | /v1/images/generations | Confirma que la imagen se devuelve en data[0].b64_json. |
| Ediciones al estilo OpenAI Images | gpt-image-2 | /v1/images/edits | Confirma la subida multipart de la imagen, la máscara opcional y el manejo del resultado en base64. |
| Generación o ediciones de imágenes de Gemini | gemini-3.1-flash-image, gemini-3.1-flash-lite-image, gemini-3-pro-image | /v1beta/models/{model}:generateContent | Confirma la modalidad de imagen en la solicitud y los datos de imagen inline en la respuesta. |
| Elemento pendiente del backlog de Imagen heredado | IDs antiguos imagen-* | No asumas la disponibilidad de la ruta | Reemplázalo por una fila actual de Gemini/Nano Banana y haz una prueba rápida con el ID exacto del modelo. |
Esta tabla de enrutamiento debe estar junto a tu tabla de precios. Una estimación de coste no está lista para lanzamiento hasta que se haya comprobado la familia de rutas.
Comprobaciones de Flatkey antes de que lo envíes
Usa Flatkey como comprobación del plano de control, no como sustituto de la verificación de origen. Una revisión práctica del lanzamiento debería incluir:
- Abre el directorio de modelos de Flatkey y busca el ID exacto del modelo.
- Confirma el proveedor, el estado de la ruta, los tipos de endpoint compatibles y la visualización de precios.
- Compara la fila actual del modelo en Flatkey con la página de precios de Google.
- Revisa la página de estado de Flatkey en busca de incidencias activas o enrutamiento degradado.
- Ejecuta una solicitud de prueba rápida desde el mismo entorno que usará producción.
- Confirma el formato de resultado que espera tu aplicación:
b64_jsonpara la salida al estilo OpenAI Images o datos de imagen inline para la salida de Gemini. - Registra el ID de la solicitud, el ID del modelo, el endpoint, la latencia, el tamaño de salida y el coste en el ticket de lanzamiento.
- Añade una lista de permitidos o una barrera de presupuesto antes de que se ejecute el trabajo por lotes creativo.
El objetivo no es encerrar a tu equipo en un único proveedor. El objetivo es hacer que cambiar de modelo sea algo aburrido: filas de modelos actuales, familias de endpoints explícitas, un libro mayor de uso y criterios claros de fallback.
Lista de verificación de lanzamiento para el trabajo de migración de Imagen
Usa esta lista de verificación cuando sustituyas llamadas heredadas de Imagen o añadas una nueva ruta de imágenes de Gemini a una app compatible con OpenAI.
| Paso | Condición de aprobación |
|---|---|
| Comprobación del ciclo de vida | Ninguna ruta de código activa hace referencia a imagen-4.0-generate-001, imagen-4.0-ultra-generate-001 o imagen-4.0-fast-generate-001. |
| Comprobación de sustitución | La incidencia de lanzamiento nombra un modelo actual como gemini-3.1-flash-image, gemini-3.1-flash-lite-image o gemini-3-pro-image. |
| Comprobación del endpoint | El código usa Flatkey /v1beta/models/{model}:generateContent para los modelos de imagen de Gemini, no /v1/images/generations. |
| Comprobación de precios | La hoja de presupuesto incluye el precio por token de salida del proveedor, la resolución esperada, la ratio de reintentos y el coste por imagen aceptada. |
| Comprobación de límite de tasa | El plan por lotes tiene en cuenta los límites de RPM, TPM, RPD e IPM; los límites de vista previa o experimentales se tratan como más estrictos. |
| Comprobación de respuesta | El analizador gestiona partes de texto, partes de imagen, resultados de imagen vacíos y bloqueos de seguridad. |
| Comprobación de marca de agua | Las partes interesadas saben que Google indica que las imágenes generadas por Gemini incluyen marcado de agua SynthID. |
| Comprobación de fallback | La ruta de fallback se prueba con el mismo contrato de prompt y los mismos criterios de revisión. |
| Comprobación del libro mayor | Los registros de uso de Flatkey se revisan después de la prueba de humo y después del primer lote de producción. |
Si alguna fila falla, no lo trates como un problema creativo. Trátalo como un problema de preparación para producción.
Cómo ejecutar las comprobaciones de precios y enrutamiento de Imagen API para flujos de trabajo compatibles con OpenAI
Ejecuta las comprobaciones en este orden:
- Empieza por las páginas de precios de la API de Gemini, obsolescencias de Gemini, generación de imágenes Nano Banana y límites de tasa de Google.
- Compara esos datos del proveedor con la fila del modelo de Flatkey para
gemini-3.1-flash-imageactual. - Confirma el comportamiento de la ruta en la guía de generación de imágenes de Flatkey y en la referencia de API compatible con OpenAI Images.
- Ejecuta la prueba de humo y luego compara el coste en tu libro mayor de uso de Flatkey con tu recuento de imágenes aceptadas.
Esa secuencia mantiene las comprobaciones de precios y enrutamiento de Imagen API para flujos de trabajo compatibles con OpenAI basadas en precios oficiales, el ciclo de vida actual del modelo y la ruta real que llamará tu aplicación.
Enlaces internos para comprobaciones más profundas
Si todavía estás comparando familias de modelos, empieza con GPT Image vs Imagen API y GPT Image vs Gemini Image API. Si necesitas el modelo operativo más amplio, usa la guía práctica de Image Generation API y la guía de métricas de la API de generación de imágenes.
Para los equipos que crean canalizaciones de medios agentivos, combina esta lista de verificación con el manual de enrutamiento de agentes multimodales y la guía del catálogo de modelos de IA. Después, verifica el directorio de modelos de Flatkey en vivo, la página de precios, la página de estado y la documentación de generación de imágenes de Flatkey antes del despliegue.
Preguntas frecuentes
¿Sigue siendo la API de Imagen la ruta adecuada para el trabajo nuevo?
Por lo general, no. La documentación actual de Google marca los modelos Imagen como obsoletos y dice que se cerrarán el 17 de agosto de 2026. Para trabajo nuevo, empieza con los modelos de imagen actuales de Gemini/Nano Banana y verifica el ID exacto del modelo antes de la implementación.
¿Puedo llamar a los modelos de imagen de Gemini a través de un endpoint compatible con OpenAI Images?
No a través de las rutas /v1/images/generations o /v1/images/edits de Flatkey. La documentación de Flatkey indica que los modelos de imagen de Gemini usan el generateContent nativo de Gemini; las rutas compatibles con OpenAI Images son para los modelos de imagen expuestos en esa familia de endpoints, como gpt-image-2.
¿Qué modelo actual debería sustituir a Imagen 4?
La tabla de depreciación de Google enumera gemini-3.1-flash-image como sustituto para los IDs de modelo de Imagen 4. En la práctica, los equipos deberían probar gemini-3.1-flash-image, gemini-3.1-flash-lite-image y gemini-3-pro-image con su propio conjunto de prompts, porque el coste, la latencia y la tasa de aceptación creativa varían según la carga de trabajo.
¿Qué debería revisar finanzas antes de aprobar un lote?
Pide el precio por token de salida del proveedor, la resolución esperada, el número de imágenes, la ratio de reintentos, la ratio de salidas rechazadas, el uso de edición/imagen de referencia y el coste medido por imagen aceptada. Un único número por imagen no es suficiente para una campaña de producción.
Conclusión
Las comprobaciones de precios y enrutamiento de Imagen API para flujos de trabajo compatibles con OpenAI deben terminar con una prueba de ruta, no con una hoja de cálculo. Imagen 4 ya pasó su fecha de cierre, gemini-2.5-flash-image está en una ruta de depreciación fechada y los modelos de imagen actuales de Gemini usan una familia de rutas distinta de los endpoints compatibles con OpenAI Images de Flatkey.
Usa Flatkey para mantener en un solo lugar el acceso a modelos, la facturación y las comprobaciones de uso. Luego haz que cada flujo de trabajo de imágenes demuestre cuatro cosas antes del lanzamiento: ID del modelo actual, unidad de precio actual, familia de endpoint correcta y coste medido por imagen aceptada.