Atualizado em 15 de setembro de 2026.
As Verificações de Preços e Roteamento da API Imagen para Workflows Compatíveis com OpenAI agora começam com uma verificação de migração, não com uma consulta de preço. A documentação atual do Google para geração de imagens diz que os modelos legados do Imagen estão descontinuados e foram encerrados em 17 de agosto de 2026, e a tabela de descontinuação do Google lista imagen-4.0-generate-001, imagen-4.0-ultra-generate-001 e imagen-4.0-fast-generate-001 com gemini-3.1-flash-image como substituto recomendado.
Para equipes que ainda pesquisam por "preços da API Imagen", a questão prática é: qual modelo de imagem atual deve substituir essa rota, em que unidade ele é cobrado e seu workflow compatível com OpenAI realmente consegue chamá-lo pelo endpoint que você planeja usar?
A Flatkey ajuda na parte operacional: mantenha uma chave, um saldo, uma fatura e um diretório de modelos para as rotas atuais. Mas a verificação de roteamento ainda importa. O guia de imagens da Flatkey separa as rotas compatíveis com OpenAI Images para gpt-image-2 das rotas nativas do Gemini generateContent para modelos de imagem Gemini, e alerta que os modelos de imagem Gemini não podem ser chamados por meio de /v1/images/generations ou /v1/images/edits.
A resposta rápida: Imagen agora é uma palavra-chave de migração
Se seu backlog diz "API Imagen", trate isso como um rótulo legado e verifique o modelo de imagem atual do Gemini antes do lançamento. Em 15 de setembro de 2026, as verificações com base na fonte são:
| Verificação | O que verificar | Por que isso importa |
|---|---|---|
| Ciclo de vida do modelo | Os IDs dos modelos Imagen 4 foram encerrados; gemini-2.5-flash-image está descontinuado, com encerramento em 2 de outubro de 2026. | Um ID de modelo desatualizado pode passar na revisão de código e falhar em tempo de execução. |
| Substituto atual | O Google aponta os usuários do Imagen 4 para gemini-3.1-flash-image; o Google também lista gemini-3.1-flash-lite-image e gemini-3-pro-image para diferentes necessidades de custo e fidelidade. | A escolha do substituto altera tanto o custo quanto as expectativas de qualidade. |
| Unidade de preço | A saída de imagem do Gemini é precificada por tokens de saída de imagem, com exemplos por imagem por resolução. | Um número de planejamento por imagem pode ocultar o custo de prompt, edição, saída rejeitada e tentativas. |
| Família de endpoint | Os endpoints compatíveis com OpenAI Images da Flatkey são para gpt-image-2; os modelos de imagem Gemini usam o generateContent nativo do Gemini. | "Compatível com OpenAI" não significa que todo modelo de imagem deva ficar em /v1/images/generations. |
| Status da rota | Confirme a linha atual do modelo na Flatkey, os tipos de endpoint, a expressão de preço e a página pública de status antes do lançamento. | Os catálogos de modelos e a disponibilidade upstream mudam mais rápido do que os roadmaps de produto. |
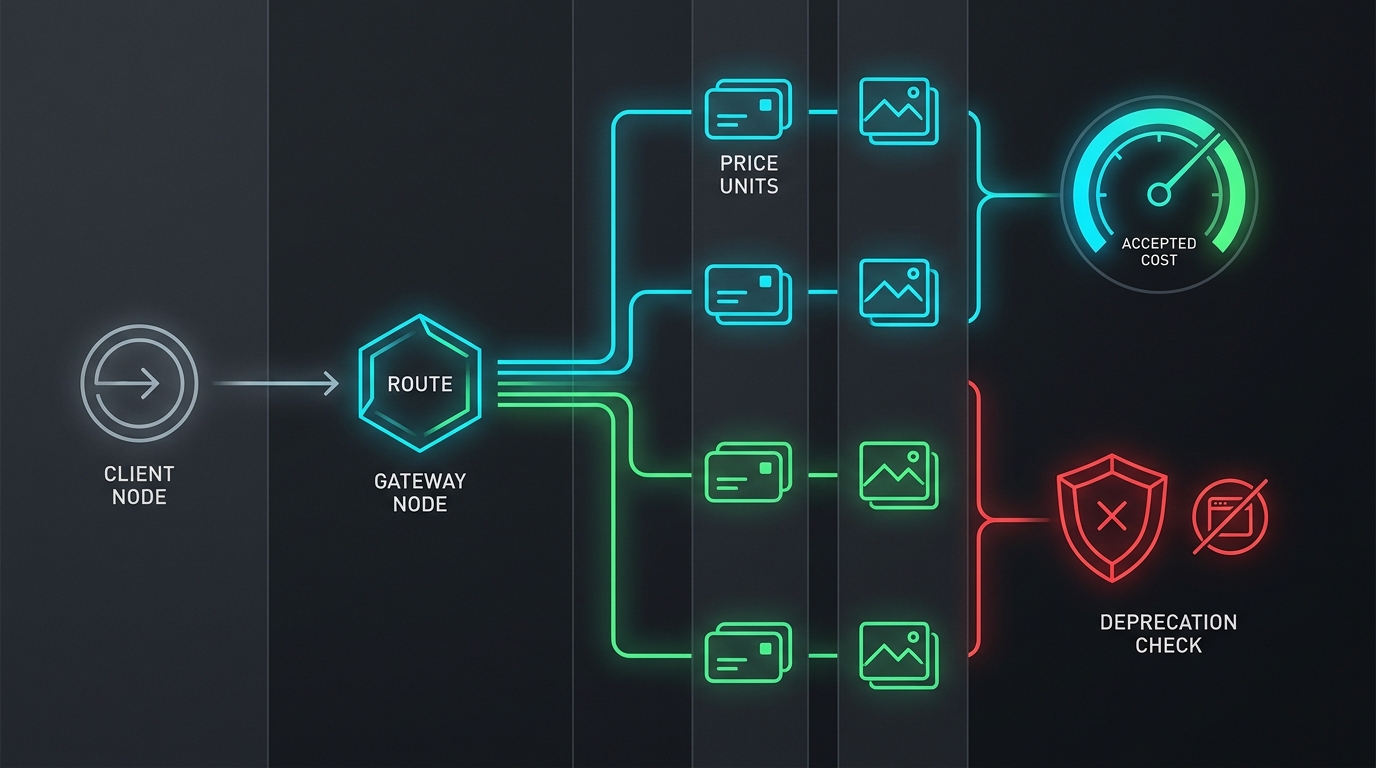
Este é o núcleo das Verificações de Preços e Roteamento da API Imagen para Workflows Compatíveis com OpenAI: normalize a unidade de preço, escolha o modelo atual e então teste a rota exata que seu código usará.
Precificação atual dos modelos de imagem do Google a normalizar
Use a precificação do provedor como fonte da verdade para o planejamento e, em seguida, compare-a com seu painel da Flatkey e o livro-razão de uso antes de comprometer o orçamento. A página de preços do Google lista estas linhas atuais de imagem:
| Modelo atual | Nomeação do Google | Preço de entrada pago | Preço de saída de imagem pago | Exemplos por imagem do Google |
|---|---|---|---|---|
gemini-3.1-flash-image | Nano Banana 2 | $0.50 por 1M tokens de texto/imagem | $60.00 por 1M tokens de saída de imagem | $0.045 em 0.5K, $0.067 em 1K, $0.101 em 2K, $0.151 em 4K |
gemini-3.1-flash-lite-image | Nano Banana 2 Lite | $0.25 por 1M tokens de texto/imagem/vídeo | $30.00 por 1M tokens de saída de imagem | $0.0336 por 1K imagem; saída em lote $0.0168 por 1K imagem |
gemini-3-pro-image | Nano Banana Pro | $2.00 por 1M tokens de texto/imagem; equivalente de entrada de imagem $0.0011 por imagem | $120.00 por 1M tokens de saída de imagem | $0.134 por imagem 1K/2K; $0.24 por imagem 4K |
gemini-2.5-flash-image | Legado Nano Banana | Descontinuado | Verifique antes de usar | O Google alerta que será desativado em 2 de outubro de 2026 |
A decisão não é "qual linha é mais barata". As equipes de mídia devem mapear cada modelo para uma classe de trabalho:
- Use
gemini-3.1-flash-lite-imagepara geração de rascunhos em alto volume, quando latência e custo são as restrições principais. - Use
gemini-3.1-flash-imagecomo caminho de substituição generalista quando você precisar de renderização de texto mais forte, consistência e opções de saída de até 4K. - Use
gemini-3-pro-imagepara ativos de produção complexos em que localização, grounding, consistência de marca e controle criativo sejam importantes o suficiente para justificar a taxa mais alta de tokens de saída.
Depois, execute o mesmo conjunto de prompts em cada candidato e compare o custo por imagem aceita, e não apenas o preço de saída listado.
Por que o preço de token listado não é o custo por imagem aceita
Fluxos de trabalho com imagens têm mais custo oculto do que fluxos de trabalho de texto. Um prompt pode gerar uma imagem utilizável, cinco imagens rejeitadas ou nenhum entregável devido a um bloqueio de segurança, incompatibilidade de rota, timeout ou falha na direção de arte. Fluxos de trabalho de edição também adicionam custo de imagem de entrada e novas tentativas extras.
Use esta fórmula para cada rota candidata:
accepted_image_cost =
  (successful_request_cost + failed_request_cost + retry_cost + edit_input_cost)
  / accepted_assets
Acompanhe as entradas separadamente:
| Métrica | Definição | Onde verificar |
|---|---|---|
| Custo de solicitação bem-sucedida | Custo de solicitações que retornaram pelo menos um candidato de imagem. | Fatura do fornecedor e livro-razão de uso do Flatkey. |
| Custo de solicitação com falha | Custo de erros de rota, bloqueios de segurança, partes de imagem vazias e timeouts do cliente que ainda consumiram uso. | Logs de erro, página de status e livro-razão de uso. |
| Custo de retry | Custo de regeneração após falha de prompt, seed, tamanho, segurança ou revisão de marca. | Fila de QA criativa e logs de execução. |
| Custo de entrada de edição | Custo de imagens de referência, máscaras e saídas anteriores usadas em edições. | Logs de payload da solicitação e uso do modelo. |
| Ativos aceitos | Imagens que passaram na QA criativa humana ou automatizada e foram publicadas na campanha, superfície do produto ou biblioteca de ativos. | DAM, CMS, rastreador de campanha ou conselho de revisão. |
Para o planejamento de produção, mantenha dois números no documento de lançamento: o custo do provedor listado por saída planejada e o custo medido por imagem aceita do seu próprio conjunto de prompts.
Verificações de roteamento para workflows compatíveis com OpenAI
O roteamento de texto compatível com OpenAI costuma ser uma alteração de base_url de uma linha. O roteamento de imagens precisa de uma etapa extra porque as APIs de imagem não são intercambiáveis.
A referência da API compatível com OpenAI Images da Flatkey documenta:
POST https://router.flatkey.ai/v1/images/generations
POST https://router.flatkey.ai/v1/images/edits
Essas rotas aceitam formatos de solicitação no estilo OpenAI Images para modelos expostos nesse canal, como gpt-image-2. O guia Gemini da Flatkey documenta a geração de imagens Gemini por meio de:
POST https://router.flatkey.ai/v1beta/models/{model}:generateContentA solicitação deve incluir saída de imagem na configuração da resposta, e as imagens geradas são retornadas como dados de imagem inline nas partes da resposta do Gemini. Se você enviar um modelo de imagem Gemini para o endpoint OpenAI Images, a documentação da Flatkey alerta que a solicitação pode retornar get_channel_failed.
Antes do lançamento, escreva a família de endpoint no seu contrato de integração:
| Carga de trabalho | Família de modelo | Família de rota da Flatkey | Verificação principal |
|---|---|---|---|
| Geração no estilo OpenAI Images | gpt-image-2 | /v1/images/generations | Confirme a imagem retornando em data[0].b64_json. |
| Edições no estilo OpenAI Images | gpt-image-2 | /v1/images/edits | Confirme o upload multipart de imagem, máscara opcional e tratamento do resultado em base64. |
| Geração ou edição de imagem Gemini | gemini-3.1-flash-image, gemini-3.1-flash-lite-image, gemini-3-pro-image | /v1beta/models/{model}:generateContent | Confirme a modalidade de imagem na solicitação e os dados de imagem inline na resposta. |
| Item legado do backlog de Imagen | IDs antigos imagen-* | Não assuma a disponibilidade da rota | Substitua por uma linha atual do Gemini/Nano Banana e faça um smoke test do ID exato do modelo. |
Esta tabela de roteamento deve ficar ao lado da sua tabela de preços. Uma estimativa de custo não está pronta para lançamento até que a família de rota seja comprovada.
Verificações da Flatkey antes de você lançar
Use a Flatkey como verificação do plano de controle, não como substituto da validação na origem. Uma revisão prática de lançamento deve incluir:
- Abra o diretório de modelos da Flatkey e pesquise o ID exato do modelo.
- Confirme o fornecedor, o status da rota, os tipos de endpoint suportados e a exibição do preço.
- Compare a linha atual do modelo na Flatkey com a página de preços do Google.
- Verifique a página de status da Flatkey quanto a incidentes ativos ou roteamento degradado.
- Execute uma solicitação smoke a partir do mesmo ambiente que a produção usará.
- Confirme o formato de resultado que sua aplicação espera:
b64_jsonpara saída no estilo OpenAI Images ou dados de imagem inline para saída Gemini. - Registre o ID da solicitação, o ID do modelo, o endpoint, a latência, o tamanho da saída e o custo no ticket de lançamento.
- Adicione uma allowlist ou uma barreira de proteção de orçamento antes que o trabalho em lote criativo seja executado.
O objetivo não é prender sua equipe a um único provedor. O objetivo é tornar a troca de modelos algo sem drama: linhas de modelo atuais, famílias de endpoints explícitas, um ledger de uso e critérios claros de fallback.
Uma lista de verificação de lançamento para trabalho de migração do Imagen
Use esta lista de verificação ao substituir chamadas legadas do Imagen ou ao adicionar uma nova rota de imagem do Gemini a um app compatível com OpenAI.
| Etapa | Condição de aprovação |
|---|---|
| Verificação de ciclo de vida | Nenhum caminho de código ativo referencia imagen-4.0-generate-001, imagen-4.0-ultra-generate-001 ou imagen-4.0-fast-generate-001. |
| Verificação de substituição | O ticket de release nomeia um modelo atual como gemini-3.1-flash-image, gemini-3.1-flash-lite-image ou gemini-3-pro-image. |
| Verificação de endpoint | O código usa Flatkey /v1beta/models/{model}:generateContent para modelos de imagem do Gemini, e não /v1/images/generations. |
| Verificação de preços | A planilha de orçamento inclui o preço de token de saída do provedor, a resolução esperada, a taxa de repetição e o custo de imagem aceita. |
| Verificação de limite de taxa | O plano em lote considera limites de RPM, TPM, RPD e IPM; limites de prévia ou experimentais são tratados como mais restritivos. |
| Verificação de resposta | O parser lida com partes de texto, partes de imagem, resultados de imagem vazios e bloqueios de segurança. |
| Verificação de marca d'água | As partes interessadas sabem que o Google afirma que as imagens geradas pelo Gemini incluem marca d'água SynthID. |
| Verificação de fallback | A rota de fallback é testada com o mesmo contrato de prompt e critérios de revisão. |
| Verificação de ledger | Os logs de uso do Flatkey são verificados após o teste de smoke e após o primeiro lote em produção. |
Se alguma linha falhar, não trate isso como um problema criativo. Trate isso como um problema de prontidão para produção.
Como executar as verificações de preços e roteamento da API Imagen para workflows compatíveis com OpenAI
Execute as verificações nesta ordem:
- Comece com as páginas de preços da API Gemini do Google, descontinuações do Gemini, geração de imagens Nano Banana e limites de taxa.
- Compare esses fatos do provedor com a linha de modelo atual do Flatkey para
gemini-3.1-flash-image. - Confirme o comportamento da rota no guia de geração de imagens do Flatkey e na referência de API compatível com OpenAI Images.
- Execute o teste de smoke e, em seguida, compare o custo no seu ledger de uso do Flatkey com sua contagem de imagens aceitas.
Essa sequência mantém as verificações de preços e roteamento da API Imagen para workflows compatíveis com OpenAI fundamentadas em preços oficiais, no ciclo de vida atual do modelo e na rota real que sua aplicação chamará.
Links internos para verificações mais profundas
Se você ainda estiver comparando famílias de modelos, comece com GPT Image vs Imagen API e GPT Image vs Gemini Image API. Se você precisar do modelo operacional mais amplo, use o guia prático da Image Generation API e o guia de métricas da API de geração de imagens.
Para equipes que estão construindo pipelines de mídia agentic, combine esta checklist com o playbook de roteamento de agente multimodal e o guia de catálogo de modelos de IA. Em seguida, verifique o diretório de modelos Flatkey ao vivo, a página de preços, a página de status e os documentos de geração de imagens da Flatkey antes do lançamento.
Perguntas frequentes
A API Imagen ainda é o caminho certo para novos trabalhos?
Geralmente, não. A documentação atual do Google marca os modelos Imagen como descontinuados e informa que eles serão encerrados em 17 de agosto de 2026. Para novos trabalhos, comece com os modelos de imagem atuais do Gemini/Nano Banana e verifique o ID exato do modelo antes da implementação.
Posso chamar modelos de imagem do Gemini por meio de um endpoint compatível com OpenAI Images?
Não por meio das rotas /v1/images/generations ou /v1/images/edits da Flatkey. A documentação da Flatkey diz que os modelos de imagem do Gemini usam o generateContent nativo do Gemini; as rotas compatíveis com OpenAI Images são para modelos de imagem expostos nessa família de endpoints, como gpt-image-2.
Qual modelo atual deve substituir o Imagen 4?
A tabela de descontinuação do Google lista gemini-3.1-flash-image como substituto para os IDs de modelo do Imagen 4. Na prática, as equipes devem testar gemini-3.1-flash-image, gemini-3.1-flash-lite-image e gemini-3-pro-image com seu próprio conjunto de prompts, porque custo, latência e taxa de aceitação criativa variam conforme a carga de trabalho.
O que o financeiro deve revisar antes de aprovar um lote?
Peça o preço do token de saída do provedor, a resolução esperada, a contagem de imagens, a taxa de repetição, a taxa de saída rejeitada, o uso de imagem de edição/referência e o custo medido por imagem aceita. Um único valor por imagem não é suficiente para uma campanha em produção.
Conclusão
As verificações de preços e roteamento da API Imagen para workflows compatíveis com OpenAI devem terminar com um teste de rota, não com uma planilha. O Imagen 4 já passou da data de encerramento, gemini-2.5-flash-image está em um caminho de descontinuação datado, e os modelos de imagem atuais do Gemini usam uma família de rotas diferente dos endpoints compatíveis com OpenAI Images da Flatkey.
Use a Flatkey para manter acesso ao modelo, cobrança e verificações de uso em um só lugar. Depois, faça com que todo workflow de imagens prove quatro coisas antes do lançamento: ID atual do modelo, unidade de preço atual, família correta de endpoint e custo medido por imagem aceita.