Mise à jour du 15 septembre 2026.
Les vérifications de tarification et de routage de l’API Imagen pour les workflows compatibles avec OpenAI commencent désormais par une vérification de migration, et non par une recherche de prix. La documentation actuelle de Google sur la génération d’images indique que les anciens modèles Imagen sont obsolètes et ont été arrêtés le 17 août 2026, et le tableau d’obsolescence de Google répertorie imagen-4.0-generate-001, imagen-4.0-ultra-generate-001 et imagen-4.0-fast-generate-001 avec gemini-3.1-flash-image comme remplacement recommandé.
Pour les équipes qui recherchent encore « tarification de l’API Imagen », la question pratique est la suivante : quel modèle d’image actuel doit remplacer cette route, selon quelle unité est-il facturé, et votre workflow compatible avec OpenAI peut-il réellement l’appeler via l’endpoint que vous prévoyez d’utiliser ?
Flatkey aide sur l’aspect opérationnel : conserver une seule clé, un seul solde, une seule facture et un seul répertoire de modèles pour les routes actuelles. Mais la vérification de routage reste importante. Le guide d’images de Flatkey distingue les routes compatibles avec OpenAI Images pour gpt-image-2 des routes Gemini natives generateContent pour les modèles d’image Gemini, et avertit que les modèles d’image Gemini ne peuvent pas être appelés via /v1/images/generations ou /v1/images/edits.
La réponse courte : Imagen est désormais un mot-clé de migration
Si votre backlog indique « Imagen API », considérez-le comme une étiquette héritée et vérifiez le modèle d’image Gemini actuel avant le lancement. Le 15 septembre 2026, les vérifications étayées par les sources sont les suivantes :
| Vérification | Ce qu’il faut vérifier | Pourquoi c’est important |
|---|---|---|
| Cycle de vie du modèle | Les identifiants des modèles Imagen 4 sont arrêtés ; gemini-2.5-flash-image est obsolète avec un arrêt prévu le 2 octobre 2026. | Un identifiant de modèle obsolète peut passer la revue de code et échouer à l’exécution. |
| Remplacement actuel | Google oriente les utilisateurs d’Imagen 4 vers gemini-3.1-flash-image ; Google répertorie également gemini-3.1-flash-lite-image et gemini-3-pro-image pour différents besoins de coût et de fidélité. | Le choix du remplacement modifie à la fois les attentes en matière de coût et de qualité. |
| Unité de tarification | La sortie d’image Gemini est facturée par jetons de sortie d’image, avec des exemples par image selon la résolution. | Un chiffre de planification par image peut masquer le coût du prompt, de l’édition, des sorties rejetées et des nouvelles tentatives. |
| Famille d’endpoint | Les endpoints compatibles avec OpenAI Images de Flatkey sont destinés à gpt-image-2 ; les modèles d’image Gemini utilisent le generateContent natif de Gemini. | « Compatible avec OpenAI » ne signifie pas que tous les modèles d’image doivent utiliser /v1/images/generations. |
| État de la route | Confirmez la ligne de modèle actuelle de Flatkey, les types d’endpoint, l’expression de tarification et la page d’état publique avant la mise en production. | Les catalogues de modèles et la disponibilité en amont évoluent plus vite que les feuilles de route produit. |
C’est le cœur des vérifications de tarification et de routage de l’API Imagen pour les workflows compatibles avec OpenAI : normaliser l’unité de prix, choisir le modèle actuel, puis tester la route exacte que votre code utilisera.
Tarification actuelle des modèles d’image Google à normaliser
Utilisez la tarification du fournisseur comme source de vérité pour la planification, puis comparez-la à votre tableau de bord Flatkey et à votre registre d’utilisation avant d’engager le budget. La page de tarification de Google répertorie ces lignes d’image actuelles :
| Modèle actuel | Nom Google | Prix d’entrée payant | Prix de sortie payante des images | Exemples par image de Google |
|---|---|---|---|---|
gemini-3.1-flash-image | Nano Banana 2 | 0,50 $ par 1 M de jetons texte/image | 60,00 $ par 1 M de jetons de sortie image | 0,045 $ à 0,5K, 0,067 $ à 1K, 0,101 $ à 2K, 0,151 $ à 4K |
gemini-3.1-flash-lite-image | Nano Banana 2 Lite | 0,25 $ par 1 M de jetons texte/image/vidéo | 30,00 $ par 1 M de jetons de sortie image | 0,0336 $ par image à 1K ; sortie par lot 0,0168 $ par image à 1K |
gemini-3-pro-image | Nano Banana Pro | 2,00 $ par 1 M de jetons texte/image ; équivalent d’entrée image 0,0011 $ par image | 120,00 $ par 1 M de jetons de sortie image | 0,134 $ par image à 1K/2K ; 0,24 $ par image à 4K |
gemini-2.5-flash-image | Héritage Nano Banana | Obsolète | Vérifier avant utilisation | Google avertit qu’il sera arrêté le 2 octobre 2026 |
La décision n’est pas « quelle ligne est la moins chère ». Les équipes média doivent associer chaque modèle à une catégorie de tâche :
- Utilisez
gemini-3.1-flash-lite-imagepour la génération de brouillons à grand volume, lorsque la latence et le coût sont les contraintes les plus fortes. - Utilisez
gemini-3.1-flash-imagecomme voie de remplacement généraliste lorsque vous avez besoin d’un rendu de texte plus robuste, de cohérence et d’options de sortie jusqu’à 4K. - Utilisez
gemini-3-pro-imagepour les ressources de production complexes, lorsque la localisation, l’ancrage, la cohérence de marque et le contrôle créatif comptent suffisamment pour justifier le tarif plus élevé des jetons de sortie.
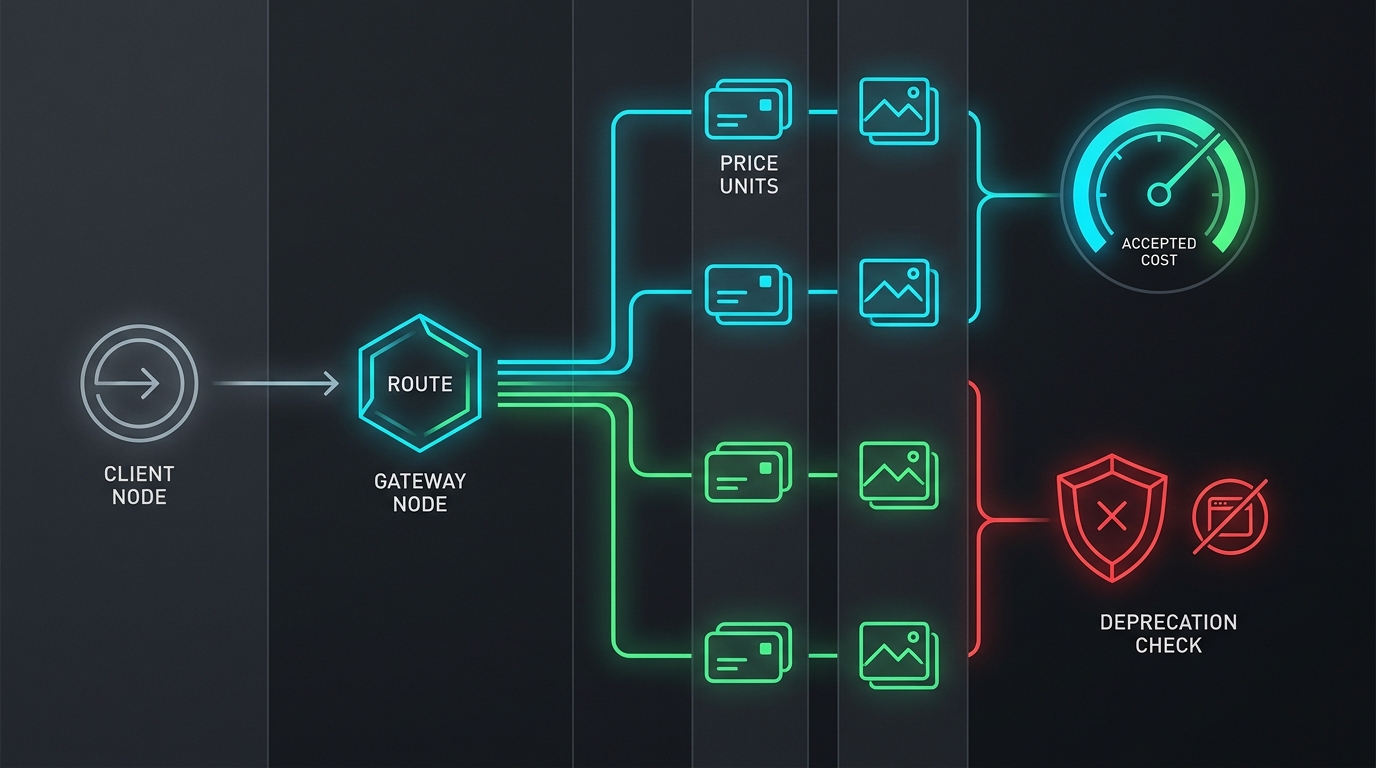
Exécutez ensuite le même ensemble de prompts via chaque candidat et comparez le coût par image acceptée, et pas seulement le prix de sortie indiqué.
Pourquoi le prix de jetons indiqué n’est pas le coût de l’image acceptée
Les workflows d’image comportent davantage de coûts cachés que les workflows texte. Un prompt peut générer une image utilisable, cinq images rejetées, ou aucun livrable en raison d’un blocage de sécurité, d’une inadéquation de routage, d’un délai d’attente ou d’un échec de direction artistique. Les workflows d’édition ajoutent aussi le coût des images d’entrée et des tentatives supplémentaires.
Utilisez cette formule pour chaque route candidate :
accepted_image_cost =
  (successful_request_cost + failed_request_cost + retry_cost + edit_input_cost)
  / accepted_assets
Suivez les entrées séparément :
| Métrique | Définition | Où vérifier |
|---|---|---|
| Coût des requêtes réussies | Coût des requêtes qui ont renvoyé au moins un candidat image. | Facture du fournisseur et registre d’utilisation Flatkey. |
| Coût des requêtes échouées | Coût des erreurs de routage, des blocages de sécurité, des parties d’image vides et des délais d’attente client qui ont tout de même consommé de l’utilisation. | Journaux d’erreurs, page d’état et registre d’utilisation. |
| Coût des tentatives | Coût de la régénération après échec du prompt, du seed, de la taille, de la sécurité ou de la validation de marque. | File d’attente de QA créative et journaux d’exécution. |
| Coût des entrées d’édition | Coût des images de référence, masques et sorties précédentes utilisées dans les éditions. | Journaux de charge utile des requêtes et utilisation du modèle. |
| Actifs acceptés | Images qui ont passé la QA créative humaine ou automatisée et ont été livrées dans la campagne, l’interface produit ou la bibliothèque d’assets. | DAM, CMS, suivi de campagne ou comité de validation. |
Pour la planification de production, conservez deux chiffres dans le document de lancement : le coût fournisseur indiqué par sortie prévue, et le coût mesuré par image acceptée à partir de votre propre ensemble de prompts.
Vérifications de routage pour les workflows compatibles avec OpenAI
Le routage de texte compatible avec OpenAI se résume souvent à un changement d’une ligne de base_url. Le routage des images nécessite une étape supplémentaire, car les API d’images ne sont pas interchangeables.
La référence de l’API compatible avec OpenAI Images de Flatkey documente :
POST https://router.flatkey.ai/v1/images/generations
POST https://router.flatkey.ai/v1/images/edits
Ces routes acceptent des structures de requête de type OpenAI Images pour les modèles exposés sur ce canal, comme gpt-image-2. Le guide Gemini de Flatkey documente la génération d’images Gemini via :
POST https://router.flatkey.ai/v1beta/models/{model}:generateContentLa requête doit inclure la sortie image dans la configuration de réponse, et les images générées sont renvoyées sous forme de données d’image inline dans les parties de réponse Gemini. Si vous envoyez un modèle d’image Gemini vers l’endpoint OpenAI Images, la documentation de Flatkey avertit que la requête peut renvoyer get_channel_failed.
Avant le lancement, indiquez la famille d’endpoint dans votre contrat d’intégration :
| Charge de travail | Famille de modèles | Famille de routes Flatkey | Vérification principale |
|---|---|---|---|
| Génération de type OpenAI Images | gpt-image-2 | /v1/images/generations | Confirmer que l’image est renvoyée dans data[0].b64_json. |
| Éditions de type OpenAI Images | gpt-image-2 | /v1/images/edits | Confirmer le téléchargement multipart de l’image, le masque facultatif et la gestion du résultat en base64. |
| Génération ou édition d’images Gemini | gemini-3.1-flash-image, gemini-3.1-flash-lite-image, gemini-3-pro-image | /v1beta/models/{model}:generateContent | Confirmer la modalité image dans la requête et les données d’image inline dans la réponse. |
| Élément de backlog Imagen hérité | Anciens ID imagen-* | Ne pas supposer la disponibilité de la route | Remplacer par une ligne Gemini/Nano Banana actuelle et tester rapidement l’ID exact du modèle. |
Ce tableau de routage doit figurer à côté de votre tableau de tarification. Une estimation de coût n’est pas prête pour le lancement tant que la famille de routes n’est pas validée.
Vérifications Flatkey avant la mise en production
Utilisez Flatkey comme vérification du plan de contrôle, et non comme substitut à la vérification de la source. Une revue de release pratique devrait inclure :
- Ouvrir l’annuaire des modèles Flatkey et rechercher l’ID exact du modèle.
- Confirmer le fournisseur, l’état de la route, les types d’endpoint pris en charge et l’affichage du prix.
- Comparer la ligne de modèle actuelle de Flatkey avec la page de tarification de Google.
- Vérifier la page d’état de Flatkey pour détecter les incidents actifs ou une dégradation du routage.
- Exécuter une requête de test depuis le même environnement que celui utilisé en production.
- Confirmer le format de résultat attendu par votre application :
b64_jsonpour une sortie de type OpenAI Images ou des données d’image inline pour une sortie Gemini. - Enregistrer l’ID de requête, l’ID du modèle, l’endpoint, la latence, la taille de sortie et le coût dans le ticket de release.
- Ajouter une liste d’autorisation ou une limite budgétaire avant l’exécution du batch créatif.
L’objectif n’est pas d’enfermer votre équipe chez un seul fournisseur. L’objectif est de rendre le changement de modèle banal : lignes de modèles actuels, familles d’endpoint explicites, registre d’utilisation et critères de repli clairs.
Liste de contrôle de lancement pour le travail de migration Imagen
Utilisez cette liste de contrôle lorsque vous remplacez des appels Imagen hérités ou que vous ajoutez un nouveau routeur d’images Gemini à une application compatible avec OpenAI.
| Étape | Condition de réussite |
|---|---|
| Vérification du cycle de vie | Aucun chemin de code actif ne fait référence à imagen-4.0-generate-001, imagen-4.0-ultra-generate-001 ou imagen-4.0-fast-generate-001. |
| Vérification du remplacement | Le ticket de mise en production nomme un modèle actuel tel que gemini-3.1-flash-image, gemini-3.1-flash-lite-image ou gemini-3-pro-image. |
| Vérification de l’endpoint | Le code utilise Flatkey /v1beta/models/{model}:generateContent pour les modèles d’images Gemini, et non /v1/images/generations. |
| Vérification de la tarification | La feuille budgétaire inclut le prix du jeton de sortie du fournisseur, la résolution attendue, le ratio de nouvelles tentatives et le coût des images acceptées. |
| Vérification des limites de débit | Le plan de lot tient compte des limites RPM, TPM, RPD et IPM ; les limites de préversion ou expérimentales sont considérées comme plus strictes. |
| Vérification des réponses | Le parseur gère les parties texte, les parties image, les résultats d’image vides et les blocages liés à la sécurité. |
| Vérification du filigrane | Les parties prenantes savent que Google indique que les images générées par Gemini incluent un filigrane SynthID. |
| Vérification du repli | La route de repli est testée avec le même contrat d’invite et les mêmes critères de revue. |
| Vérification du registre | Les journaux d’utilisation Flatkey sont vérifiés après le test de fumée et après le premier lot de production. |
Si une ligne échoue, ne l’interprétez pas comme un problème créatif. Traitez-la comme un problème de préparation à la production.
Comment exécuter les vérifications de tarification et de routage de l’API Imagen pour les workflows compatibles avec OpenAI
Exécutez les vérifications dans cet ordre :
- Commencez par les pages de tarification de l’API Gemini, des obsolescences Gemini, de la génération d’images Nano Banana et des limites de débit de Google.
- Comparez ces informations fournisseur avec la ligne de modèle Flatkey actuelle pour
gemini-3.1-flash-image. - Confirmez le comportement de la route dans le guide de génération d’images de Flatkey et la référence d’API compatible OpenAI Images.
- Exécutez le test de fumée, puis comparez le coût dans votre registre d’utilisation Flatkey avec votre nombre d’images acceptées.
Cette séquence maintient les vérifications de tarification et de routage de l’API Imagen pour les workflows compatibles avec OpenAI ancrées dans la tarification officielle, le cycle de vie actuel du modèle et la route réelle que votre application appellera.
Liens internes pour des vérifications plus approfondies
Si vous comparez encore des familles de modèles, commencez par GPT Image vs Imagen API et GPT Image vs Gemini Image API. Si vous avez besoin du modèle d’exploitation plus large, utilisez le guide pratique de l’API de génération d’images et le guide des métriques de l’API de génération d’images.
Pour les équipes qui construisent des pipelines média agentiques, associez cette liste de contrôle au manuel de routage d’agents multimodaux et au guide du catalogue de modèles d’IA. Vérifiez ensuite le répertoire de modèles Flatkey en direct, la page de tarification, la page d’état et la documentation Flatkey sur la génération d’images avant le déploiement.
Questions fréquemment posées
L’API Imagen est-elle toujours la bonne option pour de nouveaux développements ?
En général, non. La documentation actuelle de Google indique que les modèles Imagen sont obsolètes et précise qu’ils seront arrêtés le 17 août 2026. Pour de nouveaux projets, commencez avec les modèles d’images Gemini/Nano Banana actuels et vérifiez l’identifiant exact du modèle avant l’implémentation.
Puis-je appeler les modèles d’images Gemini via un endpoint compatible avec OpenAI Images ?
Pas via les routes /v1/images/generations ou /v1/images/edits de Flatkey. La documentation de Flatkey indique que les modèles d’images Gemini utilisent le generateContent natif de Gemini ; les routes compatibles avec OpenAI Images concernent les modèles d’images exposés sur cette famille d’endpoints, comme gpt-image-2.
Quel modèle actuel devrait remplacer Imagen 4 ?
Le tableau de dépréciation de Google répertorie gemini-3.1-flash-image comme remplacement des identifiants de modèle Imagen 4. En pratique, les équipes devraient tester gemini-3.1-flash-image, gemini-3.1-flash-lite-image et gemini-3-pro-image avec leur propre jeu de prompts, car le coût, la latence et le taux d’acceptation créative varient selon la charge de travail.
Que doit examiner la finance avant d’approuver un lot ?
Demandez le prix du jeton de sortie du fournisseur, la résolution attendue, le nombre d’images, le ratio de réessais, le ratio de sorties rejetées, l’utilisation d’images de référence/de modification, ainsi que le coût mesuré par image acceptée. Un simple montant par image ne suffit pas pour une campagne en production.
Points finaux avant le lancement
Les vérifications de tarification et de routage de l’API Imagen pour les workflows compatibles avec OpenAI doivent se terminer par un test de route, et non par un tableur. Imagen 4 a dépassé sa date d’arrêt, gemini-2.5-flash-image suit un chemin de dépréciation daté, et les modèles d’images Gemini actuels utilisent une famille de routes différente des endpoints compatibles avec OpenAI Images de Flatkey.
Utilisez Flatkey pour centraliser l’accès aux modèles, la facturation et les vérifications d’utilisation. Ensuite, faites en sorte que chaque workflow d’image prouve quatre éléments avant le lancement : l’identifiant de modèle actuel, l’unité de tarification actuelle, la bonne famille d’endpoints et le coût mesuré par image acceptée.