
flatkey.ai Blog
Einblicke, Produktnotizen und Implementierungsleitfäden für Teams, die mit KI-APIs entwickeln.
Architektur von KI-Gateways
Neueste Artikel in Architektur von KI-Gateways.
WeiterlesenMigration von Basis-URL und SDK
Neueste Artikel in Migration von Basis-URL und SDK.
WeiterlesenKosten, Abrechnung und Betrieb
Neueste Artikel in Kosten, Abrechnung und Betrieb.
WeiterlesenUnternehmenskontrollen und Vertrauen
Neueste Artikel in Unternehmenskontrollen und Vertrauen.
WeiterlesenGateway-Vergleiche
Neueste Artikel in Gateway-Vergleiche.
WeiterlesenLeitfäden für Modelle und Modalitäten
Neueste Artikel in Leitfäden für Modelle und Modalitäten.
WeiterlesenZuverlässigkeit und Routing
Neueste Artikel in Zuverlässigkeit und Routing.
WeiterlesenWerkzeugintegrationen
Neueste Artikel in Werkzeugintegrationen.
Weiterlesen
KI-Chatbot-API: Die richtige Ebene wählen und sicher entwickeln
Erfahren Sie den Unterschied zwischen einer Modell-API und einer Chatbot-Plattform-API, wie Sie einen Chat-Assistenten integrieren und Kosten, Sicherheit und Übergaben testen.

Was ist eine KI-API? Funktionsweise, Kosten und erster Aufruf
Erfahren Sie, was eine KI-API ist, wie eine Anfrage funktioniert und wie Sie für Ihre erste Integration zwischen einem Direktanbieter, Model Router oder selbst gehosteter Inferenz wählen.

vLLM vs. Ollama: Performance, Kosten und Deployment-Kompromisse
Vergleichen Sie vLLM und Ollama für lokale Experimente und GPU-Inferenz in der Produktion – einschließlich Parallelität, API-Kompatibilität, Benchmarks, Deployment und Kosten.

Reverse Proxy vs. API-Gateway: Was sich für KI-Traffic ändert
Vergleichen Sie Reverse Proxies und API-Gateways hinsichtlich Request-Routing, Identität, Kontingenten, Nutzungsnachweisen und den Anforderungen des KI-Modell-Traffics.

Kontinuierliches Batching mit vLLM: Scheduler, Tuning und Benchmarks
Erfahren Sie, wie vLLM asynchrone Anfragen plant, Token- und Sequenzlimits optimiert und Durchsatz im Hinblick auf Latenz und Speicherdruck benchmarked.
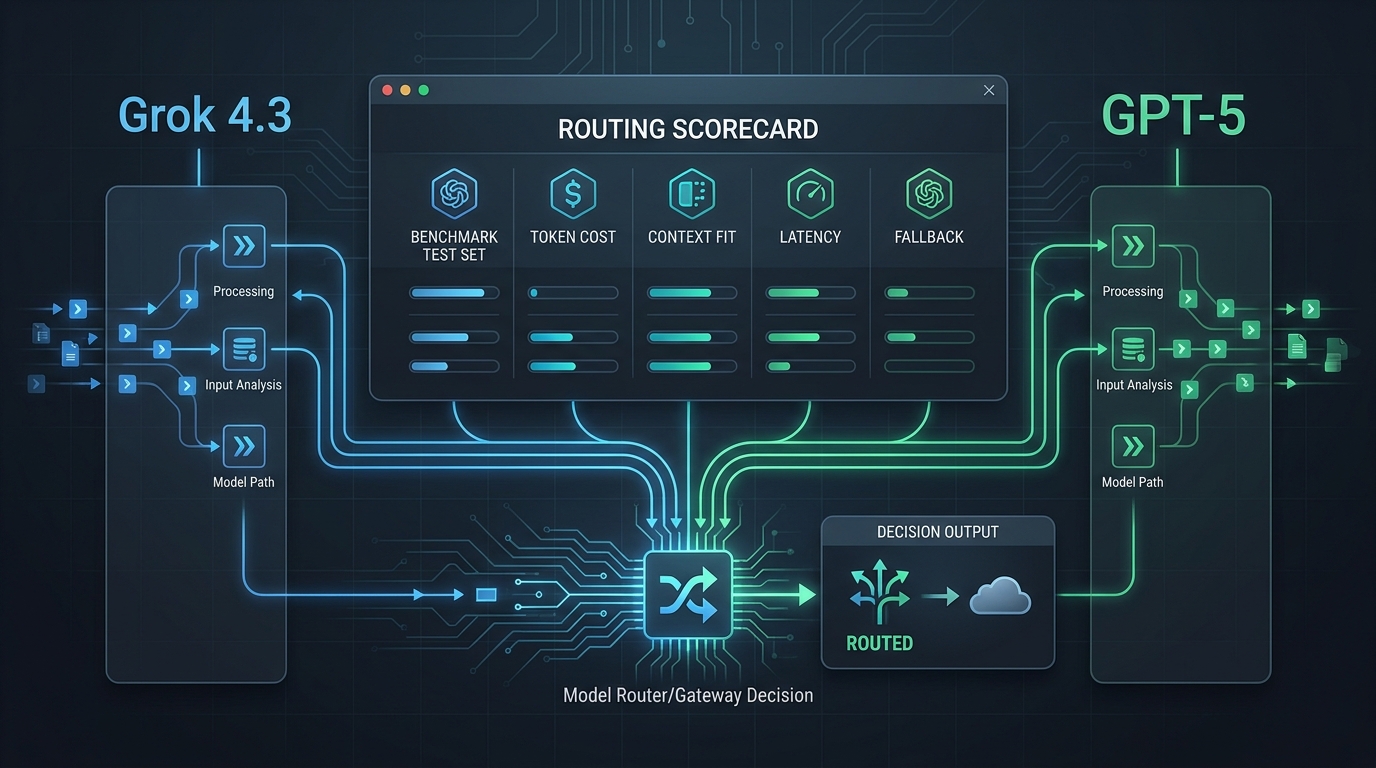
Grok 4.3 vs. GPT-5: Benchmarks, Preise und wann welches Modell geroutet werden sollte
Ein quellenbasierter Routing-Leitfaden für Teams, die Grok 4.3 und GPT-5 hinsichtlich Preisen, Kontext, Benchmark-Design, Migrationszeitpunkt und dem Einsatz eines Gateways vergleichen.
GPU-Server mieten: Architektur, Leistung und Leitfaden für die Cloud-Bereitstellung
Erfahren Sie, wie Sie einen GPU-Server mit der passenden Ressourcenzuweisung, Topologieprüfungen, Bereitstellungsphasen und Abnahmetests mieten, bevor Sie Kapazitäten verbindlich buchen.
GPU-Server-Rack: Architektur, Leistung und Leitfaden für Cloud-Bereitstellung
Ein praxisnaher Leitfaden zur Planung, Validierung und Bereitstellung von GPU-Kapazität im Rack-Maßstab für KI-Workloads.

Leitfaden zu APIs zur PII-Schwärzung (2026): AWS, Google Cloud, Azure und Presidio für LLM-Apps im Vergleich
Eine API zur PII-Schwärzung erkennt personenbezogene Daten in Texten und maskiert sie. Vergleichen Sie Amazon Comprehend, Google Sensitive Data Protection, Azure Language PII und Presidio anhand von Code, Abrechnungseinheiten, tatsächlichen Erkennungsergebnissen und einer Pipeline zur Schwärzung für LLMs.
Spekulatives Decoding für LLM-Inferenz: Durchsatzgewinne und Kompromisse
Ein praxisnaher Leitfaden zum spekulativen Decoding für LLM-Inferenz: Funktionsweise, Einsatzmöglichkeiten, Unterschiede zwischen EAGLE und Medusa sowie wichtige Benchmarks vor dem Rollout.
KI-Inferenz vs. Training: Performance, Kosten und Bereitstellungsabwägungen
KI-Inferenz vs. Training erklärt: Vergleichen Sie Leistungskennzahlen, Kostentreiber, Bereitstellungsanforderungen und wann Sie ein Modell feinabstimmen oder bereitstellen sollten.
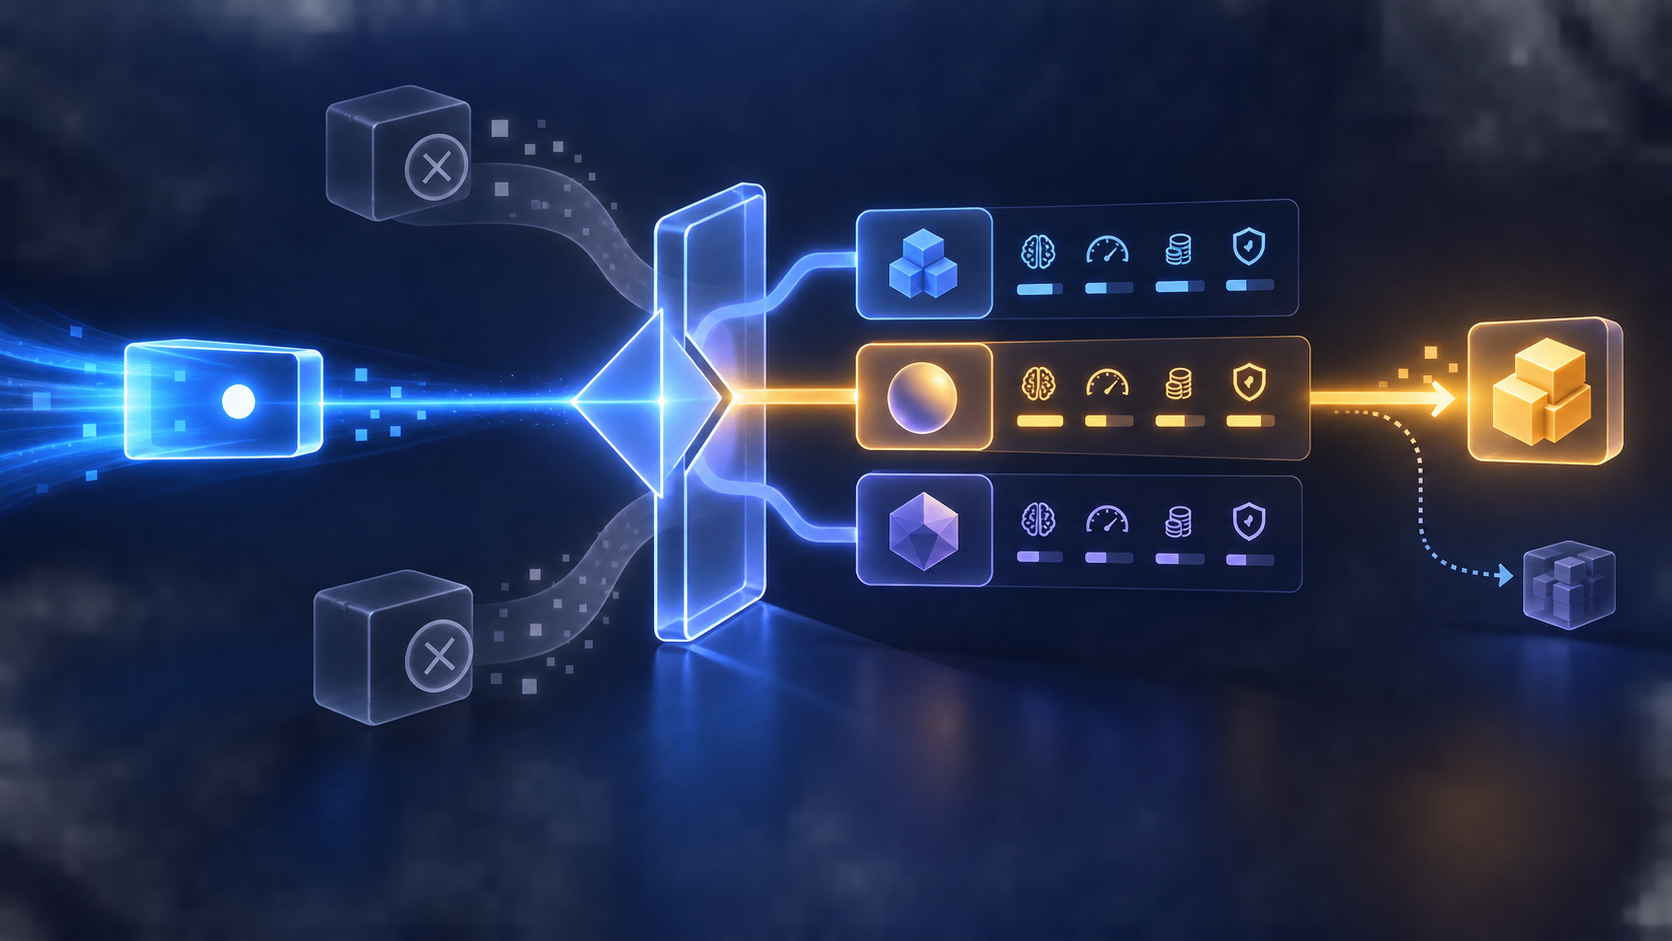
Was ist LLM-Routing? Regeln, Gewichtungen und kostenbewusste Richtlinien erklärt
Was ist LLM-Routing? Erfahren Sie, wie Regeln, gewichtete Bewertungen, Fähigkeitsfilter, Fallbacks und Evaluierung Multi-Modell-APIs zuverlässiger machen.
vLLM Expert-Parallel-Bereitstellung für DeepSeek und andere MoE-Modelle
Stellen Sie vLLM Expert Parallel für DeepSeek und andere MoE-Modelle mit den richtigen Flags, der passenden Topologie, Backend-Prüfungen und Rollout-Tests bereit.
vLLM mit Docker: Architektur, Performance und Cloud-Deployment
Anleitung zum Deployment von vLLM mit Docker auf Cloud-GPUs: Architektur, OpenAI-kompatible Einrichtung, Performance-Tuning, Multi-GPU-Skalierung und Produktionschecks.

Einheitliche API für KI-Modelle: Ein Schlüssel, Endpoint und Abrechnung
Ein praxisnaher Leitfaden zu einheitlichen APIs für die Bündelung von Modellzugriff, Schlüsseln, Endpoints, Nutzung, Abrechnung, Routing und Fallbacks – ohne anbieterspezifische Optionen zu verlieren.
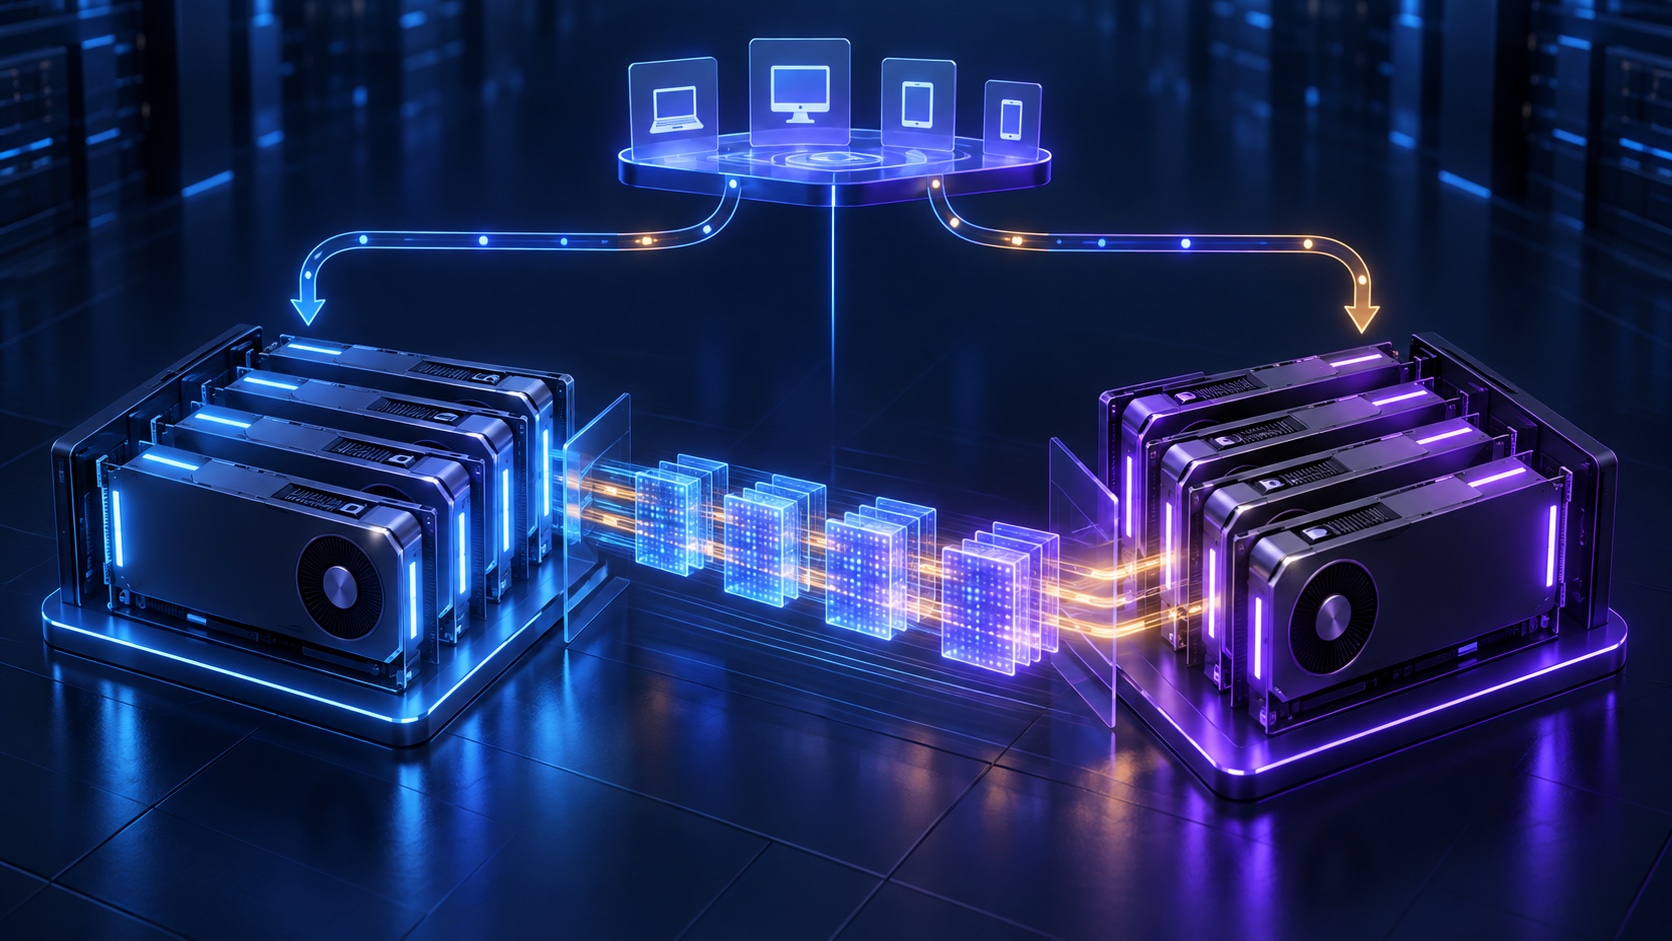
SGLang Prefill-Decode-Disaggregation: Architektur- und Bereitstellungsleitfaden
Implementieren Sie die SGLang Prefill-Decode-Disaggregation mit separaten GPU-Pools, KV-Cache-Transfer, Validierungsmetriken, Topologieoptionen und Rollout-Prüfungen.

Architekturnotizen
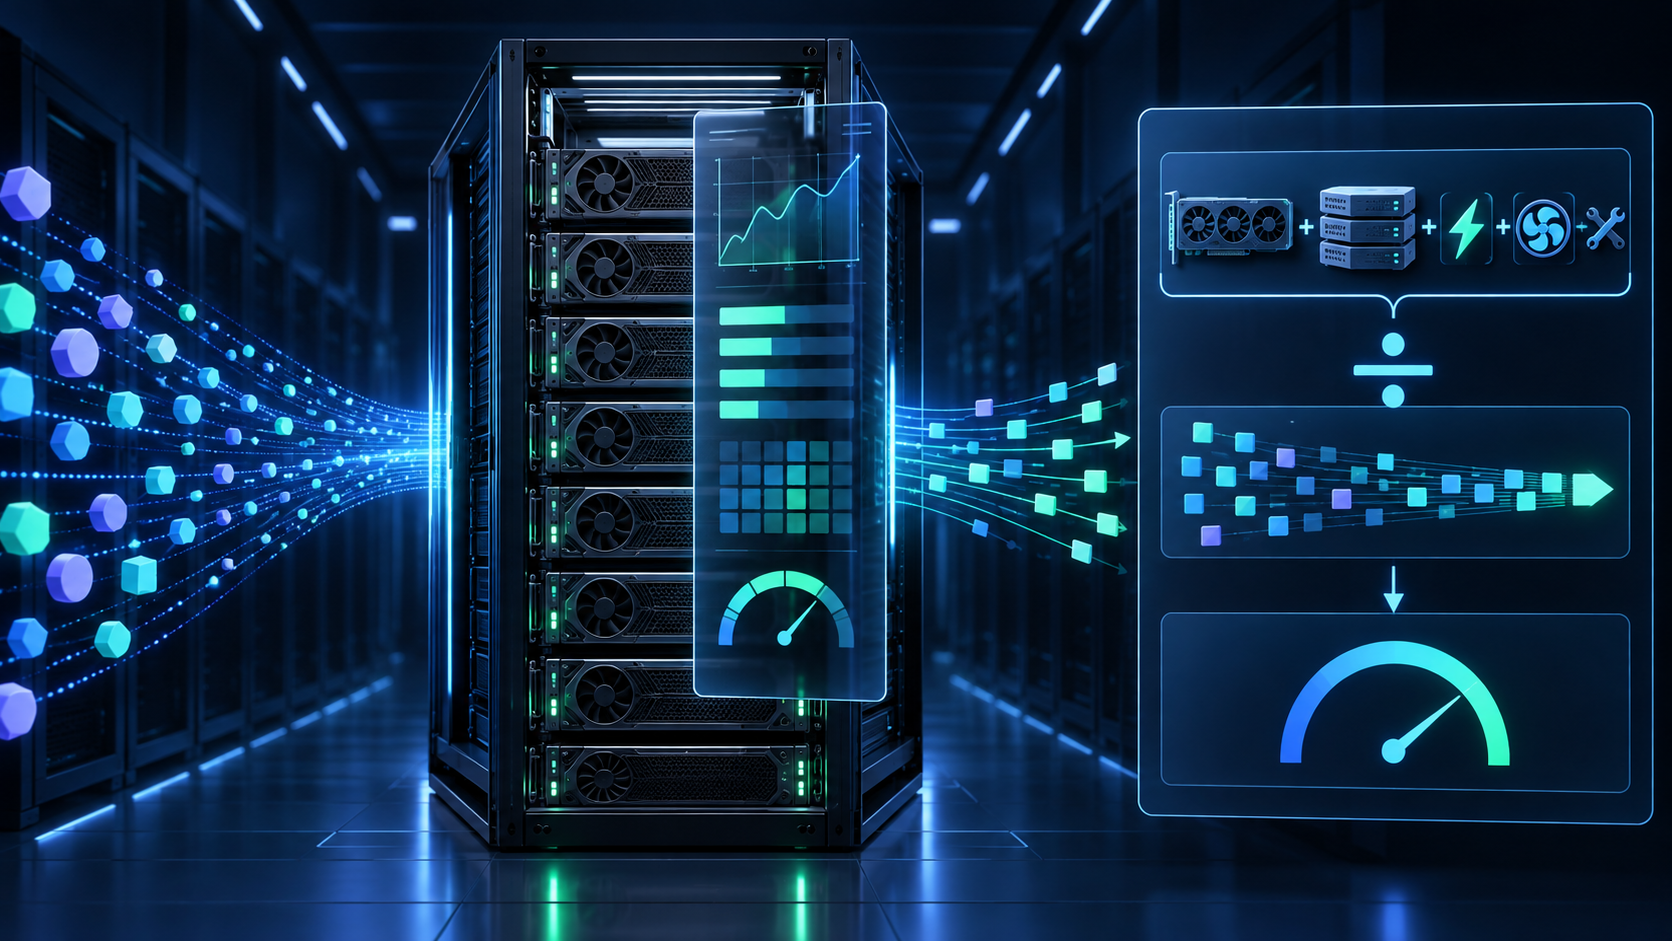
Kosten selbstgehosteter LLMs pro Million Tokens: Ein reproduzierbares GPU-Kostenmodell
Ein reproduzierbares Modell zur Berechnung der Serving-Kosten selbstgehosteter LLMs anhand vollständig ausgelasteter GPU-Kapazität, akzeptiertem Durchsatz, Auslastung und Qualität.
Schneller entwickeln mit einem KI-Gateway.
Nutze flatkey.ai, um Modelle, Schlüssel, Abrechnung und Observability über eine API-Plattform zu verwalten.
Loslegen