Was ist LLM-Routing? Regeln, Gewichtungen und kostenbewusste Richtlinien erklärt
LLM-Routing ist der Prozess, bei dem ausgewählt wird, welches Modell, welcher Anbieterpfad oder welcher Fallback-Pfad eine bestimmte KI-Anfrage bearbeiten soll. Die Entscheidung kann im Anwendungscode festgelegt, durch explizite Regeln getroffen, anhand gewichteter Kriterien berechnet oder einem trainierten Klassifikator überlassen werden. Es geht nicht darum, dass jede Anfrage einen anderen Pfad nimmt. Es geht darum, jeden Pfad bewusst, testbar und sicher zu gestalten.
Wenn Sie sich fragen, was LLM-Routing ist, lautet die praktische Antwort: Es ist die Richtlinienebene zwischen einer Anwendungsanfrage und einem Modellaufruf. Ein Router schließt zunächst Optionen aus, die die Anfrage nicht erfüllen können, und wählt dann anhand der von Ihrem Team festgelegten Prioritäten eine zulässige Route aus – beispielsweise Fähigkeit, Qualität, Latenz, Kosten, Verfügbarkeit und Datenrichtlinie.
Dieser Unterschied ist wichtig. Ein günstiges Modell ist nicht automatisch ein sicherer Standard für einen kundenorientierten Workflow. Ein sehr leistungsfähiges Modell ist nicht automatisch die richtige Wahl für eine einfache Klassifizierungsaufgabe. Und ein Fallback ist nur dann nützlich, wenn er die Ausgabe-, Tool- und Datenverträge bewahrt, die Ihre Anwendung erwartet.
Kurzfassung: Gutes LLM-Routing beginnt mit harten Einschränkungen, bewertet nur kompatible Kandidaten, dokumentiert den Grund für die Auswahl und greift nur dann auf einen Fallback zurück, wenn die Sicherungsoption vertragssicher ist.
Das ist der Standard, den eine produktionsreife Antwort auf die Frage „Was ist LLM-Routing?“ erfüllen sollte: eine Entscheidung, die ein Engineer prüfen, testen und ändern kann, ohne raten zu müssen, welche verborgene Regel den Traffic verschoben hat.
Was genau ist LLM-Routing?
Was ist LLM-Routing? Es ist ein Entscheidungsprozess, der eine eingehende Anfrage dem besten freigegebenen Ausführungspfad für diese Anfrage zuordnet. Der Pfad kann ein bestimmtes Modell, einen Anbieter, eine Region, eine Modellgruppe oder einen getesteten Fallback identifizieren.
Der Router kann sich in Ihrer Anwendung, einem API-Gateway oder einem verwalteten Modell-Routing-Dienst befinden. Beispielsweise wählt Amazon Bedrock intelligent prompt routing unter zulässigen Modellen innerhalb einer Familie anhand der prognostizierten Antwortqualität und Kosten aus. Der Microsoft Foundry-Modellrouter bietet ausgewogene sowie qualitäts- und kostenorientierte Routing-Modi. Dies sind Implementierungen derselben zugrunde liegenden Idee: bewusst auszuwählen, statt jeden Prompt als identisch zu behandeln.
LLM-Routing ist nicht dasselbe wie:
- Ein Load Balancer. Ein Load Balancer verteilt Anfragen auf ähnliche Server. Ein LLM-Router berücksichtigt zusätzlich Modellfähigkeiten und Aufgabenergebnisse.
- Eine Wiederholungsschleife. Das erneute Ausführen derselben Route kann einen vorübergehenden Fehler beheben; es entscheidet nicht, ob ein anderes Modell für die Aufgabe geeignet ist.
- Ein ungeprüfter Modellwechsel. Wird eine Anfrage auf ein Backup umgeleitet, das die JSON-Struktur, das Tool-Verhalten, Datenschutzgrenzen oder die Antwortqualität verändert, kann dies einen schwerwiegenderen Fehler verursachen als ein expliziter Fehler.
- Modelltraining. Routing wählt zur Anfragezeit einen Bereitstellungspfad aus. Es verändert keine Modellgewichte.
Eine umfassendere Betrachtung der Grenze, an der diese Entscheidungen stattfinden, finden Sie in unserem Leitfaden dazu, was ein LLM-Gateway ist und wann es nützlich wird.
Wie ein LLM-Router eine Entscheidung trifft
Das zuverlässigste Design trennt Zulässigkeit von Präferenz. Schließen Sie zunächst Optionen aus, die die Anfrage nicht erfüllen können. Bewerten Sie dann die verbleibenden Routen anhand der aktuellen Traffic-Klasse.
1. Harte Einschränkungen vor jeder Bewertung anwenden
Harte Einschränkungen sind nicht verhandelbar. Ein Modell, das eine davon nicht erfüllt, sollte nicht im Kandidatensatz verbleiben, nur weil es günstig oder schnell ist.
Typische Filter umfassen:
| Einschränkung | Beispielfrage | Warum sie zuerst kommt |
|---|---|---|
| Modalität | Akzeptiert die Route Text-, Bild-, Audio- oder Videoeingaben? | Ein reiner Textendpunkt kann eine multimodale Anfrage nicht verarbeiten. |
| Vertrag | Unterstützt sie die erforderlichen Tool-Aufrufe, das Streaming-Format oder strukturierte Ausgabe? | Eine syntaktisch gültige Antwort kann die Anwendung dennoch beschädigen. |
| Datenrichtlinie | Sind Anbieter, Region oder Aufbewahrungseinstellung für diese Anfrage freigegeben? | Richtlinien können nicht gegen einen niedrigeren Tokenpreis eingetauscht werden. |
| Kapazität | Verfügt die Route über ausreichend Kontext, Kontingent oder verfügbare Kapazität? | Ein Kandidat, der die Anfrage sofort ablehnt, ist nicht zulässig. |
| Produktrichtlinie | Ist dieses Modell für diesen Mandanten, diese Umgebung oder dieses Experiment erlaubt? | Macht Governance prüfbar statt implizit. |
Diese Reihenfolge verhindert einen häufigen Routing-Fehler: Jedes Modell als austauschbar zu behandeln. Das sind sie nicht. Die Kompatibilität muss für den exakten Endpunkt und die Traffic-Klasse nachgewiesen werden, die Sie weiterleiten möchten.
2. Die zulässigen Kandidaten bewerten
Nach dem Filtern kann eine Route eine transparente gewichtete Bewertung verwenden. Ein einfaches Muster lautet:
route score =
  quality_weight × expected_quality
  + latency_weight × (1 - normalized_latency)
  + cost_weight × (1 - normalized_cost)
  + reliability_weight × recent_route_health
Diese Formel ist ein Entscheidungsrahmen, kein universeller Benchmark. Entscheidend ist, dass die Terme konsistent normalisiert werden, die Gewichtungen zu einer Traffic-Klasse gehören und die Richtlinie nach einem Vorfall erklärt werden kann.
Beispielsweise kann ein Hintergrundauftrag zur Verschlagwortung Kosten und Durchsatz stärker gewichten. Ein kundenorientierter Support-Agent kann Qualität, Tool-Kompatibilität und Tail-Latenz stärker gewichten. Ein regulierter Workflow kann Datenresidenz als absoluten Filter statt als Bewertung behandeln.
3. Ausführen, beobachten und einen begrenzten Fallback verwenden
Der Router sollte die ausgewählte Route, die Eingaben für die Bewertung, die Richtlinienversion, die Anfrage-ID, die Latenz, die Kostenschätzung oder den Nutzungsdatensatz sowie den Ergebnisstatus protokollieren. Wenn die primäre Route fehlschlägt, benötigt die Fallback-Entscheidung eigene Regeln:
- Ist der Fehler vorübergehend genug für einen Wiederholungsversuch auf derselben Route?
- Ist die Anfrage idempotent, oder könnte ein Wiederholungsversuch eine externe Aktion duplizieren?
- Bewahrt der Fallback den Ausgabe- und Tool-Vertrag?
- Darf der Fallback das Budget oder die Datengrenze der Anfrage überschreiten?
- Falls nicht, sollte das System die Anfrage in eine Warteschlange stellen, kontrolliert degradieren oder stattdessen einen kontrollierten Fehler zurückgeben?
Deshalb ist Fallback eine Routing-Technik und kein Synonym für Routing. Unser Playbook zur Model-Fallback-Strategie behandelt die Wiederherstellungsentscheidungen ausführlicher.
Sechs LLM-Routing-Techniken für den gezielten Einsatz
Es gibt nicht den einen besten Router. Beginnen Sie mit der einfachsten Technik, die den Workload erfüllen kann, und fügen Sie Komplexität hinzu, wenn Ihre Messungen dies rechtfertigen.
1. Statisches Routing
Jede Anfrage in einem Workload geht an ein bestimmtes Modell oder einen bestimmten Endpunkt.
Verwenden Sie es, wenn: Sie eine Baseline etablieren, ein stabiles Evaluierungsziel benötigen oder einen eng abgegrenzten Workload mit einem genehmigten Modell haben.
Achten Sie auf Folgendes: Eine statische Route kann die Kosten für den Einsatz eines leistungsstarken Modells bei trivialen Aufgaben oder das Zuverlässigkeitsrisiko der Abhängigkeit von einem einzigen Upstream-Pfad verbergen.
2. Regelbasiertes Routing
Explizite Bedingungen wählen eine Route aus: Anfragen mit Bildern werden an einen visionfähigen Pfad gesendet; Anfragen mit Tool-Aufrufen werden nur an Modelle gesendet, die den genehmigten Tool-Vertrag unterstützen; interne Batch-Zusammenfassungen werden an eine kostengünstige Route gesendet.
Verwenden Sie es, wenn: die Entscheidung anhand von Anfrage-Metadaten erklärbar ist und die Regeln wenige genug sind, um sie zu überprüfen.
Achten Sie auf Folgendes: eine Ausuferung von Regeln. Legen Sie Regeln in einer versionierten Richtliniendatei oder einem Service ab, statt Provider-Prüfungen im gesamten Anwendungscode zu verteilen.
3. Fähigkeitsbasiertes Routing
Der Router beginnt mit einem Register für Modellfähigkeiten statt allein mit Prompt-Text. Er filtert nach Endpunktfamilie, Kontext, unterstützten Modalitäten, Tool-Verhalten, Unterstützung strukturierter Ausgaben, Region und Kontoberechtigung.
Verwenden Sie es, wenn: eine Anwendung mehrere Endpunkttypen oder Modelle mit wesentlich unterschiedlichen Verträgen hat.
Achten Sie auf Folgendes: veraltete Katalogdaten. Behandeln Sie Modell-IDs, Fähigkeiten und Abkündigungen als Betriebsdaten, die regelmäßig überprüft werden müssen.
4. Gewichtetes Routing nach Kosten, Qualität, Latenz und Zuverlässigkeit
Zulässige Routen erhalten eine Bewertung auf Grundlage des aktuellen Ziels. Dies ist die gängige Antwort auf was ist LLM-Routing, wenn ein Team mehr Nuancen als bei einer festen Regel wünscht, aber dennoch eine erklärbare Richtlinie benötigt.
Verwenden Sie es, wenn: Sie ein messbares Akzeptanzsignal definieren können und genügend Routen-Telemetrie haben, um Kandidaten zu vergleichen.
Achten Sie auf Folgendes: Scheingenauigkeit. Eine Bewertung ist nur so nützlich wie die Qualitätsdaten, Kostenannahmen, Zustandssignale und Gewichtungen dahinter. Erwecken Sie nicht den Eindruck, dass eine Dezimalbewertung beweise, ein Modell sei universell besser.
5. Klassifikatorbasiertes Routing
Ein kleiner Klassifikator oder ein LLM-basierter Klassifikator kennzeichnet die Anfrage – etwa als einfache Extraktion, Codegenerierung, komplexes Schlussfolgern oder sicherheitssensiblen Inhalt – und übergibt sie dann an eine vordefinierte Richtlinie für diese Klasse.
Verwenden Sie es, wenn: die Prompt-Absicht die geeignete Modellstufe stark vorhersagt und Sie Klassifikatorfehler getrennt von Modellfehlern bewerten können.
Achten Sie auf Folgendes: eine undurchsichtige Entscheidung vor dem Modellaufruf hinzuzufügen. Behalten Sie einen Pfad für geringe Konfidenz bei, protokollieren Sie die Klassifikation und bewerten Sie den Klassifikator anhand repräsentativer Anfragen.
6. Zustandsbewusstes Fallback-Routing
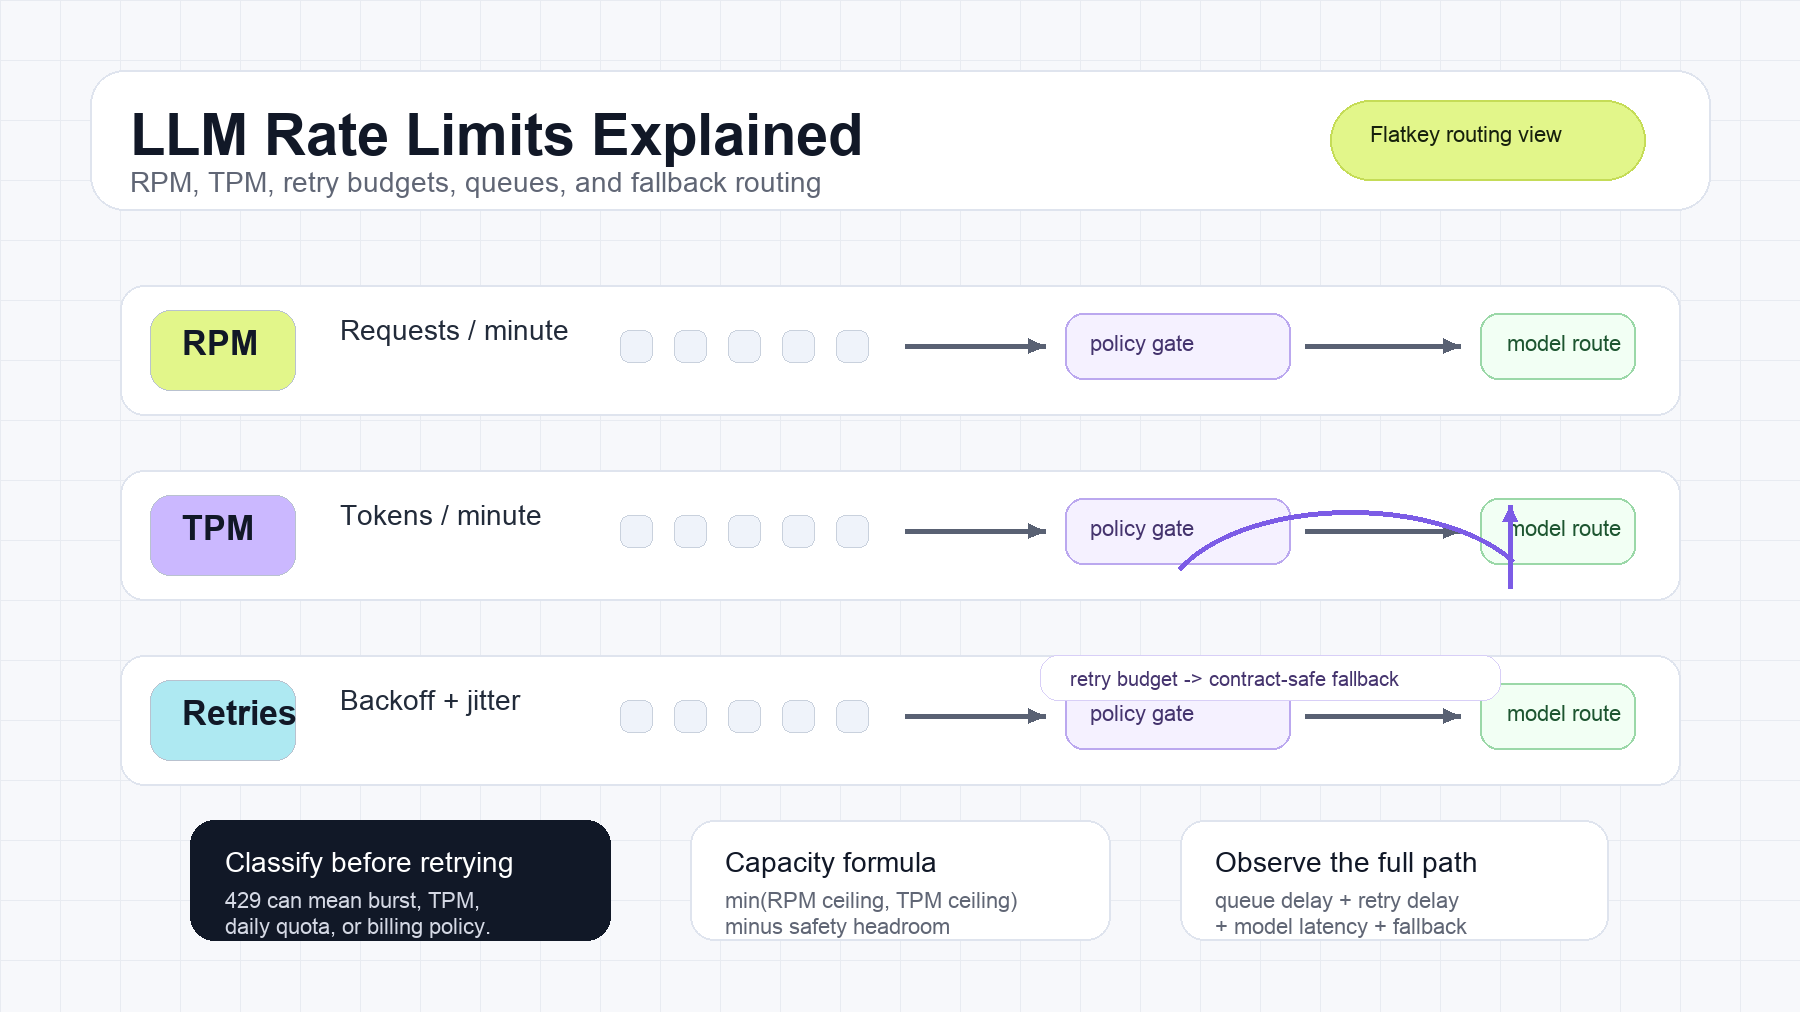
Der primäre Pfad wird normal ausgewählt, aber der Router reagiert auf Timeouts, Überlastung, Ratenlimits oder einen beeinträchtigten Zustand mit einem begrenzten Wiederholungsversuch, einer gleichwertigen Sicherungsoption, einer Warteschlange oder einem kontrollierten Fehlschlag.
Verwenden Sie es, wenn: Verfügbarkeit wichtig ist und Sie festgestellt haben, welche Sicherungsoptionen vertragskompatibel sind.
Achten Sie auf Folgendes: eine semantische Grenze stillschweigend zu überschreiten. Ein Fallback kann für eine wiederholbare Textvervollständigung angemessen sein, nicht jedoch für einen Tool-verwendenden Agenten, einen zustandsändernden Workflow oder eine Ausgabe, die einem strengen Schema entsprechen muss. In unserem Leitfaden zum Routing multimodaler Agenten finden Sie Beispiele, bei denen Änderungen der Modalität die Fallback-Regeln strenger machen.
Eine kostenbewusste Richtlinie entwickeln, ohne die Qualität aus den Augen zu verlieren
Kostenbewusst bedeutet nicht „immer das günstigste Modell auswählen“. Es bedeutet, Kosten eine definierte Rolle zu geben, nachdem erforderliche Fähigkeiten sowie Richtlinien- und Vertragsprüfungen bestanden wurden.
Ein hilfreiches Muster besteht darin, vor dem Festlegen von Gewichtungen Verkehrsklassen zu erstellen:
| Traffic-Klasse | Erste Priorität | Gängiger Routing-Ansatz | Sichere Fallback-Strategie |
|---|---|---|---|
| Kundenorientierter Assistent | Qualität und vorhersehbarer Vertrag | Fähigkeitsfilter + Qualitäts-/Latenzgewichtungen | Nur gleichwertige genehmigte Route |
| Extraktion im Hintergrund | Durchsatz und Stückkosten | Regeln + Kosten-/Latenzgewichtungen | Wiederholen, in Warteschlange einreihen oder genehmigte kostengünstigere Route |
| Evaluierungssuite | Reproduzierbarkeit | Modell- und Richtlinienversion festlegen | In der Regel kein versteckter Fallback |
| Tool-nutzender Agent | Tool-Kompatibilität und Idempotenz | Fähigkeitsfilter + Risikoregeln | Bei unsicheren Nebenwirkungen anhalten und abgleichen |
| Mediengenerierung | Endpunkt- und Ausgabeanforderungen | Modalitäts-/Endpunktfilter + Budgetregeln | Geschlossen fehlschlagen, sofern der Backup nicht getestet wurde |
Vergleichen Sie dann die entscheidende Kennzahl: Kosten pro akzeptiertem Ergebnis, nicht nur die Kosten pro Anfrage. Eine günstigere Route, die zusätzliche Wiederholungen, menschliche Prüfung, Schema-Reparaturen oder fehlgeschlagene Tool-Aufrufe verursacht, kann pro abgeschlossener Aufgabe mehr kosten.
Die Routing-Dokumentation von Amazon weist im gleichen praktischen Sinne auf einen Vorbehalt hin: Automatisiertes Routing hat Grenzen, einschließlich routenspezifischer Trainingsdaten und Support-Grenzen. Sie empfiehlt eine fortlaufende Überprüfung von Leistung und Kosten, statt anzunehmen, dass eine Routing-Entscheidung dauerhaft optimal bleibt. Ihre eigene Richtlinie sollte anhand Ihres eigenen Anfrage-Mix bewertet werden.
Eine sichere Routing-Richtlinie in Pseudocode
Dieses vereinfachte Beispiel hält die Entscheidung nachvollziehbar. Es setzt nicht voraus, dass jede Route jede Anfrage verarbeiten kann.
const candidates = catalog
  .filter(route => route.isHealthy)
  .filter(route => route.supports(request.modality))
  .filter(route => route.supportsTools(request.requiredTools))
  .filter(route => route.allows(request.dataClass))
  .filter(route => route.withinBudget(request.budget));

if (candidates.length === 0) {
  return failClosed("No approved route for this request");
}

const primary = candidates
  .map(route => ({
    route,
    score: score(route, request.trafficClass),
  }))
  .sort((a, b) => b.score - a.score)[0];

const result = await call(primary.route, request);

if (isTransient(result.error) && request.isIdempotent) {
  return retryWithinBudget(primary.route, request);
}

if (canUseEquivalentFallback(result.error, request, primary.route)) {
  return call(selectApprovedFallback(candidates, primary.route), request);
}

return returnControlledError(result.error);
Die Richtlinie sollte einen Routing-Grund wie tool_contract_required, budget_preferred, primary_unhealthy oder no_contract_safe_fallback ausgeben. Dieses kleine Detail macht das System deutlich leichter zu debuggen als eine allgemeine Meldung wie „Modell fehlgeschlagen“.
So messen Sie, ob LLM-Routing hilft
Routing ist nicht erfolgreich, weil es einen Modellnamen ausgegeben hat. Es ist erfolgreich, wenn es ein definiertes Arbeitsergebnis verbessert, ohne unvertretbare Risiken zu schaffen.
Verfolgen Sie Ergebnisse nach Traffic-Klasse, Richtlinienversion und ausgewählter Route:
- Rate akzeptierter Ergebnisse: der Anteil der Antworten, die den Akzeptanztest für Geschäftszwecke, Schema oder menschliche Prüfung bestehen.
- Kosten pro akzeptiertem Ergebnis: gesamte Modell-, Wiederholungs- und Behebungskosten, geteilt durch akzeptierte Aufgaben.
- P50-, P95- und P99-Latenz: segmentiert nach Anfragegröße und Route; ein Durchschnittswert kann schmerzhafte Latenz am langen Ende verbergen.
- Fallback-Wiederherstellungsrate: wie oft ein Fallback ein akzeptables Ergebnis erzeugt, nicht nur einen HTTP-200-Status.
- Vertragsfehlerquote: ungültige strukturierte Ausgabe, nicht unterstützte Tools, Streaming-Inkompatibilität oder fehlende Pflichtfelder.
- Routenverteilung: ob eine neue Richtlinie unerwartet den Großteil des Traffics an einen teuren oder beeinträchtigten Pfad sendet.
- Richtlinien-Ablehnungsrate: wie oft kein sicherer Kandidat vorhanden ist – häufig ein Signal, genehmigte Fähigkeiten zu erweitern, statt eine Schutzmaßnahme zu lockern.
Eine praktische Scorecard finden Sie unter KI-Routing-API-Metriken, die tatsächlich zählen. Die Metriken sind besonders nützlich, wenn eine Routing-Änderung die Token-Kosten zu senken scheint, aber die akzeptierten Ergebnisse reduziert.
Wann benötigen Sie LLM-Routing?
Möglicherweise benötigen Sie keinen Router, wenn ein Anbieter, ein Endpunkt und eine stabile Arbeitslast Ihre Anforderungen erfüllen. Legen Sie das Modell fest, setzen Sie klare Timeouts und Wiederholungen und messen Sie zuerst die Ausgangsbasis.
LLM-Routing wird wertvoll, wenn mindestens eine dieser Aussagen zutrifft:
- Verschiedene Anfragetypen benötigen unterschiedliche Fähigkeiten, Kostenrahmen oder Latenzziele.
- Sie müssen Anbieter-, Modell- und Regionsauswahl hinter einer Richtliniengrenze halten.
- Ein Ausfall, ein Kontingentproblem oder eine Einstellung erfordert einen sicheren Reaktionspfad.
- Sie möchten Kandidaten vergleichen, ohne jeden Aufrufer neu zu schreiben.
- Sie benötigen einen Nachweis darüber, welche Route eine Anfrage verarbeitet hat und warum.
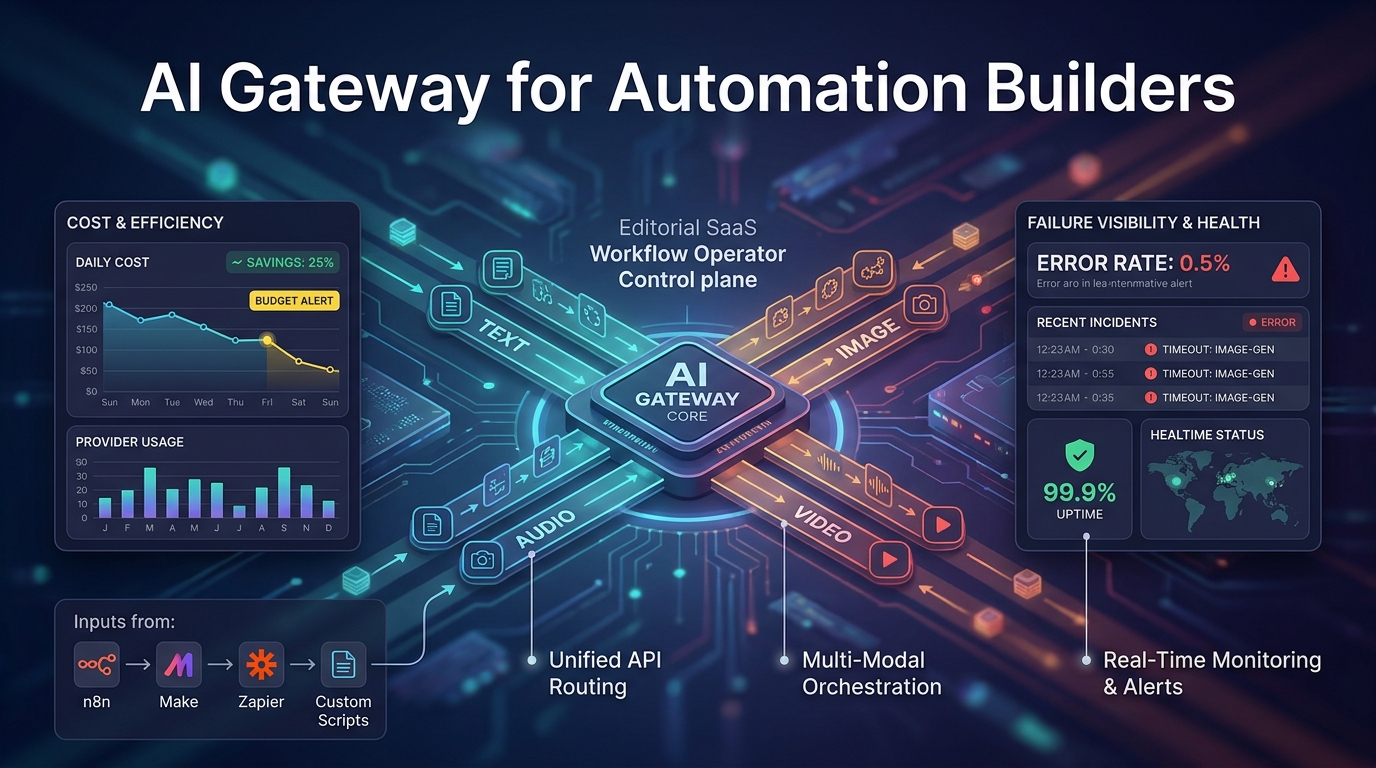
Wenn das nach Ihrem Stack klingt, kann ein Gateway die Betriebsgrenze leichter verwaltbar machen. Die Dokumentation von Flatkey beschreibt eine OpenAI-kompatible Basis-URL und einen einzelnen API-Schlüssel für unterstützte Modelle; Aufrufer wählen pro Anfrage eine Modell-ID, während die Plattform automatisches Upstream-Failover dokumentiert. Beginnen Sie damit, ein Modell festzulegen und Ergebnisse zu protokollieren, und führen Sie dann eine explizite Routing-Richtlinie für die Traffic-Klassen ein, die sie tatsächlich benötigen. Lesen Sie für den nächsten architektonischen Schritt unsere Checkliste der Anforderungen an ein KI-API-Gateway.
Lesen Sie unseren Leitfaden zum Modell-Routing, um Routing-Strategien, eine Richtlinienvorlage und Produktionscode kennenzulernen.
Häufig gestellte Fragen
Was ist LLM-Routing im Vergleich zu Modell-Fallback?
LLM-Routing ist der umfassendere Entscheidungsprozess zur Auswahl eines Ausführungspfads. Ein Modell-Fallback ist eine Wiederherstellungsmaßnahme innerhalb dieses Prozesses, die nur verwendet wird, wenn die primäre Route fehlschlägt und eine alternative Route für denselben Anfragevertrag freigegeben ist.
Was ist LLM-Routing in einer API mit mehreren Anbietern?
In einer API mit mehreren Anbietern kann LLM-Routing sowohl einen Anbieterpfad als auch ein Modell auswählen. Die Richtlinie sollte Endpunktkompatibilität, Datenrichtlinien, Modellfähigkeiten, Preiseinheiten, Zustand und Fallback-Verhalten prüfen, bevor zwei Anbieter als gleichwertig behandelt werden.
Mit welcher LLM-Routing-Technik sollte ein neues Team beginnen?
Beginnen Sie mit statischem Routing sowie expliziten Fähigkeitsprüfungen und Observability. Fügen Sie Regeln für klar unterschiedliche Traffic-Klassen hinzu. Wechseln Sie erst zu gewichtungs- oder klassifikatorbasiertem Routing, wenn Sie repräsentative Tests und eine Möglichkeit zur Messung akzeptierter Ergebnisse haben.
Kann ein LLM-Router automatisch das günstigste Modell auswählen?
Das kann er, aber Kosten sollten harte Einschränkungen niemals umgehen. Filtern Sie zuerst nach freigegebener Fähigkeit und Vertrags-kompatibilität und optimieren Sie dann den Preis unter den geeigneten Routen. Validieren Sie das Ergebnis anhand der Kosten pro akzeptiertem Ergebnis, nicht allein anhand des Token-Preises.
Die praktische Antwort auf „Was ist LLM-Routing?“
Die praktische Antwort auf was LLM-Routing ist, lautet nicht: „Wählen Sie ein cleveres Modell.“ Sie lautet: „Kodieren Sie die Entscheidungen, die Ihr Team vertreten kann.“ Beginnen Sie mit freigegebenen Fähigkeiten und harten Einschränkungen; verwenden Sie Gewichtungen nur für echte Zielkonflikte; halten Sie Fallbacks begrenzt und vertragssicher; und zeichnen Sie jede Entscheidung gut genug auf, um sie später verbessern zu können.
Wenn Sie den Modellzugriff zentralisieren, nutzen Sie diese Grenze, um kontrollierte Routing-Experimente durchzuführen, statt Anbieterlogik über jeden Service zu verteilen. Erfahren Sie mehr in der Flatkey-API-Dokumentation.