Grok 4.3 vs. GPT-5: Benchmarks, Preise und wann welches Modell geroutet werden sollte
Grok 4.3 vs. GPT-5: Benchmarks, Preise und wann welches Modell geroutet werden sollte ist im Oktober 2026 eine Frage des Routings von Legacy-Modellen. OpenAI hat die Entfernung der Modell-ID gpt-5 und des Snapshots gpt-5-2025-08-07 für den 11. Dezember 2026 geplant. Die Migrationstabelle verweist auf gpt-5.6-sol, während die aktuelle Modellberatung GPT-6 Astra für neue komplexe Reasoning- oder Coding-Workloads empfiehlt. In den Release Notes von xAI wird nun Grok 4.7 als aktuelle Frontier-Grok-Route aufgeführt. Dennoch müssen viele Teams Grok 4.3 und GPT-5 vergleichen, weil ältere Agenten, Dashboards, Benchmarks und Beschaffungsnotizen auf diesen Namen basieren.
Die Kurzantwort: Verwenden Sie Grok 4.3 zuerst, wenn ein Workload von seinem niedrigeren ausgewiesenen Output-Preis, dem größeren dokumentierten Kontextfenster und den mit xAI kompatiblen Reasoning-Steuerungen profitiert. Verwenden Sie GPT-5 zuerst, wenn Ihre Anwendung auf OpenAI-nativem Responses-API-Verhalten, gehosteten Tools, Prompt-Caching, Chat-Completions-Kompatibilität oder einer bestehenden OpenAI-Evaluierungsbasis beruht. Verwenden Sie einen Router, wenn das eigentliche Problem nicht allein die Modellqualität ist, sondern das Wechseln zwischen Modellen, ohne Schlüssel, Rechnungen, Logs und Fallback-Code über jeden Dienst zu verteilen.
Treffen Sie diese Entscheidung nicht allein anhand öffentlicher Benchmark-Bezeichnungen. Vergleichen Sie die Modelle mit Ihrem Workload und routen Sie dann nach Kosten pro akzeptiertem Output.
Schnellvergleich: Grok 4.3 vs. GPT-5
| Entscheidungsbereich | Grok 4.3 | GPT-5 | Routing-Hinweis |
|---|---|---|---|
| Aktualitätsstatus | Ältere Grok-Route; in den xAI-Release-Notes wird nun Grok 4.7 als aktuell hervorgehoben. | Veraltet; OpenAI plant die Entfernung von gpt-5 und gpt-5-2025-08-07 am 11. Dezember 2026. |
Behandeln Sie beide als Legacy-Routen; planen Sie die GPT-5-Migration vor dem Entfernungsdatum. |
| Modell-ID | grok-4.3, Alias grok-4.3-latest. |
gpt-5, Standard-Snapshot gpt-5-2025-08-07. |
Fixieren Sie für reproduzierbare Tests die exakte Modell-ID oder den Snapshot. |
| Input und Output | Text- und Bildeingabe; Textausgabe. | Text- und Bildeingabe; Textausgabe. | Beide eignen sich für textbasierte Workflows mit visueller Unterstützung; keines ist eine Video-Route. |
| Kontext | xAI gibt ein Kontextfenster von 1 Mio. an, mit Long-Context-Preisen ab 200.000 Prompt-Tokens. | OpenAI gibt ein Kontextfenster von 400.000, maximal 272.000 Input-Tokens und maximal 128.000 Output-Tokens an. | Testen Sie den nutzbaren Kontext, nicht nur die prominente Kontextzahl. |
| Ausgewiesener Textpreis | 1,25 $ / 0,20 $ gecacht / 2,50 $ Output pro 1 Mio. Tokens unter 200.000 Prompt-Tokens; 2,50 $ / 0,40 $ / 5,00 $ bei 200.000+ Prompt-Tokens. | 1,25 $ / 0,125 $ gecacht / 10 $ Output pro 1 Mio. Tokens. | Grok 4.3 ist beim ausgewiesenen Output-Preis günstiger; GPT-5 hat günstigeren gecachten Input. |
| Batch | xAI kennzeichnet Grok 4.3 als Batch-fähig mit 20 % Batch-Rabatt. | OpenAI kennzeichnet GPT-5 Batch als unterstützt. | Batch hilft nur, wenn eine verzögerte Antwort akzeptabel ist. |
| Tools | In der xAI-Dokumentation werden Function Calling, strukturierte Outputs, Reasoning und Optionen für den Reasoning-Aufwand aufgeführt. | In der OpenAI-Dokumentation werden Streaming, strukturierte Outputs, Function Calling, Dateisuche, Bildeingabe, Websuche, Prompt-Caching und unterstützte Responses-API-Tools aufgeführt. | GPT-5 ist in der Regel stärker, wenn von OpenAI gehostete Tools Teil der Anforderung sind. |
Das ist der praktische Benchmark-Ausgangspunkt für Grok 4.3 vs. GPT-5: Benchmarks, Preise und wann welches Modell geroutet werden sollte. Die öffentlichen Spezifikationen deuten auf unterschiedliche Kosten- und Kontextprofile hin, doch in der Produktion gewinnt die Route, die Ihren Validator zu den niedrigsten Kosten pro akzeptiertem Output besteht.
Benchmarken Sie die Route, nicht den Modellnamen
Öffentliche Modell-Ranglisten sind für die Orientierung nützlich, beantworten aber selten die Produktionsfrage. Ein Benchmark-Score sagt Ihnen nicht, ob eine Route Ihr exaktes Schema beibehält, sich von Rate Limits erholt, die Nutzung am richtigen Ort protokolliert oder nach Wiederholungsversuchen innerhalb des Budgets bleibt.
Stellen Sie vor der Verkehrsverlagerung ein kleines Benchmark-Paket zusammen:
| Benchmark-Bereich | Was getestet werden sollte | Warum dies die Route verändert |
|---|---|---|
| Reasoning und Coding | 50–200 echte Prompts aus Agenten-, Coding-, Analyse- oder Support-Workflows. | Ein Gewinn in einem allgemeinen Benchmark lässt sich möglicherweise nicht auf Ihre Prompt-Struktur übertragen. |
| Strukturierter Output | Erforderliches JSON-Schema, Enum-Felder, verschachtelte Objekte und Fälle ungültiger Eingaben. | Das Modell, das bessere Prosa schreibt, kann dennoch an Ihrem Parser scheitern. |
| Tool-Aufrufe | Fälle für erforderliches Tool, kein Tool, falsches Tool und Tool-Fehler. | Eine fehlerhafte Aktion kann mehr kosten als ein höherer Token-Preis. |
| Langer Kontext | p50-, p90- und Worst-Case-Retrieval-Pakete. | Ein großes Kontextfenster ist nicht dasselbe wie zuverlässiger Abruf. |
| Kosten | Input-Tokens, gecachte Tokens, Output-Tokens, Batch-Modus, Wiederholungsversuche und abgelehnte Outputs. | Der ausgewiesene Token-Preis ist ohne Akzeptanzrate unvollständig. |
| Latenz | Zeit bis zum ersten Token, vollständige Antwortlatenz, Timeout-Rate und Queueing-Verhalten. | Nutzerorientierte Agenten benötigen möglicherweise eine schnellere Route, selbst wenn sie mehr kostet. |
| Fallback | Provider-Fehler, 429, Modell nicht gefunden, Schema-Fehler, Timeout und beeinträchtigter Output. |
Eine Route ohne Rollback-Regel ist nicht produktionsreif. |
Die Routenmetrik sollte lauten:
cost_per_accepted_output =
  (input_cost + cached_input_cost + output_cost + tool_cost + retry_cost + fallback_cost)
  / accepted_outputs
Verwenden Sie Grok 4.3, wenn es diese Formel für einen Workload mit ausreichend Qualitäts- und Latenzspielraum gewinnt. Verwenden Sie GPT-5, wenn OpenAI-natives Verhalten Implementierungsrisiken, Validierungsfehler oder Integrationskosten ausreichend reduziert, um den ausgewiesenen Output-Preis auszugleichen.
Preise: Wo Grok 4.3 günstiger ist und GPT-5 dennoch gewinnen kann
Für Textanfragen mit kurzem Kontext listet xAI Grok 4.3 mit 1,25 $ für Input, 0,20 $ für zwischengespeicherten Input und 2,50 $ für Output pro 1 Mio. Token. Ab 200.000 Prompt-Token listet xAI höhere Preise für langen Kontext: 2,50 $ für Input, 0,40 $ für zwischengespeicherten Input und 5,00 $ für Output pro 1 Mio. Token. xAI kennzeichnet Grok 4.3 außerdem als batchfähig mit einem Batch-Rabatt von 20 %.
OpenAI listet GPT-5 mit 1,25 $ für Input, 0,125 $ für zwischengespeicherten Input und 10 $ für Output pro 1 Mio. Token. Damit ist GPT-5 bei den ausgewiesenen Output-Token teurer, aber bei zwischengespeichertem Input günstiger als in der Kurzkontext-Zeile für zwischengespeicherten Input von Grok 4.3.
Die Preisentscheidung ändert sich mit der Form des Workloads:
| Workload-Form | Preisdruck | Wahrscheinlicher erster Test |
|---|---|---|
| Kurzer Prompt, lange generierte Antwort | Der Output-Preis dominiert. | Testen Sie zuerst Grok 4.3 und vergleichen Sie dann die Akzeptanzrate der Outputs. |
| Wiederholter großer System-Prompt oder Richtlinienpaket | Zwischengespeicherter Input ist wichtig. | Testen Sie beide; der zwischengespeicherte Input von GPT-5 kann bei hoher Cache-Trefferquote relevant sein. |
| Langes Retrieval-Paket mit über 200.000 Prompt-Token | Preise für langen Kontext gelten. | Testen Sie Grok 4.3 unter Einbeziehung des Preises für langen Kontext und der Latenz. |
| OpenAI-gehostete Tools oder ein Responses-API-Workflow | Tool- und Integrationsverhalten sind wichtig. | Testen Sie zuerst GPT-5, da direkte Feature-Unterstützung die App-Komplexität verringern kann. |
| Offline-Evaluierungen oder Backfills | Batch-Ökonomie ist wichtig. | Testen Sie beide Batch-Pfade, wenn verzögerte Fertigstellung akzeptabel ist. |
Wenn Sie nur den ausgewiesenen Input-Preis vergleichen, wird Grok 4.3 vs. GPT-5: Benchmarks, Preise und wann welches Modell geroutet werden sollte zu einer irreführenden Tabellenkalkulationsübung. Output-Länge, Wiederholungsrate, Tool-Fehler und menschliche Prüfung können die scheinbaren Einsparungen zunichtemachen.
Wann zu Grok 4.3 geroutet werden sollte
Beginnen Sie mit Grok 4.3, wenn der Workload kostensensitiv, outputlastig und nicht an OpenAI-native Tools gebunden ist.
Gute Kandidaten sind:
- Interne Analyseaufgaben, bei denen der Textoutput lang und die Validierung unkompliziert ist.
- Zusammenfassungen mit langem Kontext, bei denen das dokumentierte Kontextfenster von 1 Mio. Token nützlich ist und der Preis für langen Kontext weiterhin Alternativen unterbietet.
- Evaluierungsjobs, bei denen Batch akzeptabel ist und ein Batch-Rabatt von 20 % gilt.
- Workflows, die Function Calling oder strukturierte Outputs verwenden, aber keine OpenAI-gehosteten Tools erfordern.
- Modellexperimente, bei denen Sie eine Grok-Familienroute zum Vergleich mit GPT, Claude, Gemini, DeepSeek oder Qwen wünschen.
Überprüfen Sie vor dem Launch die genaue Grok-Route in der Provider-Konsole oder im Gateway-Katalog. xAI verfügt über neuere Grok-Routen, und Flatkeys aktuelle lokale Wissensbasis bestätigt grok-4.2 statt grok-4.3. Gehen Sie daher nicht davon aus, dass Grok 4.3 über ein Gateway verfügbar ist, bevor der Live-Katalog dies bestätigt.
Wann zu GPT-5 geroutet werden sollte
Beginnen Sie mit GPT-5, wenn der Workload von der API-Oberfläche von OpenAI abhängt oder Ihre Evaluierungshistorie GPT-5 bereits als Baseline verwendet.
Gute Kandidaten sind:
- Bestehende Anwendungen mit OpenAI Chat Completions oder Responses API, die nicht für ein Modellexperiment umgeschrieben werden sollten.
- Workloads, die OpenAI-gehostete Tools wie Websuche, Dateisuche, Bildgenerierung, Code Interpreter oder MCP über die Responses API verwenden.
- Produkte, die auf OpenAI Prompt Caching, strukturierten Outputs, Streaming oder OpenAI-spezifischen Projektsteuerungen beruhen.
- Regressionstests, bei denen frühere GPT-5-Snapshots Teil der Akzeptanz-Baseline sind.
- Migrationsaudits, bei denen GPT-5 die stabile Referenzroute vor dem Wechsel zu einem neueren Modell ist.
Zeitgebundener Hinweis: OpenAI plant, gpt-5 und gpt-5-2025-08-07 am 11. Dezember 2026 zu entfernen. Verwenden Sie diesen Vergleich zur Validierung von Migrationen, nicht als Standard für neue Deployments. Das dokumentierte Migrationsziel ist gpt-5.6-sol; die aktuelle Modellberatung von OpenAI empfiehlt GPT-6 Astra für einen neuen komplexen Reasoning- oder Coding-Workload.
OpenAI dokumentiert GPT-5 als vorheriges Modell. Wenn Sie ein neues Projekt starten, vergleichen Sie auch das aktuell von OpenAI empfohlene Modell. GPT-5 kann weiterhin nützlich sein, wenn eine festgepinnte Legacy-Route zur Debatte steht, sollte jedoch ohne aktuelle Modellprüfung nicht als Standardantwort für neue Entwicklungen betrachtet werden.
Wann ein Router die bessere Lösung ist
Teams fragen oft, ob Grok 4.3 oder GPT-5 besser ist, doch der tatsächliche Engpass ist die operative Zersplitterung:
- Getrennte Provider-Schlüssel.
- Getrennte Dashboards und Rechnungen.
- Getrennte Rate-Limit-Richtlinien.
- Getrennte Statusprüfungen.
- Getrennte Nutzungs-Exporte.
- Unterschiedliche Modell-IDs, die über Agents und Services hinweg fest codiert sind.
- Keine gemeinsame Fallback-Regel, wenn ein Provider beeinträchtigt ist.
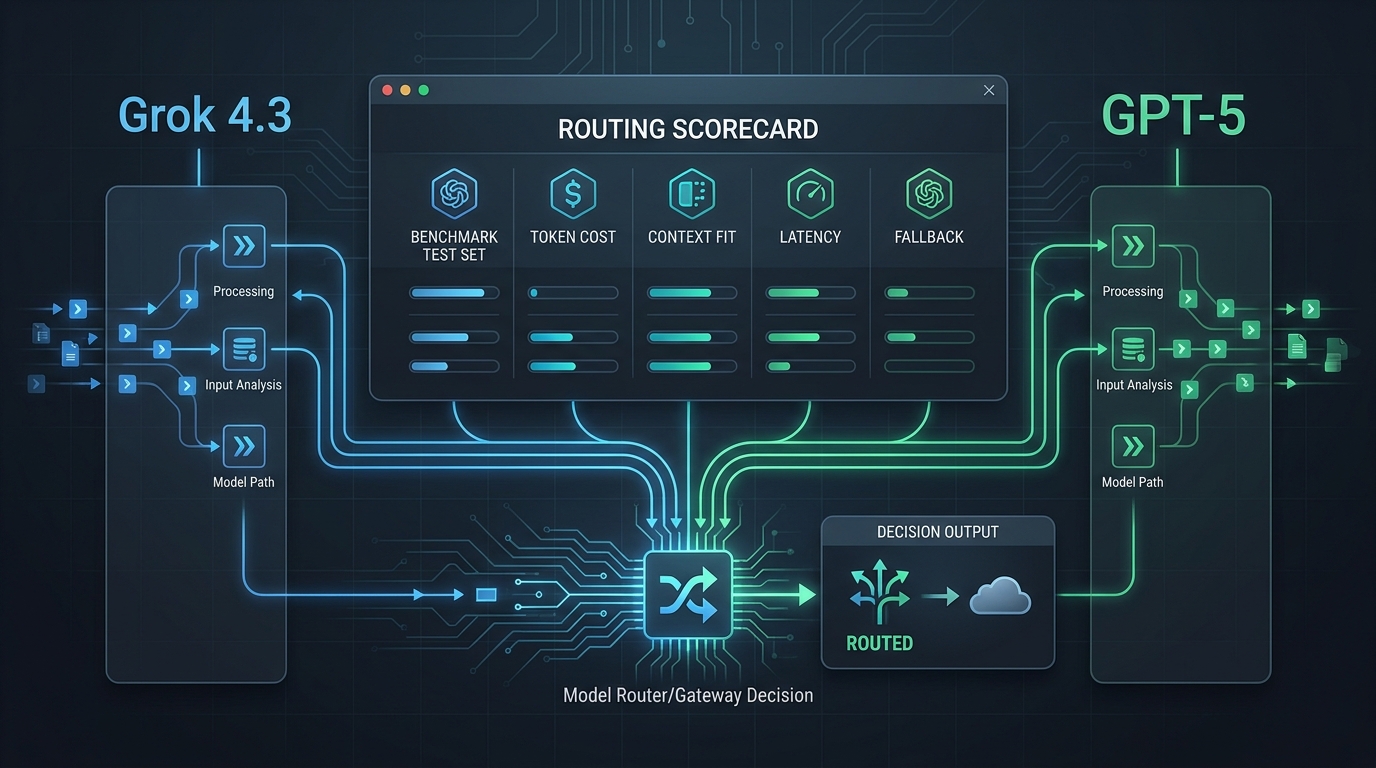
Die Positionierung von Flatkey ist auf diese Ebene ausgerichtet: ein Schlüssel, ein Guthaben, eine Rechnung, offizieller Modellzugang, Nutzungsprotokolle und ein OpenAI-kompatibler Router. Das bedeutet nicht, dass jedes Provider-native Feature automatisch über jede Route funktioniert. Es bedeutet, dass das Team eine einheitliche Betriebsoberfläche erhält, um unterstützte Modelle zu vergleichen und Nutzungsnachweise zu prüfen.
Kombinieren Sie diesen Artikel mit dem Leitfaden zum KI-Modellkatalog, dem Framework für Metriken für KI-Routing-APIs und dem Flatkey-API-Schnellstart, bevor Sie den Produktions-Traffic ändern.
Eine praktische Routing-Scorecard
Verwenden Sie diese Scorecard für Grok 4.3 vs GPT-5: Benchmarks, Preise und wann welches Modell geroutet werden sollte. Bewerten Sie jede Route für dieselbe Arbeitslast auf einer Skala von 1 bis 5.
| Kriterium | Gewichtung | Grok 4.3 | GPT-5 | Hinweise |
|---|---|---|---|---|
| Akzeptierte Ausgaberate | 25% | Besteht die Antwort Ihren Validator oder Ihre Bewertungsrubrik? | ||
| Kosten pro akzeptierter Ausgabe | 20% | Berücksichtigen Sie Prompt-Größe, Ausgabelänge, Cache, Batch, Tools, Wiederholungsversuche und abgelehnte Ausgaben. | ||
| Zuverlässigkeit von Tools und Schemas | 15% | Zählen Sie ungültiges JSON, falsche Tool-Aufrufe, fehlende Felder und nicht unterstützte Parameter. | ||
| Kontextzuverlässigkeit | 15% | Testen Sie p50-, p90- und Worst-Case-Retrieval-Pakete. | ||
| Latenz und Timeouts | 10% | Messen Sie TTFT, die vollständige Abschlusszeit und die Timeout-Rate. | ||
| Beobachtbarkeit | 10% | Können Entwicklung und Finanzen Anbieter, Modell, Tokens, Kosten, Latenz und Fehler prüfen? | ||
| Fallback-Bereitschaft | 5% | Ist der Rollback getestet und dokumentiert? |
Erstellen Sie anschließend einen Routeneintrag:
route_review:
  workload: support_case_summarization
  candidates:
    - grok-4.3
    - gpt-5
  required_features:
    - structured_output
    - streaming
    - usage_readback
  launch_rule:
    minimum_score: 4
    accepted_output_rate: ">= target set by owner"
    rollback_path_required: true
  stop_conditions:
    - schema_failure_rate_above_threshold
    - timeout_rate_above_threshold
    - cost_per_accepted_output_above_budget
Diese Richtlinie ist nützlicher als ein Screenshot einer Rangliste, weil sie Ihrer Anwendung vorgibt, was zu tun ist, wenn ein Modell nicht verfügbar, zu langsam, zu teuer oder für die Aufgabe ungeeignet ist.
Preflight-Checkliste vor der Umleitung von Traffic
Führen Sie diese Prüfungen durch, bevor Sie echte Nutzer zu einem der beiden Modelle routen:
- Modellverfügbarkeit bestätigen. Prüfen Sie am selben Tag, an dem Sie starten, die direkte Anbieter-Konsole und jeden Gateway-Katalog.
- Modell-IDs festlegen. Verwenden Sie
grok-4.3bewusst. Für bestehenden GPT-5-Traffic legen Siegpt-5-2025-08-07nur fest, während Sie eine validierte Migration abschließen; sowohl dieses als auchgpt-5sollen am 11. Dezember 2026 entfernt werden. - Endpoint-Familie verifizieren. Bestätigen Sie, ob die Arbeitslast xAI-kompatible Routen, OpenAI Chat Completions, OpenAI Responses, Batch- oder Gateway-Endpoints verwendet.
- Erforderliche Funktionen testen. Tools, strukturierte Ausgaben, Bildeingaben, Streaming, Caching und Batch sollten nur getestet werden, wenn Ihre Arbeitslast sie tatsächlich benötigt.
- Nutzbaren Kontext messen. Prüfen Sie Erinnerung und Zitierdisziplin bei realistischen Kontextgrößen.
- Kosten pro akzeptierter Ausgabe berechnen. Berücksichtigen Sie Wiederholungsversuche, abgelehnte Ausgaben und menschliche Überprüfung.
- Jede Route protokollieren. Erfassen Sie Anbieter, Modell, Request-ID, Eingabe-Tokens, Ausgabe-Tokens, Cache-Tokens, Latenz, Status und Kosten.
- Fallback definieren. Entscheiden Sie, wann Wiederholungsversuche erfolgen, Routen gewechselt, Anfragen in Warteschlangen gestellt, Ausgaben eingeschränkt oder Anfragen vollständig abgewiesen werden.
- Verantwortlichkeiten zuweisen. Übertragen Sie einer Person die Verantwortung für Schlüssel, Budget, Kontingent, Routenzustand und Rollback.
- Nach Modelländerungen erneut ausführen. Neue Grok- oder GPT-Releases können diesen Vergleich schnell veralten lassen.
Häufige Fragen: GPT-5.4- und GPT-5.5-Varianten
Was ändert sich, wenn der Vergleich Grok 4.3 vs. GPT-5.4 oder GPT-5.5 lautet?
Ersetzen Sie nicht einfach gpt-5.4 oder gpt-5.5 in der GPT-5-Spalte und gehen Sie von denselben Ergebnissen aus. Jede Modellversion hat ihre eigene Verfügbarkeit, ihren eigenen Preis, ihre eigenen Kontextlimits und ihren eigenen Migrationsstatus. Wenn Sie eine bestehende GPT-5-Arbeitslast migrieren, verwenden Sie diesen Vergleich, um die Evaluierung zu konzipieren, und vergleichen Sie anschließend Grok 4.3 mit dem exakt unterstützten OpenAI-Ersatz anhand Ihrer eigenen Prompts. Beginnen Sie bei einer neuen Implementierung mit den aktuellen Modellleitlinien von OpenAI statt mit der veralteten GPT-5-Modell-ID.
Quellenprüfungen, die Sie geöffnet lassen sollten
Nutzen Sie bei der Finalisierung einer Route die Live-Dokumentation:
- OpenAI-GPT-5-Modelldokumentation für GPT-5-Status, Snapshot, Kontext, Endpoints, Funktionen und Preisübersicht.
- OpenAI-API-Preise für aktuelle Preiszeilen für Text-Tokens sowie Hinweise zu Regionen und Schnellmodus.
- xAI-Modelle und Preise für Grok-4.3-Kontext, Preise, Batch, Modalitäten und Reasoning-Steuerung.
- xAI-Release-Notes für die Aktualität der aktuellen Grok-Modelle.
- Artificial-Analysis-Modellrangliste für Drittanbieter-Metriken zur Modellfindung, nicht als Ersatz für Ihre eigenen Routen-Benchmarks.
Fazit
Bei Grok 4.3 vs. GPT-5: Benchmarks, Preise und wann welches Modell geroutet werden sollte ist Grok 4.3 in der Regel der erste Preisvergleich, wenn Output-Token den größten Kostenanteil ausmachen und OpenAI-native Tools nicht erforderlich sind. GPT-5 ist in der Regel der erste Integrationstest, wenn Ihre Anwendung von der Responses API von OpenAI, gehosteten Tools, Prompt-Caching oder einer bestehenden GPT-5-Baseline abhängt.
Für den Produktionseinsatz sollten Sie beide Entscheidungen getrennt halten: Wählen Sie zuerst das Modell, das Ihren Workload besteht, und dann die Route, die Ihnen Logs, Kostenkontrolle, Fallback und einen sauberen Rollback-Pfad bietet. Hier zeigt ein einheitlicher Router seinen Wert.
Wenn Gemini ebenfalls auf Ihrer Liste steht, lesen Sie Grok vs Gemini (Oktober 2026) für einen Vergleich von Abonnement- und API-Preisen.