Optimisation des coûts IA (2026) : 9 façons de réduire vos dépenses en API LLM sans perdre en qualité
Optimiser les coûts IA consiste à réduire ce que vous payez pour chaque tâche IA réussie (et pas seulement pour chaque token) en envoyant chaque requête au modèle le moins cher qui satisfait vos critères de qualité, en réutilisant le contexte récurrent grâce à la mise en cache des prompts, en traitant les tâches non urgentes par lots, en plafonnant les sorties et en imposant des budgets par clé ou par équipe. Pour la plupart des produits reposant sur des API, les gains les plus importants viennent du routage et du cache : ensemble, ils peuvent diviser la facture par deux, voire davantage, lorsque les charges de travail s’y prêtent. Les autres gains reposent sur la visibilité et la gouvernance. Tous les prix ci-dessous proviennent des pages tarifaires officielles, vérifiées le 26 octobre 2026.
Ce guide s’adresse aux développeurs indépendants et aux équipes produit IA qui paient des API LLM (OpenAI, Anthropic, Google, DeepSeek, Qwen et autres) et souhaitent réduire leur facture tout en la rendant prévisible. Si vous exploitez vos propres GPU, consultez notre guide des LLM auto-hébergés pour les aspects liés à l’infrastructure.
Ce qui détermine le coût des API IA
Votre facture IA mensuelle correspond approximativement à ceci :
monthly cost = sum over requests of
  (uncached input tokens x input price)
+ (cached input tokens x cache price)
+ (output tokens x output price)
+ retries, failed calls, tool calls, and fees
Le coût dépend donc de cinq éléments que vous maîtrisez : le modèle appelé, le nombre de tokens d’entrée envoyés (prompts système, historique de conversation, contexte RAG), le nombre de tokens de sortie autorisés, la quantité de contexte récurrent pouvant être mise en cache et le nombre de requêtes relancées ou inutiles.
Tarifs de référence actuels (pour 1M de tokens, au 26 octobre 2026)
| Modèle | Entrée | Entrée en cache | Sortie | Source |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | Tarifs OpenAI |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 | Tarifs OpenAI |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | Tarifs OpenAI |
| Claude Opus 5.5 | $4.00 | $0.20 (accès au cache) | $20.00 | Tarifs Anthropic |
| Claude Sonnet 5.5 | $2.00 | $0.10 (accès au cache) | $10.00 | Tarifs Anthropic |
| Claude Haiku 5.5 (prompts jusqu’à 100K) | $0.10 | $0.01 (accès au cache) | $0.50 | Tarifs Anthropic |
| Gemini 3.8 Flash (promotion jusqu’au 31 décembre 2026) | $0.75 | $0.075 | $3.75 | Tarifs de l’API Gemini |
| Gemini 3.5 Flash-Lite | $0.30 | $0.03 | $2.50 | Tarifs de l’API Gemini |
L’écart entre la première et la dernière ligne est de 100x. Le choix du modèle est donc le premier levier. Pour un tableau plus complet, consultez notre comparatif des tarifs des API IA.
Les 9 stratégies d’optimisation des coûts IA
| # | Stratégie | Économie habituelle sur le trafic concerné | Effort | Risque pour la qualité |
|---|---|---|---|---|
| 1 | Mesurer le coût par tâche réussie | Rend toutes les autres actions possibles | Faible | Aucun |
| 2 | Router selon la difficulté de la tâche | Importante (modèle économique 20-100x moins cher par token) | Moyen | Moyen, nécessite des évaluations |
| 3 | Mettre les prompts en cache | Jusqu’à 90-95% de réduction sur les tokens d’entrée en cache | Faible | Aucun |
| 4 | Traiter les tâches non urgentes par lots | 50% de réduction | Faible | Aucun (plus lent) |
| 5 | Alléger les prompts et le contexte | Proportionnelle au nombre de tokens supprimés | Moyen | Faible à moyen |
| 6 | Plafonner et structurer les sorties | Proportionnelle au volume de sortie supprimé | Faible | Faible |
| 7 | Corriger les nouvelles tentatives et les boucles | Élimine le gaspillage | Moyen | Aucun |
| 8 | Fixer des budgets, quotas et plafonds de dépenses | Évite les dépassements | Faible | Aucun |
| 9 | Revérifier les tarifs et les fournisseurs chaque mois | Variable | Faible | Faible |
1. Mesurer le coût par tâche réussie
Le prix par token ne révèle ni les nouvelles tentatives, ni les sorties inutilisables, ni le coût des longues conversations. Suivez le coût par tâche menée à bien (un ticket résolu, une modification de code acceptée, un résumé terminé) :
def cost_per_successful_task(rows):
    """rows: dicts with cost_usd and success (bool), e.g. from a usage export"""
    total = sum(r["cost_usd"] for r in rows)
    ok = sum(1 for r in rows if r["success"])
    return total / ok if ok else float("inf")
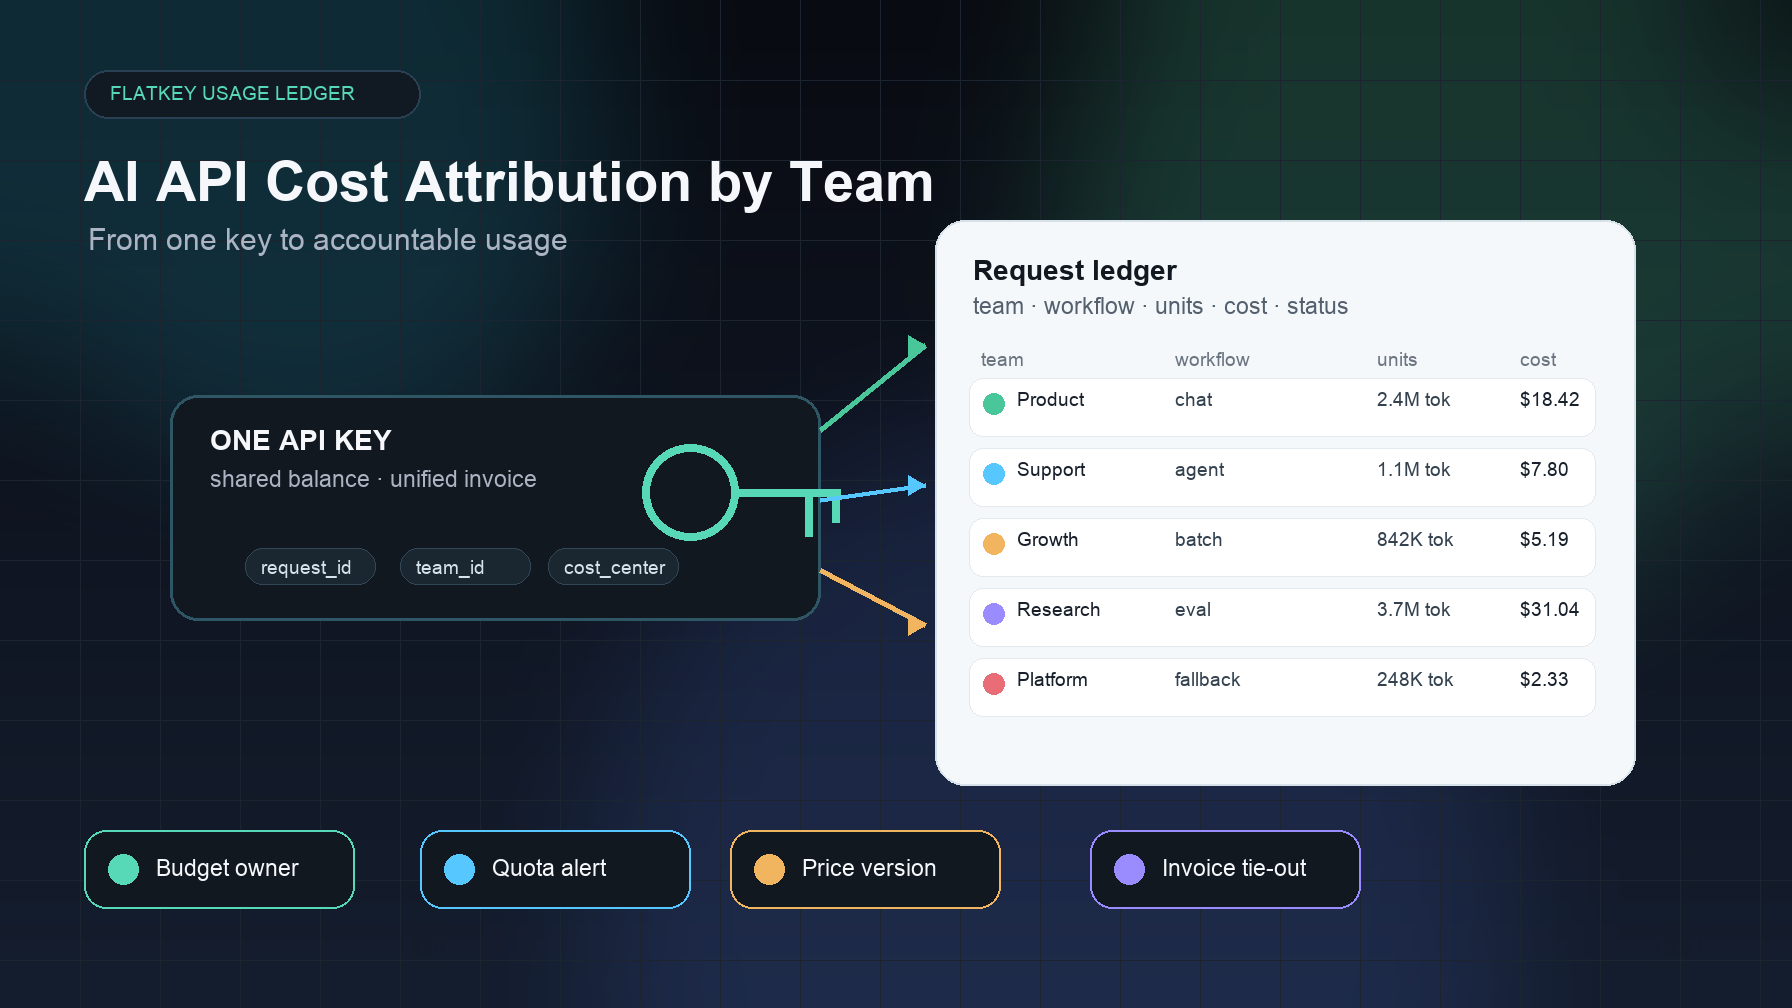
Ventilez les dépenses par fonctionnalité, équipe et clé pour savoir par où commencer. Consultez notre guide sur l’attribution des coûts des API IA par équipe. Les travaux de la FinOps Foundation sur le FinOps pour l’IA reposent sur la même logique d’économie unitaire.
2. Router chaque tâche vers le modèle le moins cher qui satisfait vos critères
La plupart des applications envoient toutes leurs requêtes à un seul modèle puissant. En pratique, un petit modèle suffit souvent pour la classification, l’extraction, les reformulations courtes et les décisions de routage, tandis que le raisonnement difficile et les modifications de code longues nécessitent un modèle plus grand.
Exemple chiffré avec une charge hypothétique de 10M de tokens d’entrée et de 2M de tokens de sortie par jour, entièrement traitée par GPT-6.1 Sol au tarif catalogue d’OpenAI :
All GPT-6.1 Sol:     10 x $2.00 + 2 x $10.00            = $40.00/day
60% to GPT-6 Luna:   6 x $0.10 + 1.2 x $0.50 = $1.20
40% stay on Sol:     4 x $2.00 + 0.8 x $10.00 = $16.00  -> $17.20/day (-57%)
L’économie n’a de valeur que si les tâches routées satisfont toujours vos contrôles qualité : commencez donc par constituer un petit jeu d’évaluation. Définissez vos règles à l’aide de notre guide des politiques de routage des modèles et gérez les mécanismes de repli séparément du routage (guide opérationnel du routage de secours des API LLM).
3. Mettre les prompts en cache pour réutiliser le contexte récurrent
Si de nombreuses requêtes partagent un long préfixe (prompt système, définitions d’outils, document de politique interne, résumé du code source), le cache réduit fortement le coût des entrées répétées. Pour GPT-6.1 Sol, les entrées en cache coûtent $0.10 contre $2.00 sans cache pour 1M de tokens ; pour Claude Sonnet 5.5, les accès au cache coûtent $0.10 contre $2.00 (tarifs catalogue d’octobre 2026). Anthropic facture un supplément pour l’écriture dans le cache (1.25x le tarif d’entrée pour un cache de 5 minutes, 2x pour 1 heure), selon sa documentation sur la mise en cache des prompts ; chez OpenAI, la mise en cache est automatique pour les prompts longs (mise en cache des prompts OpenAI).
Dans l’exemple ci-dessus, si 70% des tokens d’entrée correspondent à un préfixe en cache sur GPT-6.1 Sol :
input: 3M x $2.00 + 7M x $0.10 = $6.70 (was $20.00)
total: $6.70 + $20.00 output = $26.70/day (-33%)
Placez le contenu stable au début et le contenu variable à la fin pour que le préfixe corresponde. Pour approfondir : mise en œuvre de la mise en cache des prompts et retour sur investissement.
4. Passer les tâches non urgentes au traitement par lots
L’API Batch d’OpenAI, Message Batches d’Anthropic et le mode de traitement par lots de Gemini coûtent tous environ 50% moins cher en contrepartie d’une exécution asynchrone (résultats en quelques heures, au lieu de quelques secondes). Bons cas d’usage : classification nocturne, évaluations, calcul rétroactif d’embeddings, étiquetage de contenu et génération de rapports.
# OpenAI Batch: upload a JSONL of requests, then create the batch
curl https://api.openai.com/v1/files -H "Authorization: Bearer $OPENAI_API_KEY" \
  -F purpose="batch" -F file="@requests.jsonl"
curl https://api.openai.com/v1/batches -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"input_file_id":"file-abc123","endpoint":"/v1/chat/completions","completion_window":"24h"}'
5. Alléger les prompts et le contexte
- Supprimez les instructions inutilisées et les exemples en double des prompts système.
- Résumez les anciens échanges au lieu de renvoyer tout l’historique.
- En RAG, envoyez moins de passages, mais plus pertinents (effectuez d’abord un reclassement), au lieu des 20 premiers.
- N’envoyez pas des fichiers entiers à un agent de développement lorsqu’un diff ou une fonction suffit.
Mesurez le nombre de tokens avant et après avec le compteur de tokens ou les champs d’utilisation de votre fournisseur.
6. Plafonner et structurer les sorties
Les tokens de sortie coûtent 5x le prix des tokens d’entrée sur la plupart des modèles du tableau ci-dessus. Définissez max_tokens (ou max_output_tokens) pour chaque route, demandez du JSON structuré plutôt que du texte rédigé lorsqu’un programme lit le résultat et demandez « uniquement la réponse » lorsque les explications sont inutiles.
7. Cesser de payer pour les nouvelles tentatives et les boucles
Les rafales de nouvelles tentatives et les boucles d’agents provoquent souvent des hausses soudaines de facture. Utilisez un délai exponentiel entre les tentatives avec un nombre maximal de relances, ne relancez pas les requêtes qui ont échoué à la validation, fixez un nombre maximal d’étapes par exécution d’agent et consignez séparément le coût des requêtes échouées.
8. Faire respecter les budgets, quotas et plafonds de dépenses
Appliquez les limites là où les requêtes sont émises, pas dans une feuille de calcul mensuelle : quotas par clé, budgets par équipe, alertes à 50/80/100% et plafond strict. Consultez nos guides sur la gestion des quotas des API IA et la gestion des dépenses en API IA.
9. Revérifier les tarifs et les fournisseurs chaque mois
Les tarifs changent souvent : le tarif promotionnel de Gemini 3.8 Flash de Google prend fin le 31 décembre 2026 et passe de $0.75/$3.75 à $1.50/$7.50 pour 1M de tokens (tarifs Gemini), et l’alias deepseek-flash de DeepSeek pointe désormais vers un modèle plus récent (tarifs DeepSeek). Planifiez une revue mensuelle des tarifs et relancez vos évaluations à chaque changement.
Utiliser une passerelle API pour optimiser les coûts IA
Une passerelle réunit plusieurs de ces leviers : un point de terminaison compatible OpenAI pour de nombreux fournisseurs (ce qui facilite le routage et les changements de fournisseur), des journaux d’utilisation par clé et des quotas. Flatkey est une option : une seule clé sur https://router.flatkey.ai/v1 donne accès à GPT, Claude, Gemini, Qwen, DeepSeek et d’autres modèles. Son tableau de bord d’utilisation affiche, pour chaque requête, le modèle, les tokens, le coût et la clé, avec export CSV/JSON et plafond de dépenses mensuel.
Pour certains modèles, les tarifs affichés par Flatkey sont inférieurs aux tarifs catalogue des fournisseurs. Exemples tirés des pages des modèles Flatkey au 26 octobre 2026 :
| Modèle | Tarif catalogue du fournisseur (entrée / sortie pour 1M) | Flatkey (entrée / sortie pour 1M) |
|---|---|---|
| GPT-6.1 Sol | $2.00 / $10.00 | $1.20 / $6.00 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $1.60 / $8.00 |
| Gemini 3.8 Flash | $0.75 / $3.75 (promotion Google) | $1.20 / $6.00 |
Attention à la dernière ligne : pendant la promotion de Google, Gemini 3.8 Flash coûte moins cher en passant directement par Google. Comparez les tarifs modèle par modèle, et non plateforme par plateforme. Les recharges donnent droit à du crédit bonus ($100 deviennent $115, $300 deviennent $360) et les crédits n’expirent pas, selon la page tarifaire de Flatkey.
Changer l’URL de base avec le SDK OpenAI dans Node.js :
import OpenAI from "openai";

const client = new OpenAI({ baseURL: "https://router.flatkey.ai/v1", apiKey: process.env.FLATKEY_API_KEY });
const r = await client.chat.completions.create({
  model: "gpt-6.1-sol",
  messages: [{ role: "user", content: "Classify this ticket: 'refund not received'" }],
  max_tokens: 20,
});
console.log(r.usage); // log tokens per call for cost tracking
Un plan sur 30 jours pour optimiser les coûts IA
| Semaine | Actions | Livrable |
|---|---|---|
| 1 | Exporter l’utilisation, l’étiqueter par fonctionnalité/équipe/clé, calculer le coût par tâche réussie | Rapport de référence |
| 2 | Plafonner les sorties, corriger les nouvelles tentatives, activer le cache pour les longs préfixes partagés | Premières économies, sans risque pour la qualité |
| 3 | Constituer un jeu d’évaluation de 100-200 cas ; tester des modèles moins chers pour chaque tâche ; router celles qui satisfont les critères | Table de routage |
| 4 | Passer les tâches asynchrones au traitement par lots ; définir des quotas, des alertes et un plafond de dépenses | Budget effectivement appliqué |
Erreurs fréquentes
- Optimiser le prix par token au lieu du coût par tâche réussie. Un modèle bon marché qui échoue deux fois coûte plus cher.
- Router sans évaluations. Les baisses de qualité se traduisent ensuite par des tickets d’assistance.
- Casser le cache en plaçant des horodatages ou des identifiants utilisateur au début des prompts.
- Négliger la longueur des sorties, alors que les tokens de sortie sont généralement les plus chers.
- Ne pas fixer de plafond strict, ce qui permet à une seule boucle de consommer le budget d’un mois en une journée.
FAQ
Qu’est-ce que l’optimisation des coûts IA ?
L’optimisation des coûts IA consiste à réduire les dépenses en modèles et en infrastructure IA par résultat utile, grâce au routage des modèles, à la mise en cache des prompts, au traitement par lots, à l’allègement des prompts et des sorties et aux budgets, tout en maintenant un niveau de qualité convenu.
Comment réduire rapidement les coûts des API LLM ?
Les mesures les plus rapides consistent à plafonner max_tokens, à activer la mise en cache des prompts pour les longs préfixes récurrents, à traiter les tâches non urgentes par lots (environ 50% de réduction chez OpenAI, Anthropic et Gemini) et à confier les tâches simples à un petit modèle comme GPT-6 Luna à $0.10/$0.50 pour 1M de tokens (octobre 2026).
Quelles économies permet la mise en cache des prompts ?
Sur les tokens d’entrée en cache, les économies sont importantes : les entrées en cache de GPT-6.1 Sol coûtent $0.10 contre $2.00 pour 1M de tokens, soit une réduction de 95% (octobre 2026). L’économie totale dépend de la part de vos entrées constituée d’un préfixe récurrent.
Le modèle IA le moins cher est-il toujours le plus rentable ?
Non. Si un modèle bon marché échoue plus souvent, les nouvelles tentatives et les corrections humaines peuvent coûter plus cher qu’un modèle plus performant. Comparez le coût par tâche réussie sur votre propre jeu d’évaluation.
Qu’est-ce que le FinOps pour l’IA ?
Le FinOps pour l’IA applique les pratiques de gestion financière du cloud (visibilité, répartition des coûts, économie unitaire et budgets) aux dépenses IA. La FinOps Foundation publie le cadre de référence.
Une passerelle IA réduit-elle les coûts ?
Une passerelle ne réduit pas à elle seule le prix des tokens, mais elle facilite le routage, les changements de fournisseur, le suivi de l’utilisation et l’application des quotas. Certaines passerelles affichent aussi des prix par token plus bas pour des modèles précis ; vérifiez le tarif de chaque modèle.
Sources
Tarifs vérifiés le 26 octobre 2026 : tarifs de l’API OpenAI, tarifs Anthropic, tarifs de l’API Gemini, tarifs DeepSeek, tarifs Flatkey. Méthodes : traitement par lots OpenAI, mise en cache des prompts Anthropic, FinOps pour l’IA.