Optimización de costes de API de IA: 7 estrategias, 5 alternativas y una calculadora de costes
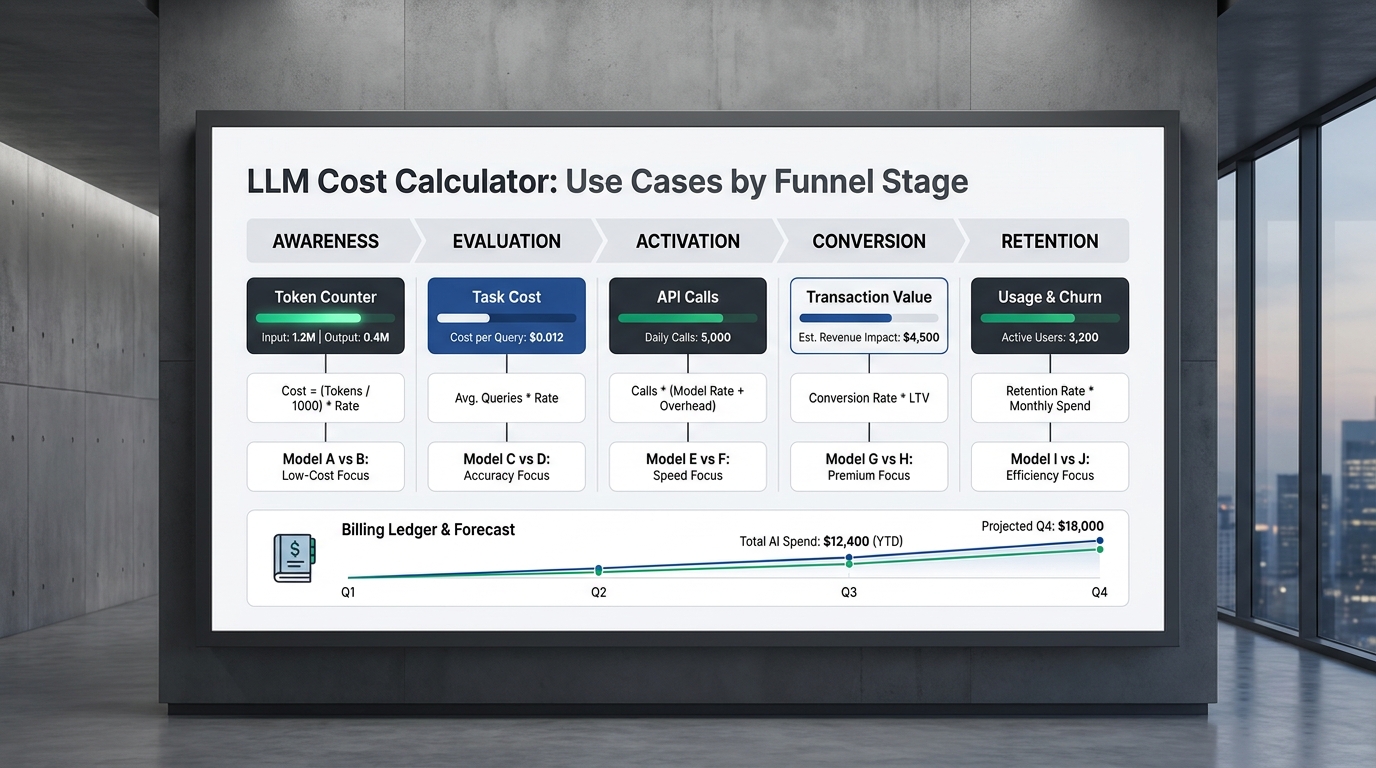
La optimización de costes de API de IA no es lo mismo que encontrar el modelo con el precio más bajo por millón de tokens. Un modelo barato puede resultar caro cuando produce respuestas más largas, no cumple los requisitos de salida estructurada, desencadena reintentos o envía más trabajo a revisores humanos. Un modelo premium puede ser económico cuando completa la tarea correctamente en el primer intento.
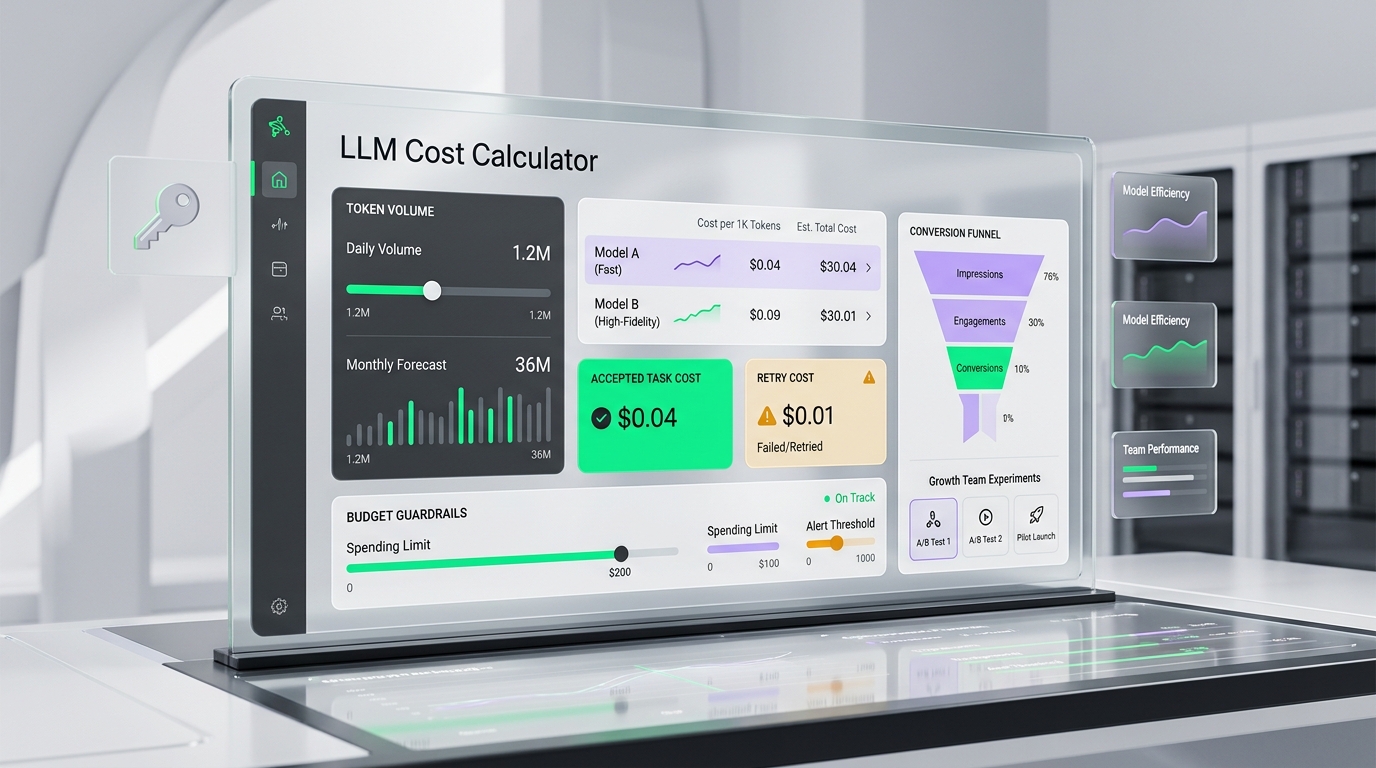
La unidad útil es coste por tarea aceptada: el coste total de producir una salida que tu aplicación realmente pueda usar.
Esta guía de implementación explica cómo calcular esa cifra, reducirla con siete estrategias prácticas, comparar cinco alternativas de arquitectura, evaluarlas con la misma carga de trabajo de 100 tareas y ejecutar un sprint de optimización de 30 días sin debilitar la calidad o la fiabilidad de la salida.
Nota sobre precios: La documentación del proveedor y el catálogo público de precios de Flatkey se volvieron a revisar el 4 de agosto de 2026. Los nombres de los modelos, los niveles de contexto, los descuentos por caché, las tarifas por lotes, la disponibilidad regional y los multiplicadores de pasarela pueden cambiar. Vuelve a comprobar las páginas de precios enlazadas antes de tomar una decisión de compra.
La respuesta rápida
Para la mayoría de los equipos de producción, la forma más rápida de reducir el coste de la API de IA es:
- Medir el coste por tarea aceptada según el caso de uso.
- Derivar el trabajo simple a un modelo más pequeño y el trabajo difícil a un modelo más potente.
- Reducir la entrada repetida con compactación de prompts y almacenamiento en caché.
- Limitar la longitud de salida y detener la generación innecesaria.
- Separar los reintentos del fallback del modelo.
- Usar ejecución por lotes o asíncrona para cargas de trabajo no interactivas.
- Hacer cumplir presupuestos por funcionalidad, arrendatario y entorno.
Si usas solo un modelo y tienes una carga de trabajo pequeña, el acceso directo al proveedor puede seguir siendo la opción más sencilla. Si comparas proveedores con regularidad, necesitas capacidad de fallback o quieres una sola integración compatible con OpenAI, una pasarela alojada puede reducir la carga de ingeniería y operativa. Si la política exige contratos directos con el proveedor o control total de la infraestructura, BYOK o el autoalojamiento pueden encajar mejor.
Por qué el precio por token es una métrica de coste incompleta
Empieza con el cargo visible de la API:
coste de la solicitud = tokens de entrada × tarifa de entrada
                    + tokens de entrada en caché × tarifa de caché
                    + tokens de salida × tarifa de salida
                    + cargos por herramientas, imágenes, audio o búsqueda
Luego añade los costes creados alrededor de la solicitud:
coste por tarea aceptada =
  (gasto del modelo
   + gasto de reintentos y fallback
   + coste de pasarela o infraestructura
   + coste de revisión humana
   + coste de remediación de fallos)
  ÷ tareas aceptadas
Supongamos que el Modelo A cuesta la mitad por token que el Modelo B. Si el Modelo A necesita 1,8 intentos de media y envía el 12% de las salidas a revisión manual, mientras que el Modelo B promedia 1,05 intentos y un 3% de revisión, el Modelo B puede tener el menor coste efectivo.
Por eso, una útil comparación de precios de API de IA debe ir acompañada de una evaluación de la carga de trabajo, y no usarse como una decisión de compra aislada.
Calculadora de costes de API de IA copiable
Construye la línea base a nivel de flujo de trabajo, no como un promedio combinado de toda la cuenta. Una respuesta de soporte, una interacción de un agente de programación, un trabajo de extracción y una solicitud de generación de vídeo tienen distintos umbrales de calidad y costes de fallo.
Usa esta hoja de cálculo para cada flujo de trabajo:
| Entrada | Cómo medirla |
|---|---|
| Solicitudes iniciadas | Cuenta todos los intentos de producción, incluidos los reintentos |
| Tareas aceptadas | Cuenta las salidas que pasaron la aceptación automática o humana |
| Coste de entrada | Incluye por separado la entrada ordinaria y la almacenada en caché |
| Coste de salida | Incluye cargos por texto, imagen, audio o vídeo generados |
| Coste de herramientas | Añade búsqueda, ejecución de código, almacenamiento y otras herramientas con medición |
| Coste de reintentos y fallback | Atribuye cada intento repetido a la tarea de origen |
| Coste de revisión | Minutos del revisor × tarifa horaria cargada |
| Coste de infraestructura | Asignación de gateway, proxy, cola, base de datos, monitorización y guardia |
| Corrección de fallos | Reembolsos, reejecuciones, tiempo de soporte o reparación posterior |
Después calcula:
tasa de aceptación = tareas aceptadas ÷ solicitudes iniciadas

coste por tarea aceptada =
  (entrada + salida + herramientas + reintentos + revisión + infraestructura + corrección)
  ÷ tareas aceptadas
Haz seguimiento también del coste p50 y p95 por tarea aceptada, además del promedio. Los promedios pueden ocultar tormentas de reintentos poco frecuentes, contextos sobredimensionados o bucles de fallback que generan los mayores incidentes de presupuesto.
Prueba de equilibrio para una optimización
Una optimización solo es financieramente útil cuando sus ahorros recurrentes amortizan el coste de implementación y operación dentro de un periodo aceptable.
ahorro neto mensual =
  coste total mensual de referencia
  - coste total mensual optimizado
  - nuevo coste operativo mensual

meses de equilibrio = coste de implementación único ÷ ahorro neto mensual
Rechaza los cambios que reduzcan el gasto en tokens pero disminuyan la aceptación lo suficiente como para aumentar el coste de revisión, reintentos, abandono o incidentes. Valida los ahorros frente al mismo conjunto de evaluación y el mismo segmento de tráfico de producción.
Tabla comparativa de optimización de costes de API de IA
Las siete estrategias siguientes atacan distintas partes de la factura. La mejor secuencia suele ser primero la medición, después el enrutamiento y, por último, los cambios en el prompt y la ejecución.
| Estrategia de optimización | Coste principal reducido | Esfuerzo de ingeniería | Riesgo principal | Mejor encaje |
|---|---|---|---|---|
| Enrutamiento de modelos basado en la tarea | Tarifas de tokens de entrada y salida | Medio | Regresiones de calidad en tareas mal clasificadas | Cargas de trabajo mixtas con bandas claras de complejidad |
| Compactación de prompts y almacenamiento en caché | Tokens de entrada repetidos | Bajo–medio | Eliminar contexto que el modelo realmente necesita | Prompts de sistema largos, RAG, agentes de programación |
| Controles de salida | Tokens de salida y latencia | Bajo | Truncar detalles útiles | Extracción, clasificación, llamadas a herramientas |
| Política de reintentos y fallback | Llamadas duplicadas y coste por fallos | Medio | Repetición insegura tras efectos secundarios parciales | APIs de producción con errores intermitentes |
| Ejecución por lotes y asincrónica | Tarifa de ejecución del proveedor | Bajo–medio | Mayor tiempo de finalización | Evals, enriquecimiento, resumen, backfills |
| Presupuestos y cuotas de uso | Gasto descontrolado o no asignado | Medio | Bloquear ráfagas legítimas | Productos multicliente y plataformas internas |
| Evaluación continua de precio-rendimiento | Coste de selección y migración de modelos | Medio–alto | Deriva de benchmarks | Equipos con un gasto mensual significativo en IA |
1. Enruta por tarea, no por aplicación
Muchos equipos eligen un único modelo para todo un producto porque simplifica la implementación. Esa comodidad puede hacer que cada solicitud pague la tarifa del modelo insignia.
En su lugar, clasifica el trabajo según la capacidad que necesita:
- Baja complejidad: clasificación, etiquetado, enrutamiento, extracción breve, reparación de formato.
- Complejidad media: resumen, respuesta a preguntas con fundamento, ediciones rutinarias de código.
- Alta complejidad: razonamiento de varios pasos, programación difícil, uso ambiguo de herramientas, decisiones sensibles.
Utiliza el modelo menos costoso que cumpla un umbral de aceptación definido para cada clase. Mantén el clasificador determinista siempre que sea posible: el endpoint, la funcionalidad, el tipo de prompt, el esquema esperado, la longitud de tokens y el nivel de riesgo suelen ser suficientes.
Una política de enrutamiento debería tener un umbral mínimo de calidad. Si el modelo de presupuesto cae por debajo de ese umbral, eleva la solicitud a un modelo más potente en lugar de aceptar silenciosamente un resultado débil.
2. Compacta los prompts y reutiliza el contexto repetido
El coste de entrada crece de forma silenciosa porque las instrucciones del sistema, las definiciones de herramientas, los documentos recuperados y el historial de conversación se repiten en cada llamada.
Reduce la entrada repetida mediante:
- eliminación de instrucciones y ejemplos duplicados;
- envío solo de las herramientas disponibles para el paso actual;
- recuperación de menos fragmentos de contexto, pero de mayor calidad;
- resumen de turnos antiguos de la conversación;
- almacenamiento del estado estable fuera del prompt;
- uso del almacenamiento en caché de prompts del proveedor cuando la carga de trabajo y el proveedor lo admitan.
El almacenamiento en caché es más útil cuando un prefijo grande permanece idéntico a lo largo de muchas solicitudes. Es menos útil cuando los prompts cambian constantemente o cuando la retención de caché y las reglas regionales no coinciden con la aplicación.
OpenAI, Anthropic y Google publican documentación separada para el precio por token, la entrada en caché o el almacenamiento en caché de contexto, y la ejecución por lotes. Trátelos como palancas específicas de la carga de trabajo en lugar de asumir que cada solicitud recibe la tarifa más baja anunciada.
3. Controle deliberadamente la longitud de la salida
Los tokens de salida suelen costar más que los tokens de entrada. También aumentan la latencia y dificultan el análisis posterior.
Para respuestas consumidas por máquinas:
- solicite un esquema estricto;
- devuelva identificadores en lugar de descripciones repetidas;
- establezca un límite máximo de salida adecuado;
- detenga la generación después de que se completen los campos requeridos;
- evite la recopilación de cadena de pensamiento cuando una respuesta concisa o una llamada a una herramienta sea suficiente;
- rechace formatos verbosos durante la evaluación.
No minimice la salida a ciegas. El objetivo es la respuesta más corta que preserve el éxito de la tarea. Una respuesta truncada que desencadena una segunda llamada no es una optimización.
4. Separe los reintentos del fallback
Los reintentos y el fallback resuelven problemas diferentes:
- Reintento: repetir una solicitud después de un fallo transitorio, idealmente hacia un endpoint equivalente.
- Fallback: cambiar de modelo, proveedor, región o nivel de capacidad cuando la ruta original no puede completar la tarea.
Los reintentos sin límite pueden multiplicar el gasto durante una interrupción. Use un presupuesto pequeño de reintentos, backoff exponencial con jitter y circuit breakers. Antes de repetir solicitudes que usan herramientas o que cambian el estado, verifique si el intento anterior creó un efecto secundario.
El fallback entre modelos también necesita comprobaciones de contrato. El siguiente modelo debe admitir la longitud de contexto requerida, la salida estructurada, las herramientas, la modalidad y la política de seguridad. El LLM API fallback routing playbook explica cómo separar reintentos seguros, failover equivalente y fallback entre modelos.
5. Mueva el trabajo no interactivo a la ejecución por lotes
Los bucles interactivos de chat y agentes necesitan baja latencia. Muchas otras cargas de trabajo no:
- enriquecimiento nocturno de documentos;
- clasificación masiva;
- evaluación offline;
- rellenos de embeddings;
- resumen de tickets de soporte;
- generación de catálogos o metadatos.
Los proveedores pueden fijar precios de forma diferente para la ejecución por lotes o asíncrona frente a las solicitudes en tiempo real. Incluso cuando la tarifa por token no cambia, el procesamiento por lotes puede reducir la sobrecarga de conexión, suavizar la demanda sobre los límites de tasa y evitar cambios costosos de capacidad de emergencia.
La contrapartida es la latencia y la complejidad operativa. Use una cola, una clave de idempotencia, un plazo de finalización y una ruta de mensajes muertos para que una ejecución más barata no cree fallos invisibles.
6. Añada presupuestos, cuotas y responsabilidades
La optimización fracasa cuando el gasto no puede asignarse a una función o a un responsable. Registre al menos:
- proveedor y modelo;
- aplicación y entorno;
- función o flujo de trabajo;
- inquilino, espacio de trabajo o plan del cliente;
- tokens de entrada, entrada en caché y salida;
- intentos de reintento y fallback;
- resultado aceptado o rechazado;
- coste estimado y conciliado.
Luego establece controles en los mismos niveles. Los controles útiles incluyen umbrales de advertencia diarios, límites máximos mensuales, límites de tokens por solicitud, cuotas por tenant, listas de अनुमति de modelos y políticas automáticas de degradación para cargas de trabajo no críticas.
El objetivo no es simplemente detener el gasto. Es preservar el tráfico de alto valor mientras se elimina primero el tráfico de bajo valor o anómalo. Consulta la guía de seguimiento de costes de API de IA y el manual de gestión del gasto en API de IA para la telemetría y el modelo operativo de finanzas.
7. Evalúa continuamente el precio y la calidad
Los precios de los proveedores cambian. Los modelos mejoran, empeoran o desaparecen. Una decisión de enrutamiento que era eficiente hace tres meses puede que ya no lo sea.
Mantén un conjunto de evaluación compacto para cada flujo de trabajo importante. Registra:
- tasa de aceptación;
- tasa válida según esquema;
- tasa de éxito de llamadas a herramientas;
- latencia p50 y p95;
- tokens medios de entrada y salida;
- intentos medios por tarea aceptada;
- tasa de revisión humana;
- coste por tarea aceptada.
Ejecuta la suite cuando cambie una versión del modelo, el prompt, el esquema de la herramienta, el sistema de recuperación o la política de enrutamiento. Esto convierte la sustitución del modelo en una decisión de compra controlada, en lugar de una migración de emergencia.
Usa la observabilidad de la API LLM para conectar los trazos y el uso de tokens con resultados validados. Sin la señal de aceptación, un panel puede demostrar que el gasto bajó sin demostrar que el producto sigue funcionando.
Cinco alternativas a la API de IA comparadas
“Alternativa” puede significar un modelo alternativo, un proveedor alternativo o una arquitectura de acceso alternativa. Para la optimización de costes, la arquitectura importa porque cambia las tarifas de plataforma, el esfuerzo de ingeniería, la cobertura de fallback y la responsabilidad operativa.
| Alternativa | Modelo de facturación | Esfuerzo de cambio | Opciones de fallback | Carga operativa | Mejor cuando |
|---|---|---|---|---|---|
| Un único proveedor directo | Precio de lista del proveedor | Alto tras una integración profunda | Normalmente dentro de un solo proveedor | Baja | Una familia de modelos satisface casi todas las cargas de trabajo |
| Varios proveedores directos | Facturas separadas de cada proveedor | Medio-alto | Fuertes, pero tú construyes el enrutamiento | Media-alta | El volumen justifica contratos directos y control personalizado |
| Pasarela multi-modelo alojada | Saldo o factura unificados más condiciones de la pasarela | Bajo con un SDK compatible | Fuerte entre proveedores y modelos | Baja-media | Necesitas comparación rápida de modelos, enrutamiento y una sola integración |
| Pasarela o proxy BYOK | Coste directo del proveedor más coste del proxy/plataforma | Bajo-medio | Depende de las claves conectadas | Media | Se requieren facturación directa del proveedor o condiciones de datos |
| Pasarela de código abierto autohospedada | Coste del proveedor más tu infraestructura y mano de obra | Medio | Tú la implementas y operas | Alta | El control y las políticas pesan más que la simplicidad de la plataforma |
Matriz de decisión de arquitectura
Puntúa cada opción de 1 a 5 frente a tus restricciones reales. Pondera el coste, la fiabilidad, el cumplimiento y la capacidad de ingeniería antes de multiplicar las puntuaciones. No dejes que la tarifa de tokens visible más baja gane automáticamente.
| Factor de decisión | Un solo proveedor directo | Varios proveedores directos | Gateway alojado | Proxy BYOK | Gateway autohospedado |
|---|---|---|---|---|---|
| Integración inicial rápida | Alta | Baja | Alta | Media | Baja |
| Facturación unificada | Alta | Baja | Alta | Baja | Depende de la implementación |
| Enrutamiento entre proveedores | Ninguno | Personalizado | Integrado o configurado | Configurado | Totalmente personalizado |
| Control del contrato con el proveedor | Alta | Alta | Varía | Alta | Alta |
| Propiedad de la infraestructura | Baja | Media | Baja | Media | Alta |
| Flexibilidad de migración | Baja–media | Alta | Alta | Alta | Alta |
| Carga operativa interna | Baja | Alta | Baja–media | Media | Alta |
Elige un único proveedor directo cuando una familia de modelos satisfaga la carga de trabajo y la simplicidad sea lo más importante. Elige varios proveedores directos cuando las funciones o los contratos específicos de cada proveedor justifiquen integraciones separadas. Elige un gateway alojado cuando las pruebas rápidas con varios modelos, una sola interfaz, operaciones unificadas y capacidad de fallback compensen la tarifa de la plataforma. Elige BYOK cuando la facturación directa o los contratos sean obligatorios, pero una plano de control compartido siga siendo útil. Elige autohospedaje cuando el control del plano de datos y las políticas personalizadas sean lo bastante estratégicos como para financiar un equipo de plataforma.
Ejecuta un benchmark de alternativas de API de IA de 100 tareas
Una lista de funciones te dice qué afirma soportar una alternativa. Una reproducción del tráfico te dice cuánto cuesta operarla para tu carga de trabajo. Antes de cambiar de proveedor o de arquitectura de gateway, ejecuta el mismo conjunto de tareas representativas a través de cada opción viable.
El benchmark debe incluir al menos 100 tareas muestreadas entre los flujos de trabajo que concentran la mayor parte de tu gasto. Conserva ejemplos difíciles, contextos largos, salidas estructuradas, llamadas a herramientas y solicitudes que anteriormente requirieron reintentos. No construyas un conjunto de evaluación compuesto solo por prompts fáciles; exagerará el ahorro de los modelos más débiles.
Paso 1: congela el contrato de aceptación
Define la condición de aprobación antes de ejecutar cualquier alternativa. Según el flujo de trabajo, la aceptación puede requerir:
- JSON válido o conformidad con un esquema;
- campos de extracción exactos;
- superar pruebas unitarias o de integración;
- respuestas fundamentadas con las citas requeridas;
- ejecución correcta de herramientas sin efectos secundarios duplicados;
- aprobación humana bajo una rúbrica documentada.
Usa un solo contrato de aceptación para todos los candidatos. Si cada proveedor recibe un umbral de calidad diferente, la comparación de costes no es válida.
Paso 2: mantén constante la política de la carga de trabajo
Mantén las instrucciones, las definiciones de herramientas, la temperatura, los límites de salida, el presupuesto de reintentos, el tiempo de espera y las reglas de respaldo lo más similares que permitan las API. Registra cualquier excepción específica del proveedor porque genera costes de migración y mantenimiento.
Ejecuta los candidatos en modo sombra o contra copias no productivas de las mismas entradas. Para agentes con efectos secundarios, simula las escrituras o usa claves de idempotencia para que un benchmark no pueda enviar correos duplicados, crear registros duplicados ni ejecutar una compra dos veces.
Paso 3: captura una fila por tarea y alternativa
Usa este registro que puedes copiar:
| Campo | Qué registrar |
|---|---|
| Flujo de trabajo e ID de tarea | Identificadores estables para comparación emparejada |
| Alternativa de acceso | Directa, multi-directa, gateway alojado, BYOK o autoalojada |
| Proveedor y modelo | El modelo que realmente atendió la solicitud |
| Tokens de entrada, en caché y de salida | Clases de tokens separadas en lugar de un único total |
| Intentos | Llamada inicial, reintentos y alternativas de modelo |
| Coste del modelo y de la plataforma | Mantén visibles el coste del proveedor y el coste del gateway/infraestructura |
| Latencia | p50 y p95 de extremo a extremo, no solo el tiempo de procesamiento del proveedor |
| Aceptado | Aprobado o rechazado según el contrato congelado |
| Minutos de revisión | Esfuerzo humano necesario antes de la aceptación |
| Motivo del fallo | Fallo de esquema, grounding, tiempo de espera, rechazo, herramienta o política |
La métrica mínima de comparación sigue siendo:
coste del benchmark por tarea aceptada =
  (coste del modelo
   + coste del gateway o de la infraestructura
   + coste de reintentos y alternativas
   + coste de revisión
   + corrección de fallos)
  ÷ tareas aceptadas
Combina el registro con una guía de seguimiento de costes de API de IA para que los campos del benchmark puedan convertirse en telemetría de producción en lugar de una hoja de cálculo puntual.
Paso 4: puntúa la adecuación operativa total
El coste debe liderar la decisión, pero no debe borrar la fiabilidad, el control ni el riesgo de migración. Asigna a cada factor un peso que sume el 100%, puntúa cada candidato del 1 al 5 y conserva las métricas brutas del benchmark junto a la puntuación.
| Factor | Peso sugerido | Evidencia |
|---|---|---|
| Coste por tarea aceptada | 35% | Benchmark de 100 tareas emparejadas |
| Tasa de aceptación | 20% | Evaluación automatizada y humana |
| Latencia p95 | 10% | Trazas de extremo a extremo |
| Recuperación ante fallos | 10% | Pruebas de tiempo de espera, límite de tasa e interrupción del proveedor |
| Esfuerzo de ingeniería | 10% | Horas estimadas de migración y mantenimiento |
| Controles de facturación y gasto | 5% | Exportaciones, presupuestos, cuotas, etiquetas de propiedad |
| Ajuste de seguridad y cumplimiento | 10% | Revisión del contrato, registros, retención, región y claves |
puntuación ponderada de la alternativa = Σ(puntuación de 1 a 5 × peso del factor)
Trate la puntuación ponderada como una ayuda para la decisión, no como un sustituto de umbrales estrictos. Un candidato que incumpla una región de datos obligatoria, una cláusula contractual o un umbral mínimo de aceptación debe rechazarse aunque su puntuación total sea alta.
Paso 5: aplique un umbral de cambio
Las pequeñas diferencias en los puntos de referencia a menudo desaparecen después del trabajo de migración, la variabilidad del tráfico y los cambios de precio. Exija un margen claro antes de cambiar.
beneficio neto anual =
  (coste actual por tarea aceptada - coste del candidato por tarea aceptada)
  × tareas aceptadas anuales previstas
  - coste operativo adicional anual

meses para recuperar la inversión = coste de migración ÷ (beneficio neto anual ÷ 12)
Para un cambio reversible en el enrutamiento de modelos, un período de recuperación corto puede ser razonable. Para un contrato con un proveedor, una migración del plano de datos o un gateway autohospedado, exija un margen mayor y un período sombra más largo. Documente el umbral antes de ver los resultados para reducir el sesgo en la decisión.
Ahorros falsos que rechazar
Una alternativa de API de IA no es más barata cuando el ahorro aparente proviene de trasladar el coste fuera de la factura del modelo. Rechace un resultado cuando:
- el gasto en tokens disminuye pero el volumen de tareas aceptadas cae más rápido;
- los reintentos se excluyen del total del candidato;
- se contabilizan las tarifas del gateway pero no la mano de obra de la infraestructura interna, o viceversa;
- el tiempo de revisión se trata como gratuito;
- se asumen descuentos por entrada en caché o por lotes sin medir la elegibilidad y la tasa de acierto;
- el punto de referencia ignora los límites de tasa, las interrupciones o el comportamiento de fallback;
- los créditos promocionales se tratan como un coste unitario permanente;
- la ruta más barata depende de un alias de modelo no compatible o de un comportamiento de enrutamiento no documentado.
Utilice una guía de costes y ROI del caché de prompts para la economía específica del caché y el playbook de enrutamiento de fallback de API de LLM para probar el coste de fallo sin crear amplificación de reintentos.
Alternativa 1: quedarse con un solo proveedor directo
Esto suele ser lo más barato operativamente a pequeña escala porque no hay una capa adicional de enrutamiento que gestionar. También proporciona acceso directo a funciones específicas del proveedor.
El inconveniente es la concentración. Si otro modelo se vuelve mejor o más barato, la migración puede requerir cambios en el SDK, nuevos esquemas, nuevos campos de observabilidad y un nuevo comportamiento de fiabilidad. El acceso a un solo proveedor es una base sólida, no necesariamente el coste total más bajo a largo plazo.
Alternativa 2: integrar varios proveedores directamente
El acceso directo multproveedor puede minimizar las tarifas intermedias y admitir acuerdos empresariales. Ofrece a los equipos de ingeniería control total sobre la selección y la conmutación por error.
El coste oculto es el trabajo de integración duplicado: autenticación, diferencias de SDK, nombres de modelos, normalización de errores, límites de tasa, conciliación de uso, comportamiento de seguridad y disponibilidad regional. Este enfoque funciona mejor cuando el equipo tiene capacidad de ingeniería de plataforma y suficiente volumen para justificarlo.
Alternativa 3: usar un gateway multmodelo alojado
Una pasarela alojada proporciona una única superficie de API a través de familias de modelos. Una URL base compatible con OpenAI puede reducir el esfuerzo de migración para aplicaciones que ya utilizan el patrón del SDK de OpenAI.
El catálogo público actual de Flatkey agrupa modelos en rutas estándar, económicas y de recursos oficiales. Eso permite a los equipos comparar opciones de modelo y enrutamiento detrás de una sola integración, mientras que el acceso actual a los modelos y los multiplicadores siguen visibles en la página de precios de Flatkey.
Compare las pasarelas basándose en algo más que el recargo principal. Revise la cobertura de modelos, la transparencia del enrutamiento, los controles de fallback, las exportaciones de uso, los términos de privacidad, el soporte, la política de créditos y si la pasarela expone el proveedor y el modelo que realmente atendieron cada solicitud. La guía de precios de pasarelas de IA ofrece una lista de verificación de compra más completa.
Alternativa 4: use sus propias claves de proveedor
Una pasarela o proxy BYOK mantiene la facturación del proveedor asociada a sus cuentas mientras añade una interfaz común, registro, políticas o una capa de enrutamiento.
Esto puede encajar en equipos que necesitan contratos directos o controles de datos específicos del proveedor. No elimina la gestión de claves, las cuotas del proveedor, las facturas fragmentadas ni los compromisos mínimos. También debe confirmar cómo el proxy gestiona los prompts, los registros, las credenciales y el failover.
Alternativa 5: aloje usted mismo una pasarela de código abierto
Alojarla usted mismo puede proporcionar el máximo control sobre la lógica de enrutamiento, la región de despliegue, la telemetría y el tratamiento de datos. La licencia del software puede ser gratuita, pero el sistema no lo es de operar.
Incluya en la comparación el tiempo de ingeniería, las actualizaciones, los parches de seguridad, la gestión de secretos, la alta disponibilidad, la respuesta a incidentes, la medición, los paneles y la conciliación de facturación. El alojamiento propio es económico cuando esas capacidades ya existen internamente o son requisitos estratégicos, no simplemente porque el proxy no tenga una tarifa de plataforma por token.
Un plan práctico de optimización de 30 días
Semana 1: establezca la línea base
Instrumente las solicitudes por flujo de trabajo, modelo, tokens, intentos, latencia y resultado aceptado. Reconcilié el coste estimado con los registros de uso del proveedor o de la pasarela. Seleccione los tres flujos de trabajo con mayor gasto total o peor coste por tarea aceptada.
Semana 2: elimine el desperdicio obvio
Elimine contenido duplicado de los prompts, limite la salida, desactive herramientas innecesarias, ponga un tope a los reintentos y traslade los trabajos elegibles a ejecución asíncrona. Añada alertas para el crecimiento del contexto, la amplificación de reintentos y el gasto sin responsable.
Semana 3: cree niveles de enrutamiento
Evalúe al menos un modelo de presupuesto, uno equilibrado y uno de alta capacidad con su propio conjunto de evaluación. Enrute por flujo de trabajo y añada una ruta de escalado activada por calidad. Haga pruebas en sombra de la nueva ruta antes de enviar tráfico de producción.
Semana 4: aplique y revise
Añada presupuestos, alertas y etiquetas de propietario. Compare el coste total de proveedor directo, pasarela, BYOK y alojamiento propio usando la misma muestra de tráfico y los mismos criterios de aceptación. Implemente gradualmente y conserve una vía rápida de reversión.
Controles para el despliegue en producción
No lance un cambio de costes basándose únicamente en una estimación de tokens fuera de línea. Exija estos controles:
- Puerta de calidad: la tasa de aceptación y la tasa de error crítico se mantienen dentro de la tolerancia acordada.
- Puerta de fiabilidad: el comportamiento de timeout, reintento y fallback supera las pruebas de inyección de fallos.
- Puerta de latencia: la latencia p95 sigue siendo adecuada para el flujo de trabajo.
- Puerta de coste: el coste por tarea aceptada mejora en una muestra representativa de tráfico.
- Puerta de seguridad: los permisos de herramientas, las salidas estructuradas y los flujos de trabajo sensibles conservan sus controles.
- Puerta de reversión: el modelo anterior y la política de enrutamiento se pueden restaurar rápidamente.
Para obtener detalles de instrumentación, utiliza la guía de seguimiento de costes de API de IA y la guía de observabilidad de API de LLM. Para prompts repetidos, calcula el punto real de equilibrio con la guía de costes y ROI del almacenamiento en caché de prompts.
Lista de verificación de optimización de costes de API de IA
- [ ] El coste se mide por tarea aceptada, no solo por token.
- [ ] Los tokens de entrada, entrada en caché y salida se rastrean por separado.
- [ ] Cada flujo de trabajo tiene un umbral de calidad explícito.
- [ ] Los modelos más pequeños gestionan las tareas que pueden completar de forma fiable.
- [ ] Los presupuestos de reintentos y las políticas de fallback están separados.
- [ ] Los límites de salida coinciden con el contrato de respuesta.
- [ ] La ejecución por lotes se usa para las cargas de trabajo elegibles.
- [ ] El gasto se atribuye a una función, inquilino, entorno y propietario.
- [ ] Las estimaciones se concilian con el uso facturado.
- [ ] Las pruebas de relación precio-rendimiento del modelo se ejecutan después de cambios significativos.
- [ ] El coste p50 y p95 por tarea aceptada se revisa por separado.
- [ ] Cada optimización tiene una estimación de punto de equilibrio y un responsable de reversión.
- [ ] Los cambios de enrutamiento superan las puertas de calidad, fiabilidad, latencia, coste y seguridad.
Preguntas frecuentes
¿Cuál es la mejor métrica para la optimización de costes de API de IA?
Usa el coste por tarea aceptada o el coste por resultado empresarial validado. El coste por token sigue siendo útil para el diagnóstico, pero no incluye los reintentos, las salidas deficientes, el trabajo de revisión ni la corrección de fallos.
¿El modelo de IA más barato es siempre el más rentable?
No. El modelo más barato solo es rentable cuando cumple con el nivel requerido de calidad, latencia, fiabilidad y uso de herramientas con un número aceptable de intentos.
¿Una pasarela de API de IA reduce los costes?
Puede reducir el coste de integración, enrutamiento, fallback y operación. Si reduce la factura final depende del precio de la pasarela, la selección del modelo, la forma del tráfico, los reintentos y el valor de unas operaciones unificadas. Compara el coste total, no solo el recargo de la plataforma.
¿Cuándo debería un equipo autoalojar una pasarela de IA?
Autoalójala cuando el control de la infraestructura, la política personalizada, la ubicación de despliegue o los requisitos de cumplimiento justifiquen asumir la disponibilidad, las actualizaciones, la seguridad, la medición y la respuesta ante incidentes. Rara vez es la opción más sencilla para un equipo pequeño.
¿Con qué frecuencia se deben reevaluar los costes del modelo?
Reevalúe después de cambios en los precios, lanzamientos de modelos, cambios en los prompts, cambios en el esquema de herramientas o cambios significativos en la carga de trabajo. Para un gasto importante en IA, una revisión mensual de precio-rendimiento es un mínimo práctico.
¿Cuál es la forma más rápida y de bajo riesgo de reducir el coste de la API de LLM?
Empiece con límites de salida, eliminación de contexto duplicado, límites de reintentos y trasladando los trabajos offline elegibles a la ejecución por lotes. Estos cambios suelen ser más fáciles de validar que una migración de modelo. Después, pruebe modelos más pequeños y políticas de enrutamiento con un conjunto de evaluación representativo.
¿Cómo debería un equipo comparar alternativas de API de IA?
Reproduzca la misma muestra de tráfico a través de cada arquitectura y compare el coste por tarea aceptada, la latencia p95, la recuperación ante fallos, el esfuerzo de integración, las operaciones de facturación, la adecuación al cumplimiento y el riesgo de migración. Una comparación de proveedor o gateway sin una métrica de aceptación está incompleta.
Elija el coste total más bajo, no la tarifa más baja
La optimización de costes de la API de IA es una disciplina de ingeniería y producto. La configuración ganadora es la que produce resultados aceptados fiables al coste total más bajo, preservando al mismo tiempo la latencia, la privacidad y el control que su aplicación requiere.
Empiece por la medición. Luego optimice el enrutamiento del modelo, el contexto, las salidas, los reintentos, el modo de ejecución y los presupuestos. Solo después compare las alternativas de acceso usando la misma carga de trabajo y los mismos criterios de aceptación.
Si quiere probar varias familias de modelos sin rehacer cada integración, revise el acceso y los precios actuales de los modelos de Flatkey y utilice un único endpoint compatible para comparar las opciones con sus propias tareas de producción.