Оптимизация затрат на ИИ (2026): 9 способов сократить расходы на API LLM без потери качества
Оптимизация затрат на ИИ — это снижение стоимости каждой успешно выполненной задачи ИИ (а не только отдельного токена): запросы направляются в самую дешевую модель, которая отвечает вашим требованиям к качеству, повторяющийся контекст используется повторно благодаря кэшированию промптов, несрочные задачи переводятся на пакетную обработку, объем вывода ограничивается, а для ключей или команд устанавливаются обязательные лимиты бюджета. В большинстве продуктов на базе API наибольшую экономию дают маршрутизация и кэширование: вместе они могут сократить счет вдвое и более на подходящих нагрузках. Остальную экономию обеспечивают прозрачность расходов и контроль. Все цены ниже взяты с официальных страниц тарифов и проверены 26 октября 2026 года.
Это руководство для независимых разработчиков и команд ИИ-продуктов, которые платят за API LLM (OpenAI, Anthropic, Google, DeepSeek, Qwen и другие) и хотят снизить расходы и сделать их предсказуемыми. Если вы используете собственные GPU, инфраструктурные вопросы разобраны в нашем руководстве по самостоятельному развертыванию LLM.
От чего зависят расходы на API ИИ
Ваш ежемесячный счет за ИИ примерно равен:
monthly cost = sum over requests of
  (uncached input tokens x input price)
+ (cached input tokens x cache price)
+ (output tokens x output price)
+ retries, failed calls, tool calls, and fees
Таким образом, расходы определяют пять факторов, которыми вы можете управлять: какую модель вы вызываете, сколько входных токенов отправляете (системные промпты, история чата, контекст RAG), сколько выходных токенов разрешаете, какую долю повторяющегося контекста можете кэшировать и сколько запросов выполняется повторно или впустую.
Актуальные цены для сравнения (за 1M токенов, 26 октября 2026 года)
| Модель | Вход | Кэшированный вход | Выход | Источник |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | Тарифы OpenAI |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 | Тарифы OpenAI |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | Тарифы OpenAI |
| Claude Opus 5.5 | $4.00 | $0.20 (при попадании в кэш) | $20.00 | Тарифы Anthropic |
| Claude Sonnet 5.5 | $2.00 | $0.10 (при попадании в кэш) | $10.00 | Тарифы Anthropic |
| Claude Haiku 5.5 (промпты до 100K) | $0.10 | $0.01 (при попадании в кэш) | $0.50 | Тарифы Anthropic |
| Gemini 3.8 Flash (акция до 31 декабря 2026 года) | $0.75 | $0.075 | $3.75 | Тарифы Gemini API |
| Gemini 3.5 Flash-Lite | $0.30 | $0.03 | $2.50 | Тарифы Gemini API |
Разница между верхней и нижней строками — 100x. Поэтому выбор модели — первый рычаг экономии. Более широкая таблица есть в нашем сравнении цен на API ИИ.
9 стратегий оптимизации затрат на ИИ
| # | Стратегия | Типичная экономия на соответствующем трафике | Трудозатраты | Риск для качества |
|---|---|---|---|---|
| 1 | Измеряйте стоимость успешно выполненной задачи | Основа для всех остальных мер | Низкие | Отсутствует |
| 2 | Маршрутизируйте запросы по сложности задачи | Высокая (стоимость токена у дешевой модели ниже в 20-100x) | Средние | Средний, нужны проверки качества |
| 3 | Кэшируйте промпты | Скидка до 90-95% на кэшированные входные токены | Низкие | Отсутствует |
| 4 | Обрабатывайте несрочные задачи пакетно | Скидка 50% | Низкие | Отсутствует (обработка медленнее) |
| 5 | Сокращайте промпты и контекст | Пропорциональна числу удаленных токенов | Средние | Низкий–средний |
| 6 | Ограничивайте объем и задавайте формат вывода | Пропорциональна сокращению вывода | Низкие | Низкий |
| 7 | Устраните лишние повторные запросы и циклы | Убирает напрасные расходы | Средние | Отсутствует |
| 8 | Введите бюджеты, квоты и лимиты расходов | Предотвращает перерасход | Низкие | Отсутствует |
| 9 | Ежемесячно проверяйте цены и провайдеров | Зависит от ситуации | Низкие | Низкий |
1. Измеряйте стоимость успешно выполненной задачи
Цена токена сама по себе не учитывает повторные запросы, неудачные ответы и длинные диалоги. Отслеживайте стоимость завершенной задачи: решенного обращения, принятого изменения кода, готового резюме:
def cost_per_successful_task(rows):
    """rows: dicts with cost_usd and success (bool), e.g. from a usage export"""
    total = sum(r["cost_usd"] for r in rows)
    ok = sum(1 for r in rows if r["success"])
    return total / ok if ok else float("inf")
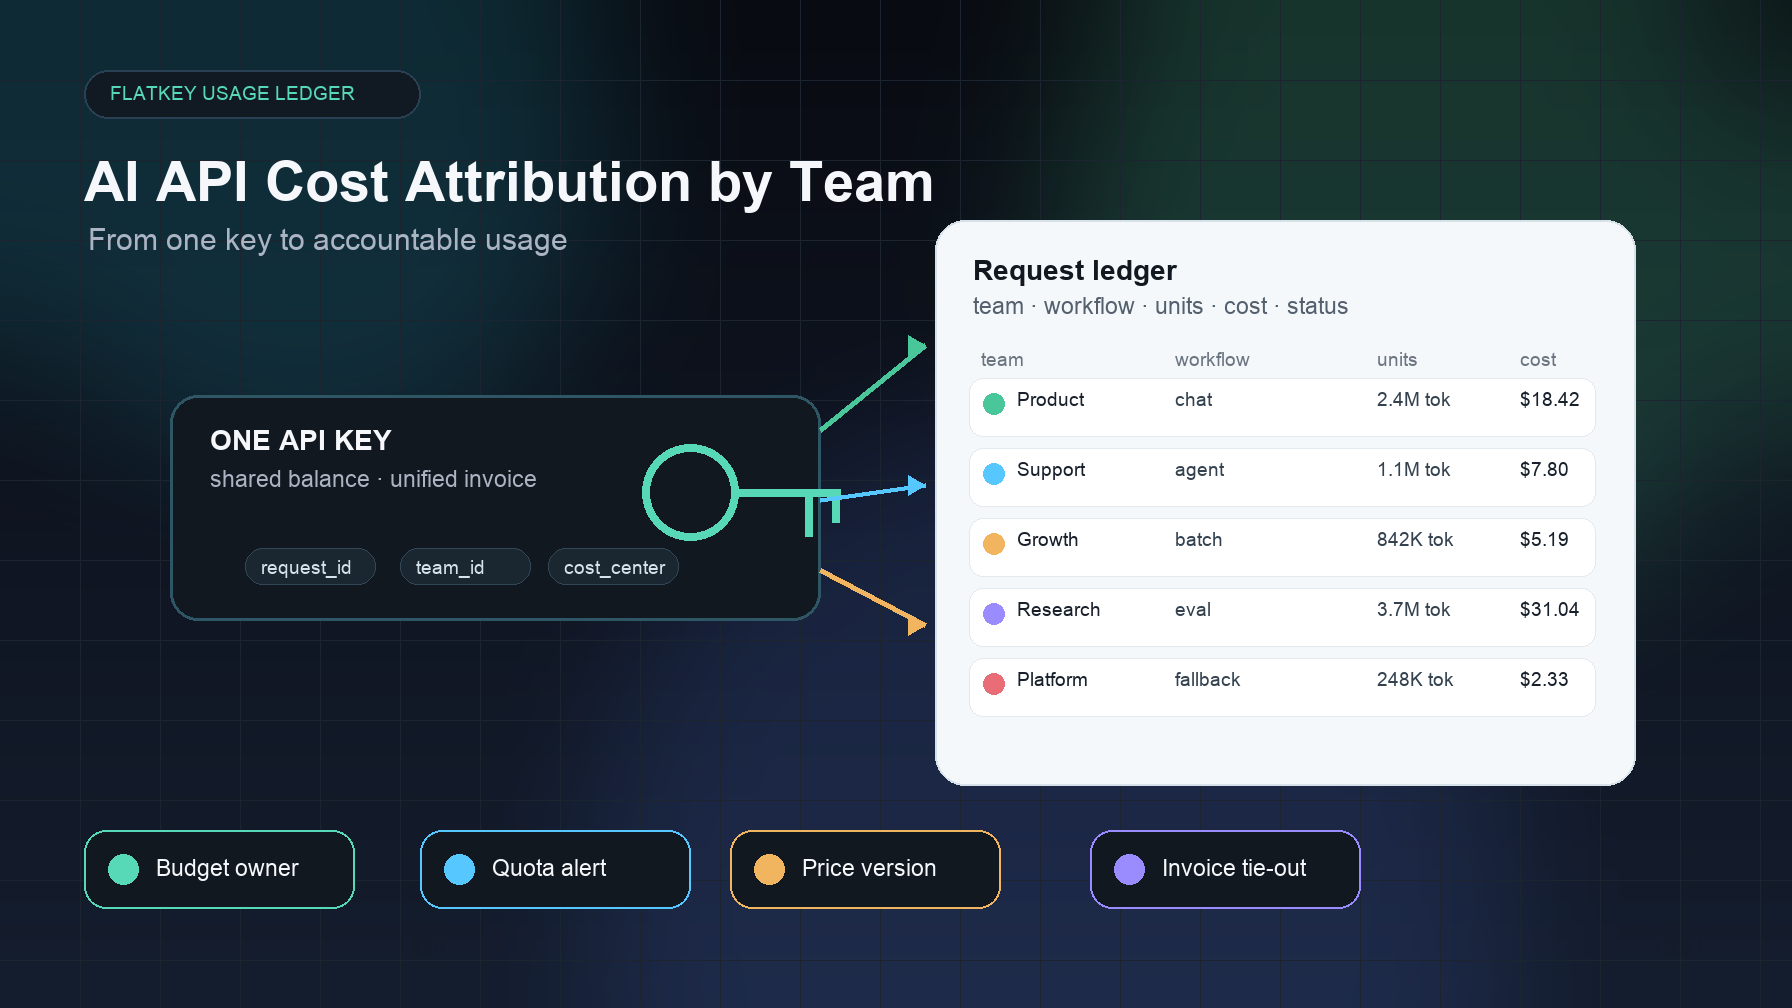
Распределяйте расходы по функциям продукта, командам и ключам, чтобы понимать, с чего начать. Подробнее — в статье «Распределение затрат на API ИИ по командам». В материалах FinOps Foundation по FinOps для ИИ используется тот же подход на основе юнит-экономики.
2. Направляйте каждую задачу в самую дешевую модель, которая с ней справляется
Большинство приложений отправляет все запросы в одну мощную модель. На практике небольшая модель часто справляется с классификацией, извлечением данных, кратким перефразированием и выбором маршрута, а сложные рассуждения и объемные правки кода требуют модели крупнее.
Пример расчета для условной нагрузки в 10M входных и 2M выходных токенов в день, если все запросы обрабатывает GPT-6.1 Sol по стандартным тарифам OpenAI:
All GPT-6.1 Sol:     10 x $2.00 + 2 x $10.00            = $40.00/day
60% to GPT-6 Luna:   6 x $0.10 + 1.2 x $0.50 = $1.20
40% stay on Sol:     4 x $2.00 + 0.8 x $10.00 = $16.00  -> $17.20/day (-57%)
Экономия имеет смысл, только если задачи после маршрутизации по-прежнему проходят ваши проверки качества, поэтому сначала подготовьте небольшой набор тестовых задач. Разработать правила поможет наше руководство по политике маршрутизации моделей. При этом отделяйте переключение на резервную модель от обычной маршрутизации (практическое руководство по резервной маршрутизации API LLM в продакшене).
3. Кэшируйте промпты с повторяющимся контекстом
Если у многих запросов совпадает длинный префикс (системный промпт, определения инструментов, документ с правилами, сводка по кодовой базе), кэширование существенно снижает стоимость повторяющихся входных данных. Кэшированный вход GPT-6.1 Sol стоит $0.10 против $2.00 за 1M токенов без кэша, а попадания в кэш Claude Sonnet 5.5 — $0.10 против $2.00 (стандартные тарифы октября 2026 года). Anthropic взимает дополнительную плату за запись в кэш (1.25x от стоимости входа для кэша на 5 минут, 2x — на 1 час), согласно документации по кэшированию промптов. В OpenAI кэширование длинных промптов работает автоматически (кэширование промптов OpenAI).
Если в примере выше 70% входных токенов составляют кэшированный префикс в GPT-6.1 Sol:
input: 3M x $2.00 + 7M x $0.10 = $6.70 (was $20.00)
total: $6.70 + $20.00 output = $26.70/day (-33%)
Размещайте неизменяемый контент в начале, а переменный — в конце, чтобы префикс совпадал. Подробнее: процесс кэширования промптов и расчет окупаемости.
4. Переведите несрочные задачи на пакетную обработку
Batch API от OpenAI, Message Batches от Anthropic и пакетный режим Gemini стоят примерно на 50% дешевле в обмен на асинхронное выполнение: результаты приходят в течение нескольких часов, а не секунд. Подходящие задачи: ночная классификация, проверки качества, расчет эмбеддингов для накопленных данных, разметка контента и подготовка отчетов.
# OpenAI Batch: upload a JSONL of requests, then create the batch
curl https://api.openai.com/v1/files -H "Authorization: Bearer $OPENAI_API_KEY" \
  -F purpose="batch" -F file="@requests.jsonl"
curl https://api.openai.com/v1/batches -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"input_file_id":"file-abc123","endpoint":"/v1/chat/completions","completion_window":"24h"}'
5. Сокращайте промпты и контекст
- Удаляйте неиспользуемые инструкции и повторяющиеся примеры из системных промптов.
- Сжимайте старые реплики чата в краткую сводку вместо повторной отправки всей истории.
- В RAG отправляйте меньше фрагментов, но лучшего качества (сначала выполните переранжирование), вместо первых 20.
- Не отправляйте агенту для работы с кодом файлы целиком, если достаточно diff или одной функции.
Измеряйте число токенов до и после изменений с помощью счетчика токенов вашего провайдера или полей статистики использования.
6. Ограничивайте объем и задавайте формат вывода
У большинства моделей в таблице выше выходные токены стоят в 5x дороже входных. Задавайте max_tokens (или max_output_tokens) для каждого маршрута, запрашивайте структурированный JSON вместо обычного текста, если результат читает программа, и просите «только ответ», когда объяснения не нужны.
7. Перестаньте платить за лишние повторные запросы и циклы
Лавины повторных запросов и зацикливание агентов часто приводят к внезапному росту счета. Используйте экспоненциальное увеличение задержки с ограничением числа повторов, не повторяйте запросы, не прошедшие валидацию, задавайте максимальное число шагов за один запуск агента и отдельно фиксируйте стоимость неудачных запросов.
8. Обеспечьте соблюдение бюджетов, квот и лимитов расходов
Вводите ограничения там, где выполняются запросы, а не в ежемесячной таблице: квоты для каждого ключа, бюджеты для команд, уведомления на уровнях 50/80/100% и жесткий лимит. Подробнее — в статьях «Управление квотами API ИИ» и «Управление расходами на API ИИ».
9. Ежемесячно проверяйте цены и провайдеров
Цены часто меняются: акция Google на Gemini 3.8 Flash заканчивается 31 декабря 2026 года, после чего цена вырастет с $0.75/$3.75 до $1.50/$7.50 за 1M токенов (тарифы Gemini), а псевдоним deepseek-flash у DeepSeek теперь указывает на более новую модель (тарифы DeepSeek). Запланируйте ежемесячную проверку цен в календаре и повторно запускайте проверки качества при смене модели или провайдера.
Использование API-шлюза для оптимизации затрат на ИИ
Шлюз объединяет несколько этих инструментов: единую совместимую с OpenAI точку доступа к разным провайдерам (упрощает маршрутизацию и переключение), журналы использования по ключам и квоты. Один из вариантов — Flatkey: один ключ для https://router.flatkey.ai/v1 дает доступ к GPT, Claude, Gemini, Qwen, DeepSeek и другим моделям, а панель статистики использования показывает модель, токены, стоимость и ключ для каждого запроса, поддерживает экспорт в CSV/JSON и установку месячного лимита расходов.
Для некоторых моделей цены Flatkey ниже стандартных тарифов провайдеров. Примеры со страниц моделей Flatkey на 26 октября 2026 года:
| Модель | Стандартный тариф провайдера (вход / выход за 1M) | Flatkey (вход / выход за 1M) |
|---|---|---|
| GPT-6.1 Sol | $2.00 / $10.00 | $1.20 / $6.00 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $1.60 / $8.00 |
| Gemini 3.8 Flash | $0.75 / $3.75 (акция Google) | $1.20 / $6.00 |
Обратите внимание на последнюю строку: во время акции Google использовать Gemini 3.8 Flash напрямую через Google дешевле. Сравнивайте цены для каждой модели, а не для платформы в целом. При пополнении начисляются бонусные средства ($100 превращаются в $115, $300 — в $360), а срок действия средств не ограничен, согласно странице тарифов Flatkey.
Смена базового URL в OpenAI SDK для Node.js:
import OpenAI from "openai";

const client = new OpenAI({ baseURL: "https://router.flatkey.ai/v1", apiKey: process.env.FLATKEY_API_KEY });
const r = await client.chat.completions.create({
  model: "gpt-6.1-sol",
  messages: [{ role: "user", content: "Classify this ticket: 'refund not received'" }],
  max_tokens: 20,
});
console.log(r.usage); // log tokens per call for cost tracking
План оптимизации затрат на ИИ на 30 дней
| Неделя | Что сделать | Результат |
|---|---|---|
| 1 | Экспортировать статистику использования, разметить по функциям продукта/командам/ключам, рассчитать стоимость успешно выполненной задачи | Отчет об исходном уровне расходов |
| 2 | Ограничить вывод, устранить лишние повторы, включить кэширование длинных общих префиксов | Первая экономия без риска для качества |
| 3 | Подготовить набор из 100-200 тестовых задач; проверить более дешевые модели для каждого типа задач; направить подходящие задачи в модели, прошедшие проверку | Таблица маршрутизации |
| 4 | Перевести асинхронные задачи на пакетную обработку; установить квоты, уведомления и лимит расходов | Соблюдение бюджета обеспечивается автоматически |
Распространенные ошибки
- Оптимизация цены токена вместо стоимости успешно выполненной задачи. Дешевая модель, которая дважды не справляется с задачей, обходится дороже.
- Маршрутизация без проверок качества. Падение качества позже проявляется в обращениях в поддержку.
- Нарушение работы кэша из-за временных меток или идентификаторов пользователей в начале промптов.
- Игнорирование длины вывода, хотя выходные токены обычно самые дорогие.
- Отсутствие жесткого лимита, из-за чего один цикл может израсходовать месячный бюджет за день.
Частые вопросы
Что такое оптимизация затрат на ИИ?
Оптимизация затрат на ИИ — это снижение расходов на модели и инфраструктуру ИИ в расчете на полезный результат с помощью маршрутизации моделей, кэширования промптов, пакетной обработки, сокращения промптов и вывода, а также бюджетов при сохранении согласованного уровня качества.
Как быстро сократить расходы на API LLM?
Самые быстрые меры — ограничить max_tokens, включить кэширование промптов с длинными повторяющимися префиксами, перевести несрочные задачи на пакетную обработку (примерно на 50% дешевле у OpenAI, Anthropic и Gemini) и отправлять простые задачи в небольшую модель, например GPT-6 Luna по цене $0.10/$0.50 за 1M токенов (октябрь 2026 года).
Сколько позволяет сэкономить кэширование промптов?
На кэшированных входных токенах — очень много: кэшированный вход GPT-6.1 Sol стоит $0.10 против $2.00 за 1M токенов, то есть на 95% дешевле (октябрь 2026 года). Общая экономия зависит от того, какую долю входных данных составляет повторяющийся префикс.
Всегда ли самая дешевая модель ИИ наиболее выгодна?
Нет. Если дешевая модель чаще не справляется с задачей, повторные запросы и исправления вручную могут обойтись дороже, чем использование более мощной модели. Сравнивайте стоимость успешно выполненной задачи на собственном наборе тестовых задач.
Что такое FinOps для ИИ?
FinOps для ИИ применяет практики финансового управления облачными ресурсами (прозрачность, распределение затрат, юнит-экономика и бюджеты) к расходам на ИИ. Методологию публикует FinOps Foundation.
Снижает ли ИИ-шлюз расходы?
Шлюз сам по себе не снижает цену токенов, но упрощает маршрутизацию, смену провайдера, учет использования и соблюдение квот. Некоторые шлюзы также предлагают более низкую цену токена для отдельных моделей; проверяйте цену каждой модели.
Источники
Цены проверены 26 октября 2026 года: тарифы OpenAI API, тарифы Anthropic, тарифы Gemini API, тарифы DeepSeek, тарифы Flatkey. Методы: пакетная обработка OpenAI, кэширование промптов Anthropic, FinOps для ИИ.