
Blog flatkey.ai
Insight, catatan produk, dan panduan implementasi untuk tim yang membangun di atas AI API.
AI Gateway Architecture
Artikel terbaru dalam AI Gateway Architecture.
Baca selengkapnyaBase URL and SDK Migration
Artikel terbaru dalam Base URL and SDK Migration.
Baca selengkapnyaCost, Billing, and Ops
Artikel terbaru dalam Cost, Billing, and Ops.
Baca selengkapnyaEnterprise Controls and Trust
Artikel terbaru dalam Enterprise Controls and Trust.
Baca selengkapnyaGateway Comparisons
Artikel terbaru dalam Gateway Comparisons.
Baca selengkapnyaModel and Modality Playbooks
Artikel terbaru dalam Model and Modality Playbooks.
Baca selengkapnyaReliability and Routing
Artikel terbaru dalam Reliability and Routing.
Baca selengkapnyaTool Integrations
Artikel terbaru dalam Tool Integrations.
Baca selengkapnya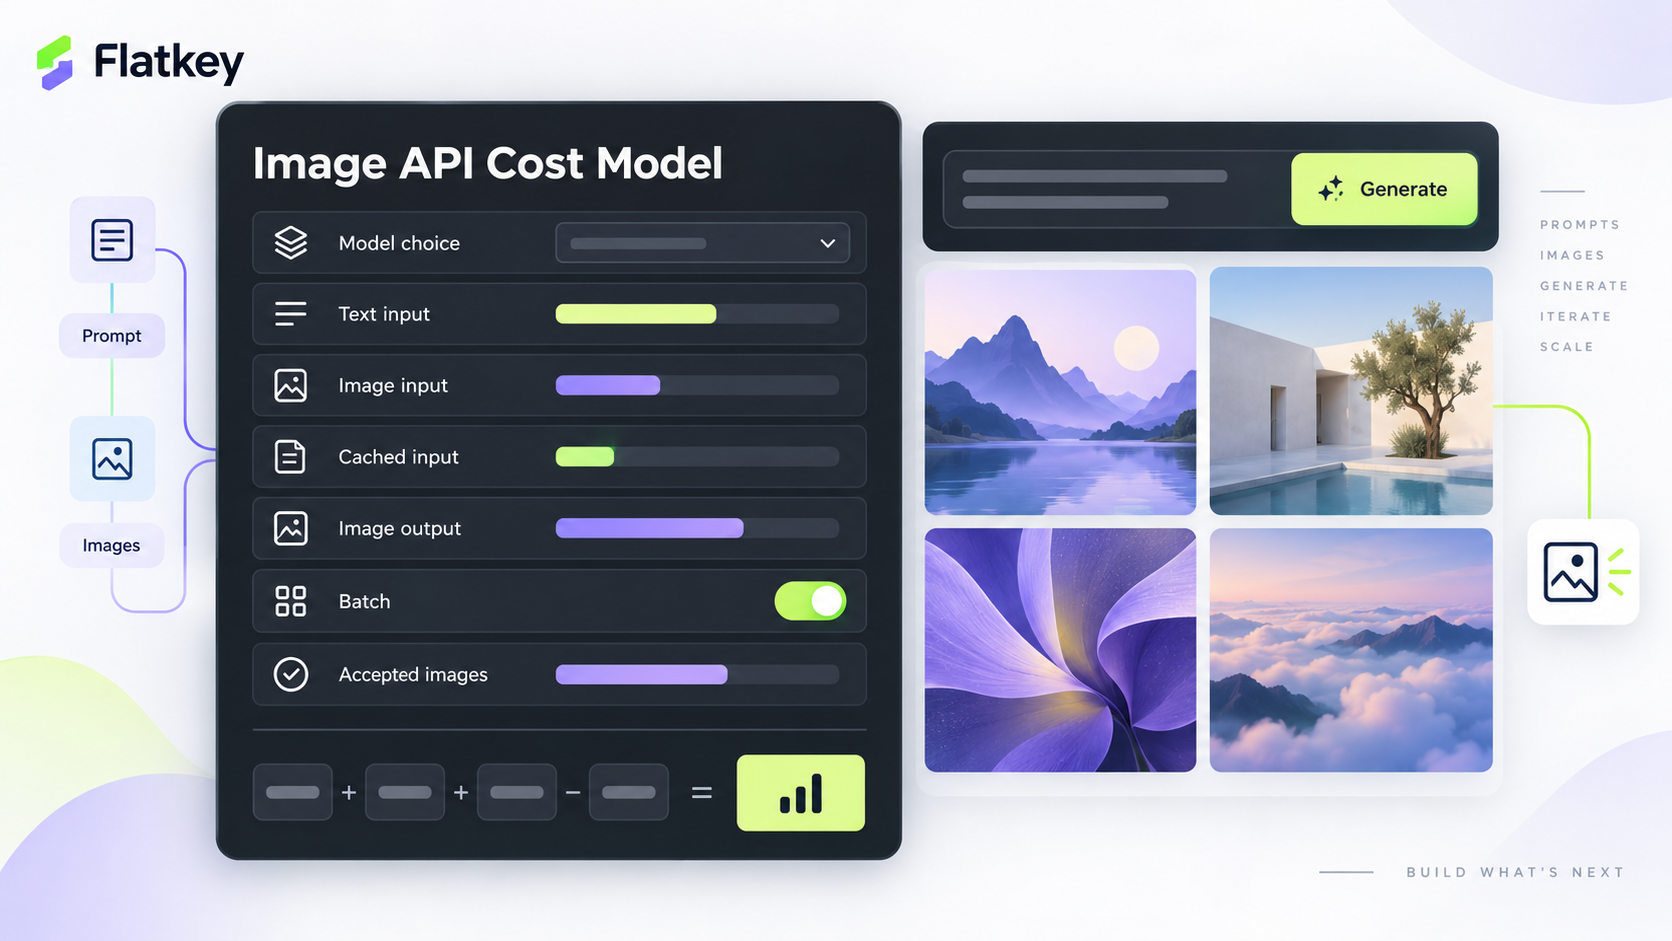
Harga OpenAI Image API: Tarif GPT Image 2.5, Rumus Biaya, dan Kontrol Anggaran
Pelajari cara kerja harga OpenAI image API untuk GPT Image 2.5, termasuk tarif token, aturan input cache, gambar parsial, Batch, dan biaya per gambar yang diterima.
GB200 vs B200: Superchip Grace Blackwell atau x86 HGX?
Bandingkan GB200 vs B200 untuk pengadaan infrastruktur AI: sistem Grace Blackwell skala rak NVL72, node B200 HGX/x86, benchmark, dan pengecekan TCO.
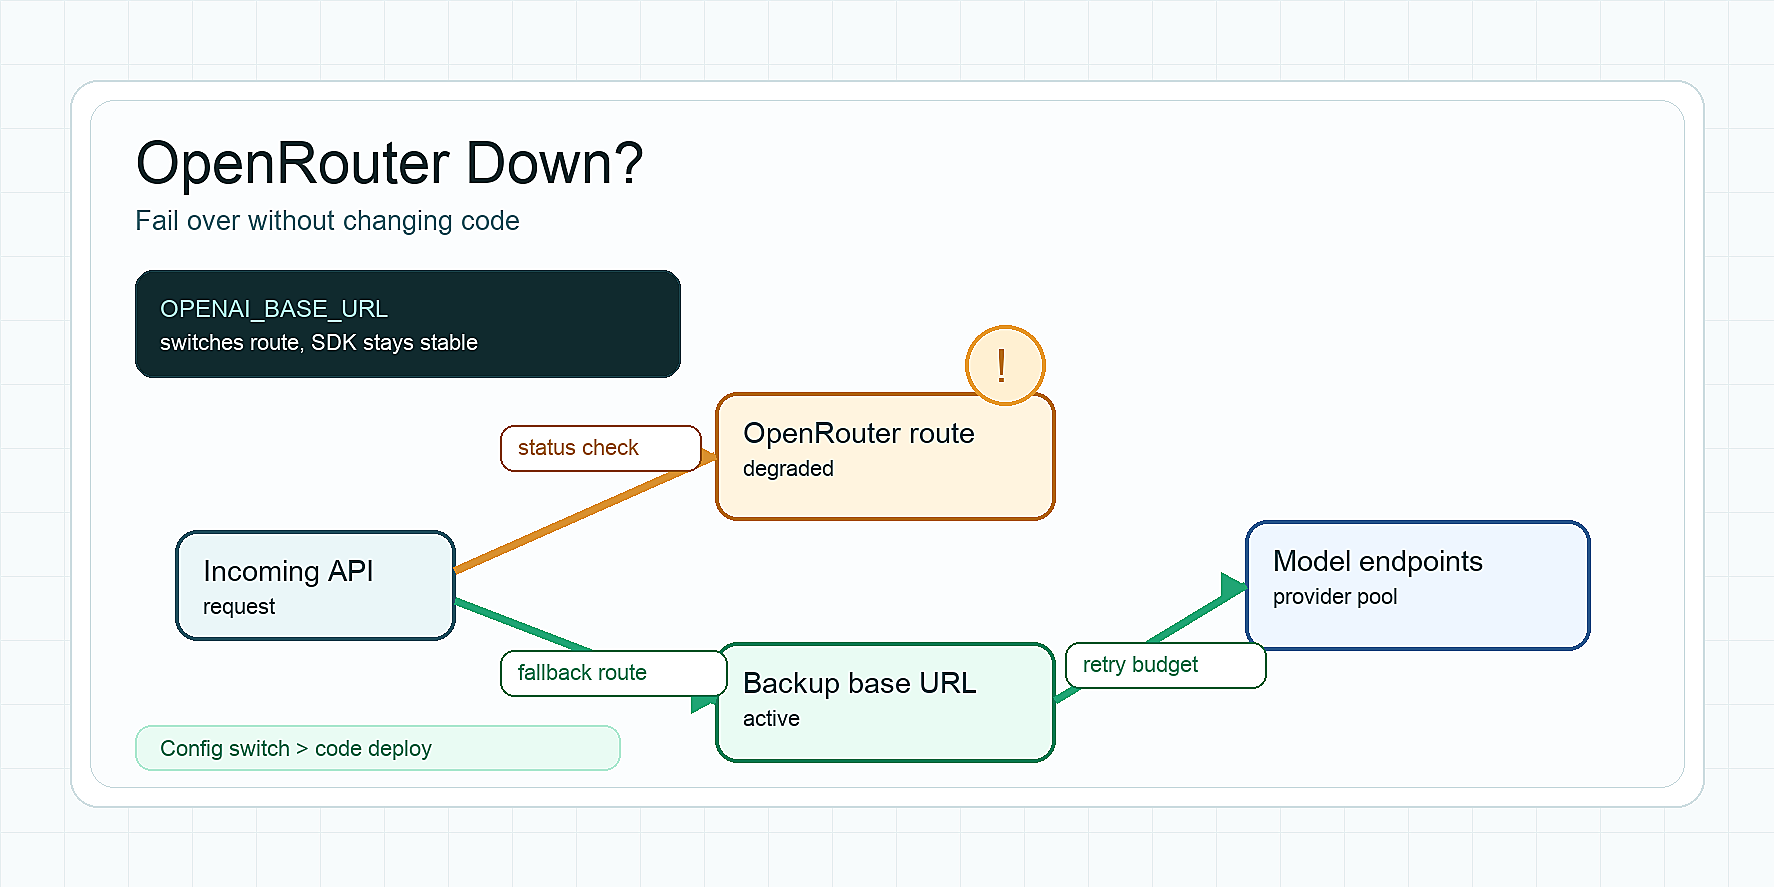
OpenRouter Down? Cara Fail Over Tanpa Mengubah Kode
Periksa apakah OpenRouter sedang down, pisahkan error penyedia dari insiden platform, dan lakukan fail over dengan base_url, retries, provider fallback, dan model fallback.

Seedance API: Harga, Kualitas, dan Penyiapan untuk Endpoint Resmi
Bandingkan opsi endpoint resmi Seedance API, harga Flatkey per detik, langkah penyiapan, dan pengecekan kualitas untuk tim pembuatan video.
Apa Itu AI Factory? Klaster GPU, Data, Model, dan Operasi
Pelajari apa itu AI factory, bagaimana klaster GPU, pipeline data, model, inferensi, tata kelola, dan operasi bekerja bersama, serta kapan API model dapat menggantikan kepemilikan GPU secara langsung.
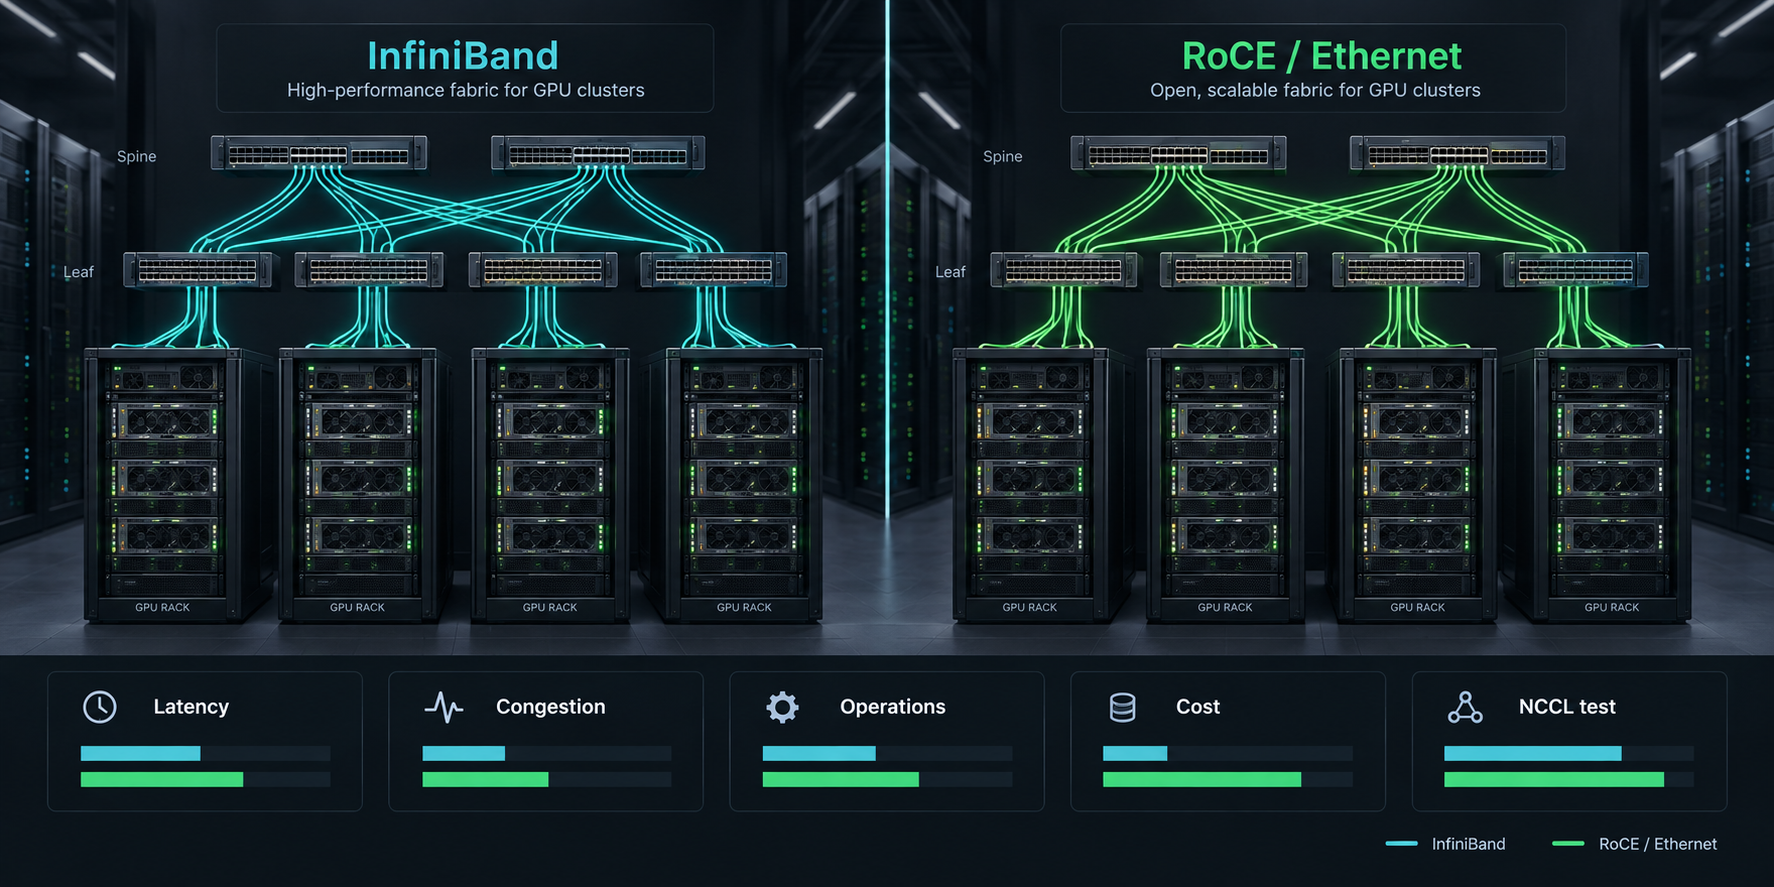
RoCE vs InfiniBand untuk Klaster GPU: Latensi, Operasional, dan Biaya
Bandingkan RoCE dan InfiniBand untuk klaster GPU multi-node dengan matriks keputusan praktis, uji penerimaan NCCL, model biaya, dan daftar periksa pengadaan.
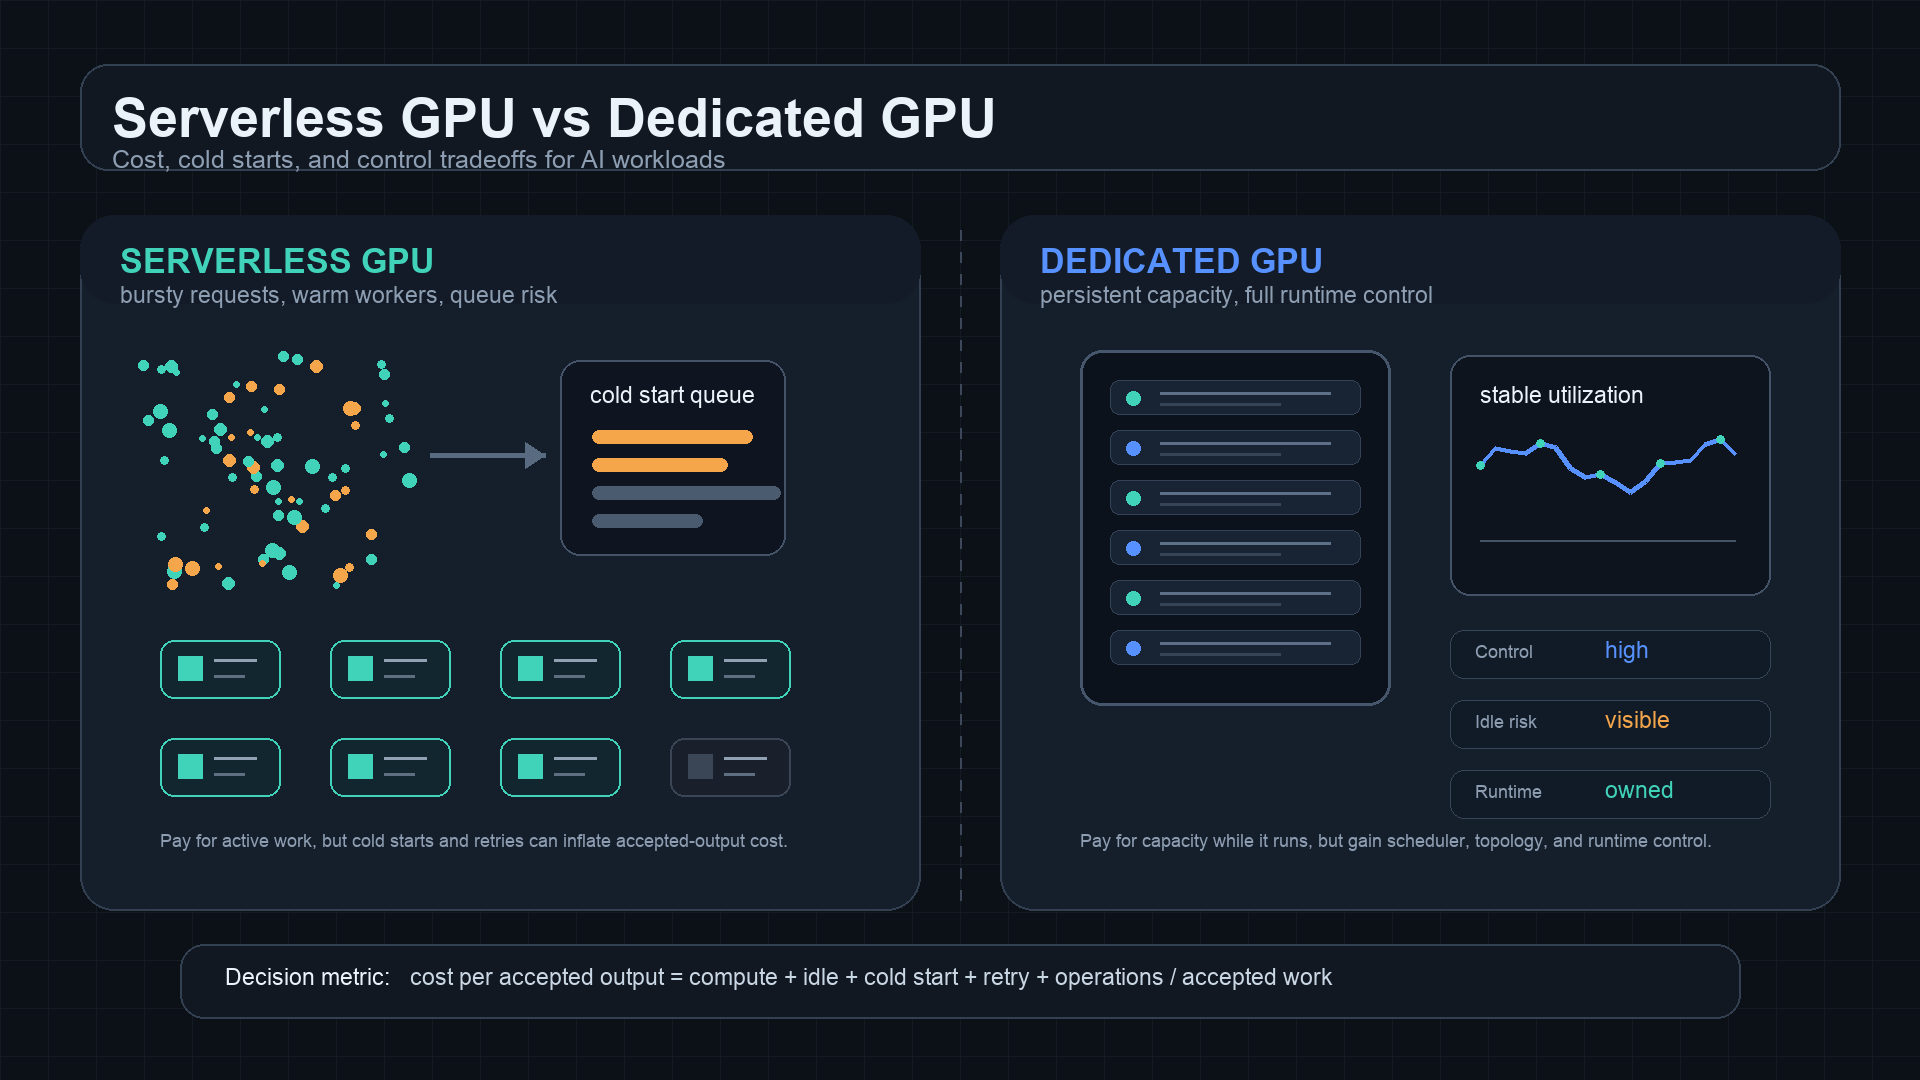
Serverless GPU vs Dedicated GPU: Biaya, Cold Start, dan Kontrol
Bandingkan serverless GPU vs dedicated GPU berdasarkan biaya per output yang diterima, cold start, kapasitas menganggur, autoscaling, dan kontrol operasional.
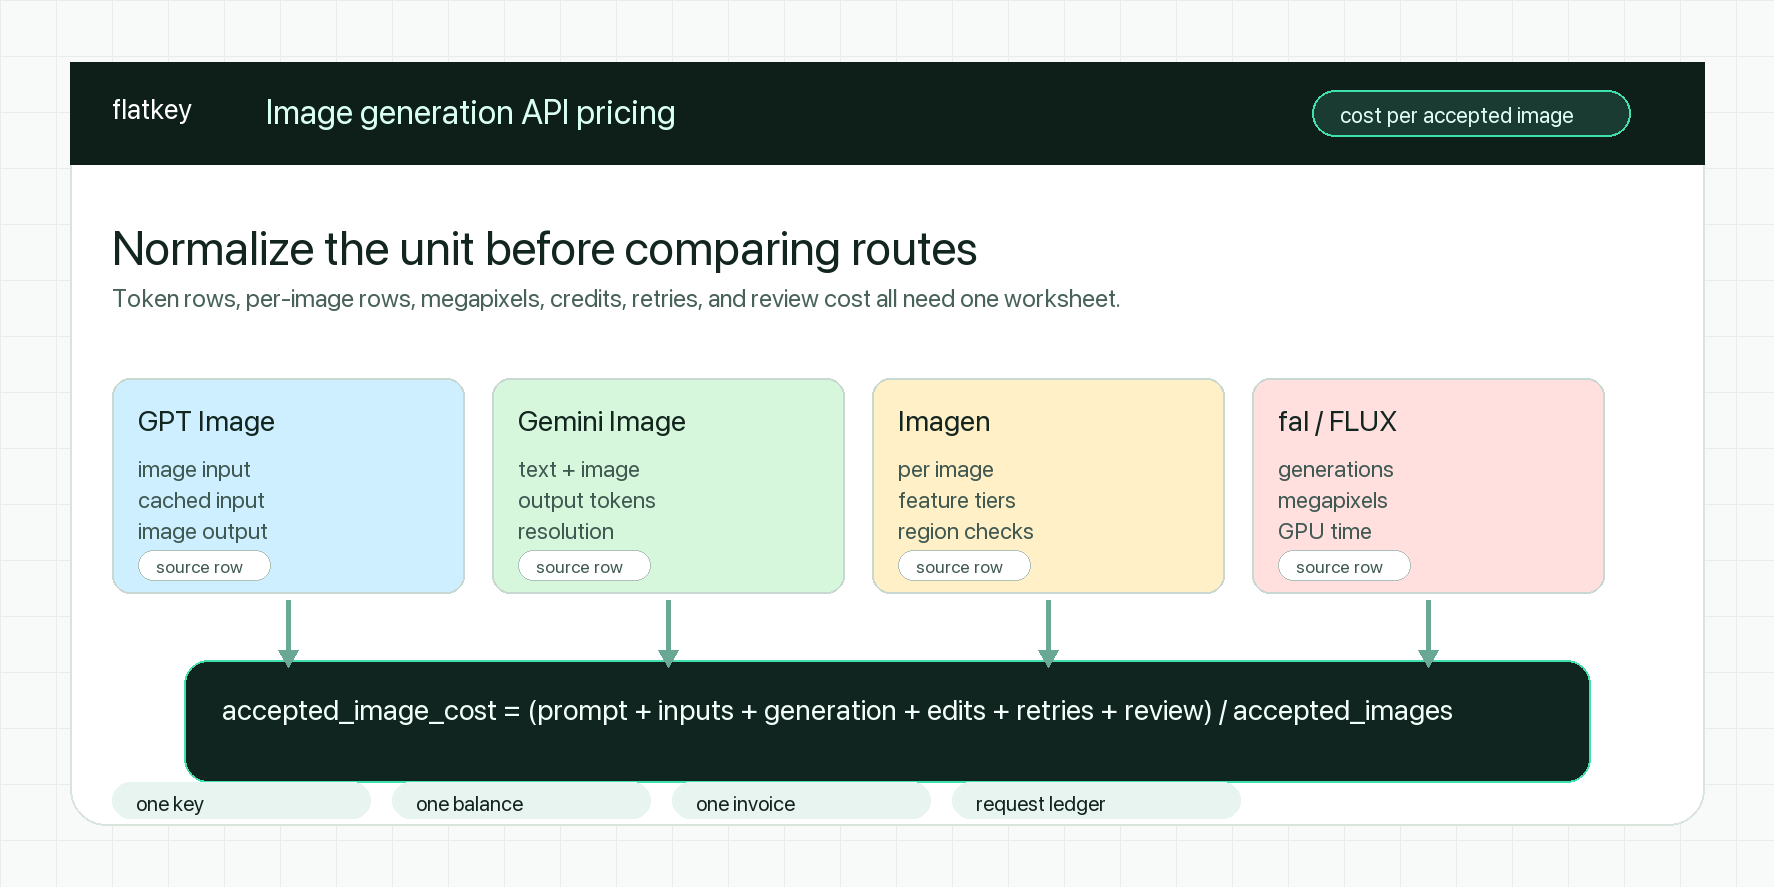
Perbandingan Harga API Generasi Gambar AI: GPT Image, Gemini, Imagen, dan fal
Bandingkan harga API generasi gambar untuk GPT Image, Gemini Image, Imagen, dan jalur fal dengan menormalkan satuan penagihan menjadi biaya per gambar yang diterima.
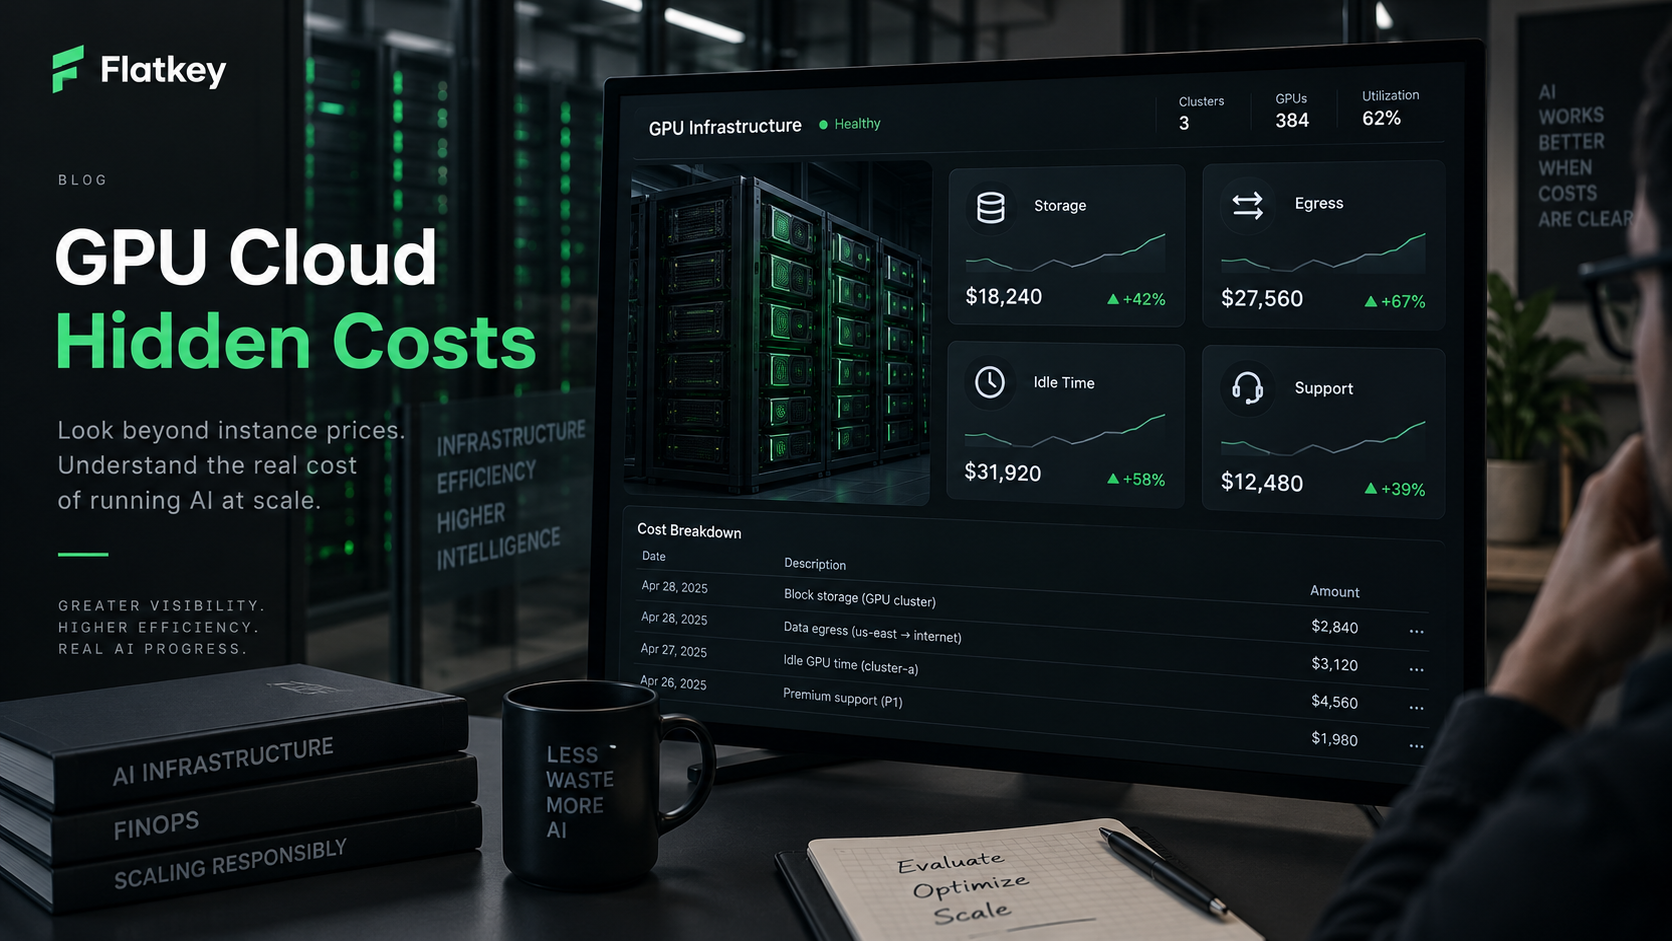
Apa Saja Biaya Tersembunyi dari Layanan GPU Cloud? Penyimpanan, Egress, Waktu Menganggur, dan Dukungan
Panduan TCO GPU cloud yang praktis untuk menemukan biaya penyimpanan, egress, waktu menganggur, job gagal, dukungan, jaringan, dan operasional sebelum tagihan datang.
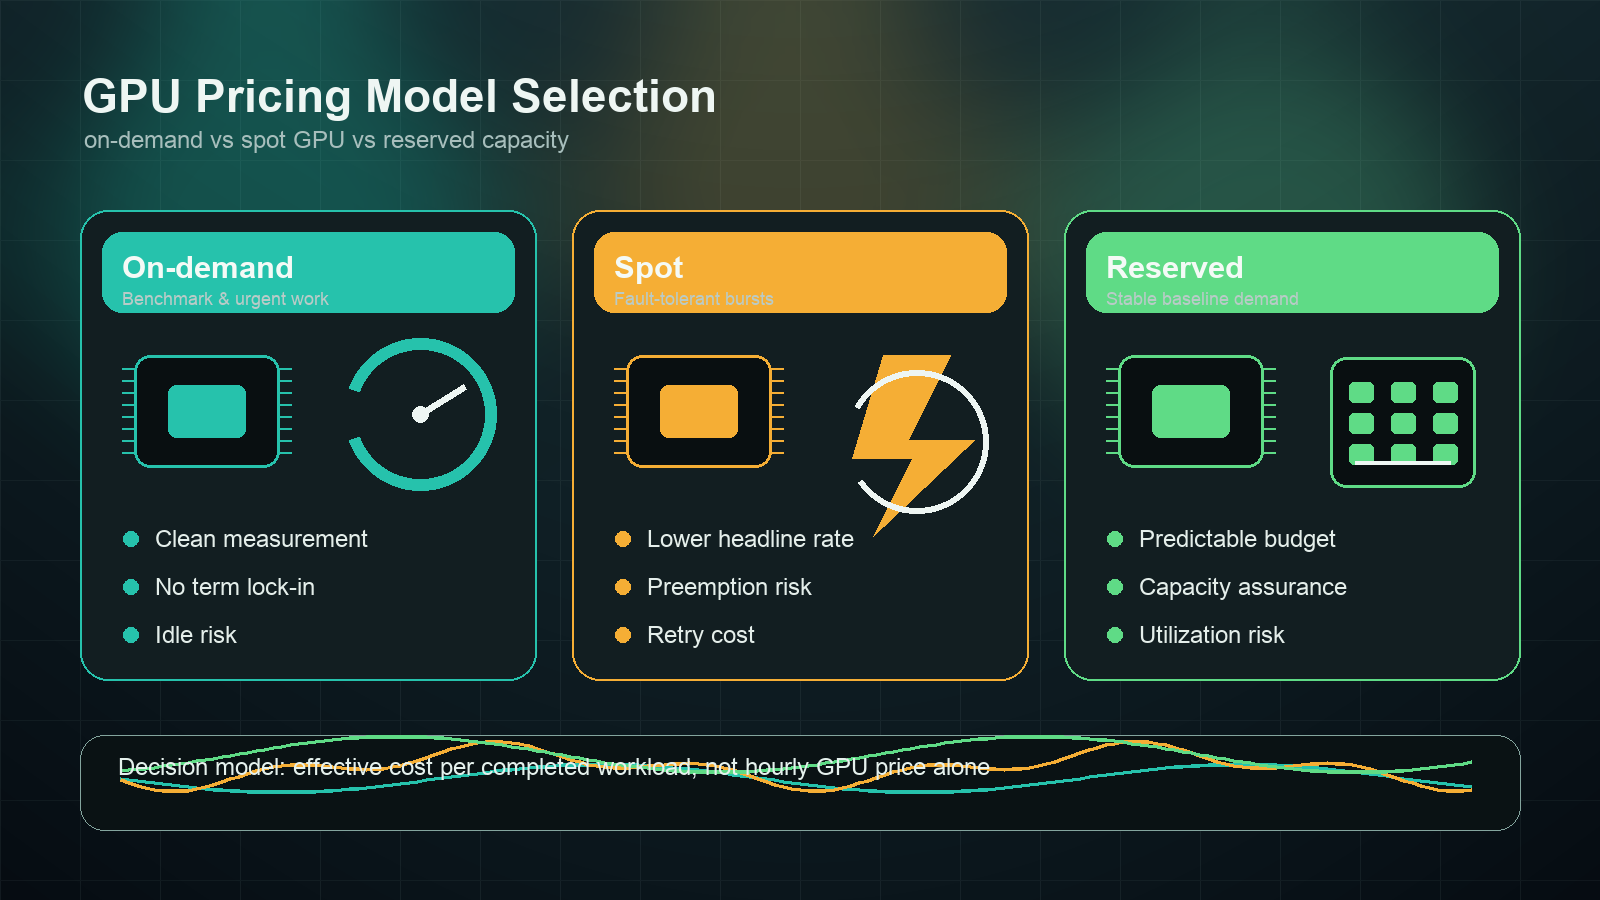
On-Demand vs Spot vs Reserved GPU Pricing: Model Mana yang Cocok untuk Workload Anda?
Kerangka kerja berbasis workload untuk memilih kapasitas GPU on-demand, spot, atau reserved tanpa mencampuradukkan tarif per jam yang tertera dengan biaya workload yang benar-benar selesai.

Private GPU Cloud: Arsitektur, Isolasi, dan Model Operasi
Pelajari cara mengevaluasi arsitektur private GPU cloud, isolasi, kepemilikan scheduler, bukti keamanan, model operasi, TCO, dan pengujian penerimaan.
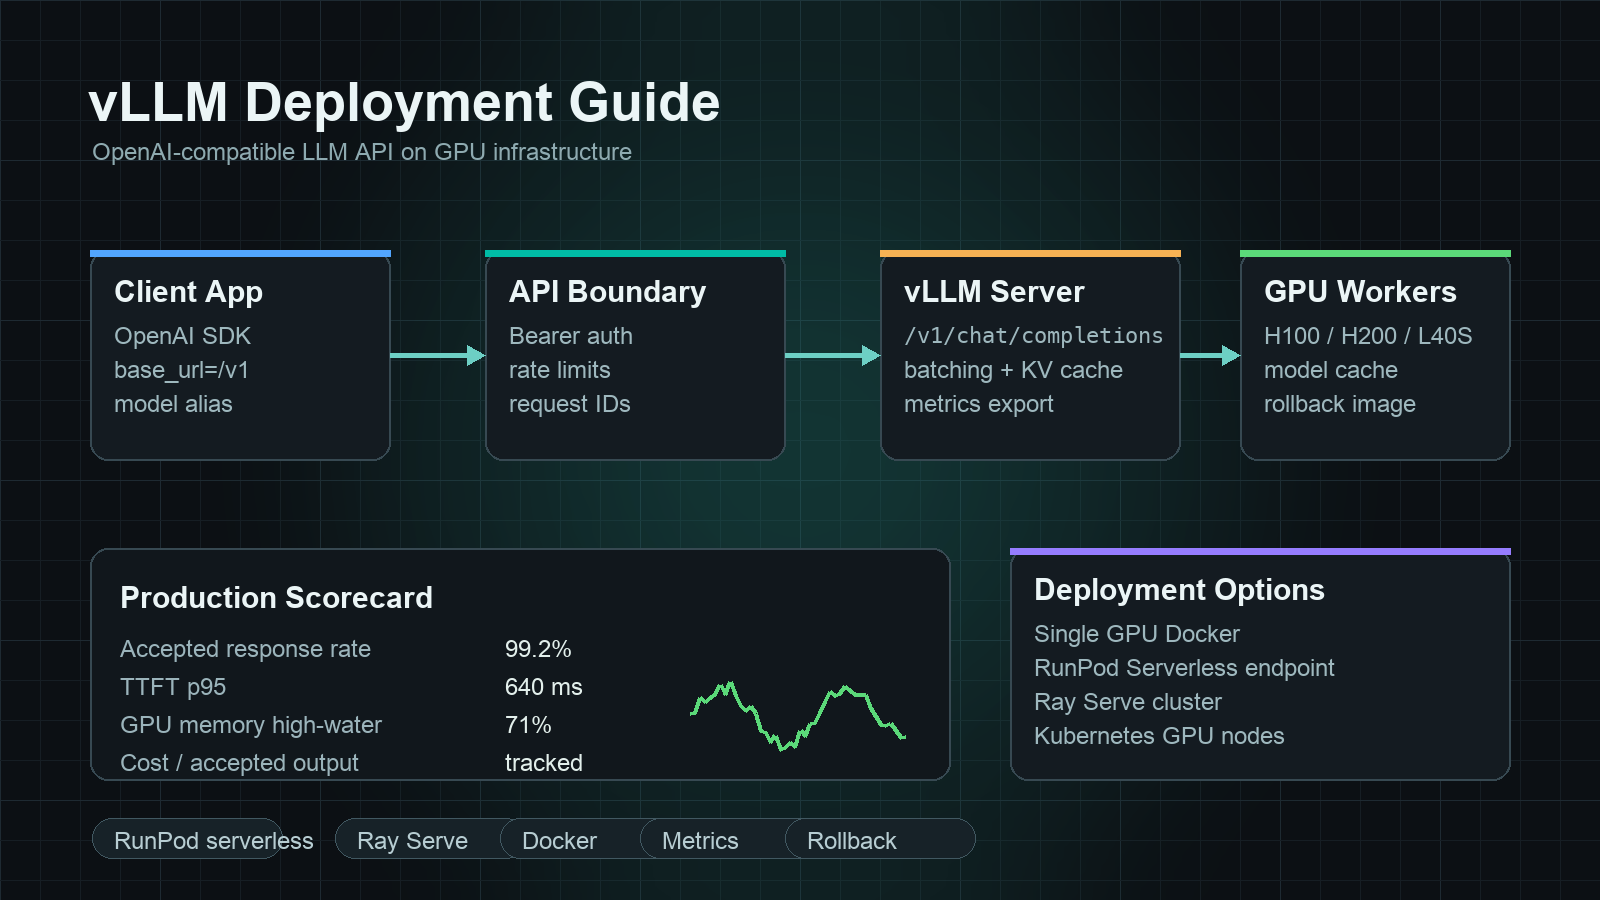
Panduan Deployment vLLM: Sajikan API LLM yang Kompatibel dengan OpenAI di GPU
Deploy vLLM sebagai API yang kompatibel dengan OpenAI di GPU dengan Docker, RunPod Serverless, Ray Serve, metrik, kontrol rollout, dan pengecekan biaya per output yang diterima.
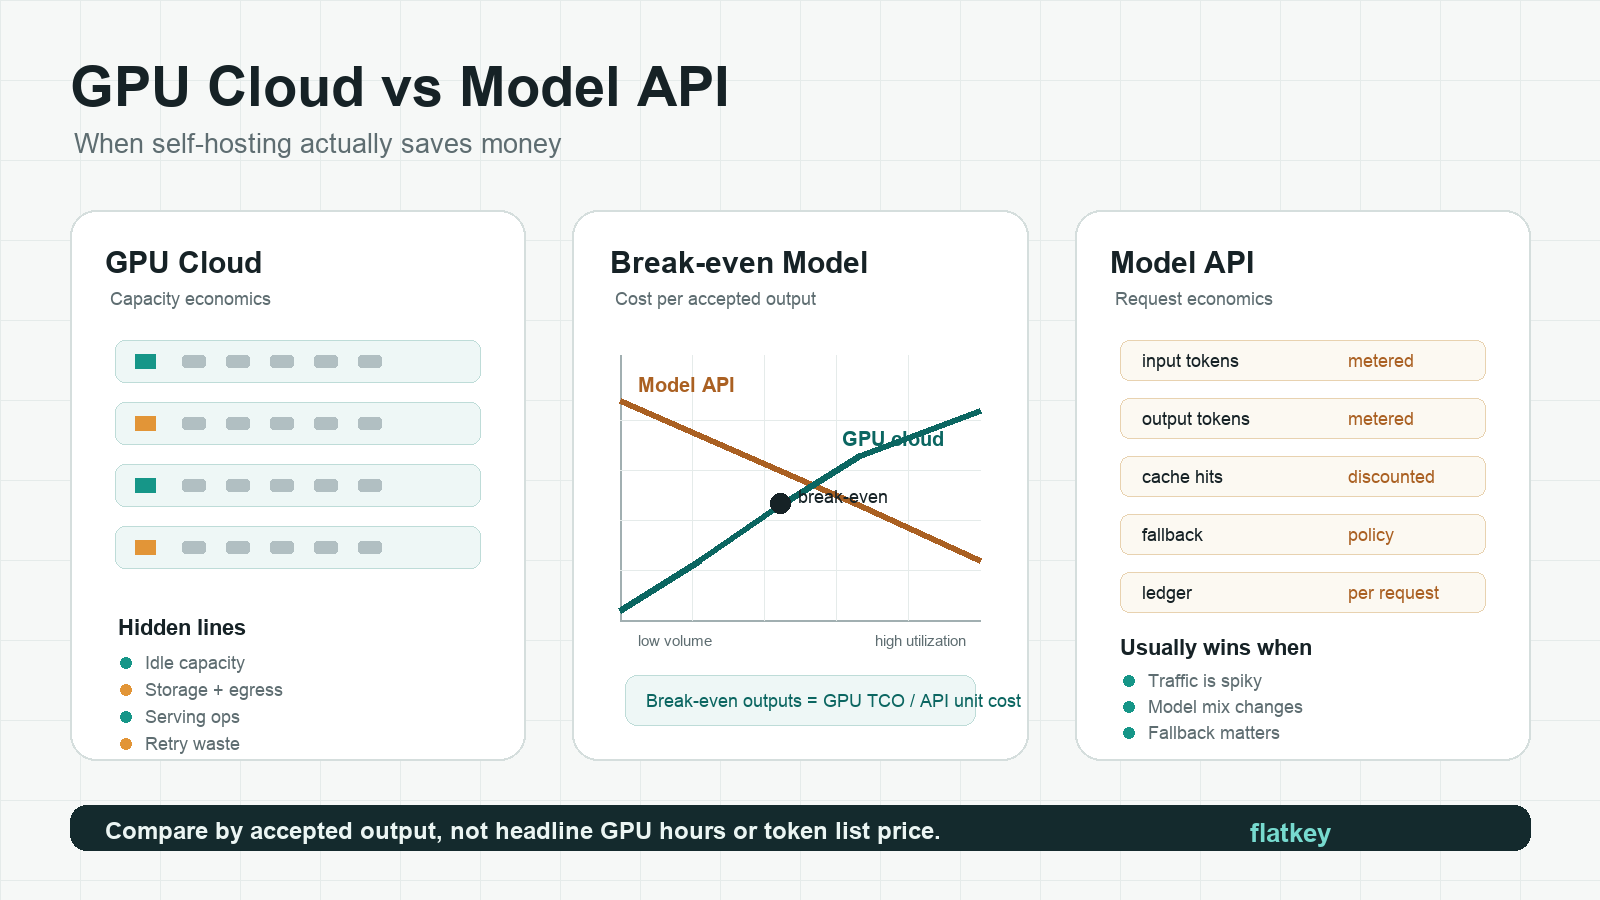
GPU Cloud vs Model API: Kapan Self-Hosting Benar-Benar Menghemat Biaya
Bandingkan ekonomi GPU cloud vs model API dengan lembar kerja titik impas untuk biaya output yang diterima, utilisasi, retry, kapasitas menganggur, dan operasi serving.
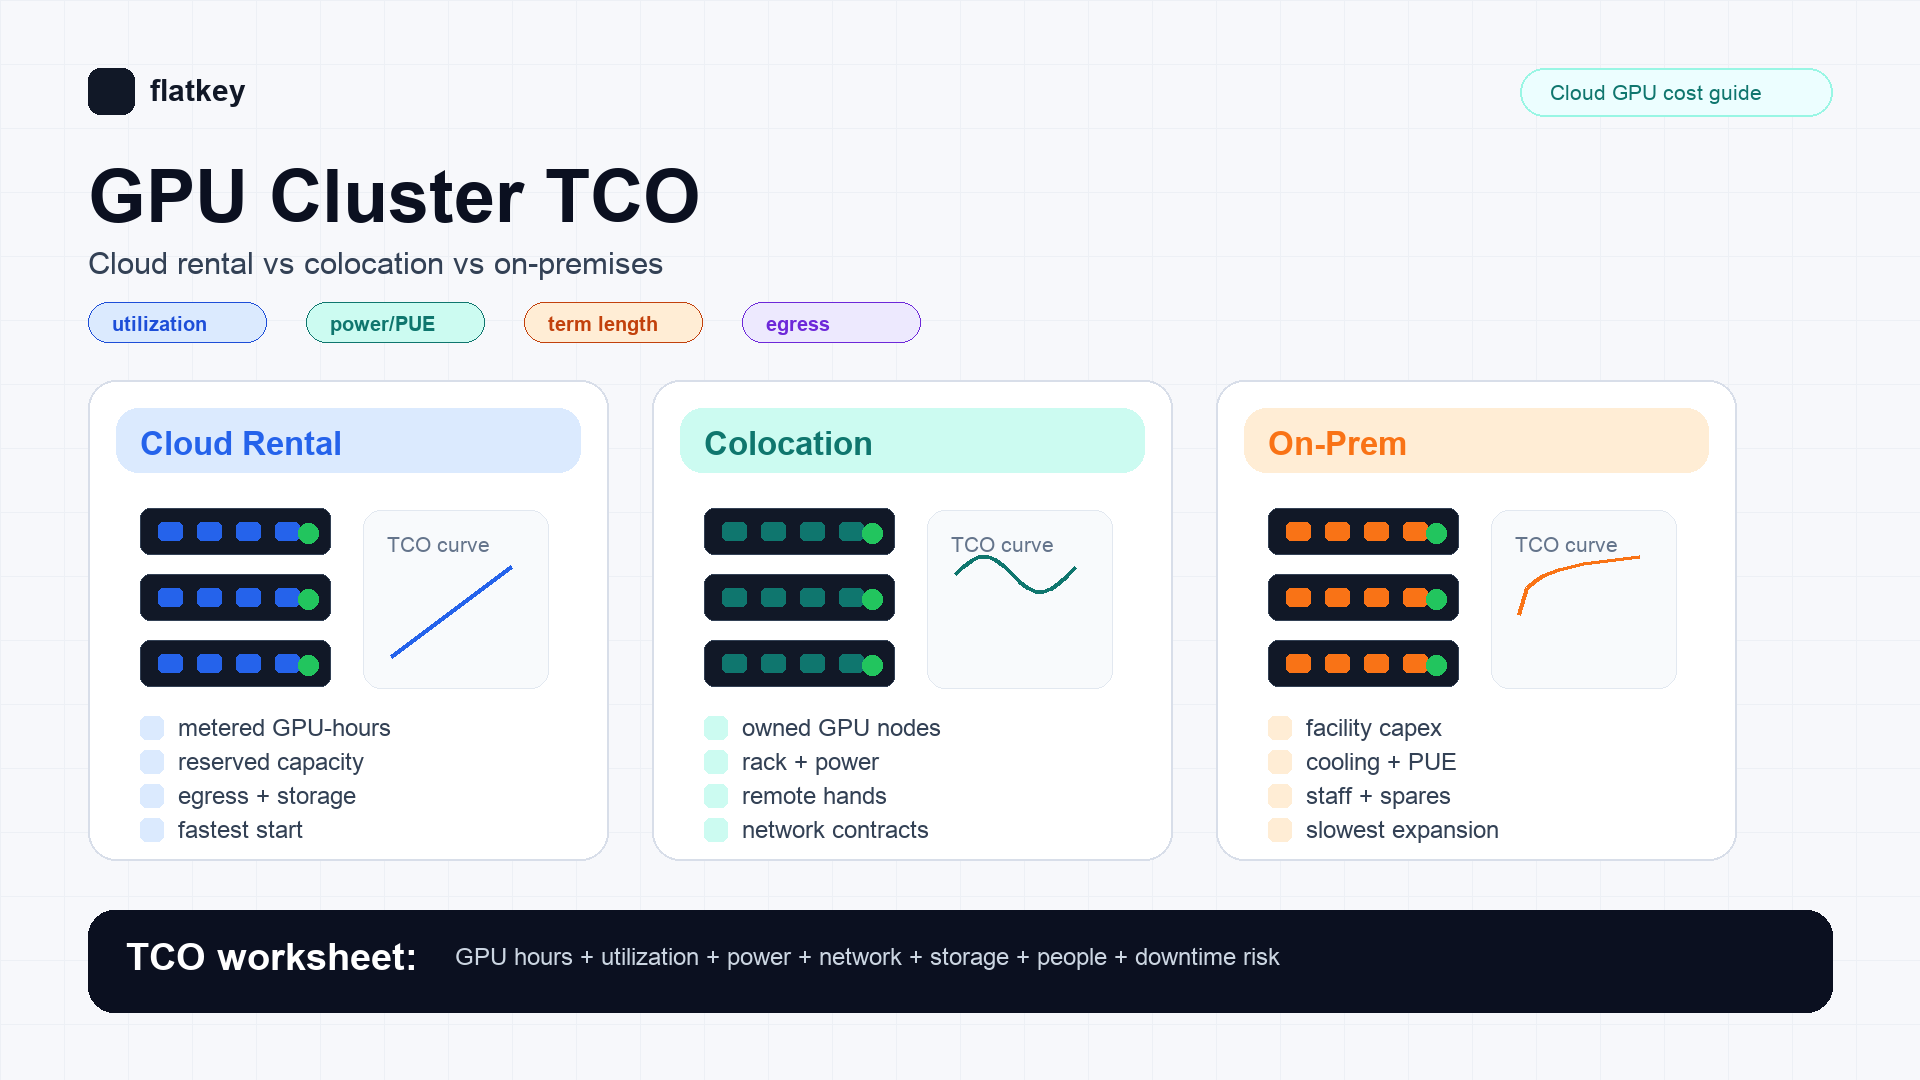
TCO Klaster GPU: Sewa Cloud vs Colocation vs On-Premises
Bandingkan TCO klaster GPU antara sewa cloud, colocation, dan on-premises dengan worksheet FinOps praktis untuk pembeli infrastruktur AI.
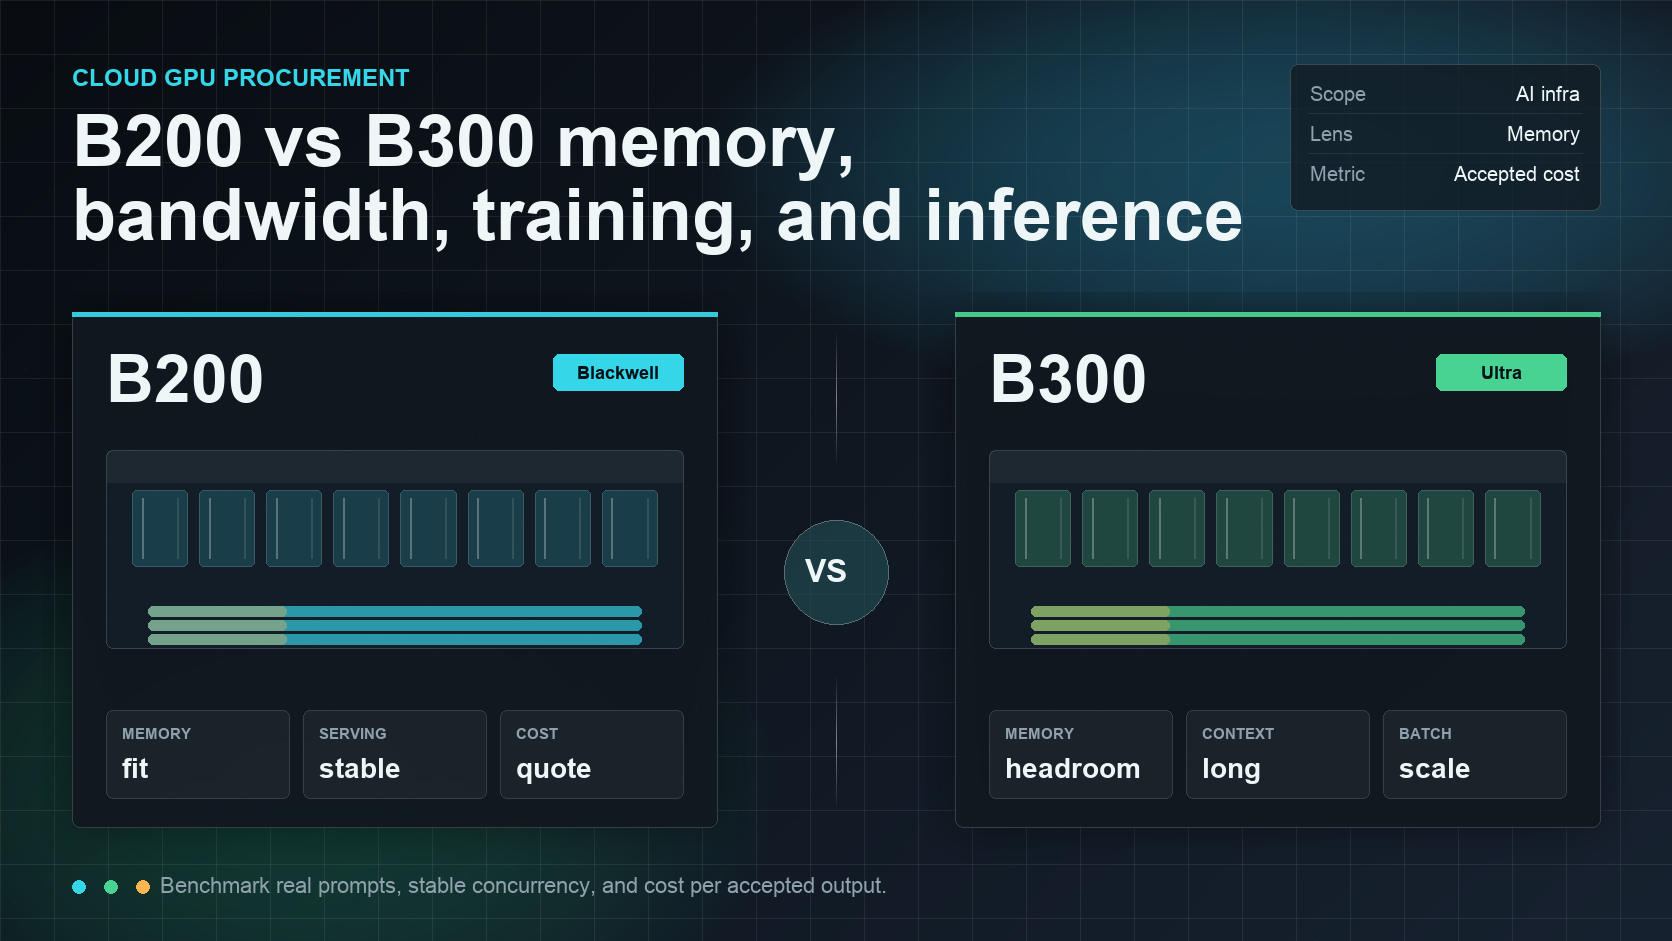
NVIDIA B300 vs B200: Memori, Bandwidth, Pelatihan, dan Inferensi
Perbandingan praktis B200 vs B300 untuk tim infrastruktur ML yang mengevaluasi memori GPU NVIDIA Blackwell, bandwidth, pelatihan, inferensi, dan ekonomi pengadaan.
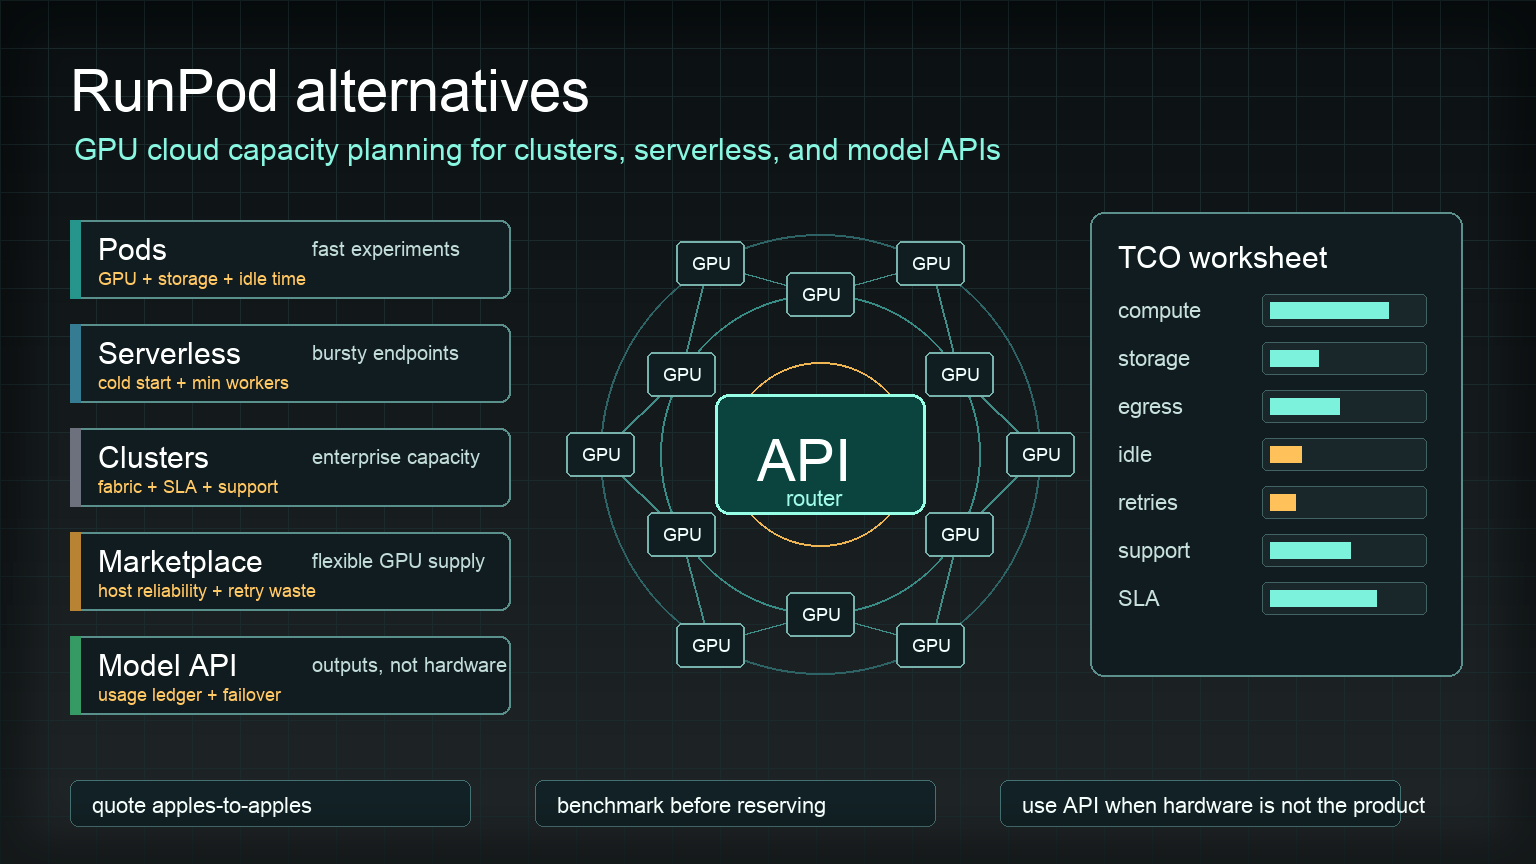
Alternatif RunPod untuk Klaster GPU Khusus dan Kapasitas Enterprise
Perbandingan praktis alternatif RunPod untuk developer dan tim AI yang mengevaluasi cloud GPU, marketplace, klaster khusus, inferensi serverless, dan API model.
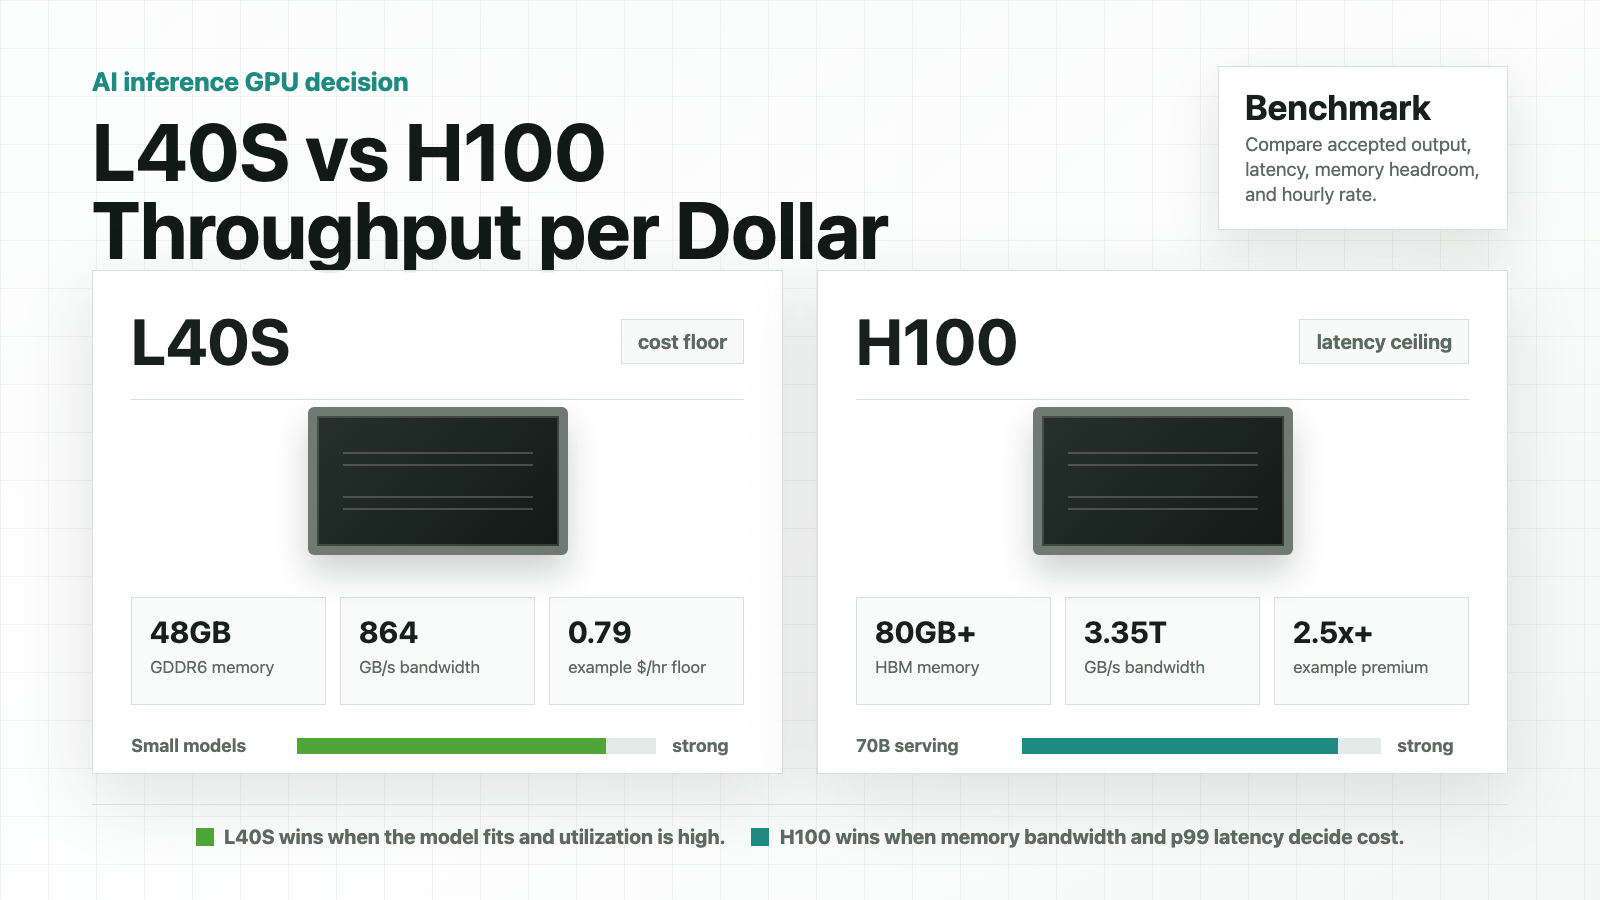
NVIDIA L40S vs H100 untuk AI Inference: Throughput per Dolar
Perbandingan praktis L40S vs H100 untuk tim AI yang mengevaluasi throughput inferensi, latensi, kecocokan memori, dan biaya GPU cloud per output yang diterima.
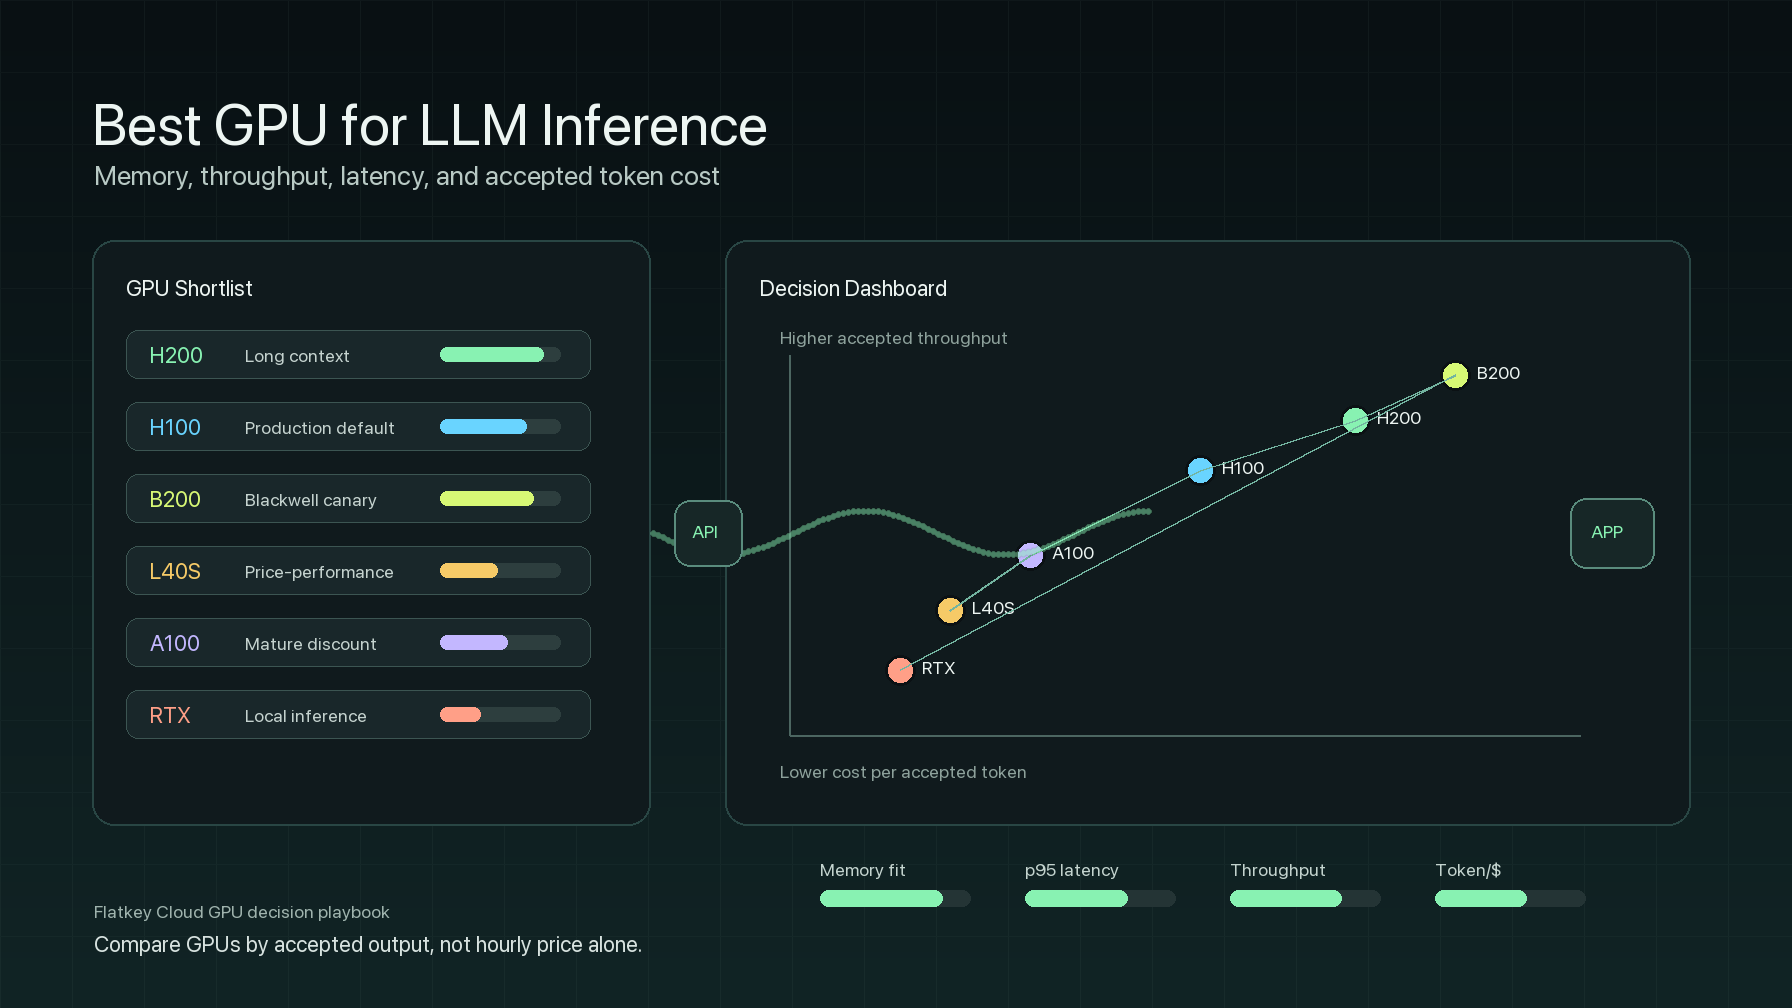
GPU Terbaik untuk Inferensi LLM: Memori, Throughput, Latensi, dan Biaya
Panduan praktis pemilihan GPU untuk tim enterprise yang menjalankan inferensi LLM, membandingkan H100, H200, B200, A100, L40S, GPU lokal kelas RTX, token per dolar, latensi p95, kecocokan memori, dan biaya per token yang diterima.
Bangun lebih cepat dengan satu gateway AI.
Gunakan flatkey.ai untuk mengelola model, kunci, penagihan, dan observabilitas dari satu platform API.
Mulai