
Blog flatkey.ai
Insight, catatan produk, dan panduan implementasi untuk tim yang membangun di atas AI API.
AI Gateway Architecture
Artikel terbaru dalam AI Gateway Architecture.
Baca selengkapnyaBase URL and SDK Migration
Artikel terbaru dalam Base URL and SDK Migration.
Baca selengkapnyaCost, Billing, and Ops
Artikel terbaru dalam Cost, Billing, and Ops.
Baca selengkapnyaEnterprise Controls and Trust
Artikel terbaru dalam Enterprise Controls and Trust.
Baca selengkapnyaGateway Comparisons
Artikel terbaru dalam Gateway Comparisons.
Baca selengkapnyaModel and Modality Playbooks
Artikel terbaru dalam Model and Modality Playbooks.
Baca selengkapnyaReliability and Routing
Artikel terbaru dalam Reliability and Routing.
Baca selengkapnyaTool Integrations
Artikel terbaru dalam Tool Integrations.
Baca selengkapnya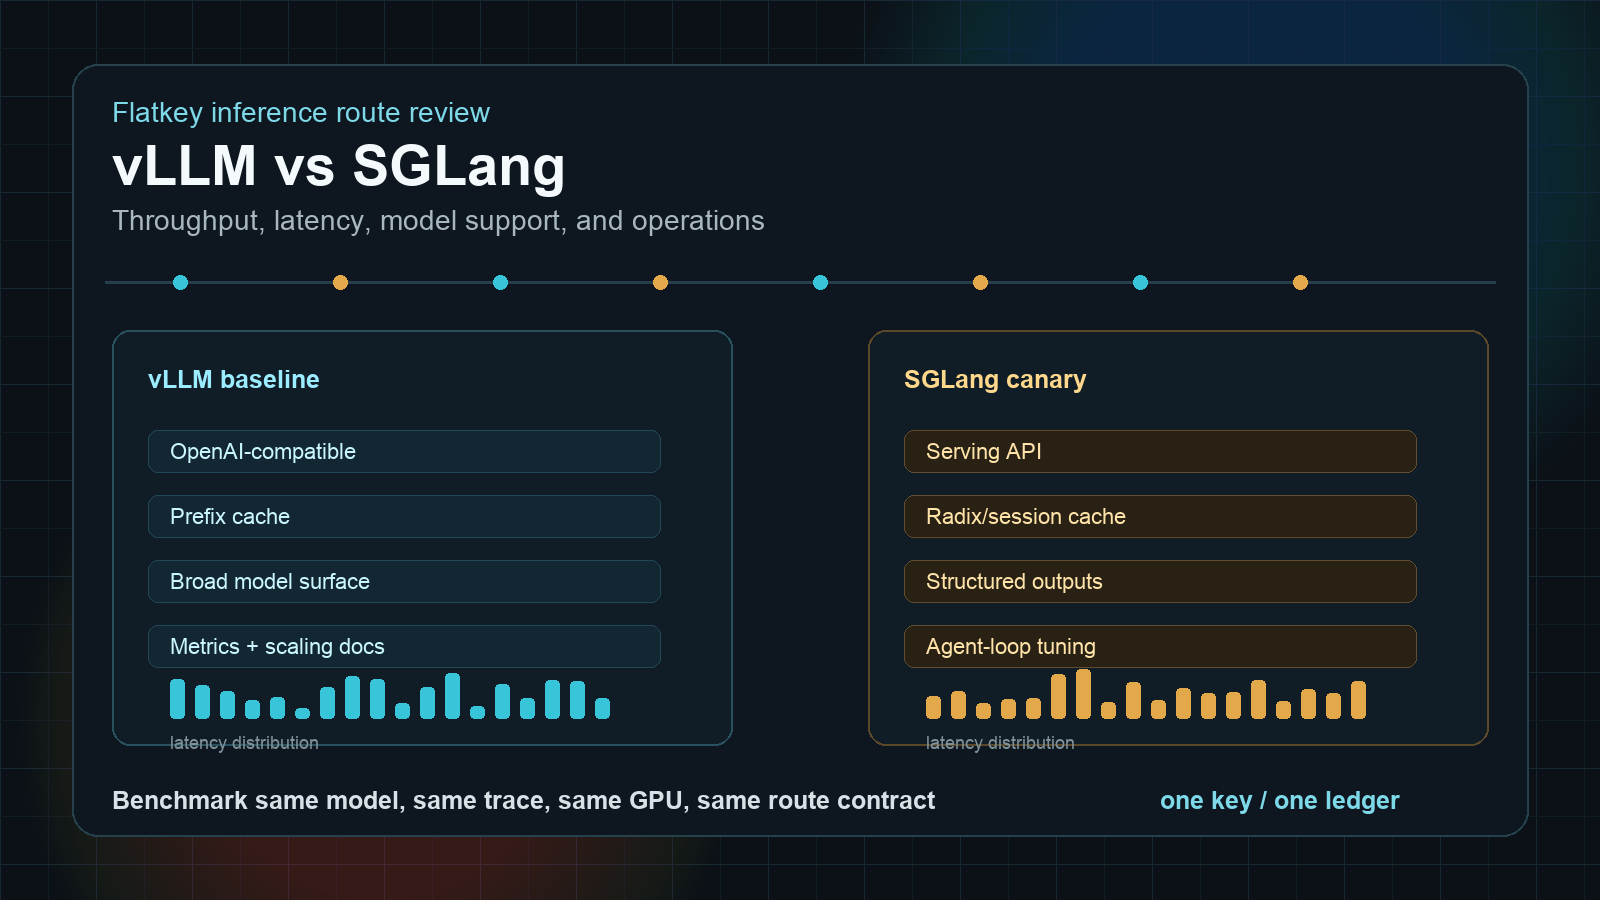
vLLM vs SGLang: Throughput, Latensi, Dukungan Model, dan Operasi
Bandingkan SGLang vs vLLM untuk inferensi GPU cloud: throughput, latensi, dukungan model, operasional, benchmark, dan kapan Ollama cocok untuk pengujian lokal.
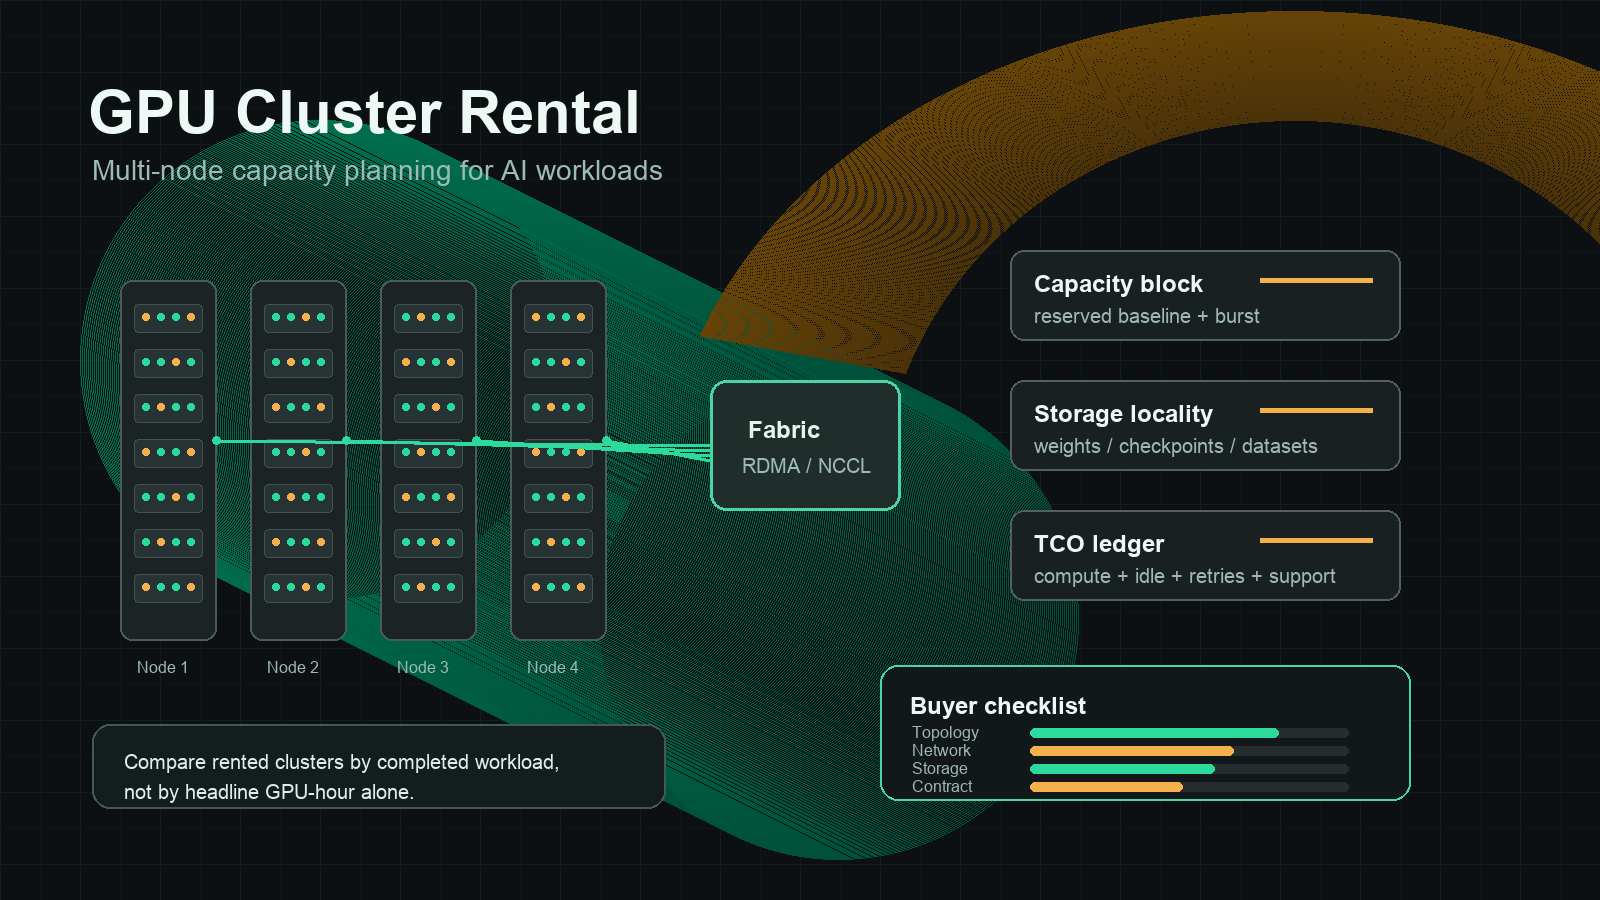
Sewa GPU Cluster: Panduan Pembeli untuk Kapasitas AI Multi-Node
Panduan pembeli untuk tim AI enterprise yang mengevaluasi sewa GPU cluster multi-node, penyedia cloud, kapasitas terpesan, fabric jaringan, penyimpanan, dan TCO.

NVIDIA H200 vs H100: Kapasitas Memori, Throughput, dan Biaya
Panduan pembelian praktis H100 vs H200 untuk tim AI yang membandingkan kapasitas memori, throughput LLM, kecocokan untuk training, harga GPU cloud, dan biaya total untuk beban kerja yang selesai.
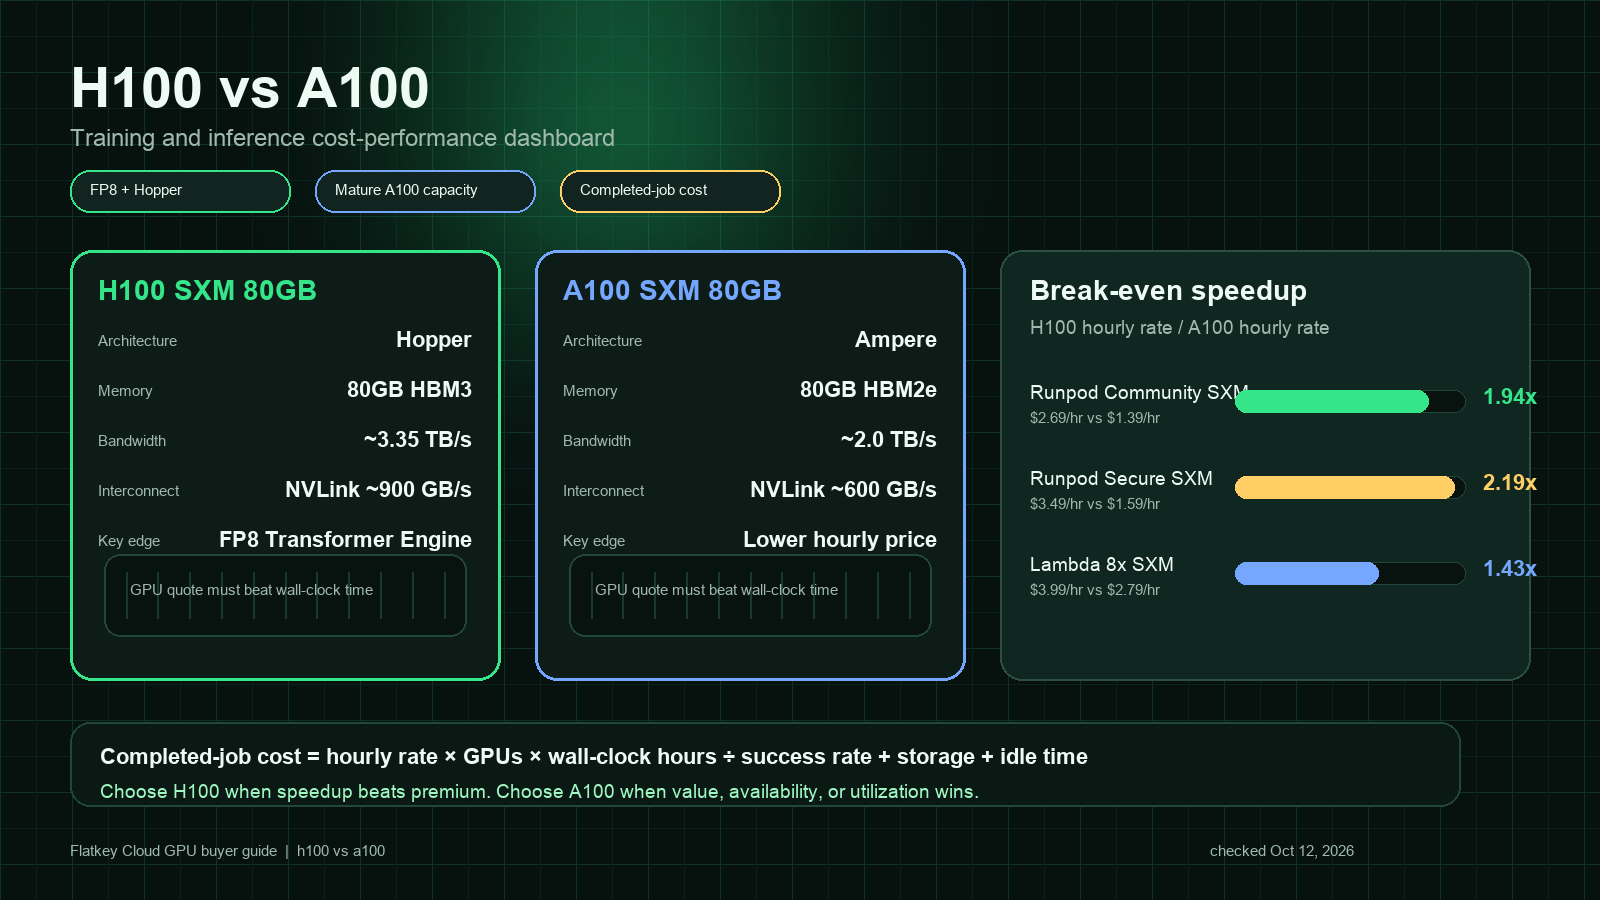
NVIDIA H100 vs A100: Performa Biaya untuk Training dan Inference
Perbandingan praktis H100 vs A100 bagi tim AI yang memilih antara performa Hopper dan nilai Ampere untuk training, inference, dan sewa GPU cloud.
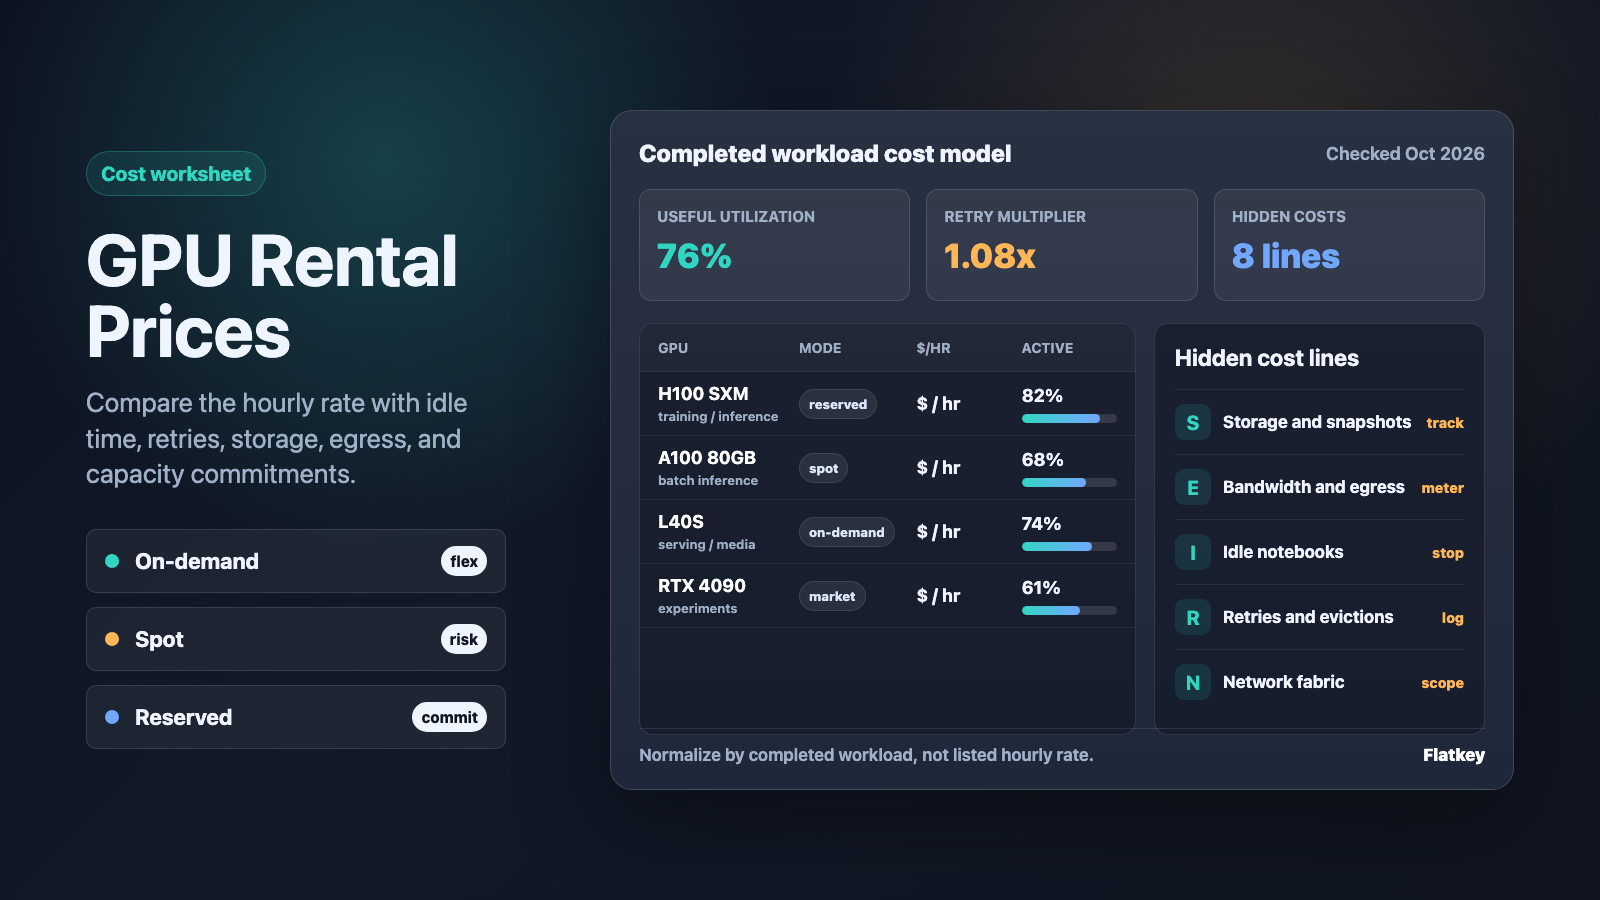
Harga Sewa GPU Dijelaskan: On-Demand, Spot, Reserved, dan Biaya Tersembunyi
Panduan praktis untuk membandingkan harga sewa GPU berdasarkan biaya beban kerja yang selesai, bukan hanya tarif per jam, dengan pengecekan sumber untuk model on-demand, spot, reserved, marketplace, dan biaya tersembunyi.

LLM API dengan Jendela Konteks Terbesar: Model Mana yang Bisa Menangani 1 Juta Token?
Panduan berbasis sumber tentang rute API LLM long-context saat ini, alasan 1 juta token tidak otomatis lebih baik, dan cara menguji model ID sebelum diluncurkan.
API LLM Gratis 2026: 12 Opsi, Batas Rate, dan Batas Tersembunyi
Bandingkan API LLM gratis 2026 berdasarkan jenis kuota, batas rate, catatan konteks, kredit trial, API lokal, dan batas tersembunyi sebelum mulai membangun.
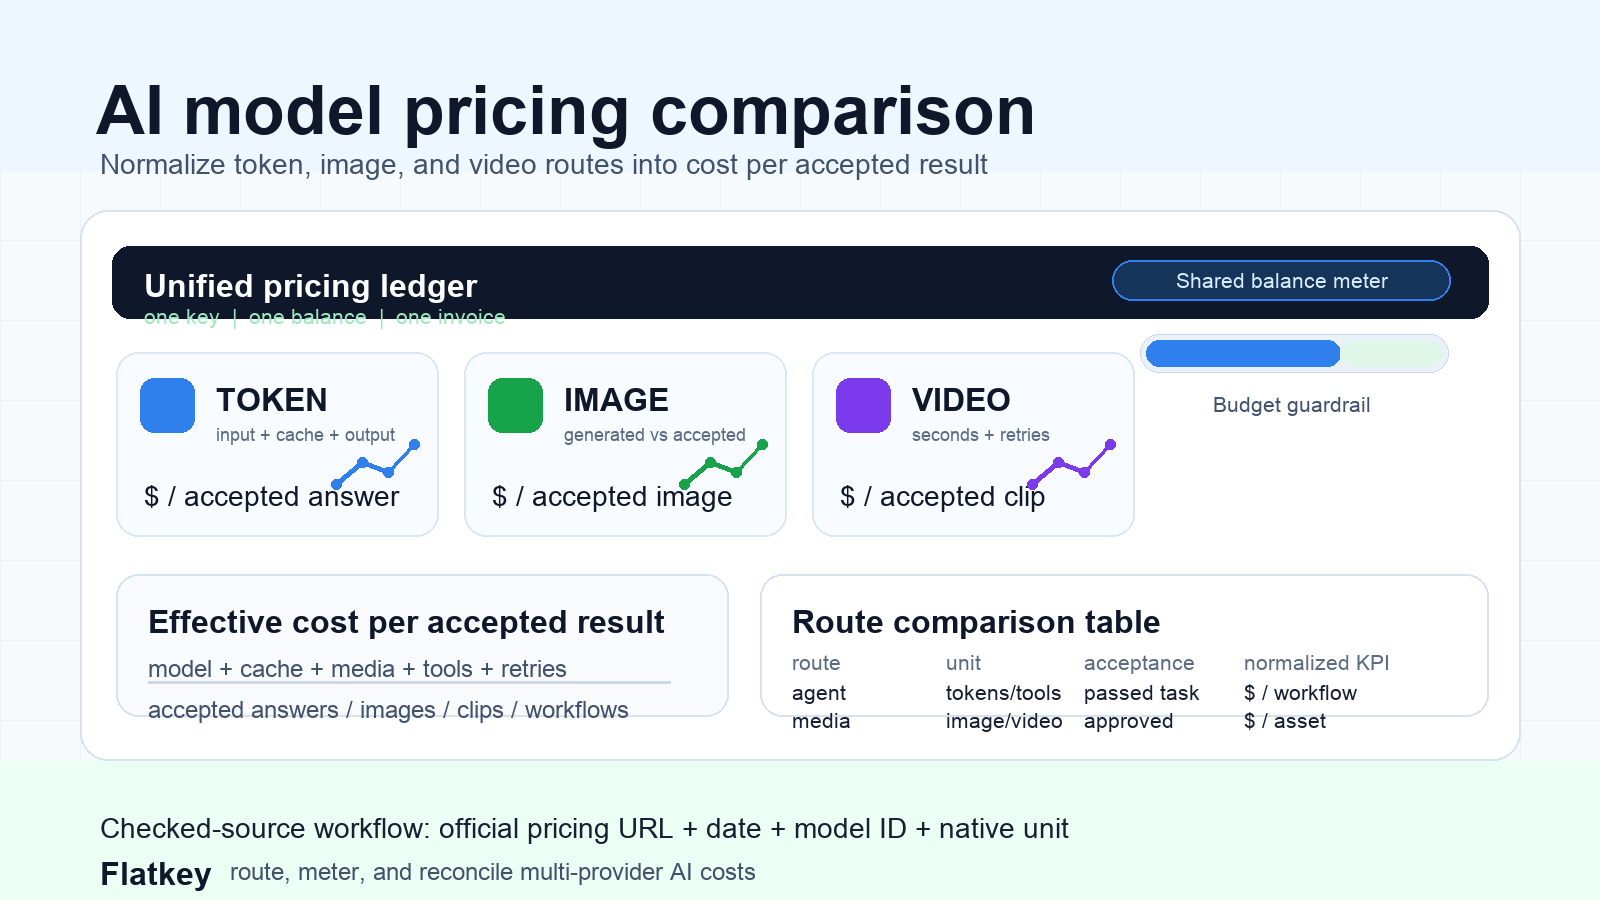
Perbandingan Harga Model AI: Biaya Token, Gambar, dan Video dalam Satu Dashboard
Bandingkan harga model AI untuk teks, gambar, video, dan rute API multi-provider dengan dashboard untuk biaya per hasil yang diterima.
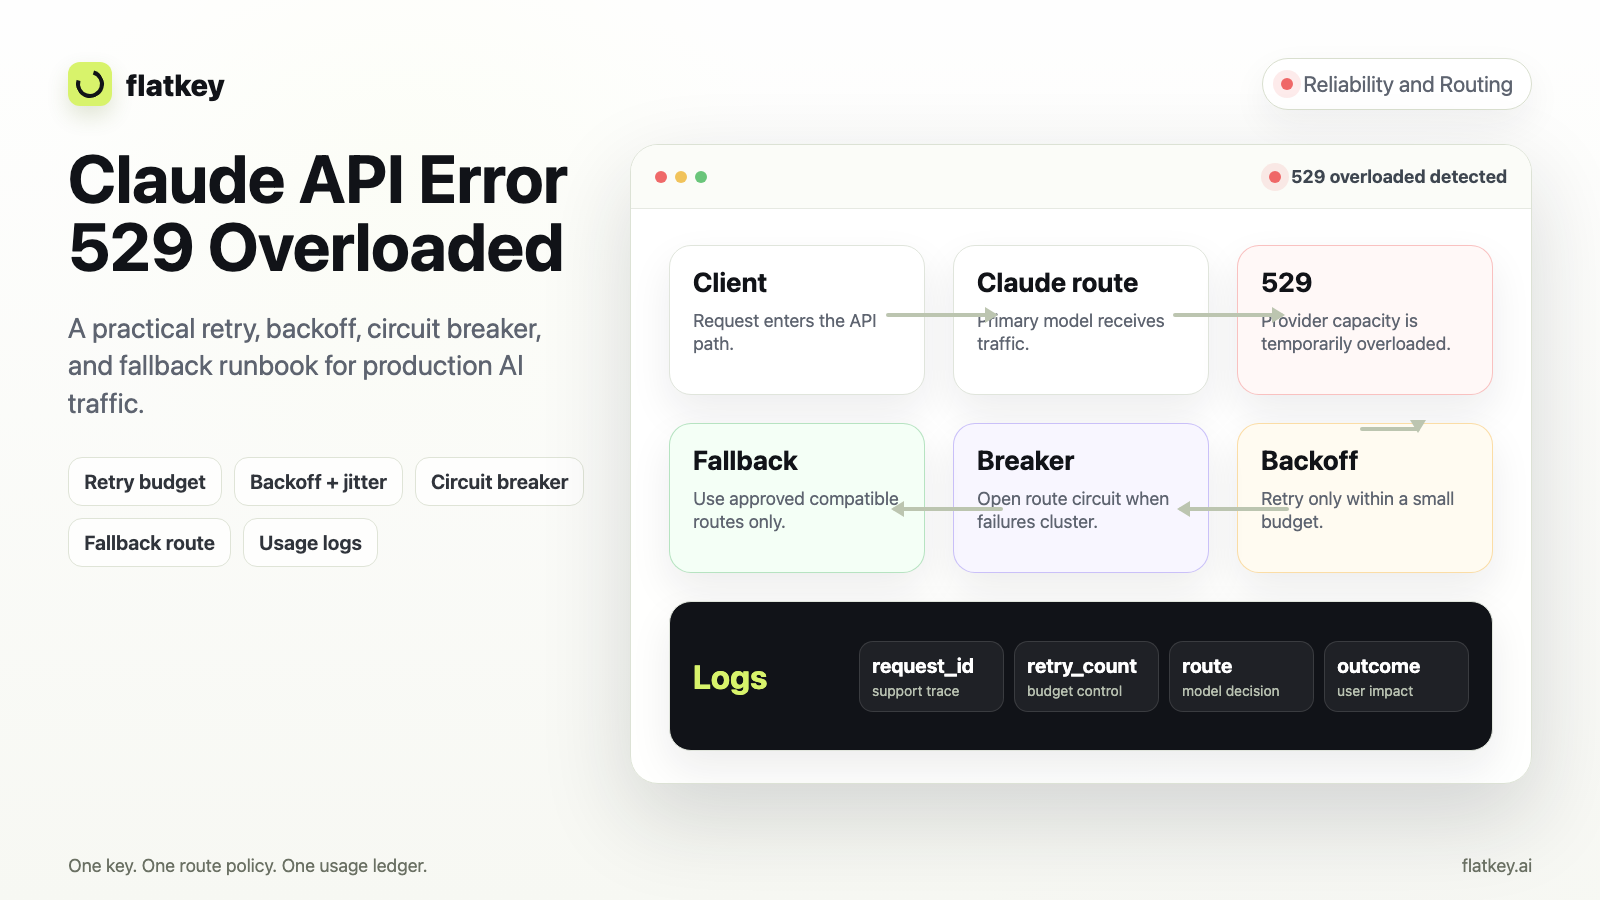
Claude API Error 529 Overloaded: Runbook Retry, Backoff, dan Fallback
Runbook produksi untuk error Claude API 529 overloaded: klasifikasikan kegagalan, tetapkan anggaran retry, tambahkan backoff dan jitter, lindungi side effect, gunakan circuit breaker untuk overload berulang, dan pilih rute fallback yang aman.
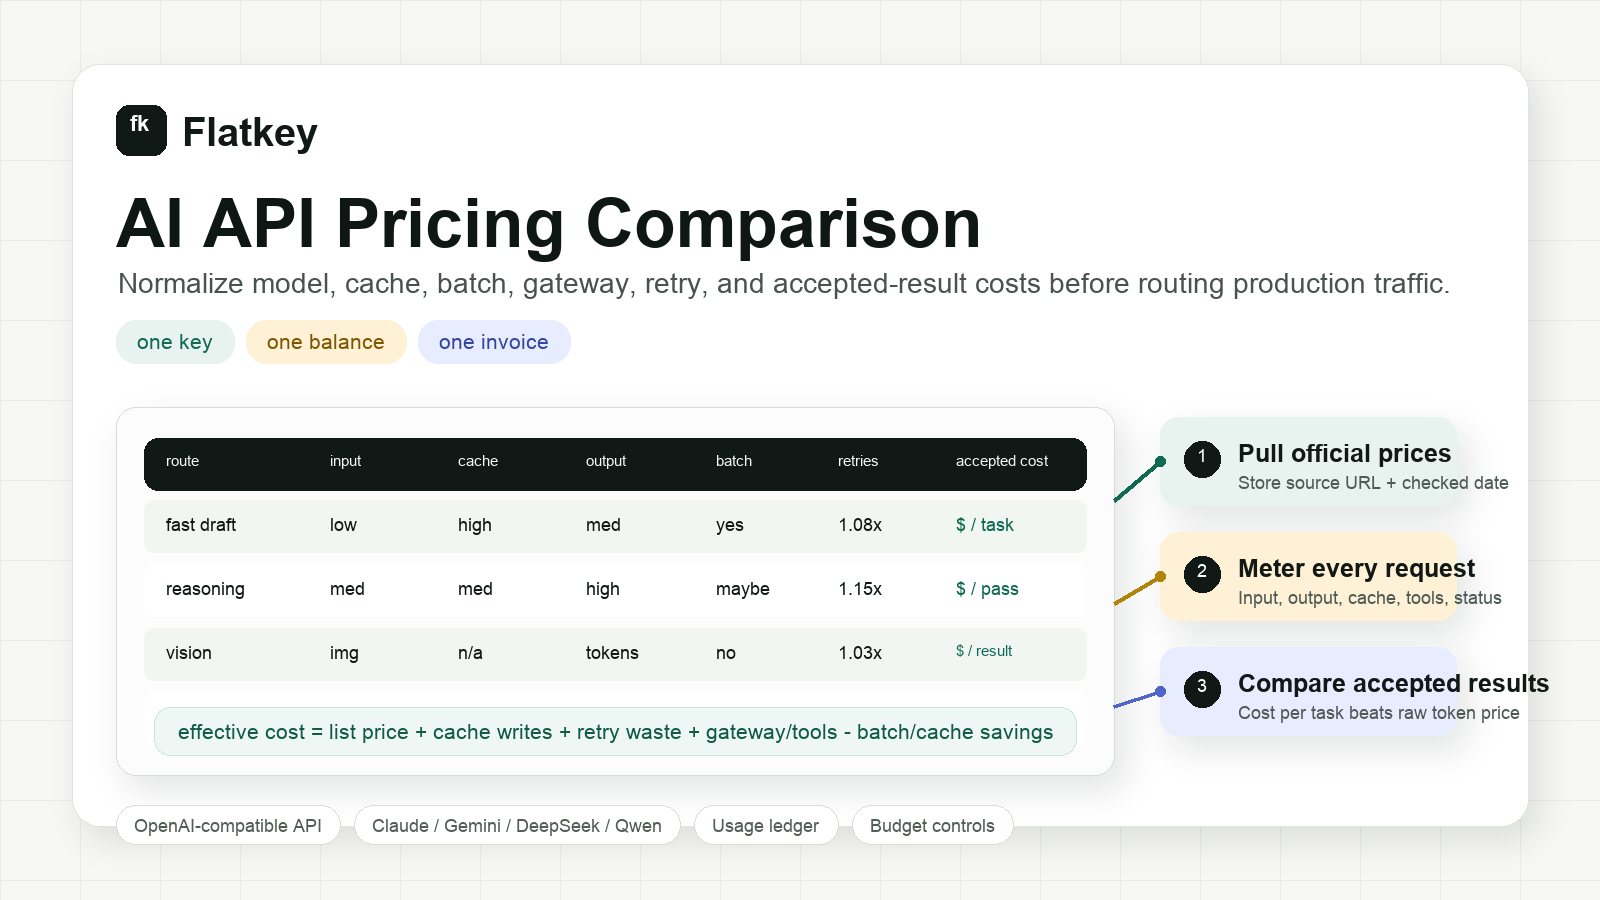
Perbandingan Harga API AI: Biaya Model, Cache, Batch, dan Gateway
Kerangka praktis perbandingan harga API AI untuk developer, tim produk, dan tim pengadaan dalam membandingkan biaya model, cache, batch, gateway, retry, dan hasil yang diterima.

DeepSeek V4 Pro vs Flash: Model Mana yang Cocok untuk Workflow API Anda?
Bandingkan DeepSeek V4 Pro vs Flash untuk routing API, harga, vision, concurrency, biaya cache, dan kapan menggunakan Pro atau Flash.
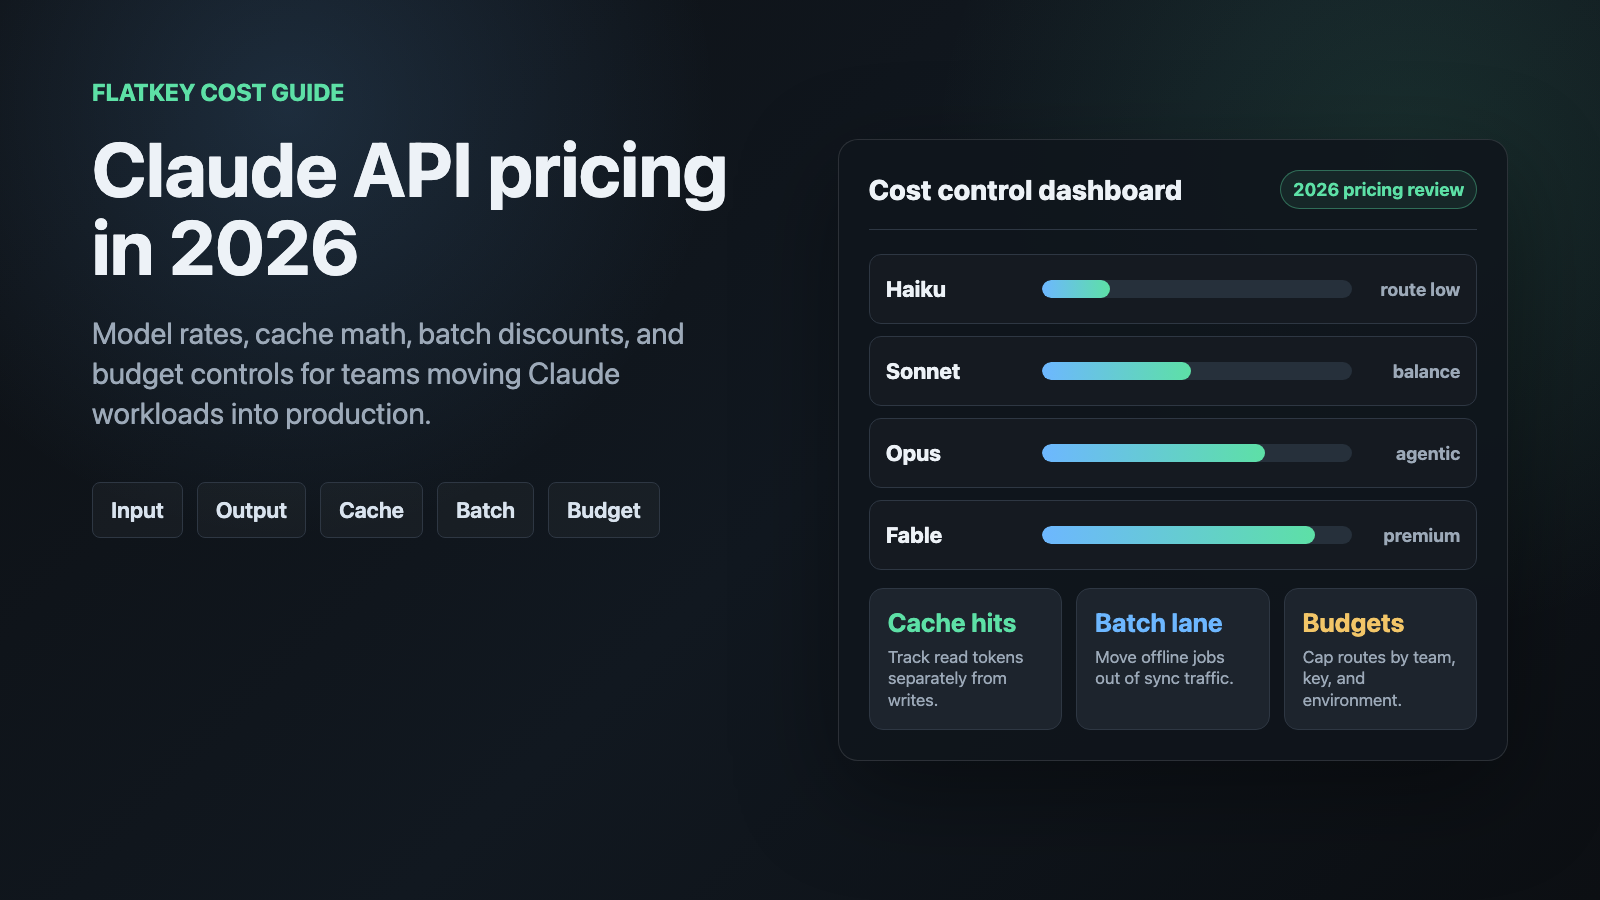
Harga API Anthropic Claude 2026: Biaya Model, Matematik Cache, dan Kontrol Anggaran
Bandingkan harga API Anthropic Claude 2026 berdasarkan model, penulisan cache, pembacaan cache, diskon batch, dan kontrol anggaran untuk tim produk dan pengadaan.
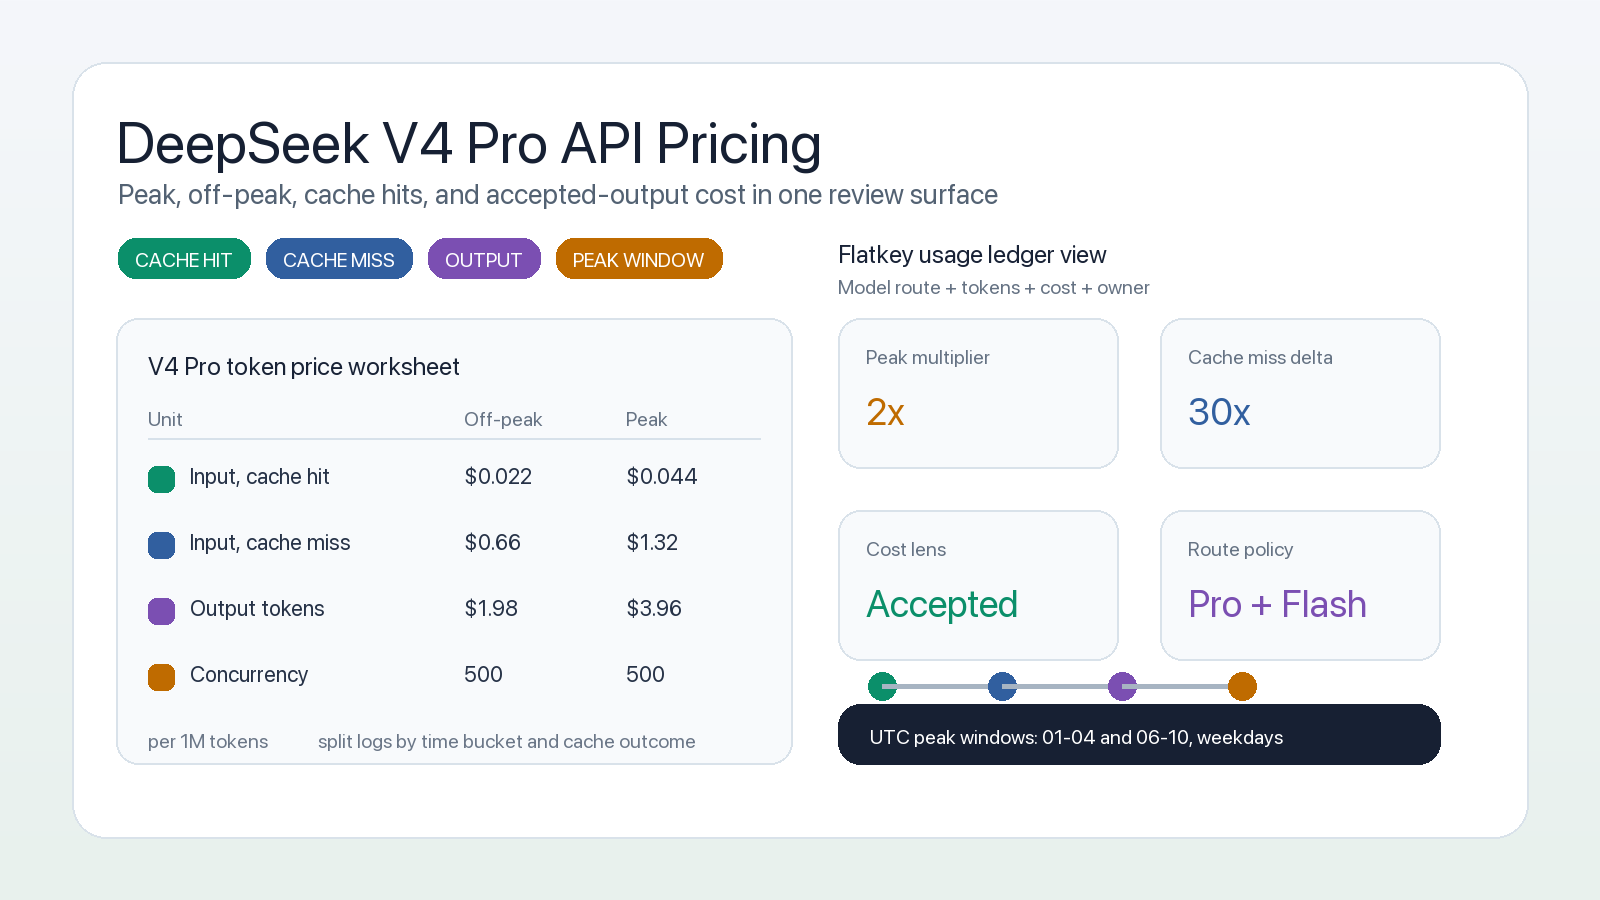
Harga API DeepSeek V4 Pro: Jam Sibuk, Jam Sepi, dan Biaya Cache
Harga API DeepSeek V4 Pro terkini dengan tarif jam sibuk/jam sepi, perhitungan cache-hit, dan lembar kerja pengendalian biaya untuk developer dan tim pengadaan.
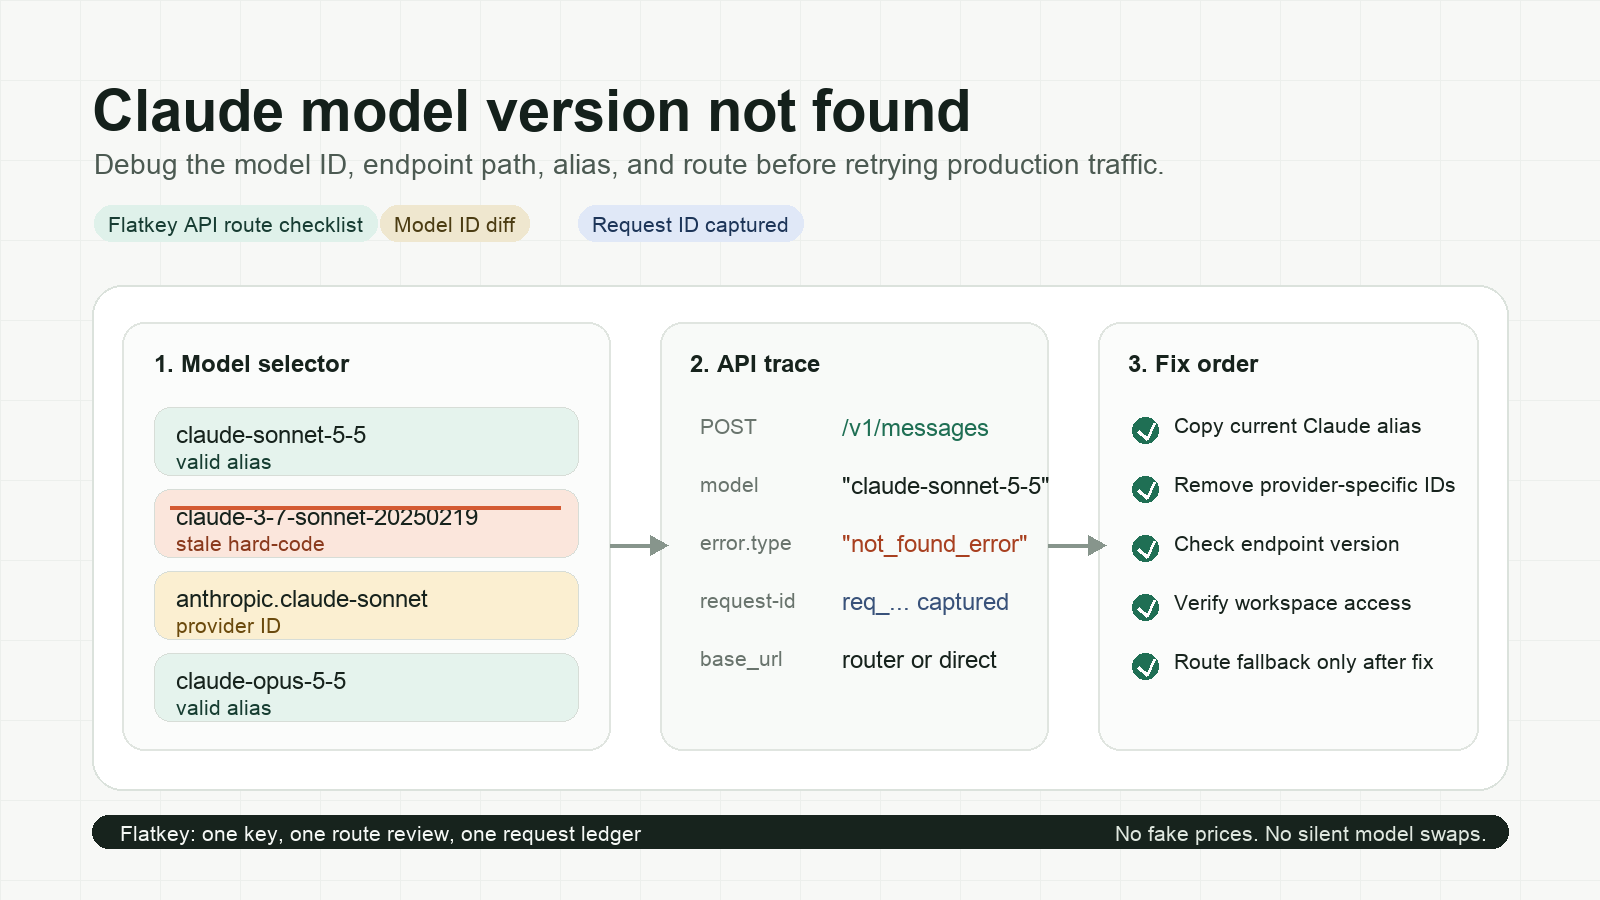
Claude Model Version Not Found: Perbaiki Wrong Model IDs, Alias, dan API Routes
Panduan debug praktis untuk error Claude model version not found di Anthropic-native APIs, router, cloud-provider IDs, konfigurasi agen, dan fallback produksi.
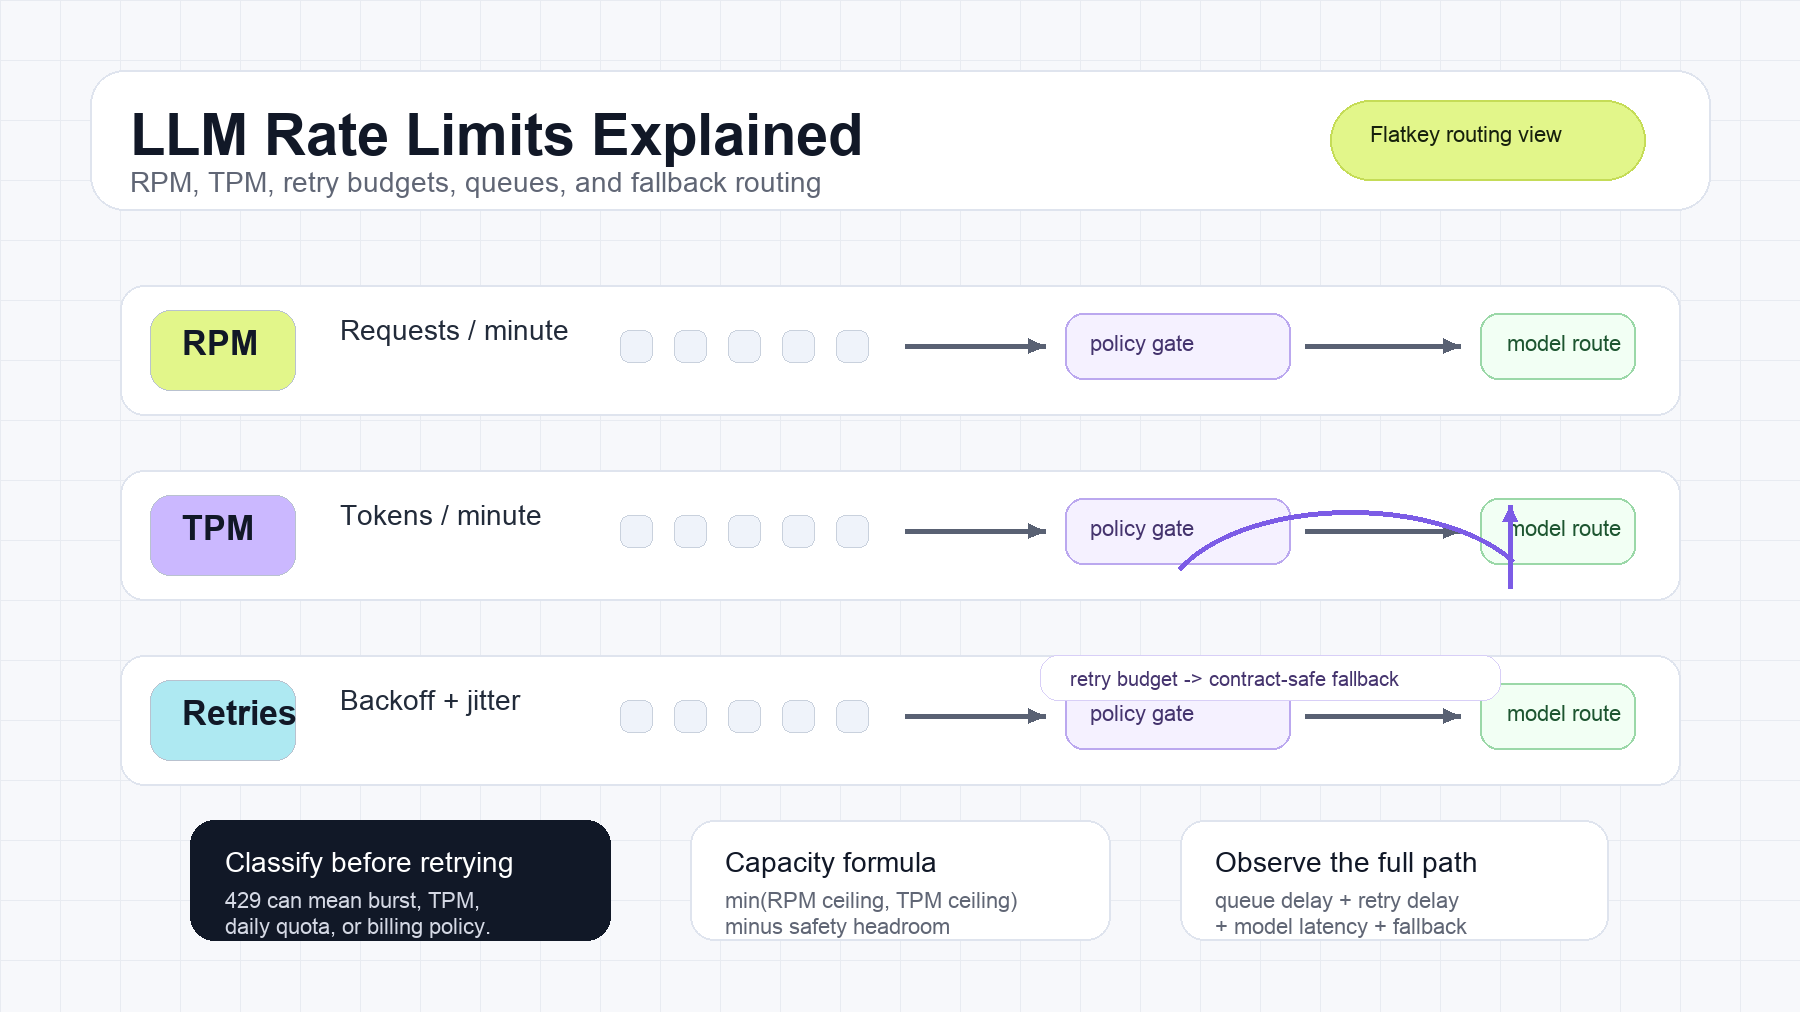
Penjelasan Batas Laju LLM: RPM, TPM, dan Retry
Pahami batas laju LLM, RPM, TPM, error 429, Retry-After, exponential backoff, retry budget, antrean, dan fallback routing.

Akses API GLM-5: Harga dan Pengaturan Kompatibel OpenAI
Bandingkan harga API keluarga GLM-5, ID model, jendela konteks, dan pola pengaturan kompatibel OpenAI untuk Z.AI dan Flatkey.
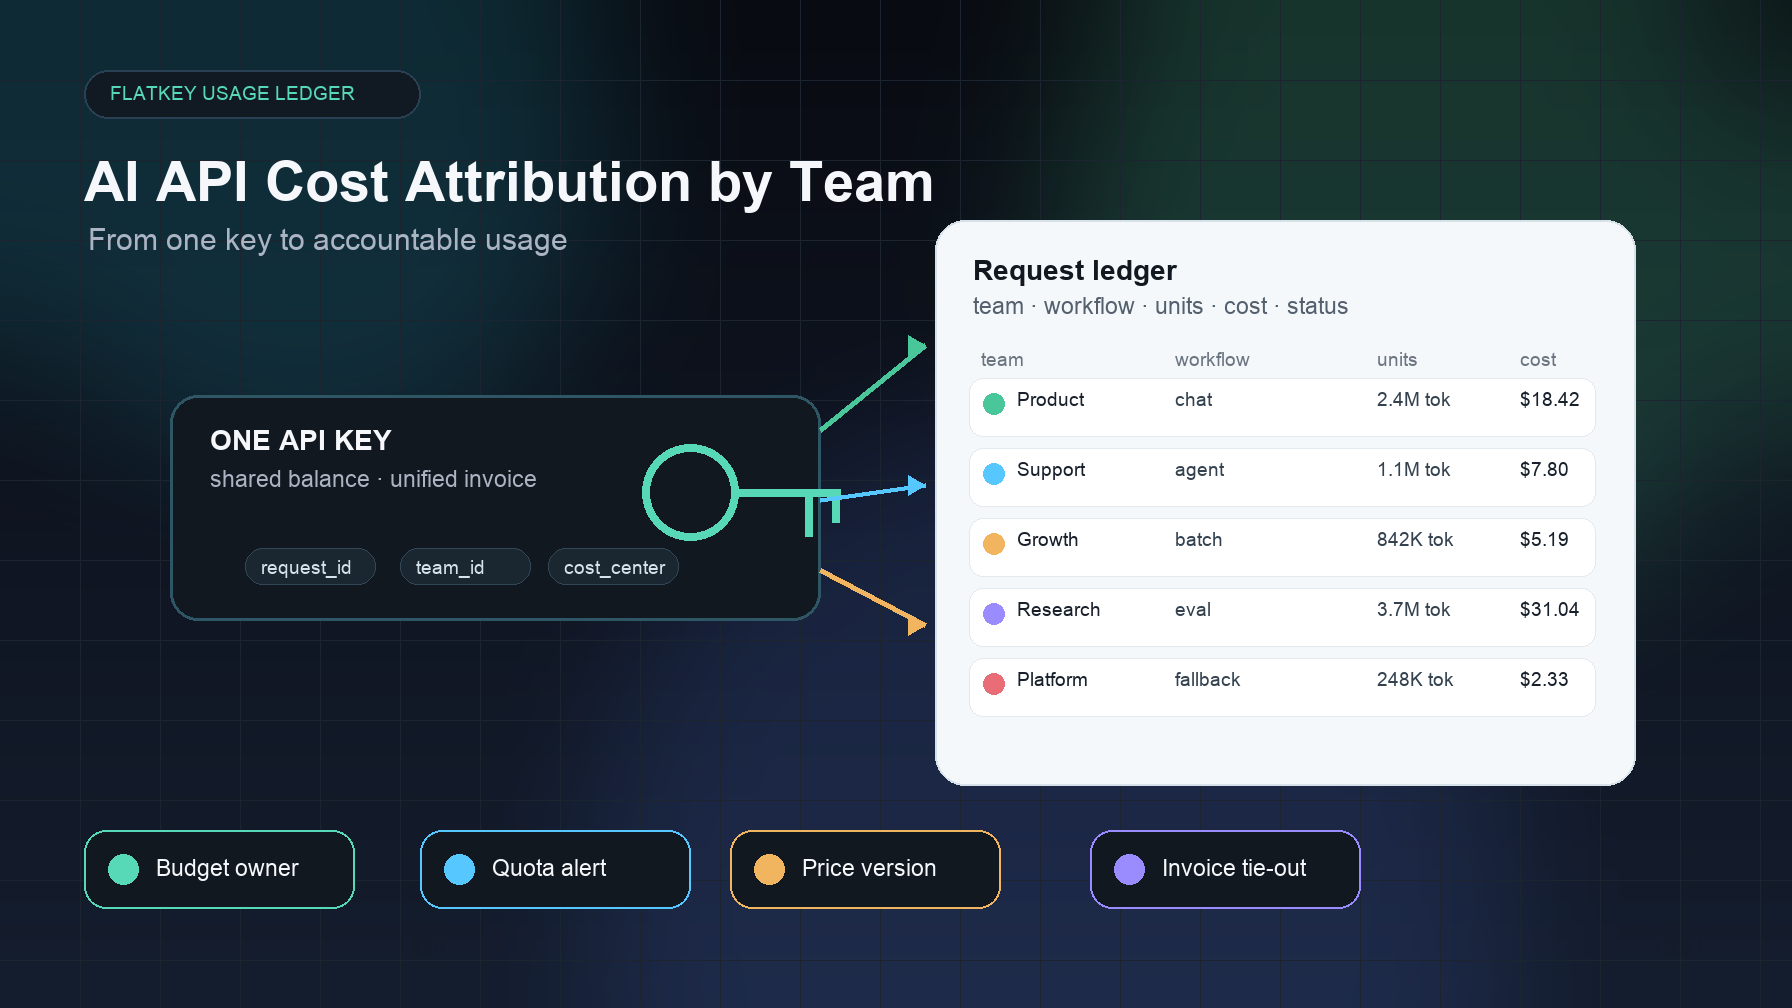
Attribution Biaya AI API per Tim: Dari Satu Key ke Penggunaan yang Akuntabel
Bangun attribution biaya AI API per tim dengan request tags, batas sub-key, ledger penggunaan, kuota, dan review keuangan bulanan.
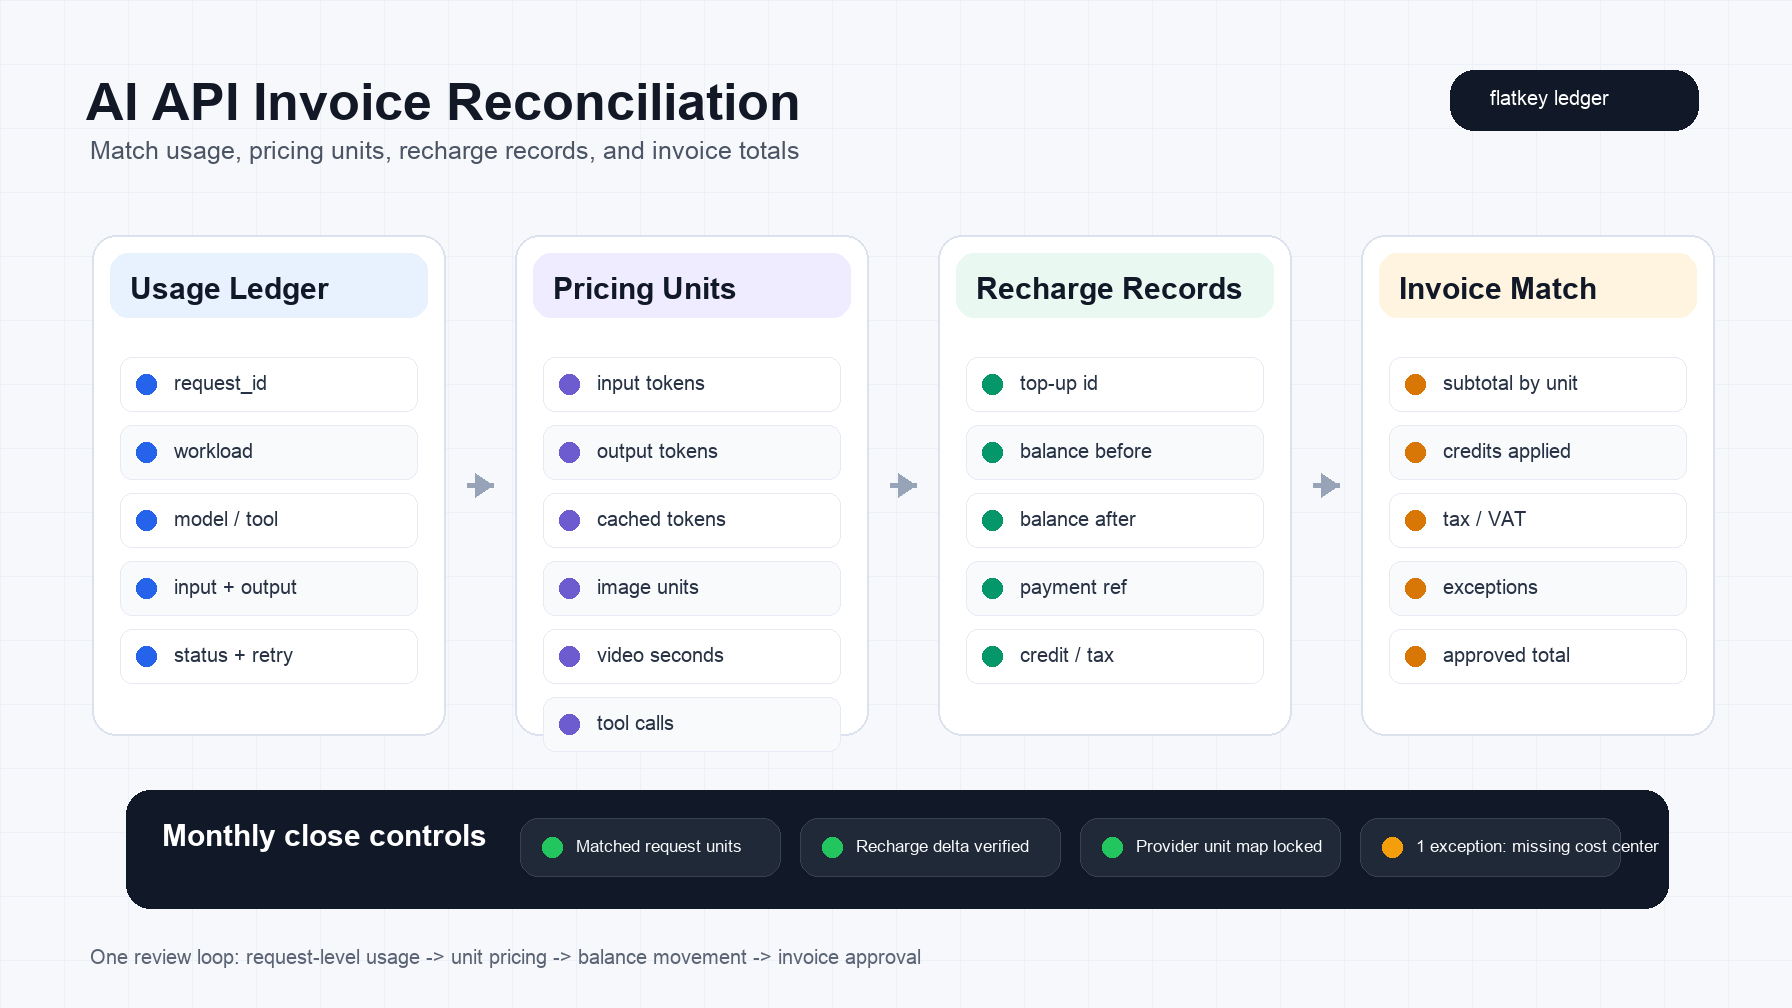
Rekonsiliasi Faktur AI API: Cocokkan Penggunaan, Unit Harga, dan Catatan Isi Ulang
Rekonsiliasikan faktur AI API dengan mencocokkan buku besar penggunaan, unit harga, catatan isi ulang, pergerakan saldo, kredit, pajak, dan total faktur.
Bangun lebih cepat dengan satu gateway AI.
Gunakan flatkey.ai untuk mengelola model, kunci, penagihan, dan observabilitas dari satu platform API.
Mulai