
Cost, Billing, and Ops
Artikel terbaru dalam Cost, Billing, and Ops.

Bangun OpenAI-Compatible Inference Server di GPU Anda Sendiri: Panduan API OpenAI-Compatible vLLM Inference Server
Bangun API OpenAI-compatible untuk vLLM inference server di GPU Anda sendiri, lalu perkuat dengan migrasi SDK, kontrol edge, pengujian, metrik, dan fallback routing.

Panduan VRAM Model 32B dan 70B: Opsi Single-GPU dan Multi-GPU
Pelajari kebutuhan VRAM praktis untuk model 32B dan 70B pada inferensi 4-bit, 8-bit, FP16/BF16, Ollama, fine-tuning QLoRA, dan opsi multi-GPU.

GPU Terbaik untuk Pelatihan LLM: Skala, Memori, Jaringan, dan Anggaran
Panduan praktis 2026 untuk memilih GPU terbaik untuk pelatihan LLM berdasarkan skala, memori, jaringan, kecocokan penyedia, dan biaya per checkpoint yang selesai.
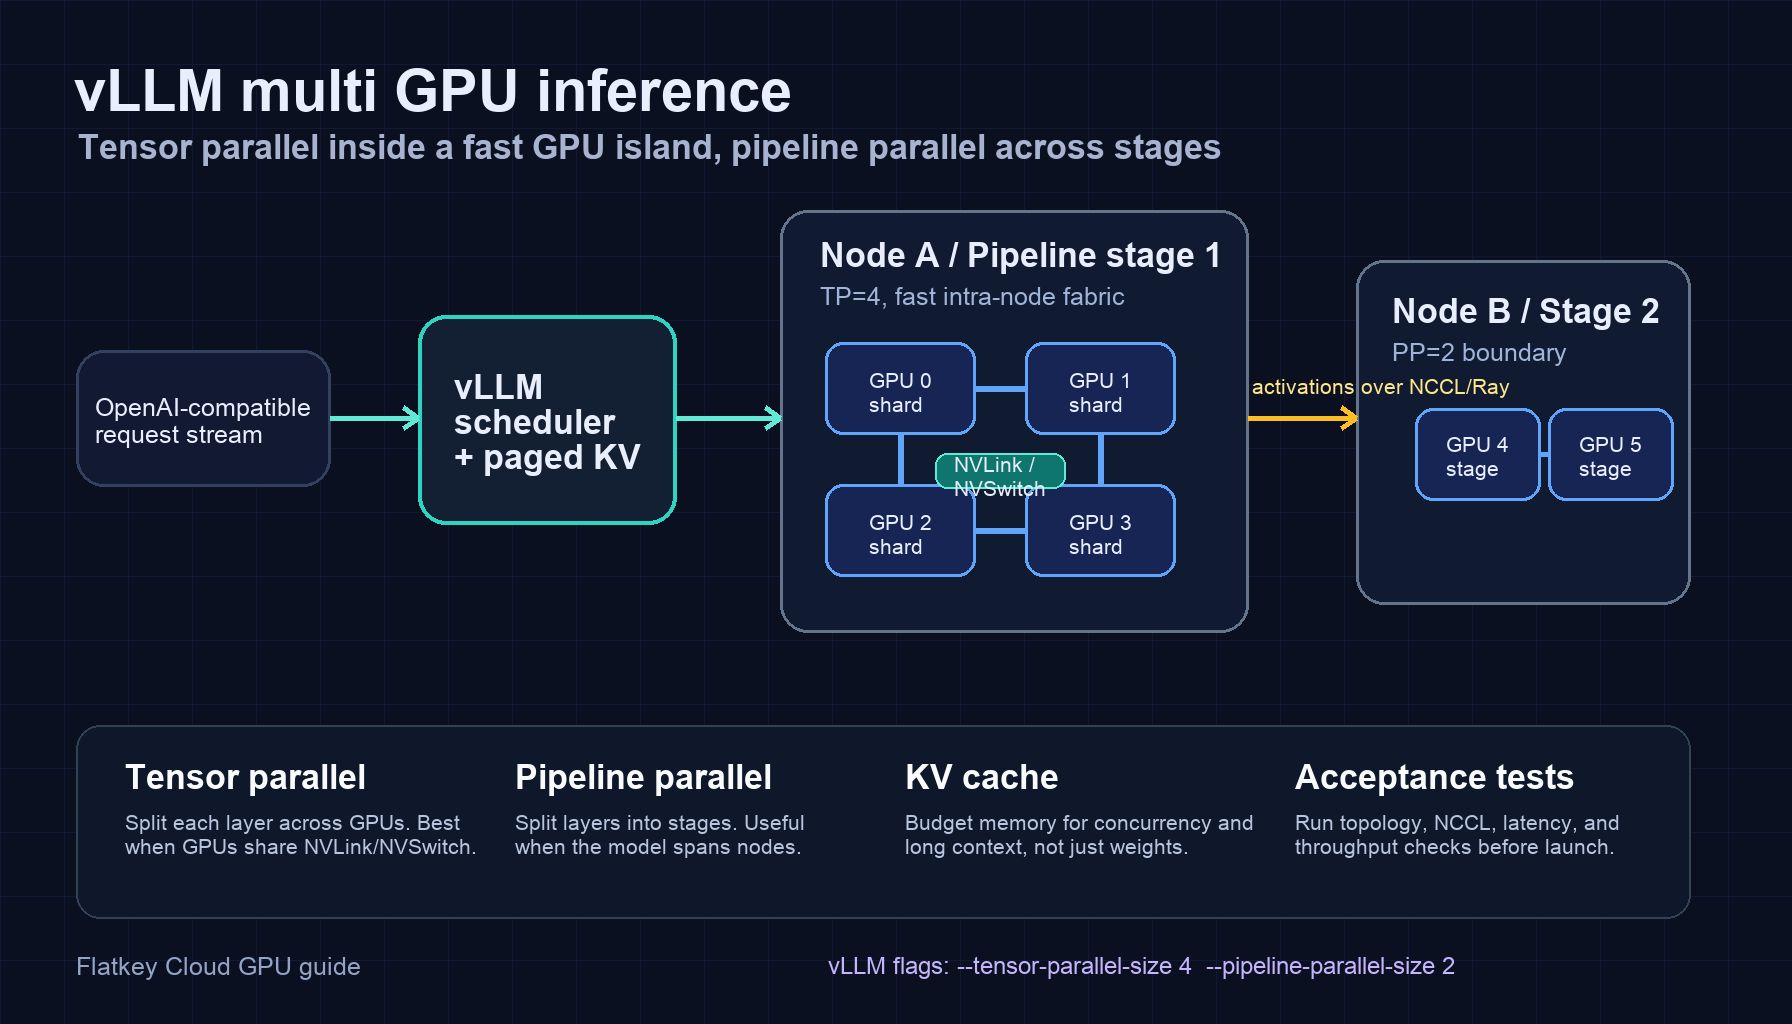
Inferensi Multi-GPU vLLM: Pengaturan Tensor dan Pipeline Parallel
Atur inferensi multi-GPU vLLM dengan tensor parallelism, pipeline parallelism, Ray, pemeriksaan topologi, contoh, dan pengujian produksi.

TensorRT-LLM vs vLLM: Performa, Portabilitas, dan Pemeliharaan
Perbandingan praktis TensorRT-LLM vs vLLM untuk tim infrastruktur AI yang memilih engine serving LLM berdasarkan performa, portabilitas, pemeliharaan, dan desain benchmark.
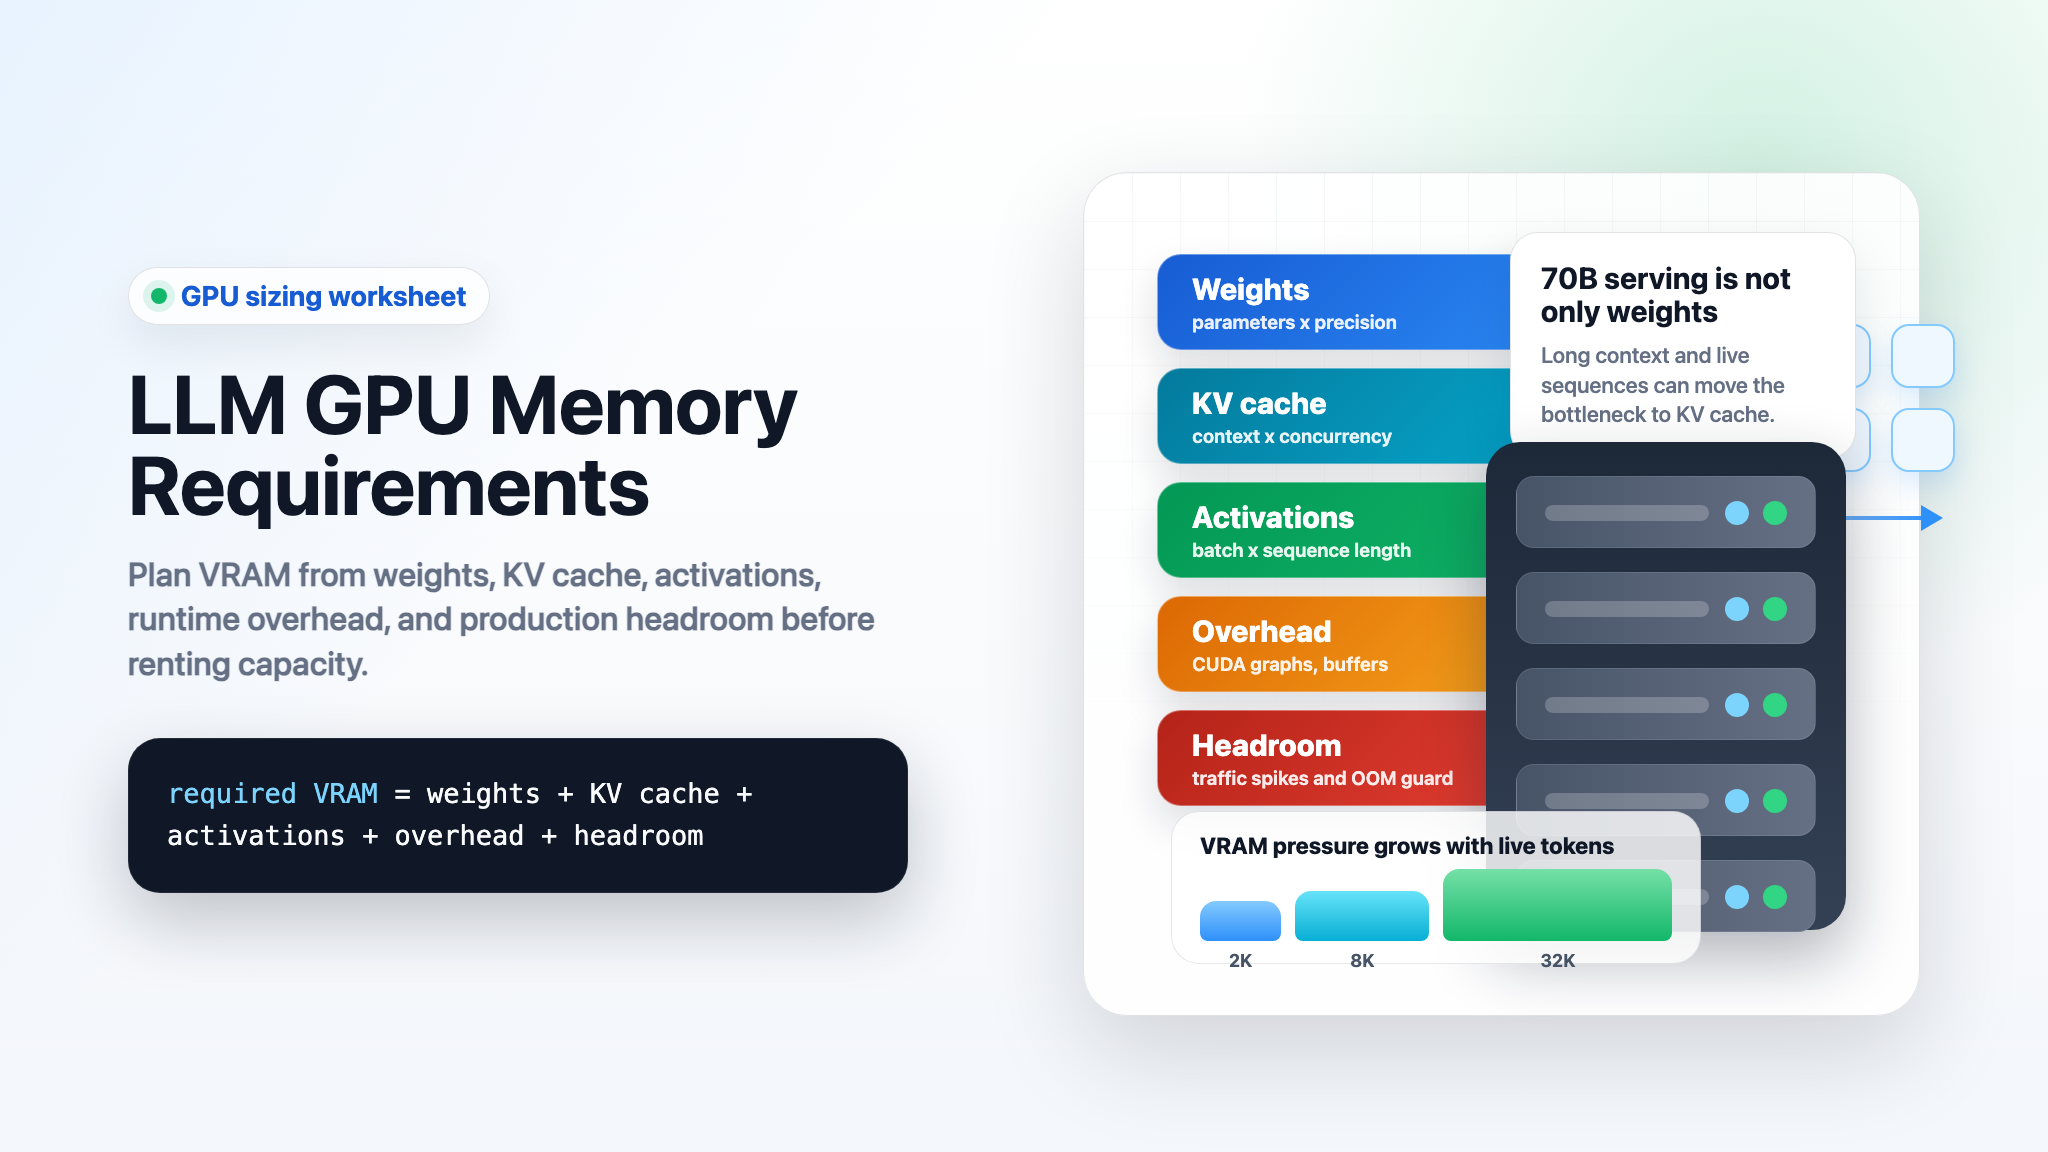
Persyaratan Memori GPU LLM: Bobot, KV Cache, Aktivasi, dan Overhead
Lembar kerja praktis untuk memperkirakan persyaratan memori GPU LLM untuk bobot, KV cache, aktivasi, overhead serving, perencanaan vLLM 70B, fine-tuning, dan training.
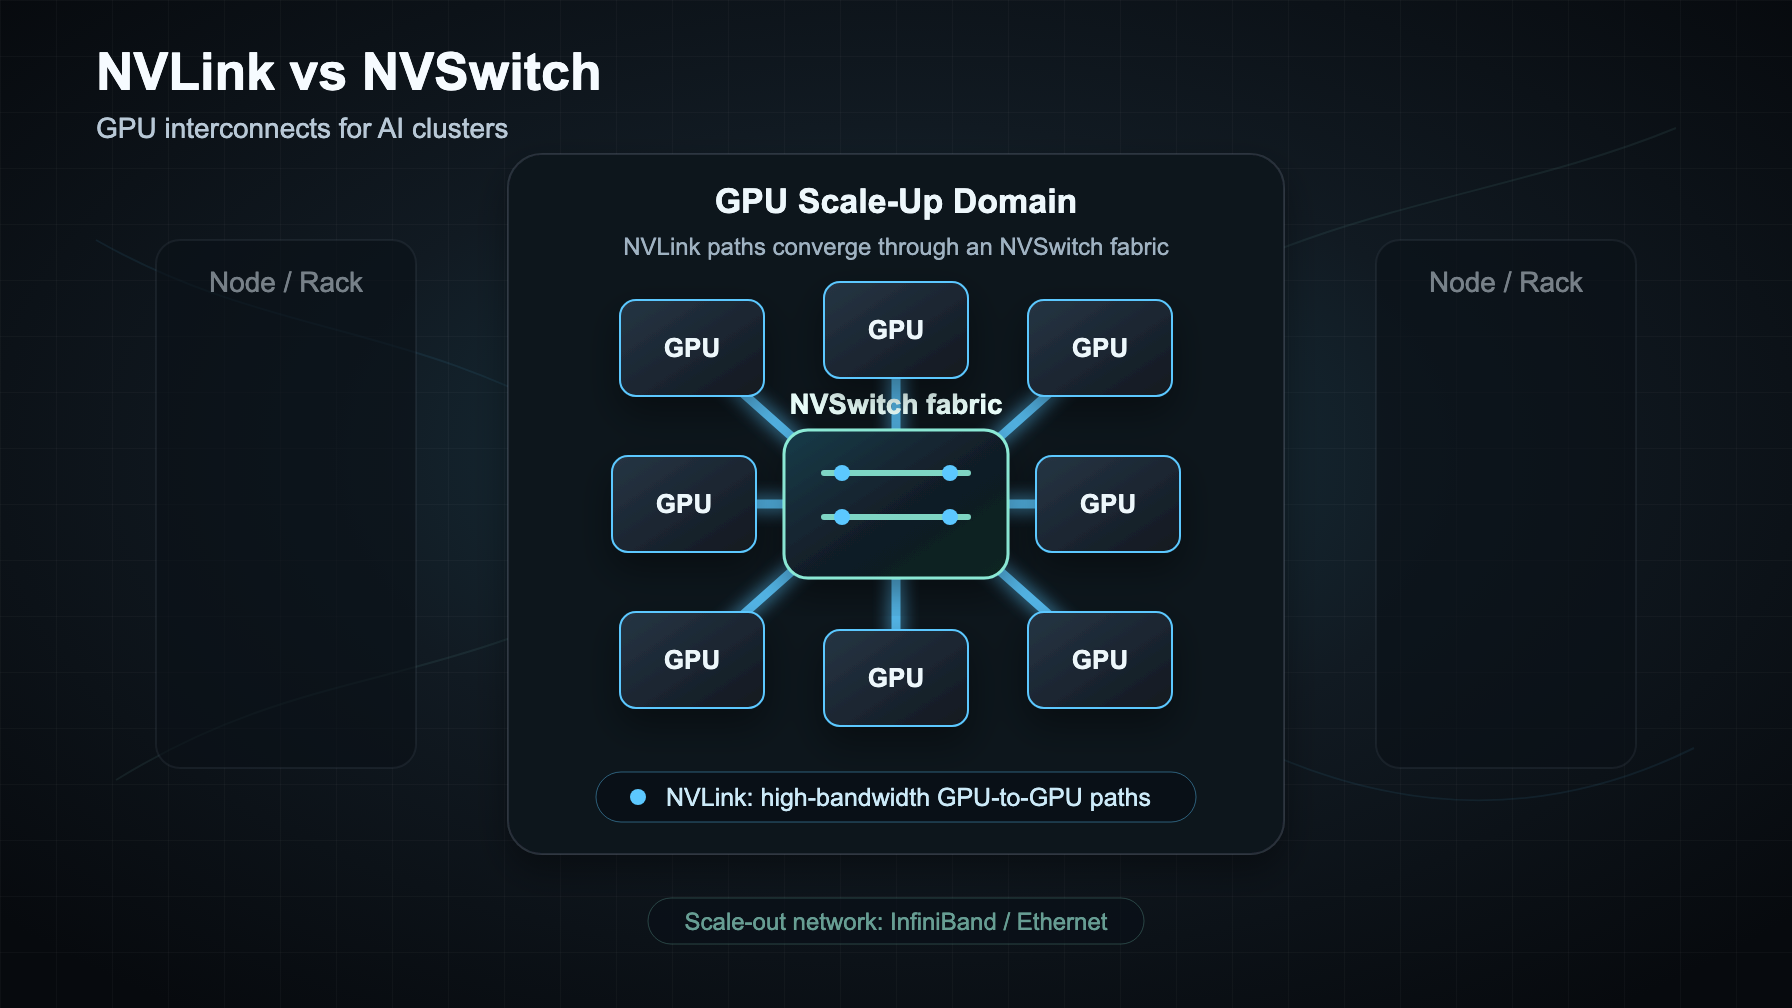
NVLink vs NVSwitch: Penjelasan Interkoneksi GPU untuk Klaster AI
NVLink adalah penghubung GPU-ke-GPU, NVSwitch adalah fabric, dan InfiniBand atau Ethernet adalah jaringan scale-out. Berikut cara memilihnya untuk klaster AI.
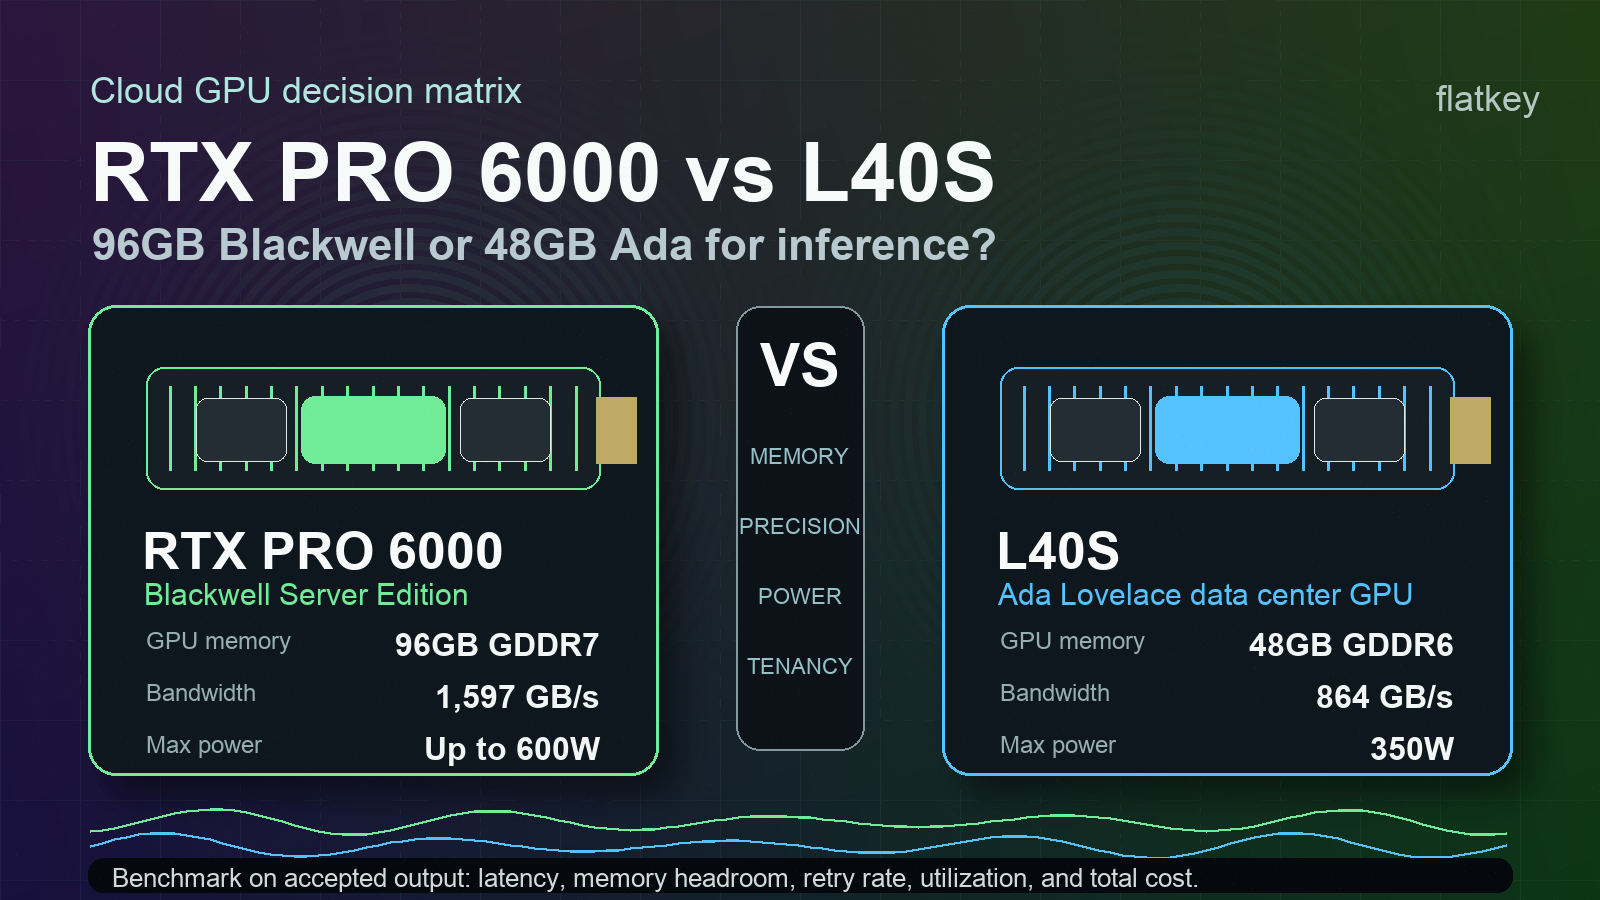
RTX PRO 6000 vs L40S: 96GB Blackwell atau GPU Inferensi Ada?
Bandingkan NVIDIA L40S vs RTX PRO 6000 Blackwell Server Edition untuk inferensi LLM, workload multimodal, kecocokan memori, daya, dan biaya output yang diterima.
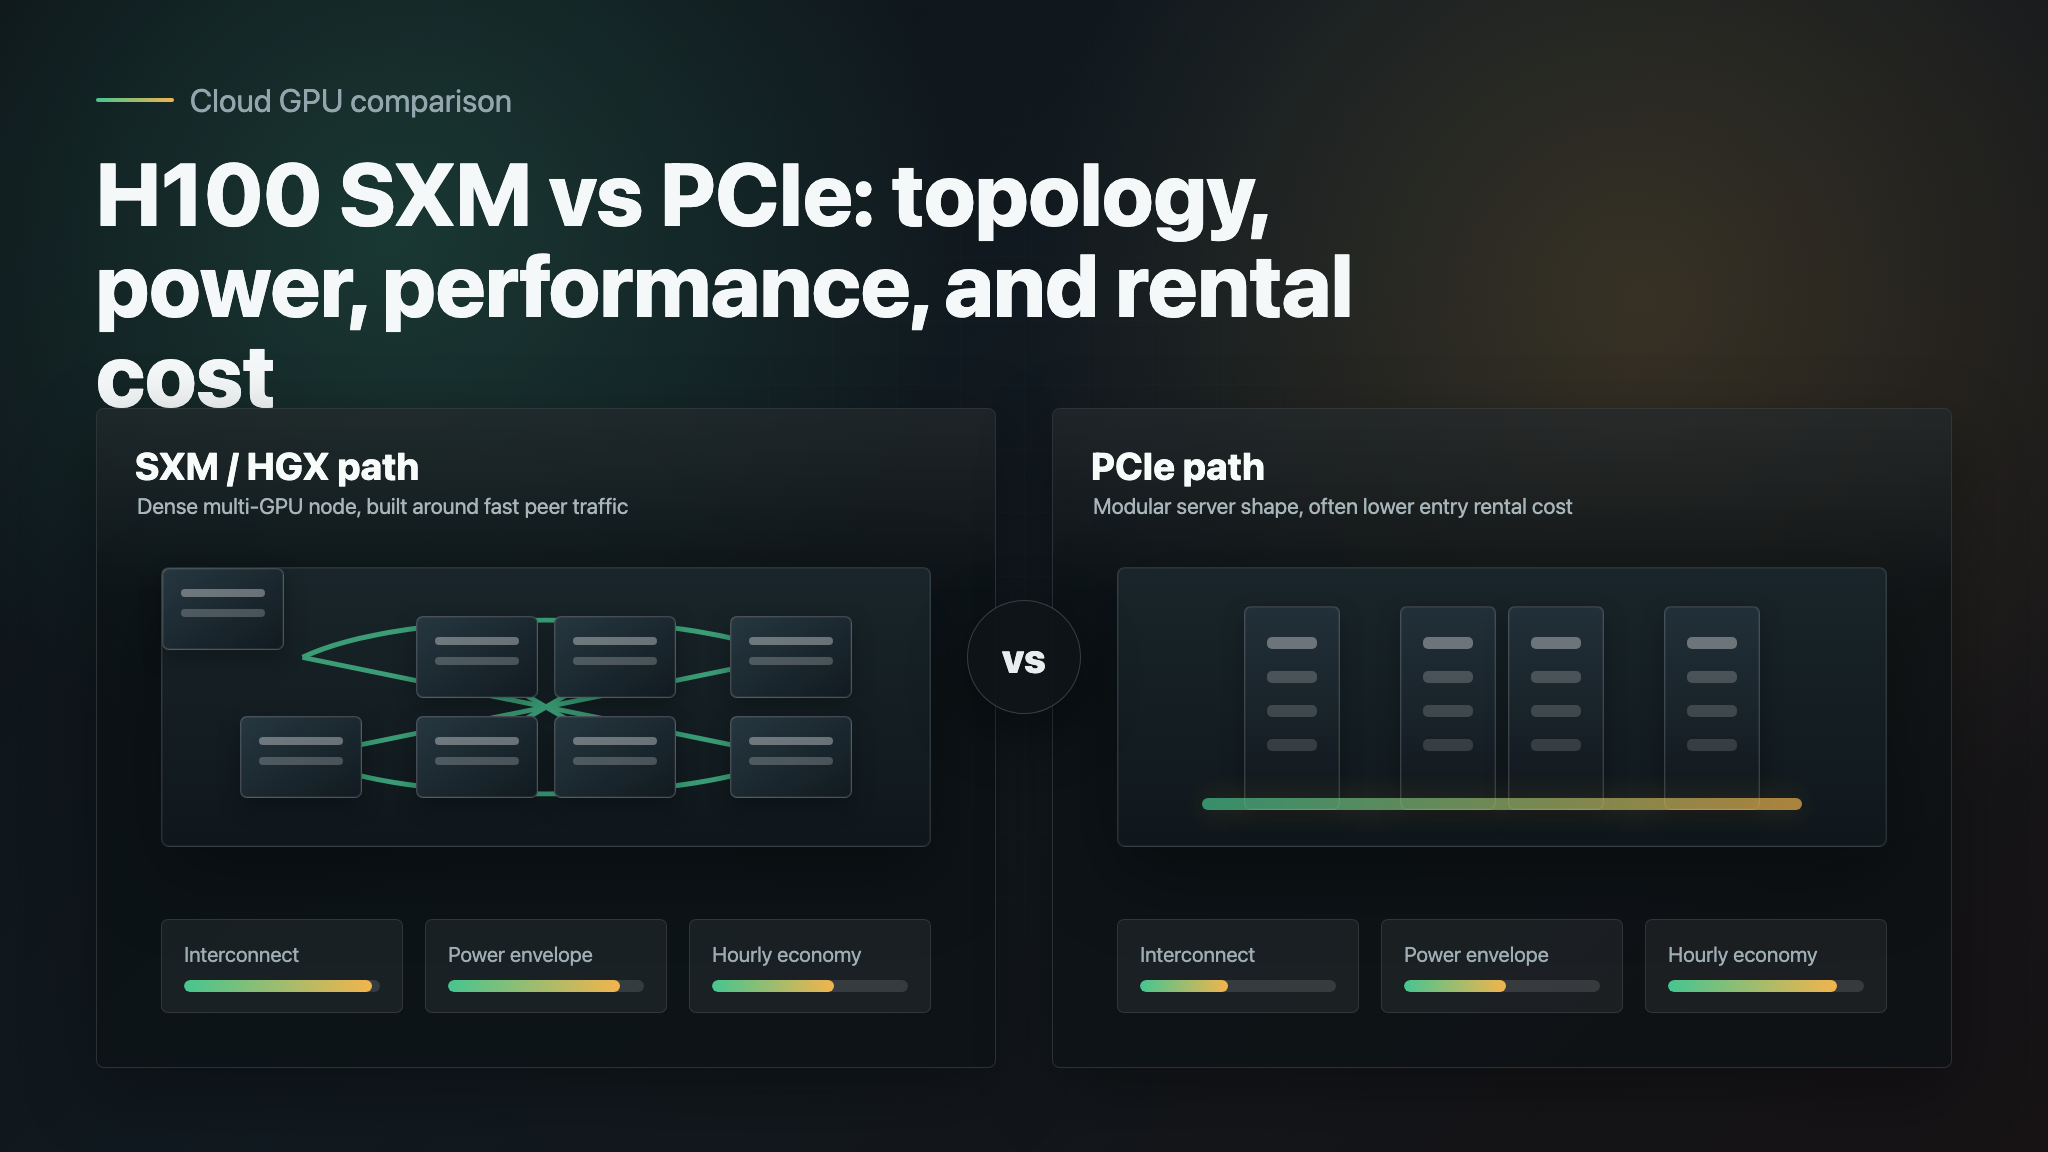
H100 SXM vs PCIe: NVLink, Daya, Performa, dan Biaya Sewa
Bandingkan H100 PCIe vs SXM untuk NVLink, konsumsi daya, performa beban kerja, dan biaya sewa sebelum menyewa GPU cloud.
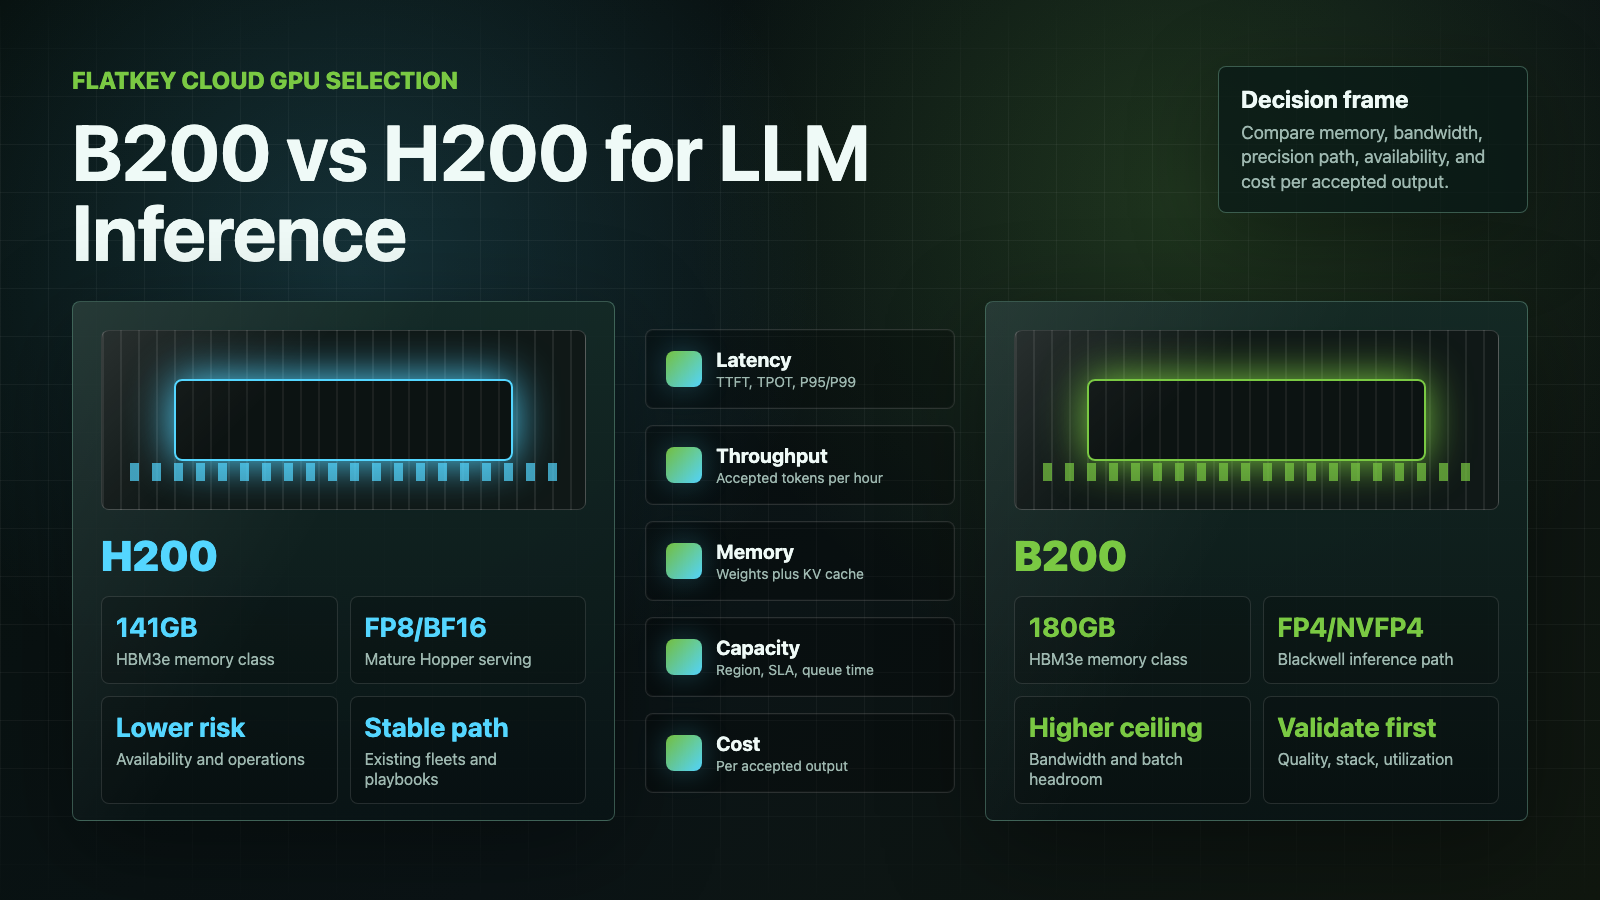
NVIDIA B200 vs H200: GPU Mana yang Lebih Baik untuk Inference LLM?
Bandingkan NVIDIA B200 vs H200 untuk inference LLM berdasarkan memori, bandwidth, dukungan presisi, sistem DGX, ketersediaan GPU cloud, dan biaya per output yang diterima.

Arsitektur Klaster GPU: Compute, Jaringan, Storage, dan Control Plane
Panduan praktis arsitektur klaster GPU untuk node compute, fabric jaringan, storage, control plane Kubernetes atau Slurm, observabilitas, dan pengujian penerimaan.
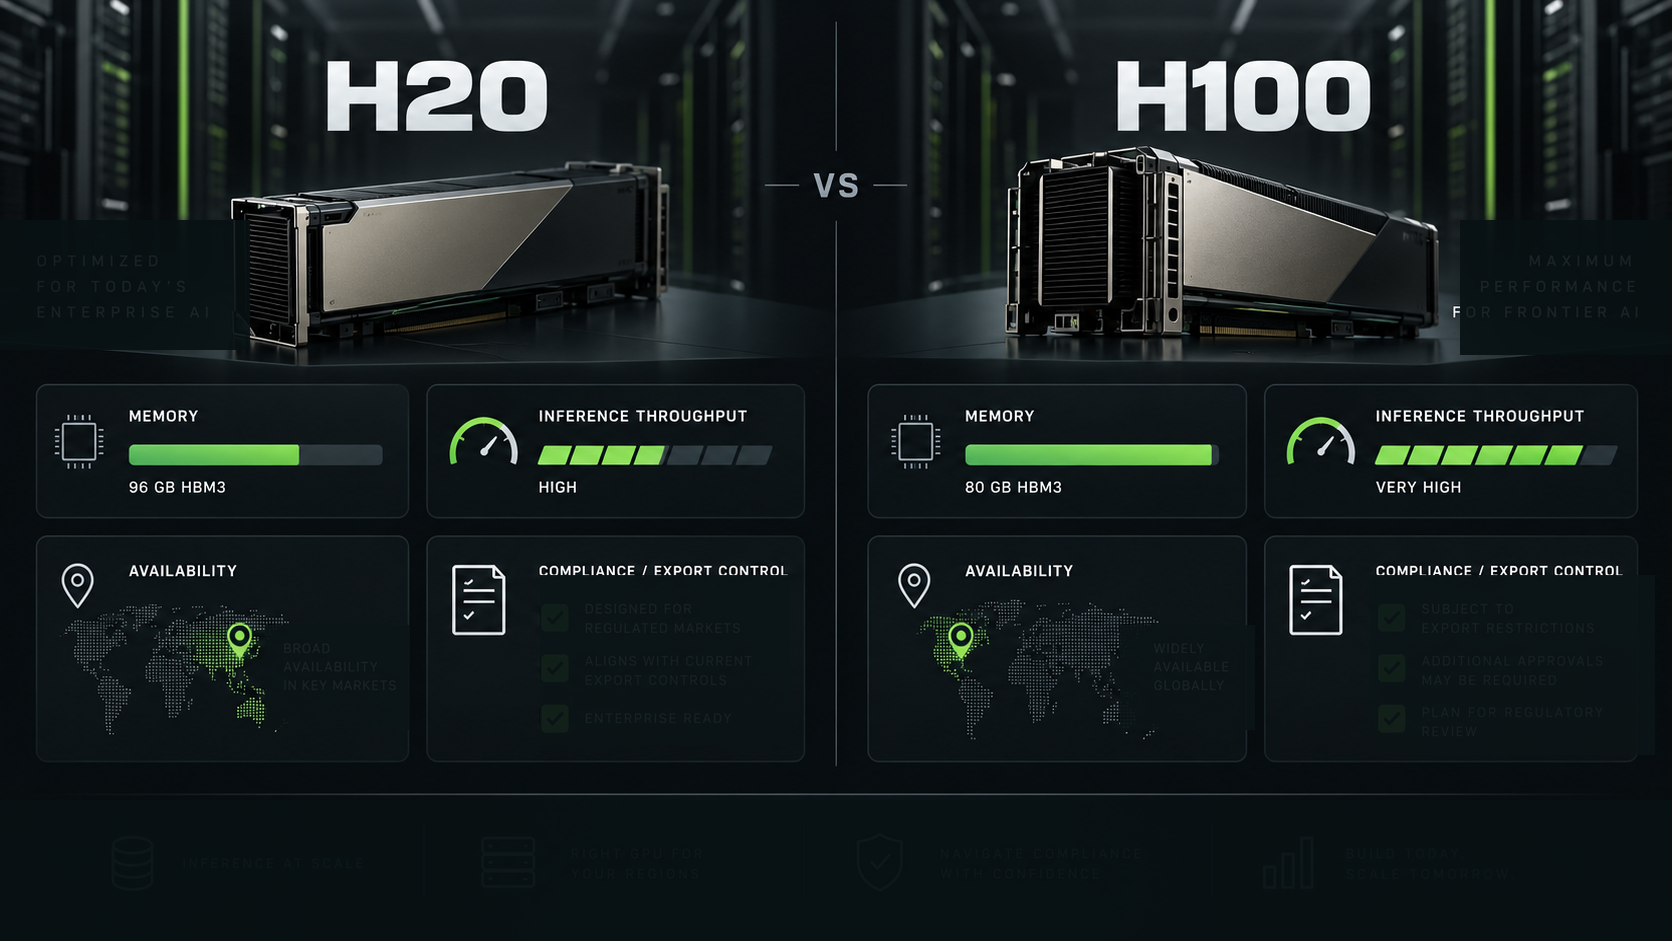
NVIDIA H20 vs H100: Inferensi, Memori, Ketersediaan, dan Kepatuhan
Perbandingan praktis H20 vs H100 untuk tim AI enterprise, mencakup inferensi, memori, ketersediaan, risiko kontrol ekspor, dan kapan H200 atau API model menjadi baseline yang lebih baik.
Platform Sewa GPU Cloud Terbaik 2026: Harga, Kapasitas, Jaringan, dan Dukungan
Daftar singkat praktis 2026 platform cloud GPU untuk tim AI, membandingkan posisi harga, kapasitas, jaringan, dukungan, dan kapan API model menjadi baseline yang lebih baik.
NVIDIA Blackwell Ultra B300: Apa yang Berubah dari B200?
Tracker praktis NVIDIA B300 Blackwell Ultra untuk tim infrastruktur AI yang membandingkan spesifikasi B300, status peluncuran, catatan harga, dan kecocokan beban kerja terhadap B200.
AMD MI455X dan Helios: Pelacak Arsitektur, Memori, dan Ketersediaan
Pelacak berfokus pada pembeli untuk AMD MI455X dan Helios yang mencakup arsitektur, memori HBM4, bandwidth, ketersediaan, kesiapan vLLM, pertanyaan ke penyedia, dan strategi fallback model/API.
GPU NVIDIA Vera Rubin: Pelacak GPU, NVL72, Memori, Jaringan, dan Ketersediaan
Pelacak terkini untuk spesifikasi GPU NVIDIA Vera Rubin, DGX Vera Rubin NVL72, memori HBM4, jaringan, dan milestone ketersediaan bagi pembeli GPU cloud.
Harga OpenAI Image API: Tarif GPT Image 2.5, Rumus Biaya, dan Kontrol Anggaran
Pelajari cara kerja harga OpenAI image API untuk GPT Image 2.5, termasuk tarif token, aturan input cache, gambar parsial, Batch, dan biaya per gambar yang diterima.
GB200 vs B200: Superchip Grace Blackwell atau x86 HGX?
Bandingkan GB200 vs B200 untuk pengadaan infrastruktur AI: sistem Grace Blackwell skala rak NVL72, node B200 HGX/x86, benchmark, dan pengecekan TCO.
Bangun lebih cepat dengan satu gateway AI.
Gunakan flatkey.ai untuk mengelola model, kunci, penagihan, dan observabilitas dari satu platform API.
Mulai