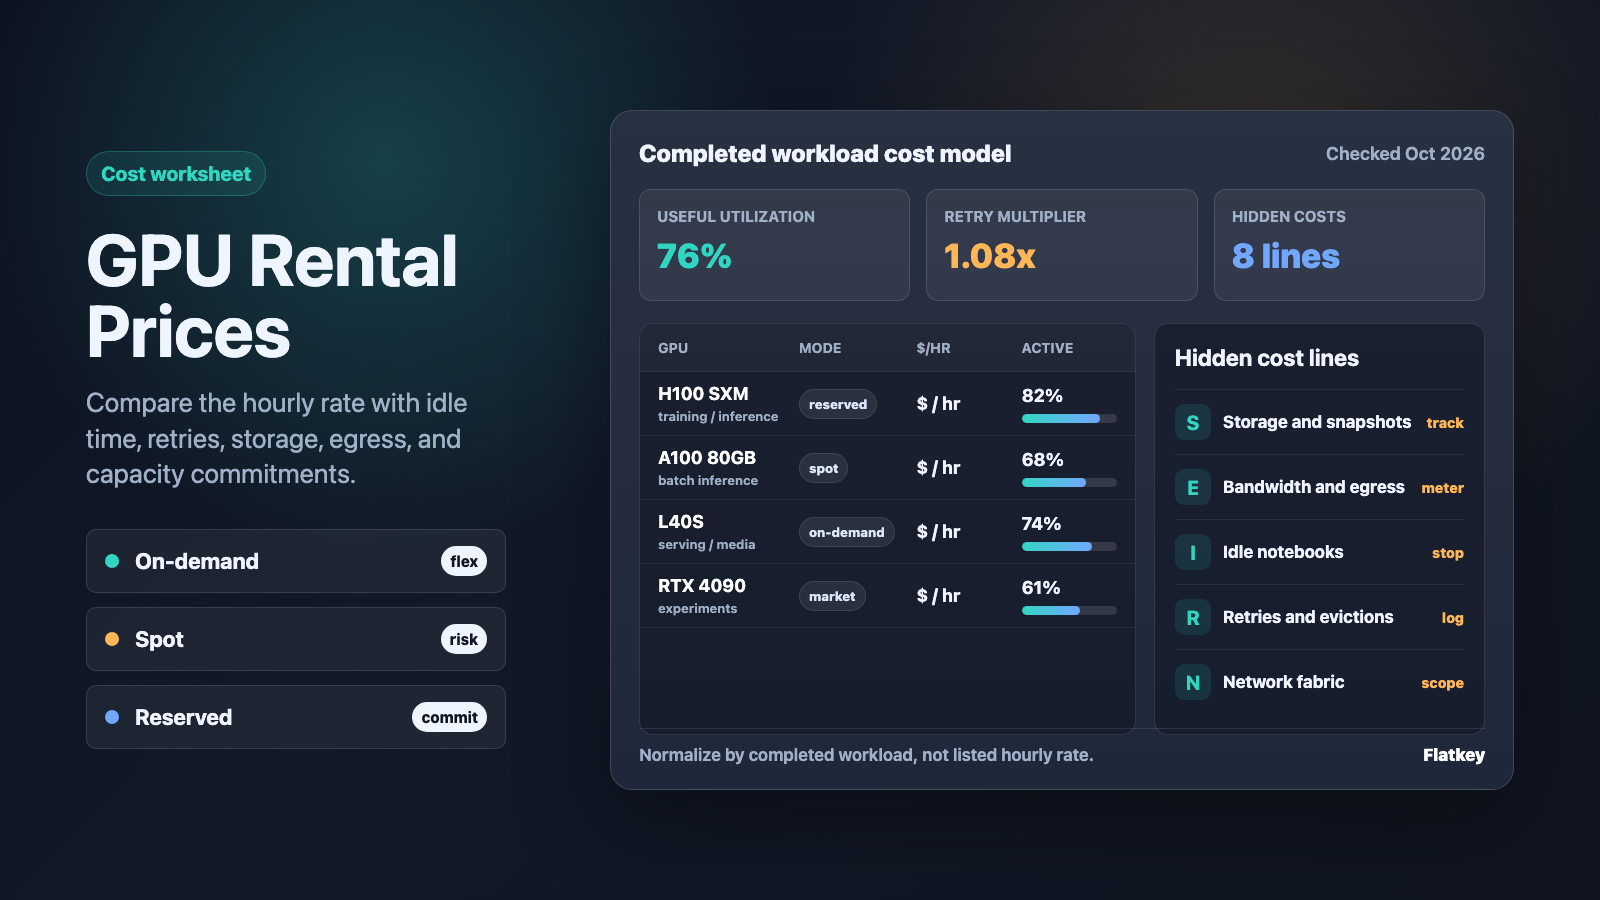
価格ページで最も安いモデルが、本番環境でも常に最安とは限りません。入力トークン単価が低くても、出力が長い、キャッシュ再利用が弱い、再試行が発生する、レイテンシーのミスがある、レート制限回避の工夫が必要になる、あるいは品質低下によって2回目のモデル呼び出しが必要になることで、相殺されてしまうことがあります。
だからこそ、APIプロバイダーを切り替える前にAIモデル価格を比較する正しい方法は、100万トークンを単独で購入したときのコストではなく、実際のワークロードを正常に完了するためのコストを測定することです。
このガイドでは、個人開発者や小規模AIプロダクトチーム向けに、AI APIプロバイダーを切り替えるための実践的な評価フレームワークを紹介します。見出し価格、キャッシュ挙動、バッチ割引、ワークロード品質、レイテンシー、信頼性、移行コスト、そして月次のモデルレビューで再利用できるワークシートを扱います。
APIプロバイダーを切り替える前にAIモデル価格を比較する方法: すぐわかる答え
APIプロバイダーを切り替える前にAIモデル価格を比較するには、5つの項目を持つワークロード単位のスコアカードを作成します。
- プロバイダーの料金単位: 入力、キャッシュ済み入力、キャッシュ書き込み、出力、ツール、メディア、バッチ、その他の優先処理料金。
- 実際のリクエスト形状: 平均入力トークン数、再利用可能なコンテキスト、出力長、ツール呼び出し、再試行、フォールバック呼び出し。
- 受理された出力率: 自社の受け入れチェックに基づいて、モデルがどれくらいの頻度でタスクを完了するか。
- 信頼性とレイテンシー: 想定負荷下でのp50、p95、p99、タイムアウト率、429/5xx率、フォールバック頻度。
- 移行および運用コスト: エンジニア工数、SDK互換性、使用量の按分、請求書、ロールバック、ガバナンス。
判断の軸として、次の指標を使います:
成功したタスク1件あたりの実効コスト =
  (主要モデルの支出 + 再試行の支出 + フォールバックの支出 + 関連する単位料金)
  / 受理されたタスク結果数
トークン単価が30%安いモデルでも、失敗が多い、回答が長くなる、またはエッジケースを救済するために別プロバイダーが必要になる場合は、より高くつくことがあります。
なぜトークン価格は不完全なコスト指標なのか
チームがAIモデル価格の比較方法を最初に学ぶとき、モデル、入力価格、出力価格の3列の表を作ることがよくあります。その表は発見には役立ちますが、APIプロバイダーの切り替えを正当化するには十分ではありません。
現代のAI APIの請求書には、複数の課金イベントが含まれることがあります。OpenAIの価格ページでは、多くのモデルについて入力、キャッシュ済み入力、出力の料金が分かれています。Anthropicは、キャッシュ書き込みとキャッシュ読み取りの経済性を分けてプロンプトキャッシュを説明しています。Google Geminiの価格も、モデル、モダリティ、キャッシュ挙動によって変わります。共通する教訓はシンプルです。各プロバイダーは異なる価格メカニズムを公開しているため、移行判断に使うには、単純な行ごとの比較を正規化する必要があります。
どのプロバイダーも順位付けする前に、次の項目を記録してください:
| コスト項目 | 収集する内容 | 判断が変わり得る理由 |
|---|---|---|
| 入力トークン | キャッシュされていないプロンプトトークンと課金単位 | 長いプロンプトはリクエストコストの大半を占めることがある。 |
| キャッシュ済み入力またはキャッシュ読み取り | 利用可能な場合の割引された再利用可能なコンテキスト | ウォームキャッシュを前提にすると、節約額を過大評価することがある。 |
| キャッシュ書き込みまたは保存 | 再利用可能なコンテキストを作成または保持するコスト | 再利用が発生する前に、前払いが必要なワークロードもある。 |
| 出力トークン | 表示される生成トークンと、別途の推論トークンの扱い | 冗長なモデルでは、入力トークンの節約分が相殺されることがある。 |
| ツールと検索 | Web検索、コード実行、関数呼び出し、データツール、またはブラウザー操作 | エージェント系のワークロードでは、テキストトークン以外の費用が発生しがちである。 |
| メディア単位 | 画像、音声、動画、OCR、文字起こし、または埋め込みの単位 | マルチモーダルのコストは、テキストトークンの計算に混ぜて扱うことはできない。 |
| バッチまたは非同期の条件 | 割引、完了ウィンドウ、再試行の挙動 | 夜間ジョブにリアルタイム前提を当てはめるべきではない。 |
| 優先処理またはプロビジョニング済み容量 | プレミアム処理、予約済みスループット、またはアカウントレベルの制限 | 単価が低く見えても、容量不足でローンチ計画が失敗することがある。 |
目的は、すべてのプロバイダーの価格表を暗記することではない。自分のワークロードの中で、すべての候補を比較可能にすることだ。
価格を1つのワークシートに正規化する
APIプロバイダーを切り替える前にAIモデル価格を比較するための再現可能な手順は、まず各候補を共通のワークシートに変換することから始めるべきだ。
個人開発のプロダクトでは、APIプロバイダーを切り替える前にAIモデル価格を比較する方法は、すべてのルートを同じコストモデルに収めることから始まる。
モデルとワークロードの組み合わせごとに1行を使う:
| 項目 | 候補A | 候補B | 候補C |
|---|---|---|---|
| プロバイダーとルート | |||
| テストしたモデルID | |||
| 非キャッシュ入力レート | |||
| キャッシュ済み入力またはキャッシュ読み取りレート | |||
| キャッシュ書き込みまたは保存レート | |||
| 出力レート | |||
| その他の単位課金 | |||
| 平均非キャッシュ入力トークン数 | |||
| 平均キャッシュ済みまたは再利用可能トークン数 | |||
| 平均出力トークン数 | |||
| 評価リクエスト数 | |||
| 承認された出力 | |||
| 再試行呼び出し | |||
| フォールバック呼び出し | |||
| 評価総支出 | |||
| 成功したタスクあたりの実効コスト | |||
| p50 / p95 レイテンシ | |||
| エラー率とタイムアウト率 | |||
| 移行時間 | |||
| 判断メモ |
次に、これらの計算を使う:
受理率 =
  受理された出力 / 評価リクエスト

action全体での有効コスト =
  (主モデルの支出 + リトライ支出 + フォールバック支出 + 関連する従量課金)
  / 受理された出力

月間予測コスト =
  action全体での有効コスト
  * 1か月あたりの予測受理タスク数
これにより、問いは「どのモデルのトークン単価が最も低いか?」から、「このワークロードを、最適なコスト・品質・運用リスクで完了できるルートはどれか?」に変わります。
割引を信頼する前にモデルのキャッシュ動作を確認する
キャッシュ料金は、AIモデル価格の見出し比較が誤解を招きやすい最大の理由の1つです。
キャッシュ依存の大きいアプリでは、APIプロバイダーを切り替える前にAIモデル価格を比較する方法は、広告上の最大割引ではなく、実際に観測された再利用率に依存します。
再利用可能なコンテキストには、システム指示、製品カタログ、ポリシーハンドブック、リポジトリ要約、スキーマ、ツール説明、あるいは長いfew-shotプレフィックスが含まれます。これらのトークンが安定していて頻繁に再利用されるなら、キャッシュはコストモデルを大きく変える可能性があります。プロンプトが絶えず変化するなら、キャッシュの経済性はほとんど問題にならないかもしれません。
次の簡略化したリクエストモデルを使います:
request cost =
  (uncached input tokens * input rate)
  + (cache-write tokens * cache-write rate)
  + (cache-read tokens * cache-read rate)
  + (output tokens * output rate)
  + other billable units
次の3つのシナリオをテストします:
| シナリオ | キャッシュ仮定 | ユースケース |
|---|---|---|
| コールド | 再利用率0% | 新規テナント、変更されたプレフィックス、期限切れのキャッシュ、疎なトラフィック。 |
| 期待値 | 代表的なトラフィックから観測された再利用率 | 本番向けの計画ケース。 |
| ウォーム | 高い再利用率 | 安定したプレフィックス、反復リクエスト、集中したトラフィック。 |
すべてのリクエストでウォームキャッシュを仮定してはいけません。最小トークン閾値、保持期間、プレフィックス変更、キャッシュキー、トラフィック分布は、実際のヒット率をすべて低下させる可能性があります。
安全な意思決定は、最大で宣伝されるキャッシュ割引ではなく、観測されたキャッシュテレメトリに基づきます。
リアルタイムとバッチのワークロードを分ける
バッチAPIや非同期APIは、即時応答を必要としない作業のコストを下げられますが、その一方で完了までの時間、可観測性、エラーハンドリング、ユーザー体験も変わります。
サポートチャットボット、コーディングエージェント、夜間の文書分類器を同じ価格仮定で扱うべきではありません。
APIプロバイダーを切り替える前に、各ワークロードを分類してください:
| ワークロードの種類 | 比較対象 | 注意点 |
|---|---|---|
| 対話型ユーザーフロー | リアルタイムモデル料金、ストリーミング対応、p95レイテンシ | コンバージョン損失、タイムアウト時のUX、フォールバック設計。 |
| コーディングまたはツールエージェント | テキスト料金に加え、ツール呼び出し、リトライ、フォールバック呼び出し、長いコンテキスト | ツール呼び出し互換性と失敗ループ。 |
| オフライン分類 | バッチまたは非同期料金、スループット、リトライウィンドウ | 完了ウィンドウと結果の突合。 |
| コンテンツまたはメディア生成 | テキスト、画像、動画、音声、またはOCRの単位 | 修正率と却下された出力。 |
| 社内自動化 | 受理された出力に対して最も安価で信頼できるルート | 監視、クォータ、元帳への帰属。 |
これはよくあるミスを防ぎます。オフラインのトラフィックでは安いからという理由でプロバイダーを選び、あとからユーザー向けリクエストには遅すぎる、または制約が厳しすぎると気づくことです。
本番に近い評価セットを作成する
公開ベンチマークは候補モデルの発見には役立ちますが、あなたのプロンプト設計、ドキュメント、ツール、出力スキーマ、言語、失敗時のコストと一致することはほとんどありません。有用なAIモデル評価フレームワークは、まず自社の本番に近いタスクから始まります。
そのため、APIプロバイダーを切り替える前にAIモデル価格を比較する方法は、評価設計の問題でもあります。
評価セットは次の4つの要素で作成します。
- 一般的なタスク: ボリュームの大半を占めるリクエスト。
- 難易度の高いタスク: 深い推論、長いコンテキスト、または厳密な指示遵守が必要なケース。
- リスクの高いタスク: 幻覚、書式崩れ、または安全でない出力のコストが高いプロンプト。
- 境界ケースのタスク: 多言語コンテンツ、特殊な書式、疎なデータ、ツールエラー、または非常に長い入力。
限定されたワークフローなら、厳選した50〜100件のケースで、何千もの一般的なプロンプトよりも優れた比較ができます。広範なアシスタントでは、より大きな層化サンプルを使い、1つの平均値にばらして隠すのではなく、タスク分類ごとに結果を報告します。
プロンプト、サンプリング設定、ツール定義、出力上限、合格基準は、候補間で一貫させてください。プロバイダーが異なるリクエスト形式を必要とする場合は、密かにテストを変えるのではなく、その違いを移行作業として文書化します。
比較を実行する前に「成功」を定義する
成功を定義しなければ、タスク1件あたりの実効コストを計算することはできません。
ワークロードに合った合格基準を使ってください。
| ワークロード | 成功基準の例 |
|---|---|
| 抽出 | 必要な項目が存在する、スキーマが有効、フィールド単位の精度。 |
| 分類 | 適合率、再現率、混同行列、レビュー済みの境界ケース。 |
| コード生成 | テストが通る、セキュリティチェックが通る、修正が範囲内に収まる。 |
| カスタマーサポート | 根拠のある回答、正しいポリシーの適用、有用なトーン、作り話のアクションがない。 |
| エージェント | 適切なツール選択、有効な引数、タスク完了、ツールエラーからの回復。 |
| コンテンツ生成 | 事実に基づく裏付け、ブランド適合、編集者の承認、修正率。 |
可能な限り決定論的なチェックを使ってください。テストに落とし込めない品質については、ブラインドの人手レビューを追加します。レビュー担当者がどのモデルが回答を生成したかを知っていると、プロバイダーへの期待が結果を歪める可能性があります。
コスト要因としてレイテンシーと信頼性を測定する
わずかに安くても、レイテンシーの目標を定期的に外すモデルは、コンバージョンを下げるか、より複雑なフォールバックシステムの構築を強いる可能性があります。
本番ルートでは、APIプロバイダーを切り替える前にAIモデル価格を比較する方法に、レイテンシー、エラー率、フォールバック挙動を含める必要があります。
追跡する項目:
- 最初のトークンまでの時間;
- 応答完了までの総時間;
- p50、p95、p99のレイテンシー;
- タイムアウト率;
- 429および5xxの発生率;
- リトライ回数;
- フォールバック頻度;
- 不完全または不正な形式の応答率。
レート制限も同じ評価に含めるべきです。あるプロバイダーは魅力的な単価を提示していても、あなたのローンチ計画に対しては、1分あたりのリクエスト数、1分あたりのトークン数、同時実行数、またはアカウントレベルの容量が不十分な場合があります。
分離した品質テストと、制御された負荷テストの両方を実行してください。分離テストではモデルが何をできるかがわかります。負荷テストでは、想定トラフィックパターンの下でプロバイダーがそれを提供できるかがわかります。
移行コストと運用コストを含める
APIプロバイダーを切り替える前にAIモデル価格を比較する方法を学んでいるチームは、API請求書の外にある一時的なコストと継続的なコストを見落としがちです。
移行の観点が重要なのは、APIプロバイダーを切り替える前にAIモデル価格を比較する方法が、エンジニアリング時間と運用の複雑さの問題でもあるからです。
次の質問を意思決定に加えてください:
| コスト領域 | 答えるべき質問 |
|---|---|
| API互換性 | ベースURLとモデルIDを変更するだけで済みますか、それともリクエストロジックを書き換える必要がありますか? |
| ツール呼び出し | ツールスキーマ、並列呼び出し、または結果メッセージの挙動は異なりますか? |
| 構造化出力 | JSONスキーマは一貫してサポートされていますか? |
| ストリーミング | クライアントとUIはプロバイダーのイベント形式を処理できますか? |
| 可観測性 | ルートやワークロードごとに使用量、エラー、レイテンシ、コストを把握できますか? |
| ガバナンス | 主要な制御、監査要件、データポリシーは組織に適合していますか? |
| フォールバック | プロバイダー固有のコードを重複させずにモデルを切り替えられますか? |
| 請求 | 財務部門は、手動エクスポートなしで使用量、チャージ、請求書、ワークロード別支出を確認できますか? |
移行にかかるエンジニアリング工数、テスト保守、月次の運用負荷を見積もってください。わずかなレート差では、リスクの高い書き換えを正当化できないかもしれません。逆に、使用状況の可視性が高いOpenAI互換のルートは、繰り返し行うモデル評価を大幅に安くできます。
重み付きの意思決定スコアを使い、ただし生の指標は保持する
生の結果を収集した後、ワークロードを反映する重み付きスコアを作成します。
本番の抽出サービス向けの重みの例:
| 次元 | 重みの例 |
|---|---|
| 受け入れ可能な出力率 | 35% |
| 成功タスクあたりの実効コスト | 25% |
| p95レイテンシ | 15% |
| 負荷時の信頼性 | 15% |
| 移行と運用の工数 | 10% |
インタラクティブなコーディングアシスタントでは、品質とレイテンシにより大きな重みを置くべきかもしれません。オフラインの文書分類では、バッチコストとスループットが主になる場合があります。
最終スコアだけを公表しないでください。関係者が評価を再実行せずに重みを変更できるよう、生の計測値を保持してください。
7日間の切り替えテスト
今月、AI APIプロバイダーを切り替えるかどうかを判断しているなら、本番トラフィックを変更する前に短い評価を実施してください。
この7日間の計画を、APIプロバイダーを切り替える前にAIモデル価格を比較する方法の実践版として使ってください。
- 1日目: 1つのワークロードを選ぶ。 製品全体を移行してはいけません。明確な成功基準を持つ、高コストまたは高ボリュームのルートを選びます。
- 2日目: 現在のベースラインを取得する。 リクエスト数、承認された出力、トークン使用量、再試行、レイテンシ、エラー率、現在の月間支出をエクスポートします。
- 3日目: 候補の価格を正規化する。 現在のプロバイダーの価格ページでワークシートを埋め、未確認の項目をすべて記録します。
- 4日目: 評価セットを実行する。 同じプロンプト、スキーマ、設定、出力制限で候補をテストします。
- 5日目: 制御された負荷テストを実行する。 想定トラフィック下で、レイテンシ、429、タイムアウト、フォールバック動作を測定します。
- 6日目: ルートをスコアリングする。 成功したタスクあたりの実効コストを計算し、移行工数を確認します。
- 7日目: カナリアリリースするか却下する。 ロールバックと支出上限を設定したうえで、勝利したルートに少量のトラフィックを送ります。
このワークフローにより、価格の判断が際限のないプロバイダー移行に変わってしまうのを防げます。
AIモデル価格を比較する際によくあるミス
1つのプロンプトだけで選ぶ
印象的な1件の応答はデモであって、評価ではありません。代表的なセットを使い、ばらつきを報告しましょう。
入力トークン価格だけを比較する
出力トークン、キャッシュの仕組み、再試行、ツール、メディア単位が最終請求額の大半を占めることがあります。
最大のキャッシュ割引を想定節約額として使う
自社のプロンプト構造とトラフィック分布におけるキャッシュ再利用率を測定してください。
出力長を無視する
2つのモデルがどちらも正しく答えられても、片方は課金対象の出力トークンを2倍生成することがあります。
レート制限を後で考える問題として扱う
容量制約によって、安価なモデルが信頼できない本番依存先に変わることがあります。
すべてのワークロードを一度に切り替える
最適なモデルはタスクごとに異なる場合があります。1つのワークロードを移行し、ロールバック経路を追加し、評価を再現可能なままにしてください。
Flatkey の役割
Flatkey は、プロバイダーのキーや請求書を製品全体に散らすことなく、複数の AI モデルを比較・ルーティング・運用したい場合に役立ちます。幅広いモデルとツールのカタログ全体で、チームに 1 つのキー、1 つの残高、1 つの使用台帳を提供するため、価格レビューを静的なスプレッドシート比較から再現可能なワークロードテストへ移行しやすくなります。
Flatkey は次のような場合に使います:
- OpenAI 互換の1つの統合の背後で、複数の公式モデルエンドポイントをテストしたいとき;
- 承認された出力コスト、レイテンシ、信頼性でルートを比較したいとき;
- モデルとツールの使用状況を1つの台帳で可視化したいとき;
- 個人開発チームやエージェントに、複数の切り離されたプロバイダーアカウントではなく1つの残高を持たせたいとき;
- プロバイダー固有のコードを前提に全ワークロードを作り直さずに、フォールバックとガバナンスのパターンを追加したいとき。
だからといって、すべてのワークロードを一度に移すべきという意味ではありません。より良い進め方は、コストが高い、または信頼性に欠けるルートを1つ選び、7日間の切り替えテストを実施し、承認された出力の計算結果がより良い場合にのみそのルートを本番化することです。
切り替え前に確認すべき公式価格の参照先
すべての最新価格項目について、一次ソースを使用してください。少なくとも、次を確認します:
| ソース | 確認すべきこと |
|---|---|
| OpenAI pricing | 正確なモデルの入力、キャッシュ済み入力、出力、バッチ、およびツールまたはモダリティの料金。 |
| Anthropic pricing | 入力/出力料金、プロンプトキャッシュの書き込み/読み取りの仕組み、バッチ条件、およびモデル固有の制限。 |
| Google Gemini API pricing | モデル料金、キャッシュ料金、モダリティ単位、無料枠または有料枠の前提。 |
| Flatkey pricing | 比較レイヤーとしてFlatkeyを使う前に、現在の残高、プラン、使用状況、ルーティング条件。 |
| Flatkey models | テスト予定の正確なモデルに対する、利用可能なモデルルートとカタログの対応範囲。 |
古いブログ記事の価格表を移行計画にそのままコピーしないでください。価格、モデルID、キャッシュ条件、可用性は、製品ロードマップよりも速く変わる可能性があります。
よくある質問
AIモデルの価格を比較する最善の方法は何ですか?
AIモデルの価格を比較する最善の方法は、成功したタスクあたりの実効コストを計算することです。入力、キャッシュ済み入力、キャッシュ書き込み、出力、ツール、メディア、再試行、フォールバック、バッチのコストを正規化し、総評価費用を受け入れられたタスク結果で割ります。
別のモデルのトークン単価が安い場合、APIプロバイダーを切り替えるべきですか?
自動的には切り替えるべきではありません。より安いトークン単価が意味を持つのは、品質、出力量、キャッシュ動作、レイテンシ、レート制限、移行作業を考慮しても、成功したタスクあたりの実効コストがさらに低くなる場合だけです。
プロバイダーを切り替える前に、何件のプロンプトをテストすべきですか?
狭いワークフローなら、まず50〜100件の代表的なケースから始めます。広範なアシスタントやエージェントなら、より大きな層化サンプルを使い、タスククラスごとに結果を報告します。重要なのは生のプロンプト数ではなく、本番との関連性です。
キャッシュ割引はAIモデルの価格にどう影響しますか?
大きく安定したプレフィックスが頻繁に再利用される場合、キャッシュ割引でコストを削減できます。一方で、プレフィックスが変わる、キャッシュエントリの期限が切れる、トラフィックが少ない、またはキャッシュ書き込みコストが読み取りコストを上回る場合は、期待外れになることもあります。コールド、想定、ウォームキャッシュの各シナリオをテストしてください。
FlatkeyはAIモデルの価格比較にどう役立ちますか?
Flatkeyは、1つのキー、1つの残高、そして多くのAIモデルとツールにまたがる1つの使用台帳をチームに提供します。これにより、繰り返しのワークロードテストを実行し、ルートを比較し、個別のプロバイダーアカウントごとに評価を作り直す手間を避けやすくなります。
最終的な推奨事項
APIプロバイダーを切り替える前にAIモデル価格を比較する方法に対する実践的な答えは、静的なトークン単価表ではありません。ワークロードのワークシートを作成し、成功条件を定義し、再試行とレイテンシを測定し、キャッシュとバッチの挙動を含めて、成功したタスクあたりの実効コストを計算してください。
その後、1つのルートずつ切り替えます。ロールバック経路を維持し、支出と信頼性を監視し、プロバイダーがモデルID、価格、キャッシュ条件、またはレート制限を変更したときには、再度レビューを行ってください。