El modelo más barato en una página de precios no siempre es el modelo más barato en producción. Una tarifa más baja por token de entrada puede quedar anulada por salidas más largas, un bajo aprovechamiento de la caché, reintentos, fallos de latencia, soluciones para sortear límites de velocidad o una caída de calidad que obligue a hacer una segunda llamada al modelo.
Por eso, la forma correcta de comparar los precios de modelos de IA antes de cambiar de proveedor de API es medir el coste de completar con éxito tu carga de trabajo real, no el coste de comprar un millón de tokens de forma aislada.
Esta guía ofrece a indie hackers y a pequeños equipos de productos de IA un marco práctico de evaluación para cambiar de proveedor de API de IA. Cubre precios principales, comportamiento de la caché, descuentos por lotes, calidad de la carga de trabajo, latencia, fiabilidad, esfuerzo de migración y una hoja de cálculo que puedes reutilizar durante las revisiones mensuales de modelos.
Cómo comparar los precios de modelos de IA antes de cambiar de proveedor de API: la respuesta rápida
Para comparar los precios de modelos de IA antes de cambiar de proveedor de API, crea una tarjeta de puntuación a nivel de carga de trabajo con cinco campos:
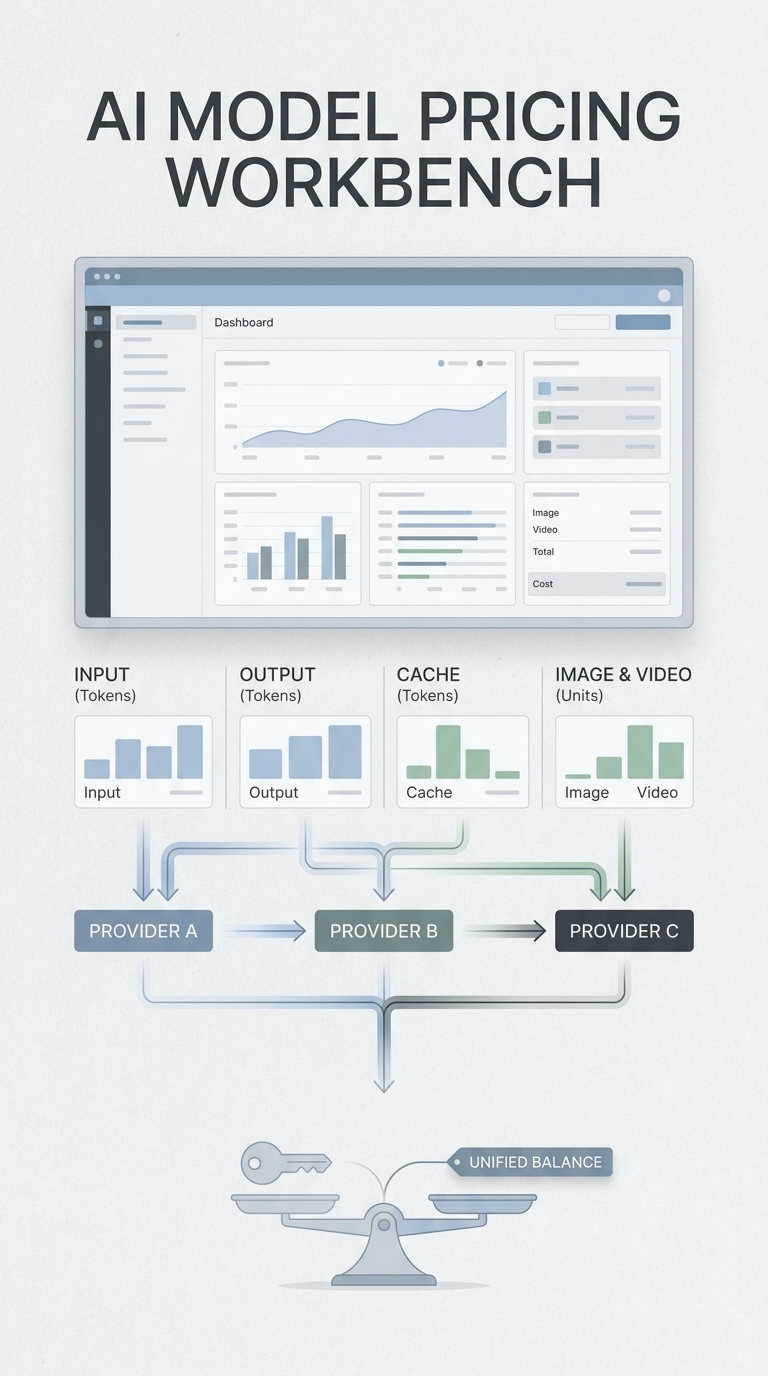
- Unidades de precio del proveedor: entrada, entrada en caché, escritura en caché, salida, herramientas, medios, lote y cualquier cargo por procesamiento prioritario.
- Forma real de la solicitud: tokens de entrada promedio, contexto reutilizable, longitud de salida, llamadas a herramientas, reintentos y llamadas de respaldo.
- Tasa de salida aceptada: con qué frecuencia el modelo completa la tarea según tus propias comprobaciones de aceptación.
- Fiabilidad y latencia: p50, p95, p99, tasa de timeouts, tasa de 429/5xx y frecuencia de respaldo bajo la carga esperada.
- Coste de migración y operación: horas de ingeniería, compatibilidad del SDK, atribución de uso, facturas, reversión y gobernanza.
Usa esta métrica como referencia para la decisión:
coste efectivo por tarea exitosa =
  (gasto del modelo principal + gasto de reintentos + gasto de respaldo + cargos unitarios relacionados)
  / resultados de tareas aceptados
Un modelo que es un 30% más barato por token aún puede salir más caro si falla con más frecuencia, produce respuestas más largas o necesita un segundo proveedor para resolver casos límite.
Por qué el precio por token es una métrica de coste incompleta
Cuando los equipos aprenden por primera vez a comparar los precios de modelos de IA, a menudo crean una tabla con tres columnas: modelo, precio de entrada y precio de salida. Esa tabla es útil para descubrir opciones, pero no basta para justificar un cambio de proveedor de API.
Las facturas modernas de API de IA pueden incluir varios eventos facturables distintos. La página de precios de OpenAI separa las tarifas de entrada, entrada en caché y salida para muchos modelos. Anthropic documenta la caché de prompts con una economía separada de escritura en caché y lectura de caché. Los precios de Google Gemini también varían según el modelo, la modalidad y el comportamiento de la caché. La lección común es simple: cada proveedor expone diferentes mecanismos de precio, así que una comparación directa fila por fila necesita normalización antes de poder guiar una decisión de migración.
Registra estos campos antes de clasificar a cualquier proveedor:
| Campo de coste | Qué capturar | Por qué puede cambiar la decisión |
|---|---|---|
| Tokens de entrada | Tokens del prompt no almacenados en caché y unidad de facturación | Los prompts largos pueden dominar el coste de la solicitud. |
| Entrada en caché o lectura de caché | Contexto reutilizable con descuento, cuando esté disponible | Las suposiciones de caché caliente pueden sobrestimar los ahorros. |
| Escritura o almacenamiento de caché | Coste de crear o mantener contexto reutilizable | Algunas cargas de trabajo pagan por adelantado antes de que aparezca la reutilización. |
| Tokens de salida | Tokens generados visibles y cualquier tratamiento separado de tokens de razonamiento | Los modelos verbosos pueden anular los ahorros de tokens de entrada. |
| Herramientas y búsqueda | Búsqueda web, ejecución de código, llamadas a funciones, herramientas de datos o acciones del navegador | Las cargas de trabajo de agentes a menudo pagan más allá de los tokens de texto. |
| Unidades de medios | Imágenes, audio, vídeo, OCR, transcripción o unidades de embeddings | Los costes multimodales no pueden combinarse en la matemática de tokens de texto. |
| Términos por lotes o asincrónicos | Descuento, ventana de finalización y comportamiento de reintento | Los trabajos nocturnos no deben usar suposiciones de tiempo real. |
| Capacidad prioritaria o provisionada | Procesamiento premium, rendimiento reservado o límites a nivel de cuenta | Los planes de lanzamiento pueden fallar por capacidad incluso cuando el precio unitario parece bajo. |
El objetivo no es memorizar la tabla de precios de cada proveedor. El objetivo es hacer que cada candidato sea comparable dentro de tu propia carga de trabajo.
Normaliza los precios en una sola hoja de cálculo
Cualquier proceso repetible para comparar precios de modelos de IA antes de cambiar de proveedor de API debería empezar por convertir cada candidato en una hoja de cálculo compartida.
Para productos independientes, comparar precios de modelos de IA antes de cambiar de proveedor de API empieza por hacer que cada ruta encaje en el mismo modelo de costes.
Usa una fila por combinación de modelo y carga de trabajo:
| Campo | Candidato A | Candidato B | Candidato C |
|---|---|---|---|
| Proveedor y ruta | |||
| ID del modelo probado | |||
| Tasa de entrada no almacenada en caché | |||
| Tasa de entrada en caché o lectura de caché | |||
| Tasa de escritura o almacenamiento de caché | |||
| Tasa de salida | |||
| Otros cargos por unidad | |||
| Promedio de tokens de entrada no almacenados en caché | |||
| Promedio de tokens en caché o reutilizables | |||
| Promedio de tokens de salida | |||
| Solicitudes de evaluación | |||
| Salidas aceptadas | |||
| Llamadas de reintento | |||
| Llamadas de respaldo | |||
| Gasto total de evaluación | |||
| Coste efectivo por tarea completada con éxito | |||
| Latencia p50 / p95 | |||
| Tasa de errores y timeouts | |||
| Horas de migración | |||
| Notas de decisión |
Luego usa estos cálculos:
tasa de aceptación =
  resultados aceptados / solicitudes de evaluación

costo efectivo por tarea exitosa =
  (gasto del modelo principal + gasto de reintentos + gasto de fallback + cargos unitarios relacionados)
  / resultados aceptados

costo mensual proyectado =
  costo efectivo por tarea exitosa
  * tareas exitosas proyectadas por mes
Esto cambia la pregunta de "¿Qué modelo tiene la tarifa por token más baja?" a "¿Qué ruta completa esta carga de trabajo con el mejor coste, calidad y riesgo operativo?"
Comportamiento de la caché del modelo antes de confiar en un descuento
El precio de la caché es una de las mayores razones por las que una comparación de precios de modelos de IA en titulares puede inducirte a error.
Para aplicaciones con uso intensivo de caché, cómo comparar los precios de modelos de IA antes de cambiar de proveedor de API depende de la reutilización observada, no de los descuentos máximos anunciados.
El contexto reutilizable puede incluir instrucciones del sistema, catálogos de productos, manuales de políticas, resúmenes de repositorios, esquemas, descripciones de herramientas o prefijos largos de few-shot. Si esos tokens son estables y se reutilizan con frecuencia, la caché puede cambiar de forma material el modelo de costes. Si los prompts cambian constantemente, la economía de la caché puede importar muy poco.
Usa este modelo simplificado de solicitud:
coste de la solicitud =
  (tokens de entrada no cacheados * tarifa de entrada)
  + (tokens de escritura en caché * tarifa de escritura en caché)
  + (tokens de lectura de caché * tarifa de lectura de caché)
  + (tokens de salida * tarifa de salida)
  + otras unidades facturables
Prueba tres escenarios:
| Escenario | Suposición de caché | Caso de uso |
|---|---|---|
| Frío | 0% de reutilización | Nuevos inquilinos, prefijos cambiados, cachés expiradas, tráfico escaso. |
| Esperado | Reutilización observada a partir de tráfico representativo | El caso de planificación para producción. |
| Cálido | Alta reutilización | Prefijos estables, solicitudes repetidas, tráfico concentrado. |
No uses una suposición de caché cálida para cada solicitud. Los umbrales mínimos de tokens, las ventanas de retención, los cambios de prefijo, las claves de caché y la distribución del tráfico pueden reducir la tasa de aciertos real.
La decisión segura se basa en la telemetría de caché observada, no en el descuento máximo de caché anunciado.
Mantén separados los flujos de trabajo en tiempo real y por lotes
Las APIs por lotes o asíncronas pueden reducir el coste del trabajo que no necesita una respuesta inmediata, pero también cambian las ventanas de finalización, la observabilidad, el manejo de errores y la experiencia de usuario.
Un chatbot de soporte, un agente de programación y un clasificador de documentos nocturno no deberían compartir una sola suposición de precios.
Antes de cambiar de proveedor de API, clasifica cada carga de trabajo:
| Tipo de carga de trabajo | Comparar con | Vigilar |
|---|---|---|
| Flujo interactivo de usuario | Tarifa del modelo en tiempo real, soporte de streaming, latencia p95 | Pérdida de conversión, UX por time-out, diseño de fallback. |
| Agente de programación o de herramientas | Tarifa de texto más llamadas a herramientas, reintentos, llamadas de fallback, contexto largo | Compatibilidad con llamadas a herramientas y bucles fallidos. |
| Clasificación offline | Tarifa por lotes o asíncrona, rendimiento, ventanas de reintento | Ventana de finalización y reconciliación de resultados. |
| Generación de contenido o medios | Unidades de texto, imagen, vídeo, audio u OCR | Tasa de revisiones y resultados rechazados. |
| Automatización interna | Ruta fiable más barata para resultados aceptados | Supervisión, cuotas y atribución en el libro mayor. |
Esto evita un error común: elegir un proveedor porque es barato para el tráfico fuera de línea y luego descubrir que es demasiado lento o demasiado limitado para solicitudes orientadas al usuario.
Construya un conjunto de evaluación con forma de producción
Los benchmarks públicos pueden ayudarle a descubrir modelos candidatos, pero rara vez coinciden con el diseño de sus prompts, documentos, herramientas, esquema de salida, idiomas o costos de fallo. Un marco útil de evaluación de modelos de IA comienza con sus propias tareas con forma de producción.
Por eso, cómo comparar los precios de modelos de IA antes de cambiar de proveedor de API es, en parte, un problema de diseño de la evaluación.
Cree un conjunto de evaluación con cuatro partes:
- Tareas comunes: las solicitudes que generan la mayor parte de su volumen.
- Tareas difíciles: casos que requieren un razonamiento más profundo, contexto largo o seguir instrucciones con precisión.
- Tareas de riesgo: prompts en los que las alucinaciones, los fallos de formato o una salida insegura tienen un coste alto.
- Tareas límite: contenido multilingüe, formato inusual, datos escasos, errores de herramientas o entradas muy largas.
Para un flujo de trabajo acotado, entre 50 y 100 casos cuidadosamente seleccionados pueden superar a miles de prompts genéricos. Para un asistente amplio, use un conjunto estratificado más grande e informe los resultados por clase de tarea en lugar de ocultar la variación en un único promedio.
Mantenga consistentes entre candidatos los prompts, los ajustes de muestreo, las definiciones de herramientas, los límites de salida y los criterios de aceptación. Si un proveedor requiere un formato de solicitud diferente, documente esa diferencia como esfuerzo de migración en lugar de cambiar silenciosamente la prueba.
Defina qué significa "éxito" antes de ejecutar la comparación
No puede calcular el coste efectivo por tarea exitosa hasta que defina el éxito.
Use criterios de aceptación que coincidan con la carga de trabajo:
| Carga de trabajo | Ejemplo de criterios de éxito |
|---|---|
| Extracción | Campos obligatorios presentes, esquema válido, precisión a nivel de campo. |
| Clasificación | Precisión, exhaustividad, matriz de confusión, casos límite revisados. |
| Generación de código | Las pruebas pasan, las comprobaciones de seguridad pasan, el parche se mantiene dentro del alcance. |
| Atención al cliente | Respuesta fundamentada, uso correcto de la política, tono útil, sin acción fabricada. |
| Agentes | Elección correcta de la herramienta, argumentos válidos, finalización de la tarea, recuperación ante errores de la herramienta. |
| Generación de contenido | Soporte factual, ajuste a la marca, aceptación del editor, tasa de revisión. |
Use comprobaciones deterministas siempre que sea posible. Añada revisión humana ciega para las cualidades que no puedan reducirse a una prueba. Si los revisores saben qué modelo produjo una respuesta, las expectativas sobre el proveedor pueden sesgar el resultado.
Mida la latencia y la fiabilidad como entradas de coste
Un modelo que es un poco más barato pero que regularmente no cumple su objetivo de latencia puede reducir la conversión u obligarle a construir un sistema de respaldo más complejo.
Para rutas de producción, cómo comparar los precios de modelos de IA antes de cambiar de proveedor de API debe incluir latencia, tasas de error y comportamiento de respaldo.
Haga seguimiento de:
- tiempo hasta el primer token;
- tiempo total de respuesta;
- latencia p50, p95 y p99;
- tasa de timeouts;
- tasa de 429 y 5xx;
- número de reintentos;
- frecuencia de fallback;
- tasa de respuesta incompleta o mal formada.
Los límites de tasa deben formar parte de la misma evaluación. Un proveedor puede ofrecer un precio unitario atractivo, pero no tener suficientes solicitudes por minuto, tokens por minuto, concurrencia o capacidad a nivel de cuenta para su plan de lanzamiento.
Ejecute tanto una prueba de calidad aislada como una prueba de carga controlada. La prueba aislada le dice qué puede hacer el modelo. La prueba de carga le dice si el proveedor puede entregarlo bajo su patrón de tráfico esperado.
Incluya los costes de migración y operación
Los equipos que aprenden a comparar los precios de modelos de IA antes de cambiar de proveedor de API a menudo ignoran los costes puntuales y recurrentes fuera de la factura de la API.
La perspectiva de migración importa porque cómo comparar los precios de modelos de IA antes de cambiar de proveedor de API también es una cuestión de tiempo de ingeniería y complejidad operativa.
Agregue estas preguntas a la decisión:
| Área de coste | Preguntas a responder |
|---|---|
| Compatibilidad con la API | ¿Puede cambiar una URL base y un ID de modelo, o debe reescribir la lógica de las solicitudes? |
| Llamada a herramientas | ¿Los esquemas de herramientas, las llamadas paralelas o los mensajes de resultado se comportan de forma diferente? |
| Salida estructurada | ¿Sus esquemas JSON son compatibles de forma consistente? |
| Streaming | ¿El cliente y la interfaz de usuario manejarán el formato de eventos del proveedor? |
| Observabilidad | ¿Puede atribuir el uso, los errores, la latencia y el coste por ruta o carga de trabajo? |
| Gobernanza | ¿Los controles clave, los requisitos de auditoría y las políticas de datos se ajustan a su organización? |
| Fallbacks | ¿Puede cambiar de modelo sin duplicar código específico del proveedor? |
| Facturación | ¿Finanzas puede ver el uso, las recargas, las facturas y el gasto por carga de trabajo sin exportaciones manuales? |
Estime las horas de ingeniería de migración, el mantenimiento de pruebas y la carga operativa mensual. Una pequeña ventaja en la tarifa puede no justificar una reescritura arriesgada. Por el contrario, una ruta compatible con OpenAI con una sólida visibilidad de uso puede hacer que las revisiones repetidas de modelos sean mucho más baratas.
Use una puntuación de decisión ponderada, pero conserve las métricas brutas
Después de recopilar los resultados brutos, cree una puntuación ponderada que refleje la carga de trabajo.
Pesos de ejemplo para un servicio de extracción en producción:
| Dimensión | Peso de ejemplo |
|---|---|
| Tasa de salida aceptada | 35% |
| Coste efectivo por tarea exitosa | 25% |
| Latencia p95 | 15% |
| Fiabilidad bajo carga | 15% |
| Esfuerzo de migración y operación | 10% |
Para un asistente de programación interactivo, la calidad y la latencia pueden merecer más peso. Para la clasificación offline de documentos, el coste por lote y el rendimiento pueden dominar.
No publique solo la puntuación final. Conserve las mediciones brutas para que las partes interesadas puedan cambiar los pesos sin volver a ejecutar la evaluación.
Una prueba de cambio de siete días
Si está decidiendo si cambiar de proveedor de API de IA este mes, ejecute una evaluación breve antes de cambiar el tráfico de producción.
Use este plan de siete días como la versión práctica de cómo comparar los precios de modelos de IA antes de cambiar de proveedor de API.
- Día 1: Elige una carga de trabajo. No migres todo el producto. Elige una ruta de alto costo o alto volumen con criterios de éxito claros.
- Día 2: Captura la línea base actual. Exporta el conteo de solicitudes, las salidas aceptadas, el uso de tokens, los reintentos, la latencia, las tasas de error y el gasto mensual actual.
- Día 3: Normaliza los precios de los candidatos. Completa la hoja de cálculo con las páginas de precios actuales del proveedor y documenta cada campo desconocido.
- Día 4: Ejecuta el conjunto de evaluación. Prueba los candidatos con los mismos prompts, esquemas, configuraciones y límites de salida.
- Día 5: Ejecuta una prueba de carga controlada. Mide la latencia, los 429, los tiempos de espera y el comportamiento de fallback bajo el tráfico esperado.
- Día 6: Puntúa las rutas. Calcula el costo efectivo por tarea exitosa y revisa el esfuerzo de migración.
- Día 7: Canary o rechaza. Envía una pequeña fracción del tráfico a la ruta ganadora con rollback y límites de gasto.
Este flujo de trabajo evita que una decisión de precios se convierta en una migración de proveedor sin límites.
Errores comunes al comparar precios de modelos de IA
Elegir a partir de un solo prompt
Una respuesta impresionante es una demostración, no una evaluación. Usa un conjunto representativo e informa la variación.
Comparar solo los precios de tokens de entrada
Los tokens de salida, la mecánica de caché, los reintentos, las herramientas y las unidades de medios pueden dominar la factura final.
Usar los descuentos máximos de caché como ahorro esperado
Mide la reutilización de caché según la estructura de tus prompts y la distribución de tu tráfico.
Ignorar la longitud de salida
Dos modelos pueden responder correctamente mientras uno genera el doble de tokens de salida facturables.
Tratar los límites de tasa como un problema posterior
Las restricciones de capacidad pueden convertir un modelo económico en una dependencia de producción poco fiable.
Cambiar todas las cargas de trabajo a la vez
El mejor modelo puede variar según la tarea. Migra una carga de trabajo, añade una ruta de rollback y mantén la evaluación repetible.
Dónde encaja Flatkey
Flatkey es útil cuando quieres comparar, enrutar y operar varios modelos de IA sin dispersar las claves del proveedor y las facturas por todo tu producto. Ofrece a los equipos una clave, un saldo y un registro de uso en un amplio catálogo de modelos y herramientas, lo que ayuda a pasar de comparaciones estáticas en hojas de cálculo a pruebas repetibles de cargas de trabajo.
Usa Flatkey cuando quieras:
- probar múltiples endpoints oficiales de modelos detrás de una sola integración compatible con OpenAI;
- comparar rutas por costo de salida aceptada, latencia y fiabilidad;
- mantener visibles el uso de modelos y herramientas en un solo registro;
- dar a los equipos indie y a los agentes un solo saldo en lugar de varias cuentas de proveedor desconectadas;
- añadir patrones de fallback y gobernanza sin reconstruir cada carga de trabajo alrededor de código específico del proveedor.
Eso no significa que todas las cargas de trabajo deban moverse a la vez. La mejor vía es elegir una ruta costosa o poco fiable, ejecutar la prueba de cambio de siete días y promover la ruta solo cuando las matemáticas de la salida aceptada sean mejores.
Referencias oficiales de precios que revisar antes de un cambio
Usa fuentes de primera mano para cada campo de precio actual. Como mínimo, verifica:
| Fuente | Qué confirmar |
|---|---|
| Precios de OpenAI | Tarifas de entrada, entrada en caché, salida, lote y herramientas o modalidades para el modelo exacto. |
| Precios de Anthropic | Tarifas de entrada/salida, mecánica de escritura/lectura de caché de prompts, condiciones de lote y límites específicos del modelo. |
| Precios de la API de Google Gemini | Tarifas del modelo, precios de caché, unidades de modalidad y supuestos de nivel gratuito o de pago. |
| Precios de Flatkey | Saldo actual, plan, uso y condiciones de enrutamiento antes de usar Flatkey como capa de comparación. |
| Modelos de Flatkey | Rutas de modelos disponibles y cobertura del catálogo para los modelos exactos que planeas probar. |
No copies una tabla de precios de una publicación antigua del blog en un plan de migración. Los precios, los IDs de modelo, las condiciones de caché y la disponibilidad pueden cambiar más rápido que la hoja de ruta de tu producto.
Preguntas frecuentes
¿Cuál es la mejor manera de comparar los precios de los modelos de IA?
La mejor manera de comparar los precios de los modelos de IA es calcular el coste efectivo por tarea exitosa. Normaliza los costes de entrada, entrada en caché, escritura en caché, salida, herramientas, medios, reintentos, alternativas y lote; luego divide el gasto total de evaluación entre los resultados de tareas aceptados.
¿Debo cambiar de proveedor de API cuando otro modelo tiene un precio de tokens más barato?
No automáticamente. Un precio de tokens más bajo solo importa si la calidad, la longitud de salida, el comportamiento de la caché, la latencia, los límites de velocidad y el trabajo de migración siguen dando un coste efectivo menor por tarea exitosa.
¿Cuántos prompts debo probar antes de cambiar de proveedor?
Para un flujo de trabajo acotado, empieza con 50 a 100 casos representativos. Para un asistente o agente amplio, usa un conjunto estratificado más grande e informa los resultados por clase de tarea. La clave es la relevancia para producción, no el número bruto de prompts.
¿Cómo afectan los descuentos de caché al precio de los modelos de IA?
Los descuentos de caché pueden reducir el coste cuando un prefijo estable grande se reutiliza con frecuencia. También pueden decepcionar si los prefijos cambian, las entradas de caché caducan, el tráfico es escaso o los costes de escritura en caché superan las lecturas. Prueba escenarios de caché fría, esperada y cálida.
¿Cómo ayuda Flatkey con las comparaciones de precios de modelos de IA?
Flatkey ofrece a los equipos una sola clave, un solo saldo y un único registro de uso para muchos modelos y herramientas de IA. Eso facilita ejecutar pruebas repetidas de cargas de trabajo, comparar rutas y evitar reconstruir cada evaluación alrededor de cuentas separadas de proveedores.
Recomendación final
La respuesta práctica a cómo comparar los precios de los modelos de IA antes de cambiar de proveedor de API no es una tabla estática de tarifas por tokens. Crea una hoja de trabajo de la carga de trabajo, define el éxito, mide los reintentos y la latencia, incluye el comportamiento de caché y lote, y calcula el coste efectivo por tarea exitosa.
Después, cambia una ruta a la vez. Mantén una ruta de reversión, supervisa el gasto y la fiabilidad, y repite la revisión cuando los proveedores cambien los IDs de modelo, los precios, las condiciones de caché o los límites de velocidad.