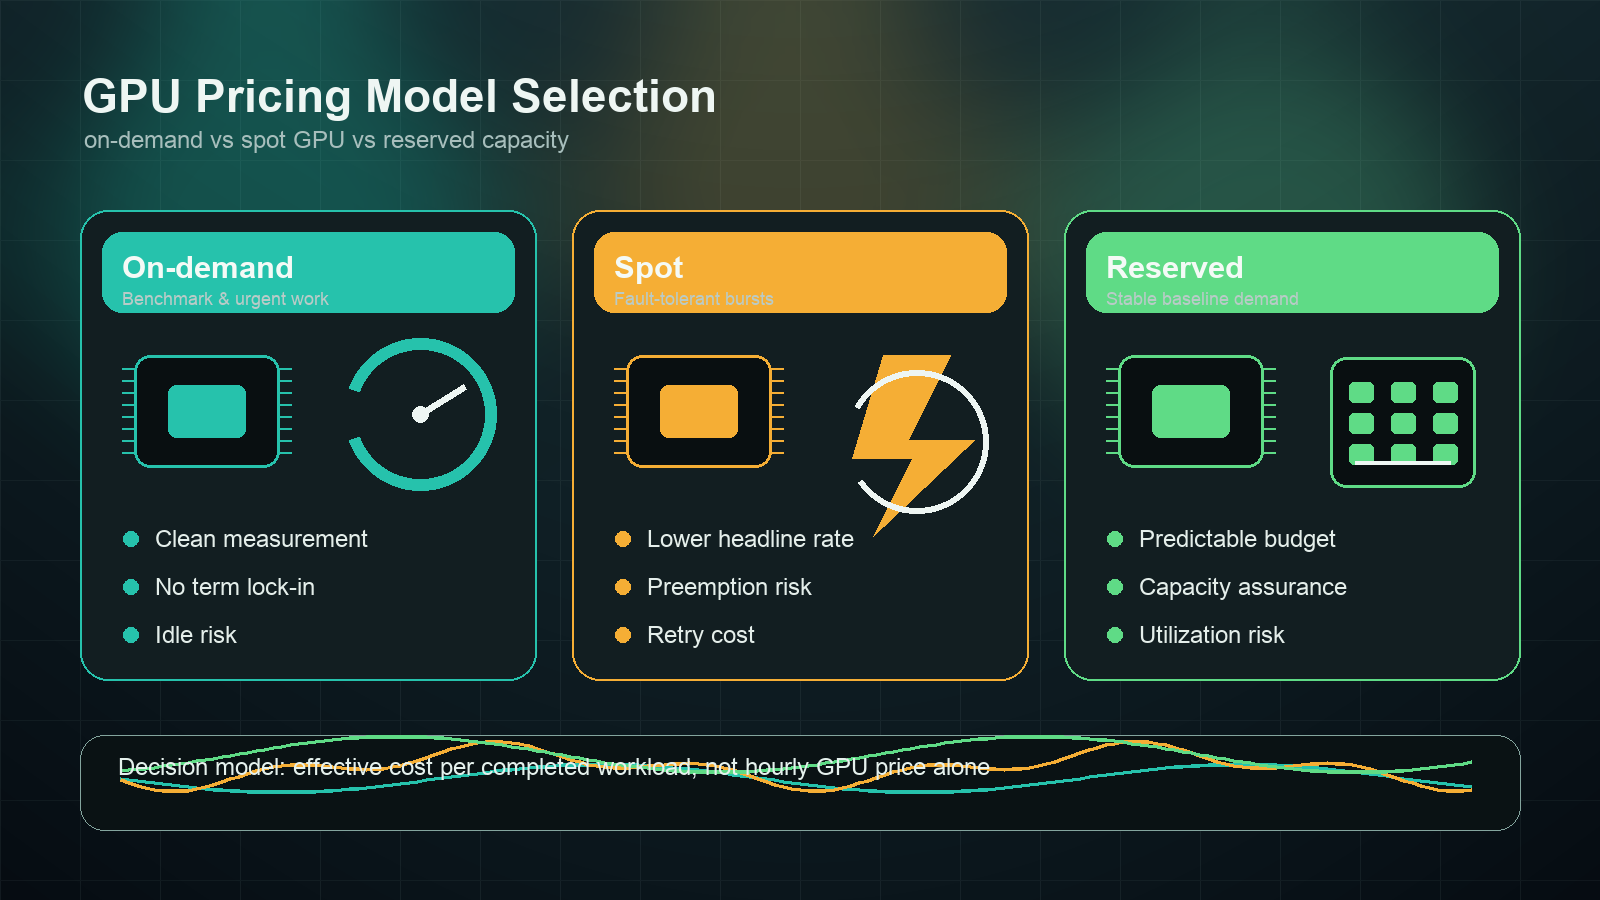
APIs de LLM mais baratas em 2026: compare preços por carga de trabalho, não por hype
Se você está procurando as APIs de LLM mais baratas, comece por uma carga de trabalho, não por um ranking. Uma tarifa baixa por token de entrada ainda pode sair perdendo quando se acrescentam extensão da saída, gravações de cache, chamadas de ferramentas, tentativas repetidas ou o tempo humano necessário para corrigir respostas fracas.
Este guia compara um conjunto pequeno e verificado nas fontes de opções de produção de baixo custo, usando preços públicos de tabela consultados em 23 de outubro de 2026. Não afirma que um provedor é universalmente o mais barato. Preços, disponibilidade, limites de taxa e qualidade dos modelos podem mudar; confirme o cartão atual do modelo antes de colocar em produção.
APIs de LLM mais baratas: a resposta rápida
Para tarefas de texto simples e de alto volume, os preços públicos de tabela abaixo colocam Gemini 2.5 Flash-Lite, OpenAI gpt-6-luna, Claude Haiku 5.5 e DeepSeek Flash em uma lista sensata de primeiros testes. No exemplo específico abaixo de 1M de tokens de entrada mais 250K de tokens de saída, o Gemini 2.5 Flash-Lite tem o menor subtotal ilustrativo de tokens na tarifa padrão entre esses quatro. Isso não o torna automaticamente a escolha para produção.
A resposta certa para “qual é a API de LLM mais barata?” depende de todos os fatores a seguir:
- Quantos tokens de entrada, saída e cache uma tarefa bem-sucedida consome.
- Se a saída estruturada, o uso de ferramentas, a cobertura de idiomas ou o comportamento de segurança do modelo evitam retrabalho caro.
- Se uma camada assíncrona ou em lote atende ao requisito de latência.
- Se chamadas de busca, navegador, armazenamento ou outras ferramentas são cobradas separadamente.
- Se sua camada de roteamento adiciona uma taxa ou altera o modelo, a região, o limite de taxa ou os termos de suporte disponíveis.
Em outras palavras, as APIs de LLM mais baratas são as rotas com o menor custo por resultado aceito para sua carga de trabalho real — não necessariamente o menor número em uma coluna de preço de entrada.
Um retrato datado dos preços das APIs de LLM mais baratas
A tabela usa preços públicos de tabela padrão por 1 milhão de tokens, consultados em 23 de outubro de 2026. Ela compara deliberadamente alguns modelos de texto de baixo custo amplamente usados, em vez de fingir ser um ranking exaustivo de todo o mercado. Impostos, descontos empresariais, preços regionais, créditos, taxas de gateway, cobranças de ferramentas e promoções estão excluídos.
| Provedor | Modelo | Entrada / 1M de tokens | Saída / 1M de tokens | Condição de preço importante |
|---|---|---|---|---|
| Gemini 2.5 Flash-Lite | $0.10 | $0.40 | O Google lista preços separados para tokens em cache e armazenamento; os termos do nível gratuito diferem do uso pago em produção. | |
| OpenAI | gpt-6-luna | $0.10 | $0.50 | Entrada em cache, lote/flex, modos rápido e ultrarrápido têm preços distintos. |
| Anthropic | Claude Haiku 5.5 | $0.10 | $0.50 | A tarifa de entrada listada se aplica a prompts de até 100K tokens; prompts mais longos custam mais. |
| DeepSeek | DeepSeek Flash | $0.30 no pico / $0.15 fora do pico | $1.20 no pico / $0.60 fora do pico | A DeepSeek documenta tarifas variáveis conforme o horário, para pico e fora do pico, além de preços de entrada separados para acertos e falhas de cache. |
Fontes: preços da API Google Gemini, preços da API OpenAI, preços do Anthropic Claude e Modelos e preços da DeepSeek.
A mesma carga de trabalho pode produzir um “vencedor” diferente
Aqui está um exemplo transparente: 1M de tokens de entrada sem cache mais 250K de tokens de saída, usando as tarifas padrão de tokens publicadas acima. Trata-se de um subtotal ilustrativo de preço de tabela, não de uma previsão de fatura.
| Modelo | Cálculo de exemplo | Subtotal ilustrativo de tokens |
|---|---|---|
| Gemini 2.5 Flash-Lite | (1 × $0.10) + (0.25 × $0.40) | $0.20 |
| gpt-6-luna | (1 × $0.10) + (0.25 × $0.50) | $0.225 |
| Claude Haiku 5.5 | (1 × $0.10) + (0.25 × $0.50) | $0.225 |
| DeepSeek Flash, no pico | (1 × $0.30) + (0.25 × $1.20) | $0.60 |
| DeepSeek Flash, fora do pico | (1 × $0.15) + (0.25 × $0.60) | $0.30 |
Use este retrato como ponto de partida para pesquisar as APIs de LLM mais baratas e, em seguida, substitua as quantidades de tokens por uma amostra representativa dos seus próprios logs. Um chatbot de suporte com respostas curtas, um agente de programação que gera patches longos e um pipeline de extração com um prompt estável em cache têm curvas de custo radicalmente diferentes.
Por que o preço de um token não é o custo total
Três equipes podem enviar o mesmo número de solicitações de clientes e pagar preços efetivos muito diferentes:
- A equipe de respostas curtas paga principalmente por entrada, pouca saída e alta taxa de processamento.
- A equipe de agentes pode pagar por definições longas de ferramentas, contexto repetido, chamadas de ferramentas, tentativas repetidas e saída detalhada.
- A equipe de fluxos de trabalho pode aceitar processamento assíncrono e obter um desconto significativo por lote.
É por isso que uma comparação de APIs de LLM mais baratas em 2026 deve separar estes itens de custo, em vez de misturá-los em um único número vago de “por token”:
| Componente de custo | O que medir | Por que isso muda a decisão |
|---|---|---|
| Tokens de entrada | Mediana e p95 de tokens enviados | Prompts de sistema longos e contexto de recuperação podem dominar a fatura. |
| Tokens de saída | Mediana e p95 de tokens gerados | Uma taxa de saída ligeiramente maior importa muito para código, raciocínio e geração de textos longos. |
| Entrada em cache | Proporção de leituras e gravações de cache | Instruções repetidas podem ser significativamente mais baratas somente quando a reutilização do cache é real. |
| Elegibilidade para lote ou processamento assíncrono | Parcela do trabalho que pode esperar | Google e Anthropic documentam descontos de 50% para processamento em lote em cargas de trabalho qualificadas. |
| Unidades de ferramentas e mídia | Chamadas, pesquisas, imagens, armazenamento ou computação | As tarifas de ferramentas podem ser separadas das tarifas de tokens do modelo. |
| Taxa de tentativas e correções | Tentativas por resultado aceito | Um modelo mais barato é caro quando causa chamadas extras ou revisão manual. |
| Gateway e operações | Tarifa, condições de saldo, faturas, sobrecarga administrativa da conta | O menor preço de tabela do modelo não é o mesmo que o menor custo operacional total. |
Por exemplo, a OpenAI lista o preço das chamadas de pesquisa na web separadamente dos tokens do modelo, enquanto a Anthropic observa que as ferramentas do lado do servidor podem ter cobranças adicionais baseadas no uso. Verifique os preços das ferramentas de cada provedor antes de usar uma comparação baseada apenas em tokens para um fluxo de trabalho de agente. Preços da OpenAI e Preços da Anthropic são os pontos de partida oficiais.
Uma calculadora copiável de custo por resultado aceito
Use este cálculo para cada modelo e rota:
Custo por resultado aceito = (custo de tokens de entrada + custo de tokens de saída + custo de cache + custo de ferramentas + custo de novas tentativas + tarifa da plataforma) / saídas aceitas
Para um lote de solicitações, calcule os componentes explicitamente:
- Custo de tokens de entrada = tokens de entrada / 1.000.000 × taxa de entrada.
- Custo de tokens de saída = tokens de saída / 1.000.000 × taxa de saída.
- Custo de cache = leituras de cache × taxa de leitura de cache + gravações de cache × taxa de gravação de cache.
- Custo de novas tentativas = todas as tentativas faturadas, incluindo tentativas com falha que precisam ser repetidas.
- Saídas aceitas = saídas que passam na sua regra de avaliação ou revisão humana sem uma etapa de correção paga.
Adicione duas colunas extras que a maioria das tabelas de preços não inclui:
| Campo | Exemplo | Por que importa |
|---|---|---|
| Taxa de aceitação | 91% | Uma vantagem de preço de 10% desaparece rapidamente se outra rota aprovar significativamente mais tarefas. |
| Custo de correção | US$ 0,04 por tarefa com falha | Inclua a segunda chamada ao modelo, a revisão humana ou a correção posterior que transforma uma falha inicial em um resultado utilizável. |
É neste ponto que uma busca pelas APIs de LLM mais baratas se torna uma decisão de compras, em vez de uma listicle.
Como escolher entre as APIs de LLM mais baratas
1. Segmente o trabalho antes de comparar modelos
Crie grupos de teste separados para classificação, extração, tradução, respostas voltadas ao cliente, geração de código, análise de contexto longo e agentes que usam ferramentas. Não use um único conjunto combinado de prompts. Uma rota que vence na rotulagem de tickets pode ser a escolha errada para edições de código ou suporte ao cliente multilíngue.
2. Execute uma avaliação pequena e fixa
Comece com 100 tarefas representativas por grupo. Para cada tentativa, registre:
- Modelo e ID exato da rota.
- Contagens de tokens de entrada, saída, entrada em cache e raciocínio, quando disponíveis.
- Chamadas de ferramentas e o status dos seus resultados.
- Latência e taxa de timeout.
- Validade da saída estruturada.
- Resultado de aprovação/reprovação específico da tarefa.
- Se foi necessária uma nova tentativa, rota de fallback ou correção humana.
Você não precisa de um benchmark enorme para eliminar falsas economias. Uma decisão confiável sobre as APIs de LLM mais baratas vem de um conjunto consistente de tarefas e de uma regra clara de aceitação, não de um prompt de demonstração do fornecedor.
3. Compare separadamente os caminhos padrão, de cache e de lote
O Google descreve uma redução de 50% para o uso da Gemini Batch API, e a Anthropic documenta um desconto de 50% da Batch API em tokens de entrada e saída. Essas taxas só são úteis quando o seu SLA permite trabalho assíncrono. Preços do Gemini e Preços do Claude devem ser verificados novamente antes de uma implantação em produção, pois a elegibilidade e a disponibilidade dos modelos podem mudar.
4. Defina uma política de roteamento, não apenas um modelo padrão
Quando os testes estiverem concluídos, escreva uma política simples:
- Envie tarefas de baixo risco e alto volume para a rota com o menor custo por resultado aceito.
- Use uma rota de maior capacidade somente quando um gatilho de avaliação exigir isso.
- Armazene em cache instruções estáveis quando o provedor e a carga de trabalho oferecerem suporte.
- Use processamento em lote apenas para trabalhos que podem esperar.
- Defina limites de saída, timeouts e limites de novas tentativas para que uma falha não gere silenciosamente uma fatura alta.
- Mantenha uma rota de fallback para regressões de disponibilidade ou qualidade.
Isso é mais durável do que vincular uma aplicação à página que estiver em primeiro lugar para “API de LLM mais barata”.
Quando uma camada de API com vários provedores ajuda
Comparar contas diretas é razoável quando tem um modelo estável e uma carga de trabalho pequena. Torna-se mais difícil quando uma equipa testa continuamente várias famílias de modelos, gere saldos, reconcilia faturas ou encaminha diferentes tipos de tarefas.
Nessa situação, utilize um gateway apenas depois de verificar o preço total, o ID de modelo suportado, os requisitos regionais e de tratamento de dados, os limites de taxa e o comportamento de fallback. O Diretório de Modelos da Flatkey é um local útil para verificar a disponibilidade e os preços dos modelos em tempo real; a sua página de preços explica as condições atuais de carregamento de saldo. Para um enquadramento de compra mais abrangente, leia a comparação de preços de APIs de IA, como comparar preços de modelos de IA antes de mudar de fornecedor e preços de gateways de IA.
O teste de conversão é simples: se a sua equipa precisa de avaliações repetidas entre fornecedores, uma integração comum e uma vista consolidada da utilização podem reduzir a sobrecarga operacional. Se precisa apenas de uma API direta e os seus preços se adequam à carga de trabalho, a opção direta pode continuar a ser a escolha mais simples.
Perguntas frequentes
Quais são as APIs de LLM mais baratas para tarefas de texto simples?
As APIs de LLM mais baratas para tarefas de texto simples são geralmente as variantes de baixo custo que atingem o seu limiar de qualidade. Na referência de preços datada acima, Gemini 2.5 Flash-Lite, OpenAI gpt-6-luna, Claude Haiku 5.5 e DeepSeek Flash são opções sensatas para testar primeiro. Não considere esta lista curta como um ranking permanente; utilize as ligações para os preços oficiais e os seus próprios dados de avaliação.
Uma API de LLM gratuita é sempre mais barata?
Não. Um nível gratuito pode ser excelente para prototipagem, mas o custo de produção inclui limites de taxa, disponibilidade, tratamento de dados, tentativas e o trabalho necessário quando uma quota se esgota. Consulte o guia de produção para APIs de LLM gratuitas para obter uma lista de verificação de preparação.
O processamento em lote torna uma API de LLM mais barata?
Muitas vezes, sim — quando a carga de trabalho pode esperar. A Google e a Anthropic documentam atualmente reduções de 50% para processamento em lote elegível. Confirme o modelo específico, o tempo de resposta e o suporte de funcionalidades antes de assumir que o processamento em lote é adequado para um pedido direcionado ao utilizador.
O que deve uma equipa de compras perguntar além da tarifa por token?
Pergunte pelo ID exato do modelo, preços de entrada/saída/cache/ferramentas, condições de lote, limites de taxa, termos de dados, disponibilidade regional, nível de suporte, taxa do gateway e o custo por resultado aceite medido pela equipa. Esta lista de verificação transforma «mais barato» de uma manchete numa decisão auditável.
Escolha a opção que torna o trabalho bem-sucedido mais barato
A melhor forma de encontrar as APIs de LLM mais baratas é atribuir preços a uma carga de trabalho real, medir a qualidade e contabilizar todas as etapas de recuperação pagas. Comece pelas tarifas públicas verificadas acima, teste um pequeno conjunto de avaliação e encaminhe cada carga de trabalho para a opção com o menor custo por resultado aceite. Quando precisar de comparar vários fornecedores repetidamente, mantenha os dados do modelo, da rota e da utilização num único lugar, para que a sua próxima decisão de preços demore horas — e não mais um projeto de integração.