
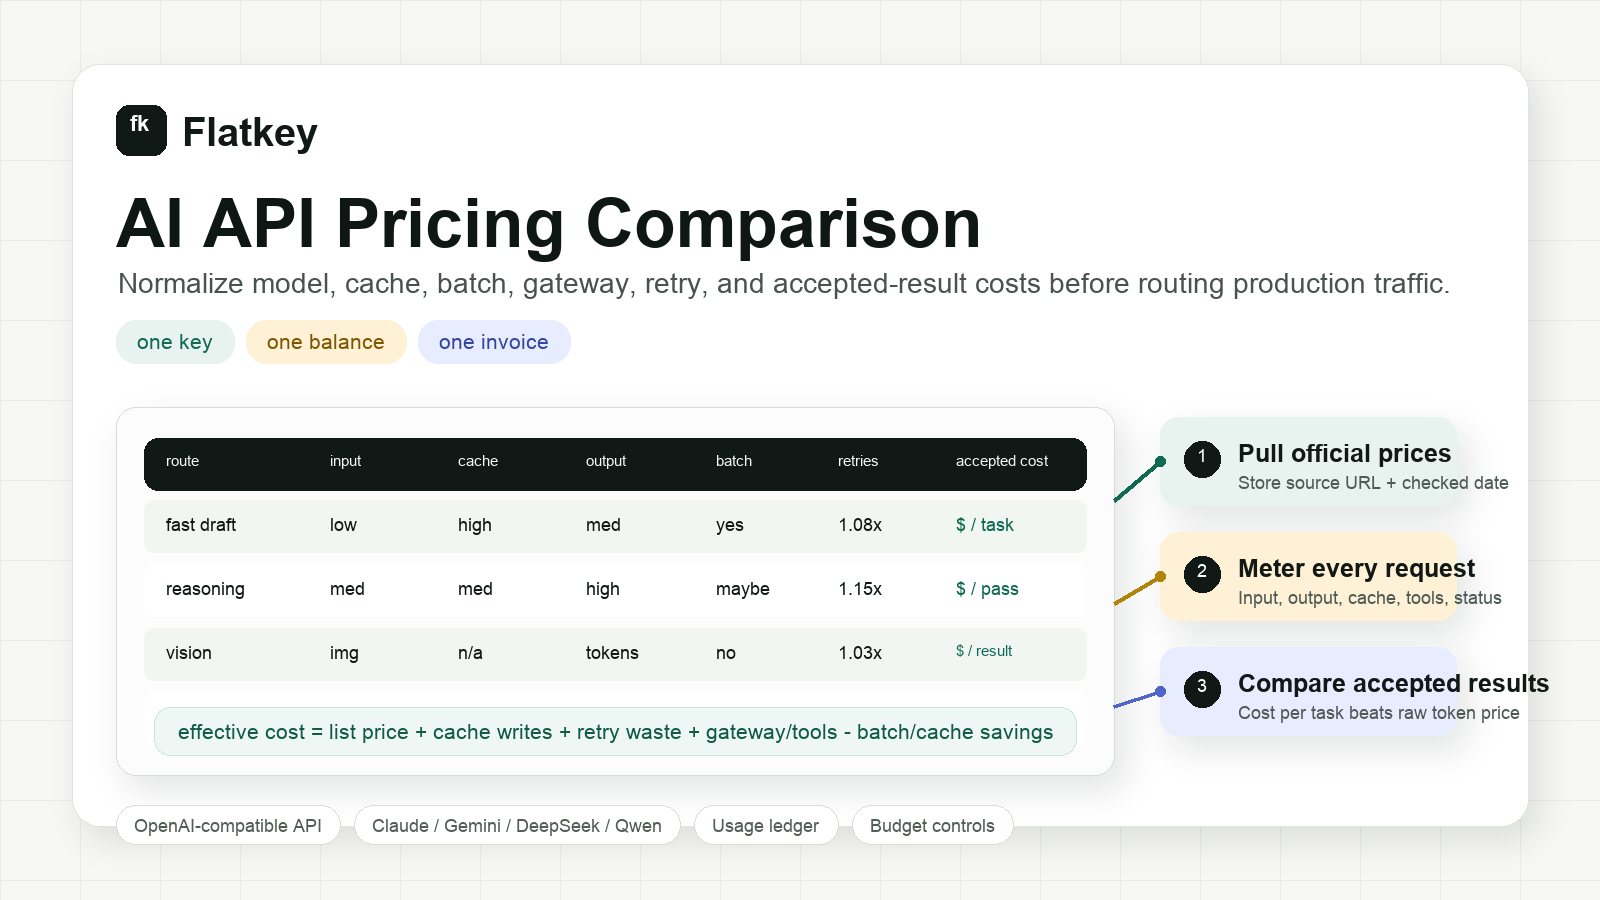
Comparação de Preços de API de IA: Custos de Modelo, Cache, Batch e Gateway
Uma comparação de preços de API de IA só é útil quando corresponde à forma como o seu produto realmente envia pedidos. Uma tabela de preços de tokens de entrada e saída é um ponto de partida, não um orçamento. O gasto real muda com entrada em cache, tokens de raciocínio, novas tentativas, descontos em lote, chamadas de ferramentas, geração de mídia, taxas de gateway e a percentagem de resultados que os seus utilizadores aceitam.
Este guia fornece a desenvolvedores, equipas de produto e equipas de compras uma folha de cálculo prática para comparar preços de API de IA entre OpenAI, Anthropic Claude, Google Gemini, DeepSeek, Alibaba Model Studio/Qwen e uma API multiforncedor, como a Flatkey.
A versão curta: compare custo por resultado aceite, não apenas o preço de tabela por milhão de tokens.
A estrutura rápida de comparação de preços de API de IA
Use esta comparação normalizada antes de mudar de fornecedor, aprovar um orçamento maior ou colocar um fluxo de trabalho de agente em produção.
| Camada | O que comparar | Por que isso altera a sua fatura |
|---|---|---|
| Preço de tabela do modelo | Taxas de entrada, entrada em cache, saída, imagem, áudio, vídeo e chamada de ferramenta | A tabela de preços visível pode favorecer um fornecedor para prompts e outro para conclusões. |
| Formato da carga de trabalho | Tokens médios de entrada, tokens de saída, prefixo passível de cache, tamanho da mídia e chamadas de ferramenta | Um modelo de saída barato pode tornar-se caro se precisar de prompts longos ou novas tentativas repetidas. |
| Descontos e modos | API Batch, níveis flex/priority, acertos de cache, janelas fora de pico, compromisso de uso ou termos de volume | O mesmo modelo pode ter uma economia diferente dependendo do agendamento e da tolerância à latência. |
| Custo de confiabilidade | Taxa de novas tentativas, taxa de fallback, taxa de timeout e política de chamadas falhadas | O desperdício com novas tentativas pode anular a vantagem de um preço de tabela mais baixo. |
| Custo operacional | Chaves de API, faturas, exportações de utilização, controlos de orçamento, retenção de dados e sobrecarga de compras | As equipas de finanças e de plataforma precisam de governança, não apenas de tokens mais baratos. |
| Resultado aceite | Taxa de aceitação, taxa de edição humana, taxa de aprovação do avaliador ou taxa de sucesso da tarefa | O pedido mais barato não é o resultado mais barato se a qualidade cair. |
Para qualquer comparação de preços de API de IA, comece com esta fórmula:
effective cost per accepted result =
  (input cost + cached-input cost + output cost + media/tool cost + gateway cost + retry waste)
  / accepted-result count
Se comparar apenas os preços de tabela dos tokens de entrada e saída, irá ignorar os custos que normalmente aparecem após o lançamento: comportamento de cache, novas tentativas, chamadas de ferramentas e reconciliação financeira.
Tabela atual de fontes de preços
Os preços dos fornecedores mudam frequentemente. Em vez de copiar uma tabela de preços grande e desatualizada para o seu documento de planeamento, mantenha uma tabela de fontes atualizada com a URL oficial, a data verificada e as dimensões de preços que precisa normalizar.
| Fornecedor ou rota | Fonte oficial de preços a verificar | Dimensões de preços a capturar | Notas para comparação |
|---|---|---|---|
| API OpenAI | preços da API OpenAI | Entrada, entrada em cache, saída, modo batch, fine-tuning, mídia, processamento regional | Útil para produtos já construídos em torno de padrões de pedidos compatíveis com OpenAI. Confirme os IDs dos modelos e se está a usar preços padrão ou batch. |
| API Anthropic Claude | preços do Claude | Entrada, saída, cache de prompts, preços batch, família de modelos, janela de contexto | Forte para tarefas de programação, raciocínio e agentes; o comportamento de escrita no cache e acerto de cache é importante para prompts repetidos. |
| API Google Gemini | preços da API Gemini | Plano gratuito/pago, entrada, saída, cache, modo batch, opções priority/flex, grounding de pesquisa | Os preços do Gemini podem variar conforme a família do modelo e o modo de serviço. Registe se há cobrança de pesquisa ou grounding. |
| API DeepSeek | preços da API DeepSeek | Falha no cache de entrada, acerto no cache de entrada, saída, timing de pico/fora de pico, alias do modelo | Os preços de acerto de cache e de janela temporal no estilo DeepSeek exigem registos de pedidos com carimbo de data/hora e estado do cache. |
| Alibaba Model Studio / Qwen | modelos do Alibaba Model Studio | Família de modelos, modalidade, região, token ou unidade de mídia, ID do modelo na consola | Útil para Qwen e acesso a modelos na região China. Verifique a página exata de detalhes do modelo para a unidade faturável. |
| Flatkey multi-provider API | preços da Flatkey e modelos da Flatkey | Rotas unificadas de modelos, um saldo, um registo por pedido, chamadas de ferramenta, faturas, orçamentos de subchave | Útil quando precisa de uma chave, um saldo e um registo de utilização em vários modelos e ferramentas oficiais. |
Adicione três campos obrigatórios a cada linha: data verificada, ID do modelo e unidade. “$ por 1M tokens” não é comparável a “$ por imagem”, “$ por segundo de vídeo”, “$ por chamada de ferramenta” ou “nível priority”.
Construa a folha de cálculo antes de negociar
Uma planilha durável de comparação de preços de API de IA precisa de colunas que reflitam o tráfego de produção.
| Coluna | Valor de exemplo | Por que isso importa |
|---|---|---|
| Fornecedor | Anthropic, OpenAI, Google, DeepSeek, Alibaba, rota Flatkey | Mantém separadas as rotas de fornecedor direto e de gateway. |
| ID do modelo ou da rota | claude-*, gpt-*, gemini-*, deepseek-*, qwen-* |
Evita comparações silenciosas entre diferentes níveis de modelo. |
| URL da fonte de preços | Página oficial do fornecedor ou página do modelo Flatkey | Torna a revisão de compras rastreável. |
| Data da verificação | 2026-10-12 |
Os preços podem mudar mais rápido do que as revisões contratuais. |
| Tokens de entrada por tarefa | 8,000 |
Prompts longos mudam a economia rapidamente. |
| Proporção de entrada passível de cache | 65% |
System prompts estáveis e prefixos de recuperação podem ficar mais baratos. |
| Tokens de saída por tarefa | 1,200 |
Raciocínio e respostas verbosas elevam o custo de saída. |
| Elegível para batch | sim/não | Tarefas offline podem se qualificar para taxas de batch mais baixas. |
| Chamadas de ferramenta/mídia | search, browser, image, video, enrichment | Workflows de agentes não são apenas de texto. |
| Multiplicador de retry | 1.08x |
Timeouts e tentativas de fallback adicionam gastos ocultos. |
| Taxa de aceitação | 82% |
Saída de baixa qualidade aumenta o custo por resultado aceito. |
| Custo de governança | necessidade de invoice, limite de orçamento, exportação, auditoria | O custo de procurement é real mesmo quando as taxas por token são baixas. |
Não faça a média de todos os modelos em uma única linha. Separe por carga de trabalho: chat, RAG, agente de codificação, extração de dados, classificação em batch, geração de imagens, geração de vídeo e execuções de agentes com muitas ferramentas.
Compare preços de fornecedor direto com uma API multi-fornecedor
Contas diretas com o fornecedor são mais simples quando uma família de modelo atende à maior parte do seu trabalho e sua equipe financeira se sente confortável com fornecedores separados. Uma API multi-fornecedor torna-se mais útil quando você precisa comparar modelos continuamente, rotear por carga de trabalho ou governar muitas chaves e invoices.
| Ponto de decisão | Contas diretas com o fornecedor podem ser suficientes quando... | Uma API multi-fornecedor ajuda quando... |
|---|---|---|
| Escolha de modelo | Um fornecedor vence na maioria das tarefas. | Diferentes cargas de trabalho precisam de rotas OpenAI, Claude, Gemini, DeepSeek, Qwen, image, video e tools. |
| Esforço de engenharia | Seu código já chama um fornecedor e raramente muda. | Você quer roteamento compatível com OpenAI e menos reescritas de integração. |
| Controle de custos | Uma invoice e um dashboard são aceitáveis. | Você precisa de orçamentos por subchave, listas de modelos permitidos e exportações de uso por requisição. |
| Procurement | Contratos separados são administráveis. | Contratos duplicados, assentos ociosos e chaves de fornecedor espalhadas atrasam a equipe. |
| Confiabilidade | Interrupções ocasionais do fornecedor são aceitáveis. | Você precisa de políticas de fallback e um ledger compartilhado para custo de retry/fallback. |
| Workflows de agentes | O app só chama modelos de texto. | Os agentes chamam modelos, busca na web, ações no navegador, ferramentas de enriquecimento, imagens e vídeo. |
A Flatkey foi construída para a segunda coluna: uma chave de API, um saldo, uma invoice e um ledger de requisições em mais de 300 modelos oficiais e mais de 1.000 ferramentas pay-per-call. Isso não elimina a necessidade de verificar os preços oficiais dos modelos. Apenas oferece à sua equipe um lugar único para rotear, medir e reconciliar esses custos. Para um detalhamento relacionado das taxas de gateway, veja preços de gateway de IA.
Cinco exemplos de carga de trabalho
1. Chat de suporte
O chat de suporte normalmente tem entrada moderada, saída curta e alto volume. Compare:
- Taxa de acerto do cache do prompt para o system prompt e o texto de política.
- Orçamento de tokens de saída por tipo de resposta.
- Taxa de escalonamento para um modelo mais forte.
- Custo por conversa resolvida, não apenas custo por mensagem.
Para essa carga de trabalho, um modelo rápido e mais barato pode vencer se mantiver a qualidade de resolução alta. Se o modelo mais barato aumentar a taxa de repasse ou de edição, a economia aparente de tokens desaparece.
2. Agente de codificação
Agentes de codificação geralmente têm contexto grande, chamadas de ferramenta, saída longa e múltiplos retries. Compare:
- Tamanho do contexto após busca no repositório ou leitura de arquivos.
- Instruções de projeto passíveis de cache.
- Quantidade de tool calls por tarefa aceita.
- Desperdício de retries devido a rotas sobrecarregadas.
- Custo por alteração mesclada ou patch aceito.
É aqui que uma comparação de preços de API de IA precisa de um ledger. Uma única execução de agente pode incluir chamadas de modelo, chamadas de ferramenta, chamadas de fallback e tentativas falhas.
3. Geração de respostas com RAG
As cargas de trabalho de RAG são dominadas pelo contexto recuperado e pelo comprimento da resposta. Compare:
- Quantidade média de tokens recuperados.
- Proporção de prefixo estável do prompt.
- Comportamento de cache para documentos repetidos.
- Custos de citação e grounding.
- Taxa de aprovação do avaliador para factualidade.
Não escolha um modelo apenas porque seus tokens de entrada são baratos. Se ele precisar do dobro de contexto ou produzir respostas que falhem na avaliação, o custo por resposta aceita pode ser maior. Se esta for a principal questão de migração, use a planilha mais detalhada em como comparar preços de modelos de IA.
4. Classificação em lote
A classificação em lote muitas vezes pode tolerar resultados atrasados. Compare:
- Se o provedor tem uma camada de batch ou flex.
- Tamanho máximo do lote e janela de conclusão.
- Custo de reexecução de erro.
- Taxa de aprovação da validação do esquema de saída.
- Custo total por linha aceita.
Se um provedor oferecer preços mais baixos para batch, a economia só se aplica quando seu fluxo de trabalho pode esperar e seu processo de retry é limpo.
5. Geração de imagem e vídeo
APIs de imagem e vídeo raramente se encaixam em uma planilha baseada apenas em tokens. Compare:
- Unidade de saída: imagem, segundo, clipe, resolução ou crédito.
- Regras de cobrança em caso de geração com falha.
- Taxa de edição/geração מחדש.
- Taxa de aprovação humana.
- Custo por ativo criativo aceito.
Para pipelines de mídia, coloque modelos de tokens e modelos de geração em abas separadas da planilha. A economia unitária é diferente demais para uma única linha combinada.
Um fluxo de trabalho de comparação de preços de API de IA em sete etapas
- Congele a carga de trabalho. Escolha uma família de tarefas real, como respostas de suporte, correções de agente de código, respostas RAG, classificação em lote, geração de imagem ou geração de vídeo.
- Reúna os preços oficiais atuais. Use as páginas de preços dos provedores, as páginas de modelos da Flatkey e uma data verificada. Evite tabelas de tarifas copiadas sem URLs de origem.
- Reproduza o tráfego representativo. Use os mesmos prompts, entradas, limites de saída, política de ferramentas e validadores em todas as rotas.
- Registre cada unidade cobrável. Capture tokens de entrada, tokens em cache, tokens de saída, unidades de mídia, chamadas de ferramentas, tentativas de retry, erros e status.
- Avalie os resultados aceitos. Use revisão humana, validadores automatizados ou verificações de aprovação/reprovação específicas da tarefa.
- Calcule o custo efetivo. Divida o custo total da rota pelos resultados aceitos, não pelo total de solicitações.
- Adicione controles operacionais. Decida se a rota vencedora também atende aos limites de orçamento, necessidades de faturamento, chave de governança, retenção de dados e fallback de incidentes.
O resultado é uma decisão de preços que você pode defender para engenharia e finanças.
Onde a Flatkey se encaixa
A Flatkey não é uma tabela de preços estática. Ela é a camada de roteamento e faturamento para equipes que precisam executar uma comparação real de preços de API de IA em produção. Para a visão mais ampla no nível do modelo, abrangendo custos de tokens, imagem e vídeo, comece pela comparação de preços de modelos de IA.
Use a Flatkey quando quiser:
- Chamar muitos modelos oficiais por meio de uma única chave de API.
- Manter o uso de modelos e ferramentas em um único saldo.
- Comparar rotas sem espalhar chaves de provedores por agentes e repositórios.
- Acompanhar tokens de entrada, saída e em cache, chamadas de ferramentas, status e custo em um único registro.
- Dar às equipes orçamentos de subchave e listas de अनुमति de modelos.
- Reconciliar uma única fatura em vez de vários painéis de provedores.
Comece com a Flatkey quando a própria comparação tiver se tornado um problema operacional. Se sua equipe já sabe exatamente qual provedor vence e não precisa de roteamento entre provedores, uma conta direta pode ser suficiente. Quando as finanças precisarem de responsabilidade por owner, chave e orçamento, combine esta planilha com gestão de gastos com API de IA e controles de quota de API de IA.
Erros comuns na comparação de preços de API de IA
| Erro | O que fazer em vez disso |
|---|---|
| Comparar apenas as taxas de tokens de entrada | Compare entrada, entrada em cache, saída, retries e resultados aceitos. |
| Mixar texto, imagem, vídeo e ferramentas em uma única unidade | Normalize cada modalidade separadamente e depois consolide o custo do fluxo de trabalho aceito. |
| Ignorar o cache de prompts | Meça prefixos de prompt estáveis e taxas de acerto do cache. |
| Ignorar a elegibilidade para batch | Separe jobs sensíveis à latência e jobs offline. |
| Confiar em tabelas de preços copiadas e desatualizadas | Armazene URLs oficiais de origem e datas de verificação. |
| Tratar gateways apenas como margem | Inclua governança, failover, exportações de uso, faturas e tempo de engenharia. |
| Escolher a solicitação mais barata | Escolha o resultado aceito mais barato que atenda aos requisitos de qualidade e confiabilidade. |
Perguntas frequentes
Qual é a melhor forma de comparar preços de API de IA?
A melhor forma de comparar preços de API de IA é normalizar cada rota para custo por resultado aceito. Inclua tokens de entrada, entrada em cache, tokens de saída, unidades de mídia, chamadas de ferramentas, retries, taxas de gateway e a taxa de aceitação da carga de trabalho.
Por que os preços de API de IA diferem tanto?
Os preços de API de IA diferem porque os provedores usam arquiteturas de modelo, camadas de serviço, janelas de contexto, regras de cache, descontos de batch, unidades de mídia e opções regionais ou prioritárias diferentes. Um preço baixo de entrada não significa automaticamente que a rota seja mais barata para sua carga de trabalho.
Devo usar um único provedor ou uma API multprovedor?
Use um provedor quando uma única família de modelo cobre a carga de trabalho e o faturamento separado é fácil de gerenciar. Use uma API multi-provedor quando você precisar comparar rotas continuamente, gerenciar várias chaves, rotear entre modelos de texto e mídia, ou reconciliar o uso em um único livro-razão.
Com que frequência os preços devem ser reavaliados?
Reavalie os preços antes de qualquer grande mudança de roteamento, revisão de contrato ou previsão de orçamento. Para cargas de trabalho de produção em rápida evolução, armazene a fonte de preços e a data da verificação em sua planilha de custos para que finanças e engenharia possam ver quando os números podem estar desatualizados.
Um preço de token mais baixo sempre reduz o gasto total com IA?
Não. Um preço de token mais baixo pode sair perdendo quando você inclui prompts mais longos, saídas mais longas, menor taxa de aceitação, novas tentativas, chamadas de fallback, uso de ferramentas e custo operacional extra de governança. A métrica duradoura é o custo efetivo por resultado aceito.
Lista de verificação final
Antes de escolher uma rota, confirme:
- O ID do modelo, a fonte de preços e a data da verificação estão registrados.
- Entrada, entrada em cache, saída, mídia e unidades de ferramentas estão separados.
- O modo batch ou prioridade está explicitamente sinalizado.
- O custo de retry e fallback está incluído.
- A taxa de aceitação é medida com tarefas reais.
- O procurement consegue reconciliar a fatura e exportar o livro-razão de uso.
- A decisão final se baseia no custo por resultado aceito, e não apenas no preço de tabela.
Essa é a comparação prática de preços de API de IA: preços atuais da fonte, tráfego moldado pela produção e um livro-razão em que finanças e engenharia podem confiar.


