
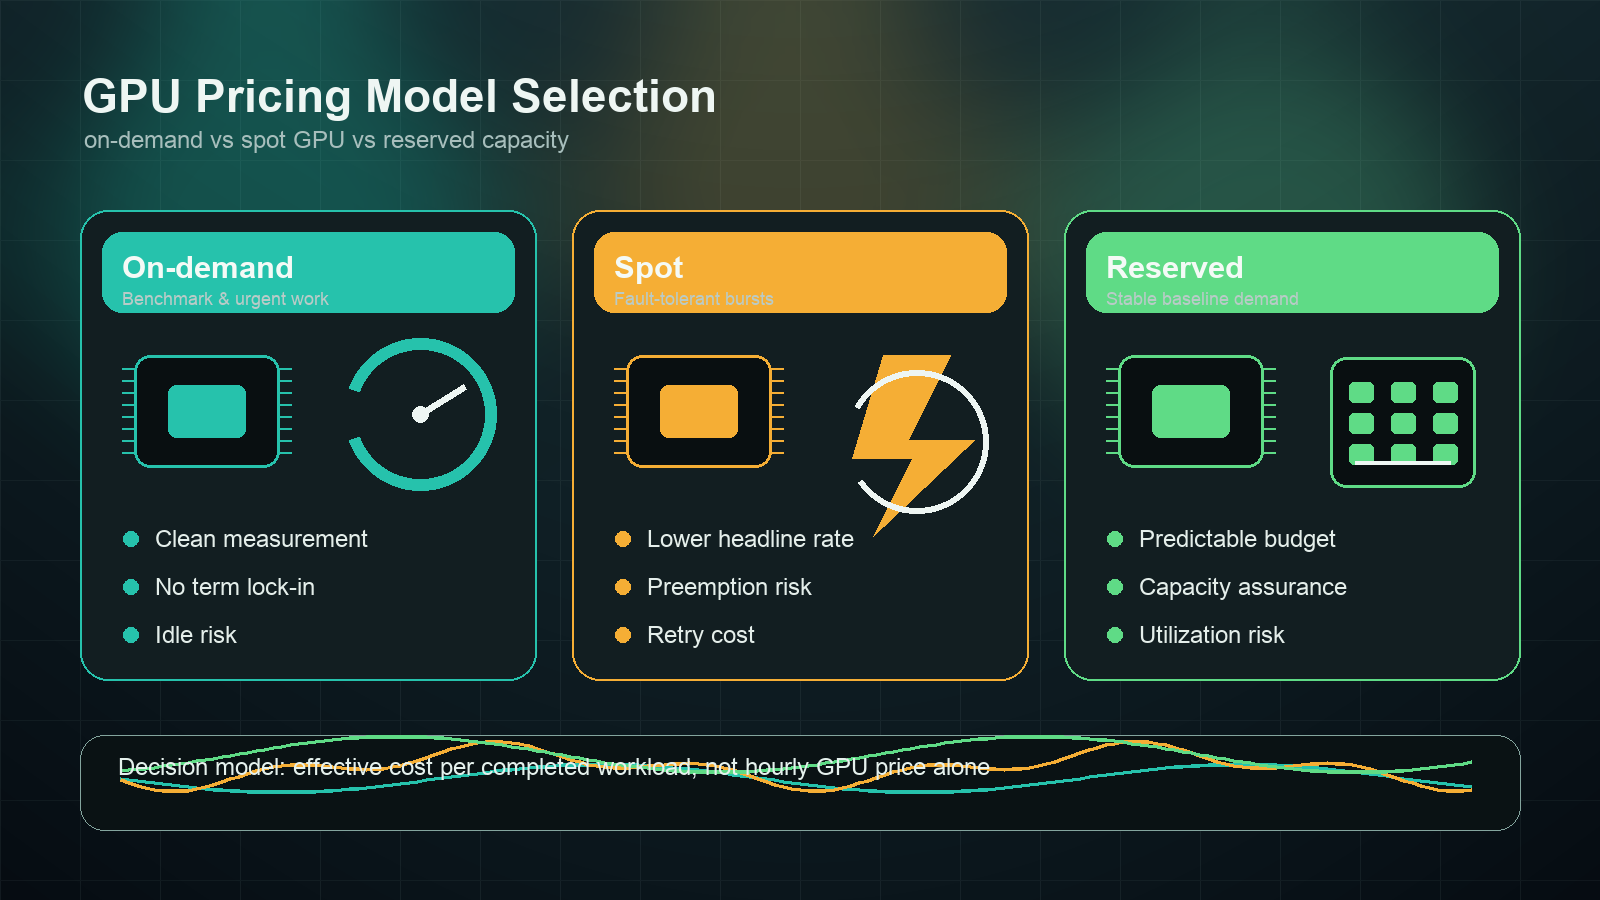
Escolher entre capacidade de GPU sob demanda vs spot não é apenas um exercício de tabela de preços. O preço horário mais barato pode sair caro se os jobs reiniciarem, os checkpoints forem fracos, os dados precisarem ser recarregados ou os engenheiros passarem dias mantendo máquinas interrompíveis em funcionamento. A capacidade de GPU reservada também pode parecer mais barata até que a demanda do modelo mude e a equipe fique presa a hardware subutilizado.
Este guia compara preços de GPU sob demanda, spot e reservada para compradores de infraestrutura de IA, equipes de FinOps e engenheiros de plataforma que precisam de um modelo prático de decisão para workloads. A resposta curta: use GPUs sob demanda para as primeiras medições e trabalhos urgentes, GPUs spot para workloads em lote tolerantes a falhas e capacidade de GPU reservada apenas depois que você conseguir provar a utilização de base.
Se você ainda está decidindo se deve alugar GPUs, comece pelos guias mais amplos de preços de aluguel de GPU e GPU cloud vs API de modelo. Este artigo foca na escolha do modelo de preço depois que você já sabe que capacidade de GPU faz parte do plano.
A resposta rápida: on-demand vs GPU spot vs reservada
Para a maioria das equipes, a primeira análise deve ser assim:
| Modelo de preço | Melhor uso | Principal risco | Métrica a monitorar |
|---|---|---|---|
| GPU sob demanda | Benchmarks, experimentos urgentes, demos, produção inicial, utilização desconhecida | Tempo ocioso e tarifa horária nominal mais alta | Minutos úteis de GPU ativa / minutos cobrados |
| GPU spot | Inferência em lote, avaliações offline, treinamento com checkpoints, filas de mídia, workers com retry | Expulsão, atraso na fila, desperdício por reinício, trabalho duplicado | Jobs concluídos após custo de interrupção |
| GPU reservada | Inferência de produção estável, treinamento agendado, janelas de lançamento, clusters dedicados | Subutilização, lock-in de hardware, incompatibilidade de contrato | Utilização de base versus ponto de equilíbrio do compromisso |
A regra duradoura para decisões entre on-demand e GPU spot é simples: compare o custo efetivo por workload concluído, não a hora de GPU anunciada.
custo efetivo por workload concluído =
  (compute + armazenamento + largura de banda + tempo ocioso + desperdício por reinício + suporte + overhead de engenharia)
  / jobs aceitos, tokens treinados, tokens de inferência, imagens, clipes ou execuções de benchmark
Essa fórmula importa porque cada modelo desloca o risco para um lugar diferente. O on-demand coloca o risco no tempo ocioso. O spot coloca o risco em interrupções e orquestração. A capacidade reservada coloca o risco na precisão da previsão.
O que significa preço de GPU sob demanda
O preço de GPU sob demanda é a base mais limpa. Você paga enquanto a instância, o pod ou o servidor está em execução, sem compromisso de longo prazo. A AWS descreve as On-Demand Instances como capacidade pay-as-you-go, sem compromissos de longo prazo. Clouds especializadas em GPU usam linguagem semelhante para pods, instâncias ou servidores de GPU por hora, mesmo que a unidade de cobrança e o armazenamento incluído variem.
Use sob demanda primeiro quando o workload ainda for desconhecido:
| Caso de uso | Por que sob demanda se encaixa |
|---|---|
| Primeiro benchmark de um modelo ou stack de serving | Você precisa de tempo limpo, sem variáveis de interrupção. |
| Validação de driver, CUDA, contêiner ou framework | Debug não deve ser misturado com risco de expulsão do spot. |
| Ambiente de demo para cliente ou QA | Previsibilidade importa mais do que a menor tarifa. |
| Endpoint de produção inicial | Você precisa de disponibilidade antes de ter dados estáveis de utilização. |
| Execução curta e urgente de treinamento ou fine-tuning | O atraso na fila pode custar mais do que a economia por hora. |
A armadilha é o tempo ocioso. Se um notebook, pod ou servidor de inferência roda por 100 horas cobradas, mas a GPU fica ativa por apenas 28 horas úteis, o custo real não é a tarifa horária publicada pelo provedor. A taxa real é inflada pelo desperdício ocioso.
taxa horária efetiva sob demanda =
  tarifa horária sob demanda publicada / participação de utilização útil
Se a utilização for 35%, uma GPU de $4/hour se comporta como um recurso de $11.43/useful-hour antes de armazenamento, largura de banda ou overhead de engenharia. Para decisões entre on-demand e GPU spot, corrija desligamentos por inatividade e empacotamento de filas antes de negociar uma tarifa horária melhor.
O que significa preço de GPU spot
O preço de GPU spot usa capacidade sobrante ou interrompível. A AWS diz que as EC2 Spot Instances usam capacidade EC2 sobrante e podem oferecer descontos de até 90% em comparação com preços On-Demand. Google Cloud Spot VMs e Azure Spot Virtual Machines seguem o mesmo padrão amplo: capacidade com preço mais baixo que pode ser preemptada ou removida quando a nuvem precisar dela de volta.
GPUs spot são atraentes para workloads de IA porque treinamento, avaliação, geração de imagens e inferência em lote geralmente têm grandes partes que podem ser repetidas. Mas "repetível" não é automático. Você precisa de checkpointing, jobs idempotentes, localidade de dados, monitoramento e um agendador que possa reiniciar sem corromper os resultados.
Spot costuma ser um forte candidato quando:
- Os jobs de treinamento fazem checkpoints com frequência e retomam sem problemas.
- A inferência em lote pode ser repetida sem falha visível para o usuário.
- Avaliações offline podem ser executadas em vários workers.
- Jobs de geração de mídia ficam atrás de uma fila.
- Um worker com falha não invalida o job completo multi-node.
- A equipe já tem orquestração para expulsões e prevenção de duplicatas.
Spot costuma ser um candidato fraco quando:
- Uma única execução de treinamento de vários dias reinicia a partir de um checkpoint antigo.
- O tempo de inicialização é dominado pelo download de modelos, imagens ou conjuntos de dados.
- A latência voltada ao cliente depende de a máquina permanecer ativa.
- O treinamento multi-node falha quando um worker desaparece.
- Os engenheiros precisam supervisionar manualmente as reinicializações.
Para os prós e contras de instâncias de GPU spot vs sob demanda, a matemática deve incluir o desperdício por interrupções:
taxa horária efetiva da spot =
  taxa horária da spot / (1 - participação de desperdício por interrupção)
Se a spot for 60% mais barata, mas interrupções, recarregamentos de dados, etapas com falha e atraso na fila desperdiçarem 35% do trabalho decorrido, o desconto real é muito menor do que a tarifa anunciada. Se o desperdício por reinicialização atingir a mesma ordem de grandeza do desconto, a capacidade sob demanda costuma ser mais simples.
O que significa preço reservado de GPU
Preço reservado de GPU é um modelo de compromisso. Ele pode aparecer como instâncias reservadas, Savings Plans, descontos por uso comprometido, clusters reservados, capacidade privada, blocos de capacidade ou contratos dedicados de GPU. Os nomes diferem conforme o provedor, mas a troca é a mesma: você troca flexibilidade por capacidade previsível ou por uma taxa efetiva menor.
A capacidade reservada de GPU faz sentido quando:
| Sinal | O que significa |
|---|---|
| Tráfego estável de inferência de base | Você consegue manter as GPUs ocupadas durante a maior parte das horas do mês. |
| Calendário de treinamento recorrente | Você sabe quando a capacidade é necessária e por quanto tempo. |
| Necessidade de capacidade no lançamento | Você não pode depender da disponibilidade spot em regime de melhor esforço. |
| Requisito de topologia multi-node | Importam o posicionamento de rede, a malha e a localidade do armazenamento. |
| Compras precisam de gasto fixo | Um compromisso mensal conhecido é mais fácil de aprovar do que um uso volátil. |
A principal questão da capacidade reservada é o ponto de equilíbrio de utilização:
utilização de equilíbrio da capacidade reservada =
  compromisso mensal reservado
  / (taxa horária sob demanda * horas no mês)
Se o compromisso reservado se equilibra em 62% de utilização e sua base real é 25%, a capacidade reservada não é um desconto. É uma assinatura de capacidade ociosa. Para clusters de GPU, combine isso com o modelo de TCO de cluster de GPU para incluir rede, armazenamento, suporte, hands remotas e operações.
Matriz de decisão por carga de trabalho
O melhor modelo de preço depende mais da tolerância a falhas e da utilização do que apenas do tamanho do modelo.
| Carga de trabalho | Melhor ponto de partida | Por quê |
|---|---|---|
| Primeiro benchmark de modelo | GPU sob demanda | Você precisa de uma base limpa para throughput, latência, memória e modos de falha. |
| Avaliação de nova stack de serving | GPU sob demanda | Valide vLLM, SGLang, TensorRT-LLM, drivers, imagens e carregamento do modelo antes de otimizar o preço. |
| Suíte de avaliação offline | GPU spot | Os resultados podem ser reexecutados, divididos e verificados quanto a trabalho duplicado. |
| Embedding em lote ou inferência em lote | GPU spot, com fallback para sob demanda | Os jobs podem entrar em fila se houver controles de idempotência e de retry. |
| Baseline de inferência voltado ao cliente | Reservado mais pico sob demanda | Demanda estável pode justificar o compromisso; o pico continua flexível. |
| Lançamento único ou campanha curta | Sob demanda ou bloco de capacidade | A garantia de capacidade pode importar mais do que um desconto de longo prazo. |
| Treinamento distribuído multi-node | Reservado ou cluster dedicado | Posicionamento, malha de rede e domínios de falha dominam o preço por hora. |
| Recurso de produto de IA de baixo volume | API de modelo ou gateway | Capacidade de GPU ociosa pode custar mais do que inferência gerenciada baseada em uso. |
Para seleção de modelo de GPU em qualquer linha, combine este artigo com o guia de seleção de GPU para IA, a melhor GPU para inferência de LLM e o guia de implantação do vLLM.
Economia de GPU sob demanda vs spot: um exemplo simples
Suponha que um lote de inferência possa rodar na mesma classe de GPU no modo sob demanda ou spot.
| Campo | Sob demanda | Spot |
|---|---|---|
| Taxa horária listada | $4.00 |
$1.80 |
| Utilização útil | 70% |
70% |
| Desperdício por reinicialização e expulsão | 0% |
22% |
| Custo efetivo por hora útil | $5.71 |
$3.30 |
A spot ainda vence neste exemplo porque o desconto é maior do que o desperdício. Agora altere o desperdício por reinicialização para 55% porque o job recarrega pesos repetidamente e perde lotes parciais.
| Campo | Sob demanda | Spot |
|---|---|---|
| Taxa horária listada | $4.00 |
$1.80 |
| Utilização útil | 70% |
70% |
| Desperdício por reinicialização e expulsão | 0% |
55% |
| Custo efetivo por hora útil | $5.71 |
$5.71 |
Nesse ponto, o aparente desconto do spot desaparece. É por isso que uma comparação entre GPU sob demanda vs spot deve incluir desperdício operacional, e não apenas a porcentagem de spot do provedor.
Economia de GPU reservada: o teste de utilização
A capacidade reservada precisa de um teste diferente. Suponha que uma GPU sob demanda custe $4/hour, e que um compromisso mensal reservado para capacidade equivalente seja $1,900/month.
monthly on-demand cost at 100% utilization =
  $4 * 730 hours = $2,920

reserved break-even utilization =
  $1,900 / $2,920 = 65%
Essa reserva só é atrativa se a carga de trabalho conseguir manter a GPU ocupada por mais de cerca de dois terços do mês. Se o seu endpoint de produção usa a GPU intensamente durante o horário comercial, mas fica ocioso à noite e nos fins de semana, a linha de base real pode ficar abaixo do ponto de equilíbrio.
A versão de compras da questão é:
- Qual é a linha de base medida, e não o pico previsto?
- Quais cargas de trabalho podem preencher a capacidade reservada ociosa?
- O que acontece se o modelo migrar de H100 para H200, B200, L40S ou para uma API gerenciada?
- Armazenamento, suporte, rede e egress estão dentro ou fora do compromisso?
- O contrato pode ser reduzido, converter o tipo de GPU ou mudar de região?
Não reserve com base na esperança. Reserve com base na utilização medida.
Checklist de fontes do provedor
As páginas de preços de GPU mudam com frequência, e os preços de marketplace podem mudar mais rápido do que um ciclo de compras. Use isto como uma checklist de fontes, não como uma tabela de preços fixa. Verifique novamente no dia em que aprovar o gasto.
| Categoria do provedor | Fonte oficial a verificar | O que capturar |
|---|---|---|
| AWS | Preços do Amazon EC2, EC2 Spot Instances, EC2 Capacity Blocks for ML | Região, família da instância GPU, On-Demand, Spot, Savings Plans ou Reserved Instances, timing do capacity block, EBS, transferência de dados, suporte. |
| Google Cloud | Preços de GPU do Compute Engine, Spot VMs, Descontos por uso comprometido | Tipo de GPU, família da máquina, região, status da Spot VM, prazo do compromisso, necessidades de reserva, disco persistente, egress de rede. |
| Microsoft Azure | Azure Spot Virtual Machines, Reserved VM Instances | SKU da VM com GPU, região, política de expulsão, configuração de preço máximo, prazo da reserva, disco gerenciado, largura de banda, suporte. |
| RunPod | Preços da RunPod e documentação do produto | Secure Cloud vs Community Cloud, preços de pod, preços de serverless, armazenamento persistente, volume de rede, comportamento de cold start. |
| Vast.ai | Preços da Vast.ai e documentação da Vast.ai | Confiabilidade do host, status de datacenter/comunidade, sinalizador interruptible, disco, largura de banda, host verificado, necessidades de IP público. |
| Lambda | Preços de GPU do Lambda Cloud | Tipo de instância, quantidade de GPUs, região, disponibilidade sob demanda, termos da cotação de cluster reservado, premissas de armazenamento e rede. |
Adicione uma linha de data verificada à sua planilha. Para este artigo, a checklist de fontes foi revisada em 13 de outubro de 2026.
Perguntas de compras antes de escolher
Antes de escolher capacidade de GPU sob demanda vs spot ou assinar um contrato de GPU reservada, faça estas perguntas:
| Pergunta | Por que isso importa |
|---|---|
| O job pode criar checkpoint e retomar sem reparo manual? | Determina se o risco de interrupção do spot é aceitável. |
| Quanto tempo leva a inicialização antes que o trabalho útil da GPU comece? | Carregamento longo de modelo e dados reduz a economia do spot e prejudica a eficiência do on-demand. |
| Qual é a taxa de ociosidade medida? | O tempo ocioso é a principal fonte de desperdício de custo no on-demand. |
| Qual é a linha de base, e não o pico? | O preço reservado só funciona quando a demanda de base é real. |
| A carga de trabalho precisa de uma região específica ou de um fabric de rede específico? | Topologia escassa pode tornar irrelevantes as taxas genéricas de spot/on-demand. |
| Armazenamento, snapshots, largura de banda e suporte estão incluídos? | Horas de GPU são apenas uma linha na fatura real. |
| Qual é o caminho de saída se a escolha do modelo mudar? | Lock-in de hardware é caro quando a arquitetura do modelo muda. |
| Uma API de modelo gerenciada pode atender à necessidade em vez disso? | Cargas de trabalho com baixa utilização ou multi-modelo podem não justificar operações de GPU. |
Para decisões de múltiplos nós e de capacidade privada, compare isto com aluguel de cluster de GPU e nuvem privada de GPU.
Quando uma API de modelo supera os três modelos de preço de GPU
GPUs sob demanda, spot e reservadas assumem que alugar e operar hardware é a camada correta de abstração. Isso nem sempre é verdade.
Uma API de modelo gerenciada pode ser o melhor ponto de partida econômico quando:
- A utilização é baixa, intermitente ou desconhecida.
- O produto precisa de muitos modelos em vez de um único modelo auto-hospedado.
- Confiabilidade, atualizações e escalabilidade distrairiam do roadmap do produto.
- A equipe precisa mais de registros de uso, orçamentos e faturas do que de controle do hardware.
- A carga de trabalho é inferência em produção, e não treinamento de modelos ou pesquisa de serving personalizado.
O Flatkey fica desse lado da decisão baseado em API. Ele oferece às equipes de IA uma chave de API, um saldo, uma fatura, visibilidade de uso e acesso a rotas oficiais de modelos entre provedores. Se a planilha de GPU sob demanda vs spot mostrar que a utilização do hardware ainda não está alta o suficiente, compare o custo por resultado aceito da API gerenciada antes de comprar ou reservar capacidade de GPU. O próximo passo são os guias comparação de preços de modelos de IA e preços de gateway de IA.
Recomendação final
Use esta sequência:
- Comece com capacidade de GPU sob demanda até que os números de benchmark e utilização sejam confiáveis.
- Migre os trabalhos que podem ser repetidos para GPUs spot somente depois que checkpointing, idempotência e automação de reinício estiverem comprovados.
- Reserve capacidade de GPU apenas para demanda de base medida, janelas de lançamento comprometidas ou clusters sensíveis à topologia.
- Mantenha um caminho de API de modelo aberto quando a utilização for baixa, a escolha de modelo mudar com frequência ou as finanças precisarem de uma atribuição de uso mais limpa.
A melhor decisão entre GPU sob demanda vs spot não é a que tem a menor taxa horária listada. É a decisão entre GPU sob demanda vs spot que minimiza o custo por carga de trabalho concluída, mantendo o risco de confiabilidade onde sua equipe realmente pode gerenciá-lo.


