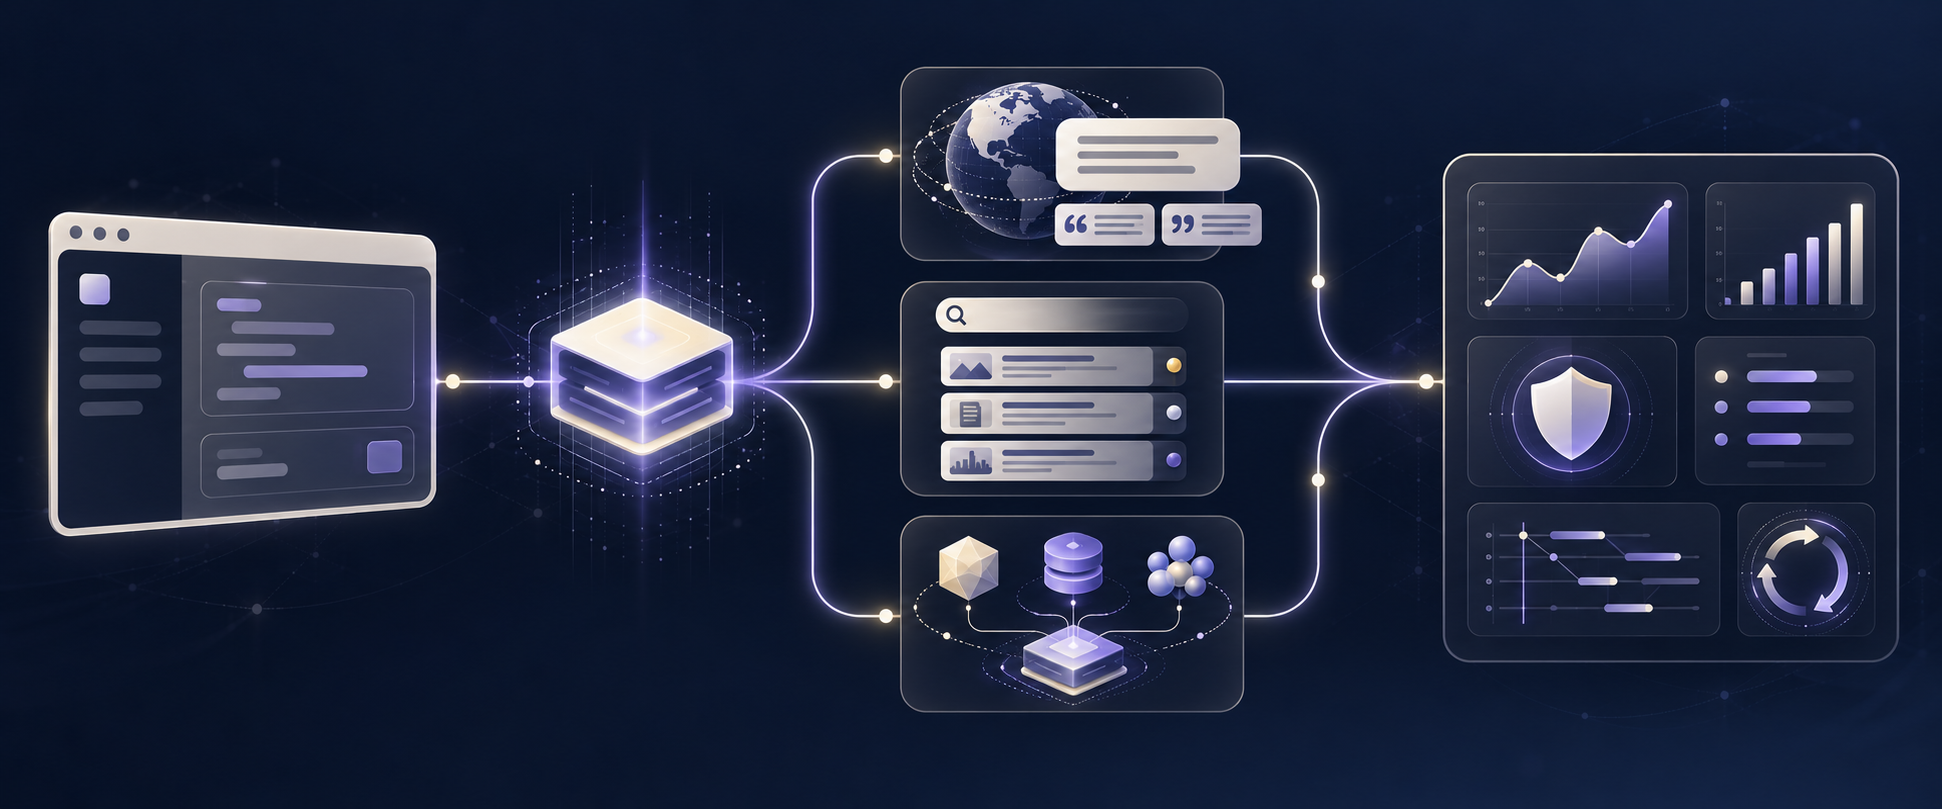
O batching contínuo permite que um servidor vLLM admita uma nova solicitação enquanto outras solicitações ainda estão gerando tokens. Um lote fixo espera que todos os membros terminem antes de formar o próximo lote; o batching contínuo revisita o conjunto ativo em cada etapa de agendamento. Essa distinção é importante quando prompts e saídas têm comprimentos diferentes. Solicitações curtas podem entrar no trabalho da GPU sem esperar pela resposta mais longa de um grupo anterior.
Para uma equipe de inferência, a pergunta útil não é se o batching contínuo está habilitado em uma lista de recursos. É se a sua combinação real de solicitações aumenta as respostas concluídas por segundo sem elevar o tempo até o primeiro token, o tempo na fila ou a taxa de erros além da meta do seu serviço. Este guia explica o mecanismo, os limites relevantes e um benchmark que você pode executar antes de escolher a capacidade de GPU.
Como funciona o batching contínuo do vLLM
Na arquitetura V1 atual do vLLM, o agendador preenche um orçamento de tokens em cada etapa usando solicitações em execução e em espera. Uma solicitação rastreia quantos tokens foram computados; o agendador atribui trabalho para reduzir essa diferença. O mesmo loop lida com prefill em blocos, cache de prefixos e decodificação especulativa. Este é um modelo mental mais preciso do que um diagrama de um lote estático que é executado até a conclusão. Consulte a visão geral da arquitetura do vLLM para ver a descrição do agendador.
Imagine três chegadas: uma resposta curta de chat, um prompt longo de documento e outro chat curto. Com um lote fixo, o segundo chat curto poderia esperar pelo limite do lote da solicitação longa. Com o batching contínuo, ele pode ser considerado em uma etapa de agendamento posterior enquanto as primeiras solicitações permanecem ativas. A admissão continua limitada pelo orçamento de tokens, pelos limites de sequências e pelo espaço disponível no cache KV. O batching contínuo não garante ausência de espera em fila nem um resultado mais rápido para todas as solicitações.
O PagedAttention aborda uma parte diferente do problema: armazenar e gerenciar o cache KV de atenção em blocos. Ele ajuda o mecanismo a usar a memória de maneira mais flexível, enquanto o agendador decide quais solicitações recebem computação. Manter essas funções separadas ajuda a diagnosticar se a baixa taxa de transferência é causada pelo agendamento, pela pressão no cache KV, por prompts longos ou por um gargalo upstream. O design do PagedAttention do vLLM descreve o mecanismo de memória.
Os controles que moldam um lote
| Controle | O que ele limita | O que observar ao alterá-lo |
|---|---|---|
max_num_batched_tokens |
Tokens processados em uma iteração do agendador | Taxa de transferência, tempo até o primeiro token, latência entre tokens e progresso de prompts longos |
max_num_seqs |
Sequências processadas em uma iteração | Solicitações em execução, margem de memória e latência de cauda |
| Prefill em blocos | Divide um prefill longo entre etapas de agendamento | Latência de prompts longos e interferência com solicitações de decodificação |
| Limite de fila ou admissão | Solicitações que podem aguardar ou executar | Tempo na fila, taxa de rejeição e se a sobrecarga chega aos chamadores |
| Capacidade do cache KV | Contexto ativo que cabe na GPU | Preempção, recomputação e falhas de falta de memória |
Essas configurações interagem. Aumentar um orçamento de tokens pode melhorar a taxa de transferência para uma carga de trabalho e piorar a latência interativa para outra. Aumentar o número de sequências admitidas pode elevar a concorrência, mas também consumir mais cache KV. A versão, a arquitetura do modelo, os comprimentos de contexto e o hardware afetam o resultado. Leia a referência de configuração do agendador para entender o comportamento da versão instalada do vLLM e, em seguida, altere um controle por vez.
Quando o cache KV não consegue acomodar novo trabalho, o vLLM pode preemptar uma solicitação em execução e posteriormente recomputar seu progresso. Uma contagem crescente de preempções é um aviso de que simplesmente adicionar mais chegadas ao lote não é gratuito. A visão geral da arquitetura explica as regras de agendamento e preempção.
Um benchmark que corresponde ao tráfego de produção
Não compare configurações de batching contínuo com um único prompt curto enviado tão rapidamente quanto o cliente consegue enviá-lo. Crie três grupos de solicitações com base nos seus próprios logs ou em um rastreamento seguro para privacidade:
- Chats interativos curtos, com prompts e respostas breves.
- Solicitações de contexto longo, com prefills grandes e comprimentos de saída moderados.
- Solicitações de agente ou RAG com prefixos repetidos, comprimentos de saída variados, cancelamentos e picos.
Mantenha fixos entre as execuções a revisão do modelo, o tokenizador, o tipo de GPU, a versão do vLLM e o rastreamento de solicitações. Varra a taxa de solicitações oferecida desde abaixo da carga esperada até o ponto em que o tempo na fila ou os erros se tornem inaceitáveis. O guia oficial do vllm bench serve documenta os controles de taxa de solicitações e de conjunto de dados. Registre o comando exato, a configuração e a versão do rastreamento para que a comparação possa ser repetida.
Para cada execução, registre solicitações concluídas por segundo, tokens de saída por segundo, p50 e p95 do tempo até o primeiro token, latência p95 entre tokens, latência p95 de ponta a ponta, tempo na fila, falhas e a marca máxima de uso de memória da GPU. A referência de métricas de produção do vLLM inclui métricas para solicitações em execução e em espera, além de histogramas de tempo na fila, tempo até o primeiro token e preempções. Um quadro de avaliação útil é:
| Execução | Solicitações oferecidas/s | Solicitações concluídas/s | p95 do primeiro token | p95 da fila | p95 de ponta a ponta | Taxa de erros | Preempções |
|---|---|---|---|---|---|---|---|
| Linha de base | medido | medido | medido | medido | medido | medido | medido |
| Alteração no orçamento de tokens | medido | medido | medido | medido | medido | medido | medido |
| Alteração no limite de sequências | medido | medido | medido | medido | medido | medido | medido |
Preencha esta tabela com medições; não há um ganho percentual universal para copiar de outro modelo ou provedor. Escolha a configuração que atende às metas de latência e confiabilidade com o menor custo por resposta aceita, e não aquela com a maior vazão de tokens isoladamente.
Diagnostique um resultado decepcionante
Se o batching contínuo parecer ineficaz, procure a restrição antes de alterar outro parâmetro.
As solicitações em espera aumentam enquanto a memória da GPU permanece confortável. Verifique os limites de admissão, um limite pequeno de sequências, a tokenização na CPU e a concorrência no lado do cliente. Um agendador não consegue preencher uma GPU com solicitações que nunca chegam até ela.
O tempo até o primeiro token aumenta em prompts longos. Separe o tráfego intensivo em prefill do tráfego intensivo em decodificação no benchmark. Revise o prefill em blocos e as configurações de orçamento de tokens, e compare a distribuição de prompts longos, em vez de apenas a média.
A vazão melhora, mas a latência p95 piora. O servidor pode estar aceitando mais trabalho simultâneo do que a meta do seu serviço interativo permite. Limite a admissão, use um tempo limite de fila ou um pool de serviço separado e teste novamente com a mesma carga oferecida.
Preempções ou eventos de falta de memória aumentam. Os contextos ativos podem não caber no cache KV da GPU. Reduza os limites de concorrência ou de contexto, selecione uma GPU com memória suficiente ou reveja as escolhas de modelo e precisão. Evite tratar uma solicitação preemptada como um evento de agendamento sem custo.
A utilização da GPU é baixa mesmo quando há solicitações em espera. Inspecione CPU, rede, armazenamento, carregamento do modelo e cadenciamento do cliente antes de atribuir o gargalo ao batching contínuo. Nosso guia de implantação do vLLM aborda o runbook mais amplo de serving; este artigo se concentra no comportamento do agendador e na medição.
Onde a escolha da GPU entra na decisão
O batching contínuo pode melhorar o uso que você faz de uma GPU, mas não pode fazer um modelo caber em uma memória que ela não possui. Estime os pesos, o cache KV na concorrência e no comprimento de contexto esperados, a sobrecarga de runtime e uma margem de segurança. Em seguida, faça benchmarks na configuração de GPU que você pretende alugar. Uma GPU de 80 GB e uma GPU com mais memória podem produzir comportamentos diferentes de admissão e preempção para o mesmo modelo e rastreamento de solicitações.
O GPU Compute da Flatkey lista opções de aluguel, incluindo H100 SXM, H200, B200, B300, A100 80GB e RTX 5090. A configuração, a região, a disponibilidade e o preço devem ser confirmados para o aluguel selecionado. Leve um rastreamento de benchmark, a latência-alvo, a revisão do modelo e a estimativa de memória ao comparar opções. Isso faz com que a discussão sobre capacidade seja sobre trabalho concluído, e não sobre uma especificação de GPU em destaque.
Checklist prático de decisão
Antes de adotar uma configuração de batching contínuo do vLLM, responda a estas perguntas:
- O principal cenário de tráfego atende às metas de latência p95 do primeiro token e de ponta a ponta?
- O que acontece em um pico acima da taxa normal de solicitações: fila limitada, rejeição ou um grande pico de latência?
- As preempções e a pressão no cache KV permanecem estáveis no comprimento de contexto pretendido?
- O resultado é reproduzível na revisão exata do modelo e na configuração de GPU que você planeja executar?
- O custo por resposta aceita supera a alternativa após considerar novas tentativas e capacidade ociosa?
Perguntas frequentes
O batching contínuo do vLLM significa que toda solicitação é executada imediatamente?
Não. Uma nova chegada pode ser considerada em uma etapa de agendamento, mas ainda pode esperar por orçamento de tokens, um slot de sequência ou capacidade do cache KV. Observe os indicadores de execução e espera juntamente com histogramas de tempo de fila antes de prometer uma meta de latência interativa.
O batching contínuo do vLLM é o mesmo que prefill em blocos?
Não. O batching contínuo descreve como as solicitações entram e saem do trabalho agendado ao longo do tempo. O prefill em blocos divide o trabalho de prefill de um prompt longo para que ele possa compartilhar o orçamento de tokens entre etapas. Eles trabalham juntos no agendador atual, mas ajustar um parâmetro não substitui medir o outro.
Devo maximizar o tamanho do batch?
Não automaticamente. Um batch maior pode melhorar a vazão enquanto aumenta o tempo de fila, o tempo até o primeiro token ou a pressão de preempção. Execute o mesmo rastreamento com a mesma carga oferecida e compare toda a meta de serviço, incluindo falhas e custo por resposta aceita.
O batching contínuo do vLLM é um método de agendamento, não um resultado de benchmark. A configuração mais robusta é aquela cuja vazão, latência, comportamento de memória e modo de falha você consegue explicar com suas próprias medições.