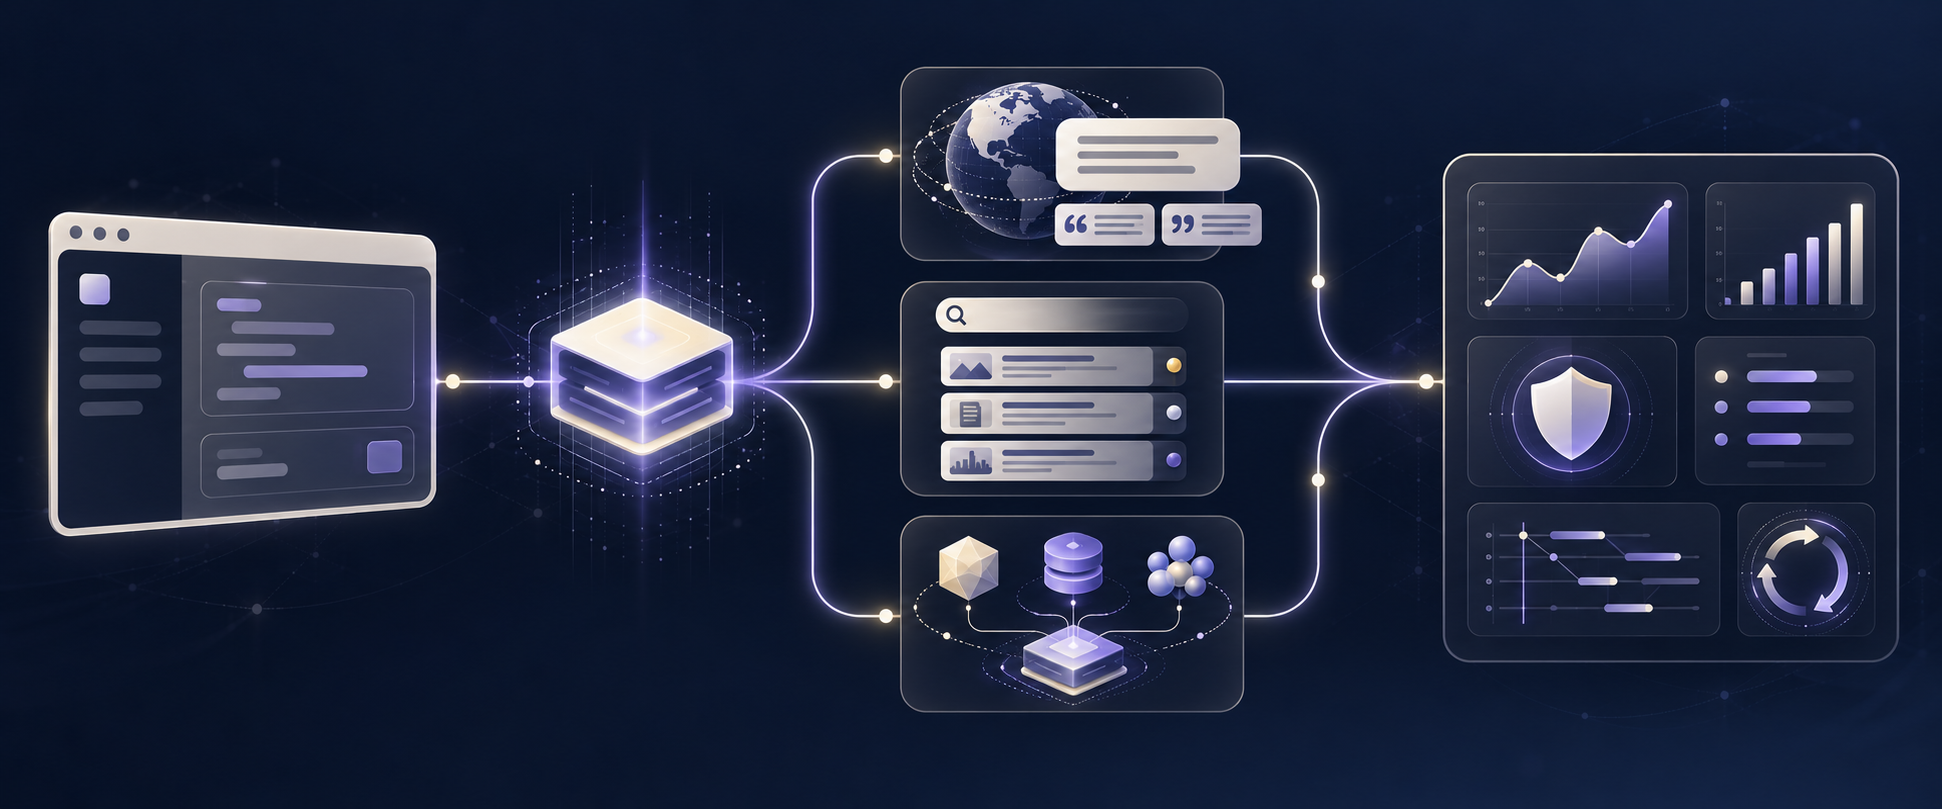
Batching berkelanjutan memungkinkan server vLLM menerima permintaan baru saat permintaan lain masih menghasilkan token. Batch tetap menunggu semua anggotanya selesai sebelum dapat membentuk batch berikutnya; batching berkelanjutan meninjau kembali set aktif pada setiap langkah penjadwalan. Perbedaan ini penting ketika prompt dan output memiliki panjang yang berbeda. Permintaan singkat dapat bergabung dengan pekerjaan GPU tanpa menunggu respons terpanjang dalam kelompok sebelumnya.
Bagi tim inferensi, pertanyaan yang berguna bukanlah apakah batching berkelanjutan diaktifkan dalam daftar fitur. Pertanyaannya adalah apakah campuran permintaan Anda yang sebenarnya meningkatkan jumlah respons yang selesai per detik tanpa mendorong waktu hingga token pertama, waktu antrean, atau tingkat kesalahan melampaui target layanan Anda. Panduan ini menjelaskan mekanismenya, batasan yang penting, dan benchmark yang dapat Anda jalankan sebelum memilih kapasitas GPU.
Cara kerja batching berkelanjutan vLLM
Dalam arsitektur V1 vLLM saat ini, scheduler mengisi anggaran token pada setiap langkah dari permintaan yang berjalan dan menunggu. Sebuah permintaan melacak berapa banyak token yang telah dihitung; scheduler menetapkan pekerjaan untuk menutup kesenjangan tersebut. Loop yang sama menangani prefill terpotong, caching prefiks, dan decoding spekulatif. Ini merupakan model mental yang lebih akurat daripada diagram satu batch statis yang berjalan hingga selesai. Lihat ikhtisar arsitektur vLLM untuk deskripsi scheduler.
Bayangkan tiga permintaan masuk: respons chat singkat, prompt dokumen panjang, dan chat singkat lainnya. Dengan batch tetap, chat singkat kedua mungkin menunggu batas batch permintaan panjang tersebut. Dengan batching berkelanjutan, permintaan itu dapat dipertimbangkan pada langkah penjadwalan berikutnya sementara permintaan pertama tetap aktif. Penerimaan tetap dibatasi oleh anggaran token, batas sekuens, dan ruang KV-cache yang tersedia. Batching berkelanjutan tidak menjamin antrean nol atau hasil yang lebih cepat untuk setiap permintaan.
PagedAttention menangani bagian masalah yang berbeda: menyimpan dan mengelola cache KV perhatian dalam blok. Ini membantu engine menggunakan memori secara lebih fleksibel, sementara scheduler memutuskan permintaan mana yang menerima komputasi. Memisahkan peran tersebut membantu Anda mendiagnosis apakah throughput rendah disebabkan oleh penjadwalan, tekanan KV-cache, prompt panjang, atau hambatan upstream. desain PagedAttention vLLM menjelaskan mekanisme memorinya.
Kontrol yang membentuk sebuah batch
| Kontrol | Apa yang dibatasi | Hal yang perlu diperhatikan saat mengubahnya |
|---|---|---|
max_num_batched_tokens |
Token yang diproses dalam satu iterasi scheduler | Throughput, waktu hingga token pertama, latensi antar-token, dan kemajuan prompt panjang |
max_num_seqs |
Sekuens yang diproses dalam satu iterasi | Permintaan yang berjalan, ruang sisa memori, dan latensi ekor |
| Prefill terpotong | Membagi prefill panjang ke beberapa langkah penjadwalan | Latensi prompt panjang dan interferensi dengan permintaan decoding |
| Batas antrean atau penerimaan | Permintaan yang diizinkan untuk menunggu atau berjalan | Waktu antrean, tingkat penolakan, dan apakah beban berlebih mencapai pemanggil |
| Kapasitas KV-cache | Konteks aktif yang muat pada GPU | Preemption, komputasi ulang, dan kegagalan kehabisan memori |
Pengaturan ini saling berinteraksi. Menaikkan anggaran token dapat meningkatkan throughput untuk satu beban kerja dan memperburuk latensi interaktif untuk beban kerja lain. Meningkatkan jumlah sekuens yang diterima dapat menaikkan konkurensi, tetapi juga mengonsumsi lebih banyak KV cache. Versi, arsitektur model, panjang konteks, dan perangkat keras semuanya memengaruhi hasil. Baca referensi konfigurasi scheduler untuk perilaku rilis vLLM yang Anda instal, lalu ubah satu kontrol pada satu waktu.
Ketika KV cache tidak dapat menampung pekerjaan baru, vLLM dapat melakukan preempt pada permintaan yang sedang berjalan dan kemudian menghitung ulang progresnya. Jumlah preemption yang meningkat merupakan peringatan bahwa sekadar menambahkan lebih banyak permintaan masuk ke batch tidaklah gratis. ikhtisar arsitektur menjelaskan aturan penjadwalan dan preemption.
Benchmark yang sesuai dengan traffic produksi
Jangan membandingkan pengaturan batching berkelanjutan dengan satu prompt singkat yang dikirim secepat yang dapat dilakukan klien. Buat tiga kelompok permintaan dari log Anda sendiri atau trace yang aman terhadap privasi:
- Chat interaktif singkat dengan prompt dan respons ringkas.
- Permintaan konteks panjang dengan prefill besar dan panjang output sedang.
- Permintaan agent atau RAG dengan prefiks berulang, panjang output bervariasi, pembatalan, dan lonjakan.
Pertahankan revisi model, tokenizer, jenis GPU, versi vLLM, dan
trace permintaan tetap sama di antara setiap pengujian. Variasikan laju permintaan yang ditawarkan dari di bawah
beban yang diharapkan hingga titik ketika waktu antrean atau kesalahan menjadi
tidak dapat diterima. Panduan resmi vllm bench serve
mendokumentasikan kontrol laju permintaan dan dataset. Catat perintah,
konfigurasi, dan versi trace secara persis agar perbandingan dapat
diulangi.
Untuk setiap pengujian, catat permintaan selesai per detik, token output per detik, p50 dan p95 waktu hingga token pertama, latensi antar-token p95, latensi end-to-end p95, waktu antrean, kegagalan, dan tanda air tertinggi memori GPU. Referensi metrik produksi vLLM mencakup gauge untuk permintaan yang berjalan dan menunggu serta histogram untuk waktu antrean, waktu hingga token pertama, dan preemption. Sebuah scorecard yang berguna adalah:
| Pengujian | Permintaan yang ditawarkan/dtk | Permintaan yang selesai/dtk | Token pertama p95 | Antrean p95 | Ujung ke ujung p95 | Tingkat kesalahan | Preemption |
|---|---|---|---|---|---|---|---|
| Baseline | diukur | diukur | diukur | diukur | diukur | diukur | diukur |
| Perubahan anggaran token | diukur | diukur | diukur | diukur | diukur | diukur | diukur |
| Perubahan batas urutan | diukur | diukur | diukur | diukur | diukur | diukur | diukur |
Isi tabel ini dengan pengukuran; tidak ada persentase peningkatan universal yang dapat disalin dari model atau penyedia lain. Pilih konfigurasi yang memenuhi target latensi dan keandalan dengan biaya terendah per respons yang diterima, bukan konfigurasi dengan throughput token tertinggi secara terpisah.
Diagnosis hasil yang mengecewakan
Jika batching berkelanjutan tampak tidak efektif, cari kendalanya sebelum mengubah flag lain.
Permintaan yang menunggu meningkat sementara memori GPU masih cukup nyaman. Periksa batas penerimaan, batas urutan yang kecil, tokenisasi CPU, dan konkurensi sisi klien. Scheduler tidak dapat mengisi GPU dengan permintaan yang tidak pernah mencapainya.
Waktu hingga token pertama meningkat pada prompt panjang. Pisahkan trafik yang berat pada prefill dari trafik yang berat pada decode dalam benchmark. Tinjau prefill terpotong dan pengaturan anggaran token, lalu bandingkan distribusi prompt panjang, bukan hanya rata-ratanya.
Throughput meningkat tetapi latensi p95 memburuk. Server mungkin menerima lebih banyak pekerjaan konkuren daripada yang diizinkan oleh target layanan interaktif Anda. Batasi penerimaan, gunakan batas waktu antrean atau pool penyajian terpisah, lalu uji kembali pada beban yang ditawarkan sama.
Preemption atau kejadian kehabisan memori meningkat. Konteks aktif mungkin tidak muat dalam cache KV GPU. Kurangi batas konkurensi atau konteks, pilih GPU dengan memori yang memadai, atau tinjau kembali pilihan model dan presisi. Hindari memperlakukan permintaan yang dipreempt sebagai kejadian penjadwalan gratis.
Pemanfaatan GPU rendah bahkan saat permintaan menunggu. Periksa CPU, jaringan, penyimpanan, pemuatan model, dan laju klien sebelum mengatribusikan bottleneck kepada batching berkelanjutan. panduan deployment vLLM kami mencakup runbook penyajian yang lebih luas; artikel ini berfokus pada perilaku scheduler dan pengukuran.
Peran pilihan GPU dalam pengambilan keputusan
Batching berkelanjutan dapat meningkatkan cara Anda menggunakan GPU, tetapi tidak dapat membuat model muat di memori yang tidak dimilikinya. Estimasikan bobot, cache KV pada konkurensi dan panjang konteks yang diharapkan, overhead runtime, serta margin keamanan. Kemudian lakukan benchmark pada konfigurasi GPU yang ingin Anda sewa. GPU 80 GB dan GPU dengan memori lebih besar dapat menghasilkan perilaku penerimaan dan preemption yang berbeda untuk model dan jejak permintaan yang sama.
GPU Compute Flatkey mencantumkan opsi sewa termasuk H100 SXM, H200, B200, B300, A100 80GB, dan RTX 5090. Konfigurasi, wilayah, ketersediaan, dan harga harus dikonfirmasi untuk sewa yang dipilih. Bawalah jejak benchmark, latensi target, revisi model, dan estimasi memori saat membandingkan opsi. Dengan demikian, diskusi kapasitas berfokus pada pekerjaan yang selesai alih-alih spesifikasi GPU utama.
Daftar periksa keputusan praktis
Sebelum menetapkan konfigurasi batching berkelanjutan vLLM, jawablah pertanyaan-pertanyaan berikut:
- Apakah skenario trafik tertinggi memenuhi target latensi token pertama dan ujung ke ujung p95?
- Apa yang terjadi pada lonjakan di atas laju permintaan normal: antrean terbatas, penolakan, atau lonjakan latensi besar?
- Apakah preemption dan tekanan cache KV stabil pada panjang konteks yang dituju?
- Apakah hasilnya dapat diulang pada revisi model dan bentuk GPU yang tepat yang Anda rencanakan untuk dijalankan?
- Apakah biaya per respons yang diterima lebih baik daripada alternatif setelah percobaan ulang dan kapasitas menganggur diperhitungkan?
Pertanyaan yang sering diajukan
Apakah batching berkelanjutan vLLM berarti setiap permintaan langsung dijalankan?
Tidak. Permintaan baru dapat dipertimbangkan pada langkah penjadwalan, tetapi masih dapat menunggu anggaran token, slot urutan, atau kapasitas cache KV. Pantau metrik yang berjalan dan menunggu bersama histogram waktu antrean sebelum menjanjikan target latensi interaktif.
Apakah batching berkelanjutan vLLM sama dengan prefill terpotong?
Tidak. Batching berkelanjutan menjelaskan cara permintaan bergabung dan keluar dari pekerjaan terjadwal seiring waktu. Prefill terpotong membagi pekerjaan prefill prompt panjang agar dapat berbagi anggaran token di seluruh langkah. Keduanya bekerja bersama dalam scheduler saat ini, tetapi mengubah satu tombol penyetelan tidak dapat menggantikan pengukuran yang lain.
Haruskah saya memaksimalkan ukuran batch?
Tidak secara otomatis. Batch yang lebih besar dapat meningkatkan throughput sambil meningkatkan waktu antrean, waktu hingga token pertama, atau tekanan preemption. Jalankan jejak yang sama pada beban yang ditawarkan sama dan bandingkan keseluruhan target layanan, termasuk kegagalan dan biaya per respons yang diterima.
Batching berkelanjutan vLLM adalah metode penjadwalan, bukan hasil benchmark. Pengaturan terbaik adalah yang throughput, latensi, perilaku memori, dan mode kegagalannya dapat Anda jelaskan dengan pengukuran Anda sendiri.