
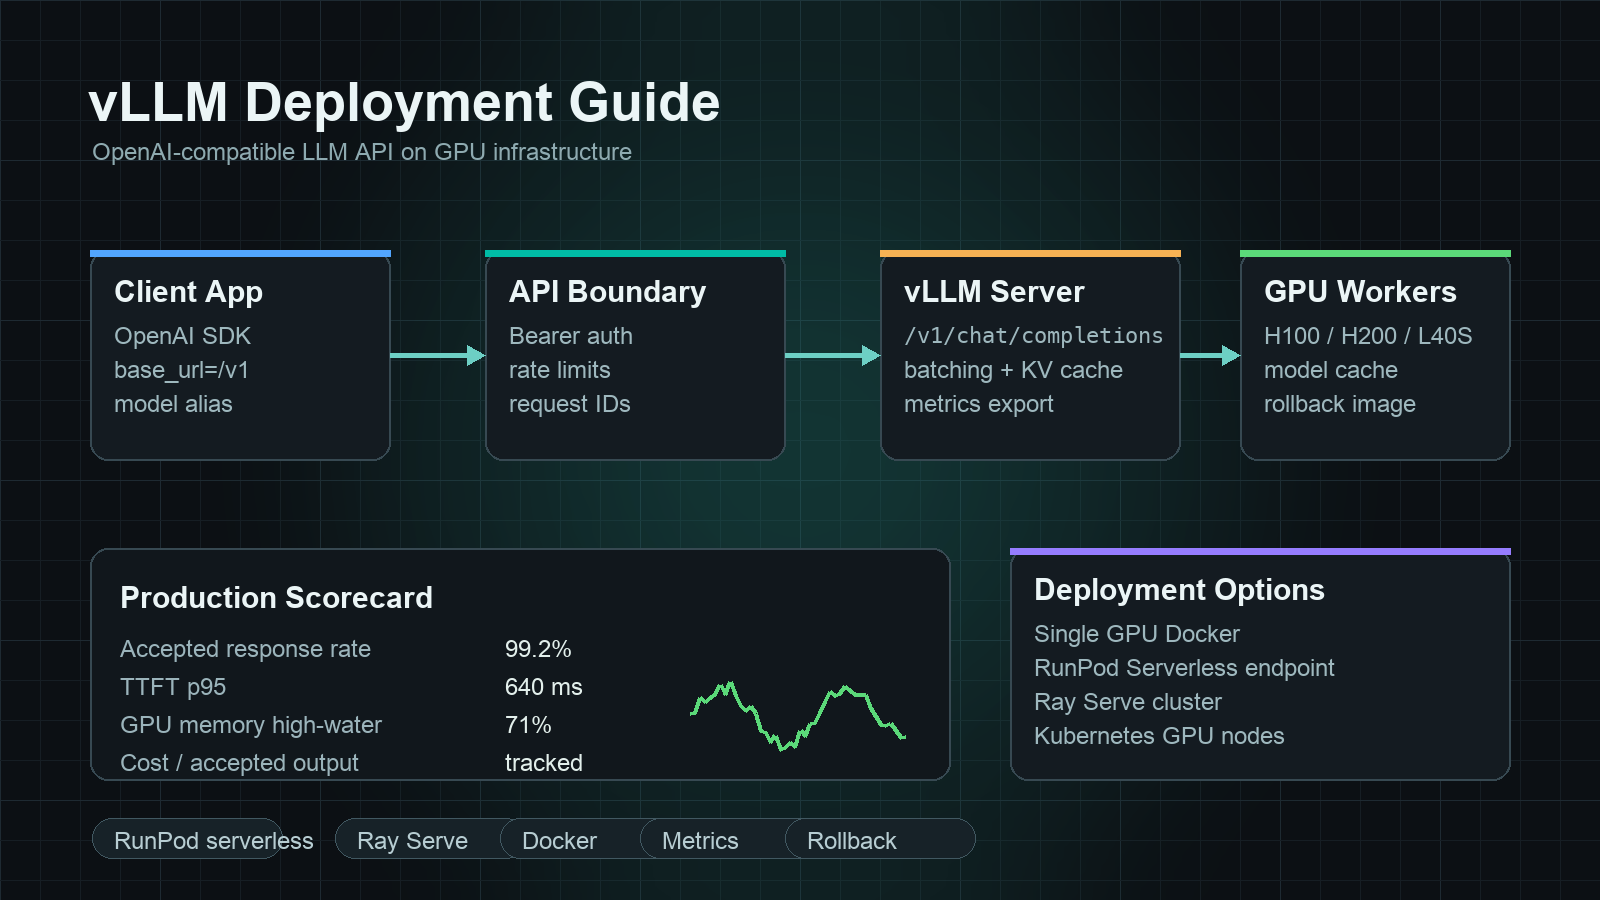
Um guia de implantação do vLLM deve responder a uma pergunta prática: como transformar capacidade de GPU em uma API de LLM compatível com a OpenAI que as equipes de aplicação possam chamar, observar, reverter e comparar com APIs de modelos gerenciados?
A resposta curta é começar com um modelo, um formato de GPU, uma rota compatível com a OpenAI e um plano de medição. O vLLM pode expor os familiares endpoints estilo OpenAI /v1/models, /v1/chat/completions e outros relacionados, mas uma implantação de produção vai além do primeiro comando vllm serve. Você precisa de uma imagem de contêiner, cache de modelo, limite de autenticação, verificações de saúde, métricas, limites de requisição, um teste de carga e um painel de custo por saída aceita.
Este guia de implantação do vLLM oferece a desenvolvedores de IA e equipes de plataforma um caminho de implantação desde um único servidor GPU até RunPod Serverless, Ray Serve e padrões de produção no estilo Kubernetes. Ele também explica quando uma API de modelo ou um roteador como o Flatkey pode ser mais simples do que assumir a camada de serving da GPU.
Guia rápido de implantação do vLLM
Use esta sequência antes de adicionar complexidade de orquestração.
| Etapa | Decisão | Configuração padrão prática |
|---|---|---|
| 1. Escolha o modelo | Escolha um modelo suportado e a revisão exata | Comece com o menor modelo que comprove o contrato da API e depois aumente |
| 2. Escolha a GPU | Confirme o ajuste de memória antes de otimizar a taxa de transferência | Use a mesma classe de GPU em testes e produção |
| 3. Inicie o vLLM | Exponha uma API compatível com a OpenAI | Use vllm serve primeiro e depois coloque em contêiner |
| 4. Trave os limites de requisição | Delimite o comprimento do contexto, a concorrência e o tamanho da saída | Proteja a GPU contra prompts sem limite |
| 5. Adicione autenticação e controles de rede | Não exponha diretamente um worker de GPU bruto | Coloque um gateway, ingress ou endpoint privado na frente |
| 6. Meça a saída aceita | Acompanhe respostas bem-sucedidas, latência, tentativas e custo | Compare com o custo por saída aceita da API de modelo |
| 7. Adicione mecânicas de lançamento | Canary, rollback e aliases de modelo versionados | Mantenha o código do cliente estável enquanto o serving muda |
O objetivo não é tornar todas as cargas de trabalho auto-hospedadas. O objetivo é saber quando o vLLM auto-hospedado vale a superfície operacional.
O que o vLLM oferece
O vLLM é um mecanismo de inferência e serving de código aberto para grandes modelos de linguagem. Sua documentação cobre serving compatível com a OpenAI, implantação com Docker, métricas, prefix caching, quantização, speculative decoding, paralelismo e arquiteturas de modelos suportadas. Esses elementos fazem do vLLM uma escolha padrão forte quando você quer servir modelos de pesos abertos por trás de um contrato de API familiar.
A propriedade útil em produção é a fronteira da API. Se sua aplicação já chama um cliente compatível com a OpenAI, um endpoint do vLLM pode reduzir o trabalho de reescrita da aplicação. A camada de serving pode mudar, os pesos do modelo podem mudar e o host da GPU pode ser movido, enquanto o código do cliente ainda envia requisições de conclusão de chat para uma única URL base.
Isso não elimina o trabalho de plataforma. Ele desloca o trabalho difícil da integração da aplicação para as operações de inferência: alocação de GPU, carregamento de modelo, batching, observabilidade, limites de taxa, resposta a incidentes e gestão de custos.
Implantação do vLLM em uma única GPU
Comece localmente ou em uma única GPU na nuvem antes de adicionar serverless, Ray ou Kubernetes.
pip install vllm

vllm serve meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Depois, teste o endpoint compatível com a OpenAI.
curl http://localhost:8000/v1/models
Use uma requisição de chat que se pareça com a requisição que sua aplicação realmente enviará.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "meta-llama/Llama-3.1-8B-Instruct",
    "messages": [
      {"role": "user", "content": "Escreva uma lista de verificação de implantação com três tópicos."}
    ],
    "temperature": 0.2,
    "max_tokens": 300
  }'
Essa primeira implantação não é produção. Ela responde a quatro perguntas:
- O modelo carrega na GPU selecionada?
- Seu cliente entende a forma da resposta?
- Streaming, chamada de ferramentas ou saída estruturada funcionam para sua requisição específica?
- Quais são os números aproximados de time-to-first-token e de latência ponta a ponta?
Mantenha o primeiro teste simples. Não ajuste batching, quantização ou paralelismo até que o endpoint base funcione.
Implantação com Docker para um servidor GPU repetível
Para um servidor repetível, use o caminho oficial do Docker do vLLM ou uma imagem de contêiner fixada no seu próprio registro. Os controles importantes de produção não são apenas a tag da imagem. Eles também incluem a pilha de driver, compatibilidade com CUDA, cache do modelo, montagem de volume, porta de rede e flags do processo.
Forma de exemplo:
docker run --gpus all \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --env HUGGING_FACE_HUB_TOKEN=$HUGGING_FACE_HUB_TOKEN \
  vllm/vllm-openai:latest \
  --model meta-llama/Llama-3.1-8B-Instruct \
  --host 0.0.0.0 \
  --port 8000
Antes de usar este padrão em produção, fixe as versões:
- Tag da imagem do vLLM.
- Driver NVIDIA e runtime de contêiner.
- Pilha CUDA, se gerenciada separadamente.
- Revisão do modelo ou hash de commit.
- Comportamento do tokenizer e do chat template.
- Modo de quantização, se usado.
Um guia de implantação do vLLM está incompleto se apenas disser “execute o Docker”. O runbook também precisa de comportamento de reinicialização, logging, aquecimento do cache do modelo, probes de prontidão e um caminho de rollback para a imagem e a revisão do modelo anteriores.
Torne o endpoint compatível com a OpenAI, mas não sem autenticação
O vLLM pode falar uma API compatível com a OpenAI, mas o seu worker bruto do vLLM normalmente não deve ser a fronteira da internet pública. Coloque algo na frente dele:
- Um endpoint privado de VPC para serviços internos.
- Um gateway de API com validação de token bearer.
- Uma malha de serviços ou controlador de ingress com mTLS.
- Um proxy leve na camada da aplicação que imponha aliases de modelo, IDs de requisição e orçamentos por equipe.
- Uma camada de roteamento quando você precisar de fallback para APIs de modelos gerenciadas.
Use base URLs específicas por ambiente:
VLLM_BASE_URL_DEV=http://localhost:8000/v1
VLLM_BASE_URL_STAGING=https://staging-inference.example.com/v1
VLLM_BASE_URL_PROD=https://inference.example.com/v1
Depois, mantenha o cliente da aplicação reversível:
from openai import OpenAI

client = OpenAI(
    api_key="not-used-by-raw-vllm",
    base_url="https://inference.example.com/v1",
)

response = client.chat.completions.create(
    model="llama-3-1-8b-instruct",
    messages=[{"role": "user", "content": "Resuma o plano de implantação."}],
)
Se mais tarde você rotear algumas requisições para a camada de API de modelos compatível com a OpenAI da Flatkey, o mesmo padrão de cliente continua útil: altere a base URL, a chave de API e o alias do modelo, mantendo estável o contrato da aplicação.
Configurações de produção a decidir antes do tráfego
As flags de implantação dependem do modelo, da GPU e da carga de trabalho, mas toda equipe deve decidir estes controles antes do tráfego de produção:
| Controle | Por que importa |
|---|---|
| Comprimento máximo do modelo | Evita que alguns prompts longos consumam toda a memória do KV-cache |
| Número máximo de tokens de saída | Impedem que gerações descontroladas ocupem a capacidade de decode |
| Limite de concorrência | Protege a latência p95 e p99 sob tráfego em rajadas |
| Timeout da requisição | Impede que requisições travadas escondam a sobrecarga |
| Política de fila | Decide se a demanda excedente espera, falha rapidamente ou faz fallback |
| Alias do modelo | Permite que os clientes usem um nome estável enquanto a revisão servida muda |
| Fronteira de autenticação | Evita que um endpoint caro de GPU se torne um proxy aberto |
| Política de logging | Equilibra depuração com retenção de dados e requisitos de privacidade |
| Exportação de métricas | Torna latência, erros, comportamento de cache e throughput observáveis |
Não copie as flags de outra equipe. Copie o método de medição dela.
Métricas para implantações de produção do vLLM
Acompanhe métricas em três camadas.
| Camada | Métricas a acompanhar |
|---|---|
| Camada da API | Contagem de requisições, taxa de respostas aceitas, taxa de 4xx/5xx, taxa de timeout, taxa de retry |
| Camada de serving | Tempo até o primeiro token, latência entre tokens, latência ponta a ponta, espera na fila, tokens por segundo |
| Camada da GPU | Utilização da GPU, utilização de memória, eventos de OOM, tempo de carregamento do modelo, contagem de reinicializações |
Depois, adicione a métrica financeira:
custo por saída aceita =
  (aluguel da GPU + armazenamento + largura de banda + retries + tempo do operador)
  / respostas aceitas que passam pelas verificações de qualidade
Isso mantém o guia de implantação do vLLM ligado à economia de produção. Um endpoint mais rápido não é mais barato se falha com mais frequência, exige mais intervenção manual ou fica ocioso durante a maior parte do dia.
Para um contexto de custo mais amplo, compare o seu endpoint medido com preços de aluguel de GPU, melhor GPU para inferência de LLM, cloud de GPU vs API de modelo e TCO de cluster de GPU.
Guia de implantação vLLM serverless da RunPod
Um guia de implantação vLLM serverless da RunPod tem um modelo operacional diferente de uma VM de GPU de longa duração. Você empacota um handler ou container, define o endpoint serverless e deixa a plataforma escalar workers em torno das requisições. Isso pode ser útil quando o tráfego é irregular ou quando você quer uma superfície de execução de GPU gerenciada sem assumir todos os detalhes do ciclo de vida da VM.
Use a RunPod Serverless quando:
- Você quer execução de GPU no estilo endpoint sem gerenciar hosts persistentes.
- O tráfego é em rajadas, de forma que a capacidade de GPU sempre ativa ficaria ociosa.
- O comportamento de cold start e de carregamento do modelo é aceitável para a carga de trabalho.
- Sua aplicação consegue tolerar o padrão de requisições assíncrono ou específico de endpoint da plataforma.
- Você pode testar comportamento de concorrência, enfileiramento e timeout antes do lançamento.
Tenha cuidado ao usar serverless para chat sensível à latência. Modelos grandes podem ter cold start e tempo de carregamento relevantes. Meça a latência do primeiro token após períodos de inatividade, não apenas durante um benchmark com aquecimento.
Para um guia de implantação vLLM de endpoint serverless da RunPod, seu teste de aceitação deve incluir:
| Verificação | Por que isso importa |
|---|---|
| Tempo de carregamento da imagem do contêiner | Imagens grandes podem dominar os cold starts |
| Download dos pesos do modelo ou montagem de volume | Downloads repetidos podem anular as economias do serverless |
| Número máximo de workers | Impede gastos inesperados durante picos |
| Timeout da fila | Define o comportamento de falha visível ao usuário |
| Política de workers aquecidos | Altera a latência e o custo ocioso |
| Formato da requisição e da resposta | Confirma que clientes compatíveis com a OpenAI podem ser adaptados corretamente |
Se sua consulta exata for runpod serverless endpoints vllm deployment guide, trate "endpoints" como um tópico de operações: construa o endpoint, mas também teste cold starts, escalonamento de workers, limites de requisição e rollback.
Guia de implantação do Ray Serve vLLM
Um guia de implantação do Ray Serve vLLM é útil quando a implantação já não é apenas um modelo em um worker. O Ray Serve pode ajudar equipes a construir uma aplicação de serving que compõe implantações, escala réplicas e executa em um cluster Ray. Isso é valioso quando você precisa de lógica de serving em Python em torno do modelo, roteamento personalizado, aplicações multimodelo ou um cluster que já padroniza em Ray.
Use o Ray Serve quando:
- Você já executa Ray para a infraestrutura de ML.
- Você precisa de várias implantações em um único grafo de serving.
- Você quer roteamento no nível da aplicação em torno de um ou mais engines vLLM.
- Você precisa de um caminho do teste local até um cluster Ray.
- Sua equipe de plataforma pode operar Ray, não apenas vLLM.
A compensação é a superfície operacional. O Ray oferece poder de orquestração, mas também adiciona operações de cluster Ray, comportamento de autoscaling, considerações sobre object store, logs, dashboards e outro caminho de atualização. Para um único modelo atrás de um endpoint, uma implantação direta do vLLM pode ser mais simples.
Padrão de implantação no Kubernetes
O Kubernetes é uma boa opção quando sua organização já opera nós de GPU, ingress, secrets, métricas e políticas de rollout no Kubernetes. Ele não é automaticamente a primeira implantação certa para uma equipe pequena.
Checklist do Kubernetes:
| Área | Checklist |
|---|---|
| Agendamento de GPU | Rótulos de nós, taints, solicitações de recursos, device plugin e isolamento de GPU |
| Armazenamento do modelo | Volume persistente, sincronização com object store ou estratégia de imagem incorporada |
| Inicialização | Aquecimento do cache do modelo e probe de readiness realista |
| Saúde | Probe de liveness que não encerra carregamentos lentos, mas saudáveis, do modelo |
| Rollout | Implantação canary ou blue-green com rollback rápido |
| Autoscaling | Escalar com base em fila, latência ou métricas de GPU, não apenas na CPU |
| Rede | Apenas interno por padrão; ingress público somente por meio de controles de autenticação |
| Observabilidade | Latência por rota, taxa de erro, memória de GPU e atribuição de custo |
Se sua plataforma ainda não tiver maturidade em Kubernetes com GPU, comece com um host com GPU ou com um endpoint gerenciado primeiro. O Kubernetes deve reduzir o risco operacional, não transformar um endpoint simples em um projeto de cluster.
Plano de teste de carga para uma implantação do vLLM
Não teste carga com um único prompt. Crie um conjunto de requisições representativo.
Use pelo menos três traces:
- Chat curto: prompt curto, saída curta, alta concorrência.
- RAG de contexto longo: prompt longo, saída média, template de sistema e de recuperação repetido.
- Loop de agente ou ferramenta: esquema repetido, saída estruturada, cancelamento, retries e contexto com múltiplas interações.
Registre:
| Métrica | Meta |
|---|---|
| Requisições aceitas por minuto | Mede o throughput útil |
| Tempo até o primeiro token p50/p95/p99 | Mostra a latência interativa |
| Latência fim a fim p50/p95/p99 | Mostra o tempo da tarefa visível ao usuário |
| Taxa de erro e timeout | Mostra a confiabilidade sob carga |
| Latência ajustada por retries | Mostra a experiência real após falhas |
| Marca de alto consumo de memória da GPU | Mostra a folga |
| Custo por saída aceita | Mostra a economia |
Execute dois benchmarks:
- Execução padrão: ajuste mínimo, para que você saiba o tempo até produção.
- Execução ajustada: batching, cache, quantização e limites de requisição ajustados, para que você saiba o teto.
Se a execução ajustada for mais rápida, mas frágil, não a implante como padrão. Implante a configuração que sua equipe de plantão consiga explicar.
Quando não implantar o vLLM por conta própria
Hospedar por conta própria é valioso quando você precisa de controle de hardware, pesos personalizados, forte localidade de dados ou alta utilização sustentada em uma carga de trabalho estável. É menos atraente quando o tráfego é incerto, a escolha do modelo muda com frequência, modelos proprietários de fronteira são necessários ou a equipe não tem capacidade de operações de inferência.
Escolha primeiro uma API de modelo gerenciada ou um roteador quando:
- Você ainda está testando a qualidade do modelo.
- Você precisa trocar modelos com frequência.
- O tráfego é irregular ou difícil de prever.
- Fallback entre provedores importa mais do que controle de GPU.
- Você precisa de um livro-razão de uso, orçamentos, faturas e governança da equipe antes do ajuste de GPU.
A Flatkey se encaixa nessa camada quando cargas de trabalho do lado da API precisam de uma chave, um saldo, uma fatura, registros de uso e acesso a rotas oficiais de modelos. Se, mais tarde, uma carga de trabalho se mostrar estável o suficiente para servir em GPUs dedicadas, continue comparando o endpoint self-hosted do vLLM com a comparação de preços de modelos de IA, a comparação de preços de APIs de IA e seu custo medido de GPU por saída aceita.
Modelo de runbook de implantação
Copie isto antes do lançamento.
Serviço:
  Responsável:
  Plantão:
  Alias do modelo:
  Revisão do modelo servido:
  Versão do vLLM:
  Imagem do contêiner:
  Tipo e quantidade de GPU:
  URL base:

Política de requisições:
  Comprimento máximo do modelo:
  Máximo de tokens de saída:
  Concurrency máxima:
  Timeout da fila:
  Timeout da requisição:
  Método de autenticação:

Observabilidade:
  Painel de métricas:
  Local dos logs:
  Campo de trace/ID da requisição:
  Limiares de alerta:

Rollout:
  Percentual de canary:
  Imagem de rollback:
  Revisão do modelo para rollback:
  Rota de fallback:

Custo:
  Fonte do custo de GPU:
  Premissas de armazenamento/largura de banda:
  Denominador de saída aceita:
  Responsável pela revisão semanal de custo:
Este modelo importa mais do que um primeiro comando perfeito. Um guia de implantação do vLLM que não possa ser entregue ao plantão ainda é um protótipo.
Perguntas frequentes
Ainda é conteúdo de guia de implantação do vLLM se eu usar um endpoint de GPU gerenciado?
Sim. Se o vLLM é o mecanismo de serving e você está decidindo como expô-lo, escalá-lo, observá-lo e protegê-lo, ele ainda pertence a um guia de implantação do vLLM. Os detalhes operacionais diferem entre uma VM bruta, RunPod Serverless, Ray Serve e Kubernetes, mas os testes de aceitação são semelhantes: contrato do endpoint, latência, erros, concurrency, rollback e custo da saída aceita.
Devo usar RunPod Serverless ou uma VM de GPU persistente para o vLLM?
Use RunPod Serverless quando o tratamento de picos e as operações de endpoint gerenciado importarem mais do que a latência sempre aquecida. Use uma VM de GPU persistente quando você precisar de desempenho aquecido previsível, controle direto do host ou um caminho de depuração mais simples. Faça benchmark de ambos se latência e utilização estiverem impulsionando a decisão.
Quando o Ray Serve faz sentido com o vLLM?
O Ray Serve faz sentido quando o vLLM faz parte de uma aplicação de serving maior, especialmente se você já opera Ray. Para um modelo atrás de um endpoint, o serving direto com vLLM pode ser mais fácil de operar.
O vLLM pode substituir a API da OpenAI?
O vLLM pode expor uma interface compatível com a OpenAI para modelos self-hosted suportados, mas isso não torna modelos de peso aberto idênticos a APIs proprietárias de fronteira. Trate isso como um contrato de endpoint e uma opção de serving, e então valide a qualidade do modelo, a latência e o custo operacional contra sua carga de trabalho.
O que devo medir primeiro?
Meça a taxa de resposta aceita, o tempo até o primeiro token, a latência p95 e p99, a taxa de timeout, a pressão de memória da GPU e o custo por saída aceita. Tokens brutos por segundo são úteis, mas não são suficientes para decisões de produção.
Onde a Flatkey entra com o vLLM?
Use vLLM quando você precisar ser o proprietário da camada de serving da GPU. Use Flatkey quando quiser uma camada de API de modelo compatível com a OpenAI, faturamento unificado, registros de uso e governança em rotas e ferramentas oficiais de modelos. Muitas equipes usarão ambos: vLLM para cargas de trabalho self-hosted estáveis e Flatkey para modelos de fronteira, fallback, experimentos e governança do lado da API.
Checklist final
Antes do lançamento, seu guia de implantação do vLLM deve produzir estes artefatos:
- Uma revisão do modelo e uma versão do contêiner fixadas.
- Uma URL base OpenAI-compatible testada.
- Uma fronteira de autenticação e rede.
- Limites de requisição para contexto, saída, timeout e concurrency.
- Métricas de latência, erros, enfileiramento, throughput e memória da GPU.
- Uma rota de rollback e a imagem anterior conhecida como boa.
- Uma planilha de custo por saída aceita.
- Um registro de decisão explicando por que o vLLM self-hosted supera uma API de modelo gerenciada para esta carga de trabalho.
Se esses artefatos existirem, você não está apenas executando vLLM. Você está operando uma API de LLM em GPUs.
Fontes oficiais para manter abertas
- Documentação do servidor compatível com OpenAI do vLLM
- Documentação de implantação do vLLM com Docker
- Documentação de métricas de produção do vLLM
- Documentação de LLM do Ray Serve
- Documentação de endpoints do RunPod Serverless
- Documentação do NVIDIA Container Toolkit
- Flatkey Compute
- Preços da Flatkey


