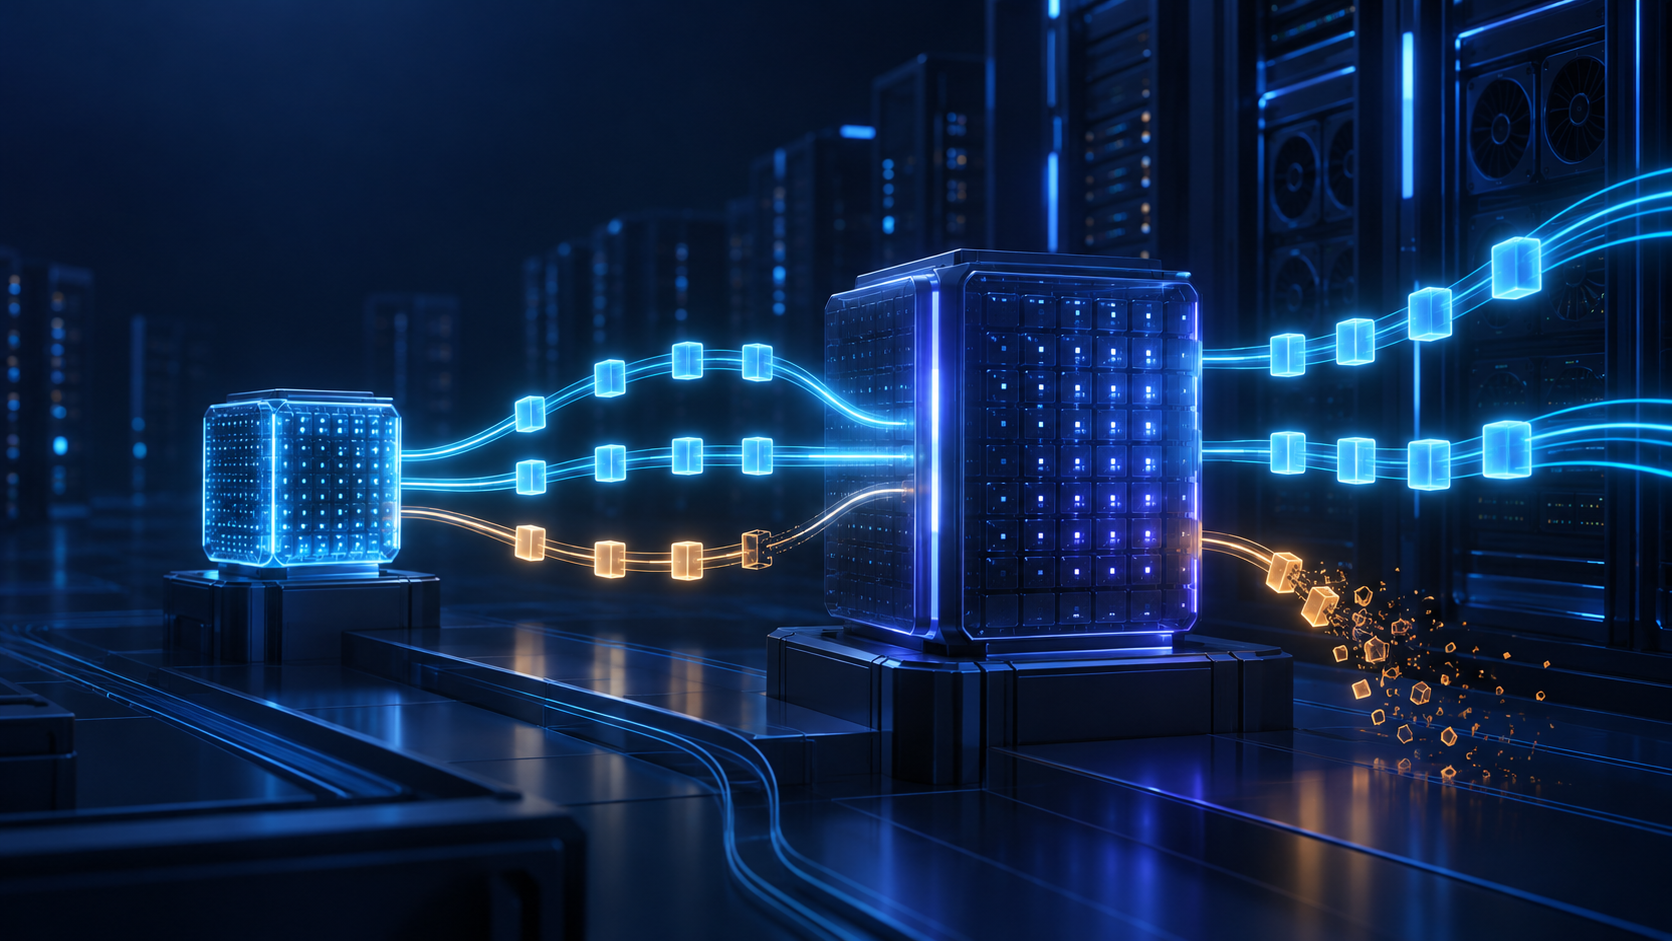
连续批处理使 vLLM 服务器能够在其他请求仍在生成 token 时接纳新请求。固定批处理必须等待所有成员完成后才能形成下一批;连续批处理则会在每个调度步骤重新检查活动集合。当提示和输出的长度不同时,这一区别尤为重要。短请求可以加入 GPU 工作,而无需等待上一组中最长响应完成。
对于推理团队而言,有价值的问题并不是功能列表中是否启用了连续批处理,而是实际请求组合能否在不将首 token 时间、排队时间或错误率推高到超出服务目标的情况下,提高每秒完成的响应数。本指南将说明其机制、需要关注的限制,以及可在选择 GPU 容量前运行的基准测试。
vLLM 连续批处理的工作原理
在 vLLM 当前的 V1 架构中,调度器会在每一步从运行中和等待中的请求填充 token 预算。请求会跟踪已计算的 token 数量;调度器分配工作以弥合这一差距。同一循环还会处理分块预填充、前缀缓存和推测解码。这比一个运行至完成的静态批处理图示更准确地反映了其工作方式。有关调度器的说明,请参阅 vLLM 架构概述。
设想有三个到达的请求:一个简短的聊天响应、一个长文档提示,以及另一个简短聊天请求。使用固定批处理时,第二个简短聊天请求可能要等待长请求的批次边界。使用连续批处理时,在第一批请求仍处于活动状态时,可以在后续调度步骤中考虑该请求。接纳仍受 token 预算、序列限制和可用 KV 缓存空间的约束。连续批处理并不保证零排队,也不保证每个请求都会更快完成。
PagedAttention 处理的是问题的另一部分:以块为单位存储和管理注意力 KV 缓存。它有助于引擎更灵活地使用内存,而调度器决定哪些请求获得计算资源。将这些角色区分开来,有助于诊断低吞吐量究竟是由调度、KV 缓存压力、长提示还是上游瓶颈造成的。vLLM PagedAttention 设计介绍了该内存机制。
影响批处理的控制项
| 控制项 | 其限制的内容 | 更改时需要关注的指标 |
|---|---|---|
max_num_batched_tokens |
一次调度迭代中处理的 token 数 | 吞吐量、首 token 时间、token 间延迟以及长提示的处理进度 |
max_num_seqs |
一次迭代中处理的序列数 | 运行中的请求、内存余量和尾延迟 |
| 分块预填充 | 将长预填充分割到多个调度步骤中 | 长提示延迟以及对解码请求的干扰 |
| 队列或接纳限制 | 允许等待或运行的请求数 | 排队时间、拒绝率,以及过载是否传递给调用方 |
| KV 缓存容量 | 可容纳在 GPU 上的活动上下文 | 抢占、重新计算和内存不足故障 |
这些设置会相互作用。提高 token 预算可能会改善某一种工作负载的吞吐量,却会恶化另一种工作负载的交互延迟。增加被接纳的序列数可以提高并发度,但也会消耗更多 KV 缓存。版本、模型架构、上下文长度和硬件都会影响结果。请阅读调度器 配置参考,了解已安装 vLLM 版本的行为,然后每次只更改一个控制项。
当 KV 缓存无法容纳新工作时,vLLM 可能会抢占一个运行中的请求,并在之后重新计算其进度。抢占计数上升表明,仅仅向批处理中添加更多到达请求并非没有代价。架构 概述说明了调度和抢占规则。
与生产流量匹配的基准测试
不要使用客户端能够尽快发送的单个短提示来比较连续批处理设置。请根据自己的日志或隐私安全的追踪数据构建三组请求:
- 提示和响应简短的短交互式聊天。
- 具有大型预填充和适中输出长度的长上下文请求。
- 具有重复前缀、多变输出长度、取消操作和突发流量的 Agent 或 RAG 请求。
在各次运行之间保持模型修订版本、分词器、GPU 类型、vLLM 版本和请求追踪数据不变。将提供的请求速率从低于预期负载逐步提高,直至排队时间或错误变得不可接受。官方 vllm bench serve
指南说明了请求速率和数据集控制方式。记录确切命令、配置和追踪数据版本,以便可以重复进行比较。
对于每次运行,记录每秒完成请求数、每秒输出 token 数、p50 和 p95 首 token 时间、p95 token 间延迟、p95 端到端延迟、排队时间、失败次数以及 GPU 内存高水位标记。vLLM 的生产指标 参考包含运行中和等待中请求的仪表,以及排队时间、首 token 时间和抢占次数的直方图。一个有用的评分卡是:
| 运行 | 提供的请求数/秒 | 完成的请求数/秒 | p95 首个 token | p95 队列时间 | p95 端到端 | 错误率 | 抢占次数 |
|---|---|---|---|---|---|---|---|
| 基线 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 |
| Token 预算变更 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 |
| 序列限制变更 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 |
请用测量结果填充此表;不存在可从其他模型或提供商照搬的通用百分比增益。应选择以每个被接受响应的最低成本满足延迟和可靠性目标的配置,而不是孤立地选择 token 吞吐量最高的配置。
诊断不理想的结果
如果连续批处理看起来没有效果,请先找出约束条件,再更改其他标志。
等待请求增加,而 GPU 内存仍有充足余量。检查准入限制、过小的序列上限、CPU token 化以及客户端并发度。调度器无法用从未到达 GPU 的请求填满 GPU。
长提示词的首个 token 时间增加。在基准测试中将以预填充为主的流量与以解码为主的流量分开。检查分块预填充和 token 预算设置,并比较长提示词的分布,而不只是平均值。
吞吐量提高,但 p95 延迟变差。服务器可能接受了超过交互式服务目标所允许的并发工作量。限制准入、使用队列超时或单独的服务池,并在相同提供负载下重新测试。
抢占或内存不足事件增加。活跃上下文可能无法装入 GPU 的 KV 缓存。降低并发度或上下文限制,选择内存充足的 GPU,或重新评估模型和精度选择。不要将被抢占的请求视为无成本的调度事件。
即使请求在等待,GPU 利用率仍然很低。在将瓶颈归因于连续批处理之前,请检查 CPU、网络、存储、模型加载和客户端节流。我们的 vLLM 部署指南涵盖了更广泛的服务运行手册;本文重点讨论调度器行为和测量。
GPU 选择如何影响决策
连续批处理可以改善 GPU 的使用方式,但无法让模型装入其不具备的内存。估算权重、预期并发度和上下文长度下的 KV 缓存、运行时开销以及安全余量。然后在计划租用的 GPU 配置上进行基准测试。对于相同的模型和请求轨迹,80 GB GPU 与更大内存的 GPU 可能产生不同的准入和抢占行为。
Flatkey GPU Compute列出了租用选项,包括 H100 SXM、H200、B200、B300、A100 80GB 和 RTX 5090。必须针对所选租用方案确认配置、区域、可用性和价格。比较选项时,请携带基准测试轨迹、目标延迟、模型修订版本和内存估算。这样,容量讨论就聚焦于已完成的工作,而非醒目的 GPU 规格。
实用决策清单
在确定 vLLM 连续批处理配置之前,请回答以下问题:
- 最高流量场景是否满足 p95 首个 token 和端到端延迟目标?
- 当突发流量高于正常请求速率时会发生什么:队列是否有界、请求被拒绝,还是出现大幅延迟尖峰?
- 在预期上下文长度下,抢占和 KV 缓存压力是否稳定?
- 在计划运行的确切模型修订版本和 GPU 规格上,结果是否可复现?
- 在计入重试和闲置容量后,每个被接受响应的成本是否优于替代方案?
常见问题
vLLM 连续批处理是否意味着每个请求都会立即运行?
不是。新到达的请求可以在调度步骤中被考虑,但它仍可能需要等待 token 预算、序列槽位或 KV 缓存容量。在承诺交互式延迟目标之前,请结合队列时间直方图一起观察运行中和等待中的指标。
vLLM 连续批处理与分块预填充相同吗?
不是。连续批处理描述的是请求如何随时间加入和离开已调度的工作。分块预填充会拆分长提示词的预填充工作,使其能够在多个步骤中共享 token 预算。它们在当前调度器中协同工作,但调整其中一个调优参数并不能替代对另一个的测量。
我应该最大化批处理大小吗?
不一定。更大的批次可能提高吞吐量,同时增加队列时间、首个 token 时间或抢占压力。在相同提供负载下运行相同的轨迹,并比较完整的服务目标,包括故障和每个被接受响应的成本。
vLLM 连续批处理是一种调度方法,而不是基准测试结果。最强的配置是能够用自己的测量结果解释其吞吐量、延迟、内存行为和故障模式的配置。