Hướng dẫn API LLM (2026): Khái niệm, cách hoạt động, giá và các nhà cung cấp tốt nhất
API LLM là một điểm cuối trên web cho phép mã của bạn gửi lời nhắc đến mô hình ngôn ngữ lớn và nhận về văn bản được tạo, JSON hoặc lệnh gọi công cụ, với phí tính theo token. Bạn gọi API bằng một yêu cầu HTTP chứa khóa API, tên mô hình và các tin nhắn, qua đó sử dụng những mô hình như GPT, Claude, Gemini, DeepSeek hoặc Qwen mà không cần vận hành GPU. Vào tháng 10 năm 2026, giá dao động từ $0.10 cho mỗi triệu token đầu vào với các mô hình nhỏ đến $10 với những mô hình lớn nhất.
Hướng dẫn này dành cho lập trình viên và những người phát triển sản phẩm độc lập đang chọn API LLM đầu tiên hoặc tiếp theo. Nội dung bao gồm cách xử lý yêu cầu, mã chạy được ngay bằng curl, Python và Node.js, giá chính thức hiện tại của các nhà cung cấp lớn, lựa chọn miễn phí, cách chọn nhà cung cấp và những trường hợp API hợp nhất phù hợp hơn các tài khoản riêng lẻ.
API trong LLM là gì?
API (giao diện lập trình ứng dụng) là bộ quy ước mà chương trình của bạn dùng để giao tiếp với một dịch vụ khác. Với mô hình ngôn ngữ lớn, API xác định:
- Điểm cuối: URL mà bạn gửi yêu cầu đến, chẳng hạn như
/v1/chat/completionshoặc/v1/messages. - Xác thực: khóa API trong phần đầu yêu cầu, gắn với tài khoản và thông tin thanh toán của bạn.
- Định dạng yêu cầu: ID mô hình, danh sách tin nhắn (system, user, assistant) và các tùy chọn như
max_tokens,temperature, công cụ và định dạng phản hồi. - Định dạng phản hồi: văn bản được tạo hoặc đầu ra có cấu trúc, cùng lượng token sử dụng để tính phí.
- Giới hạn: số yêu cầu và token mỗi phút, cửa sổ ngữ cảnh và độ dài đầu ra tối đa.
Bản thân mô hình chạy trên GPU của nhà cung cấp. Bạn không tải trọng số về mà thuê năng lực suy luận theo từng yêu cầu. Đây là khác biệt chính so với việc tự triển khai một mô hình mở bằng các công cụ như vLLM hoặc Ollama.
Quy trình hoạt động của API LLM
- Ứng dụng của bạn tạo yêu cầu chứa tên mô hình và nội dung hội thoại tính đến thời điểm hiện tại.
- Nhà cung cấp chia văn bản thành token (một token tương đương khoảng 3 đến 4 ký tự tiếng Anh).
- Mô hình lần lượt tạo từng token đầu ra, có thể truyền dần về dưới dạng sự kiện do máy chủ gửi (server-sent events).
- Phản hồi chứa văn bản và một đối tượng
usagevới số token đầu vào và đầu ra. - Phí được tính theo công thức: token đầu vào x giá đầu vào + token đầu ra x giá đầu ra.
Vì API không lưu trạng thái, bạn phải gửi lại lịch sử hội thoại có liên quan trong mỗi lần gọi. Đó là lý do cuộc trò chuyện càng dài càng tốn kém và mức giảm giá nhờ lưu đệm lời nhắc lại quan trọng.
Ví dụ API LLM: yêu cầu đầu tiên của bạn
Hầu hết nhà cung cấp hiện chấp nhận định dạng hội thoại kiểu OpenAI, vì vậy định dạng này đã trở thành tiêu chuẩn trên thực tế. Ví dụ sau gọi trực tiếp OpenAI:
curl https://api.openai.com/v1/chat/completions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      {"role": "system", "content": "You are a concise assistant."},
      {"role": "user", "content": "Explain what an LLM API is in one sentence."}
    ],
    "max_tokens": 100
  }'
Cùng yêu cầu đó bằng Python với gói openai chính thức. Thay base_url và khóa API để chuyển sang bất kỳ nhà cung cấp nào tương thích với OpenAI, bao gồm bộ định tuyến như Flatkey (hướng dẫn bắt đầu nhanh):
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_KEY",
    base_url="https://router.flatkey.ai/v1",  # or https://api.openai.com/v1
)

resp = client.chat.completions.create(
    model="claude-sonnet-5-5",  # any model ID from the provider's catalog
    messages=[{"role": "user", "content": "Give me 3 names for a todo app."}],
    max_tokens=200,
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens, completion_tokens -> what you pay for
Và bằng Node.js 18+ với fetch thuần và cơ chế truyền dữ liệu theo luồng:
const res = await fetch("https://router.flatkey.ai/v1/chat/completions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.FLATKEY_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    model: "gemini-4-argon",
    stream: true,
    messages: [{ role: "user", content: "Write a haiku about APIs." }],
  }),
});
const decoder = new TextDecoder();
for await (const chunk of res.body) process.stdout.write(decoder.decode(chunk));
Anthropic và Google cũng có định dạng riêng (API Messages và API Gemini) với các tính năng đặc thù của từng nhà cung cấp, nhưng cả hai đều có thể được truy cập qua các lớp tương thích với OpenAI.
Các nhà cung cấp API LLM tốt nhất năm 2026 (kèm giá chính thức)
Giá dưới đây tính cho mỗi triệu token (đầu vào / đầu ra), lấy từ trang giá chính thức của từng nhà cung cấp vào ngày 23 tháng 10 năm 2026.
| Nhà cung cấp | Mô hình cao cấp | Mô hình cân bằng | Mô hình tiết kiệm | Ghi chú |
|---|---|---|---|---|
| OpenAI | gpt-6-astra $10 / $50 | gpt-6.1-sol $2 / $10 | gpt-6-luna $0.10 / $0.50 | Các hình thức Batch và Flex giảm giá 50% |
| Anthropic Claude | Opus 5.5 $4 / $20 | Sonnet 5.5 $2 / $10 | Haiku 5.5 $0.10 / $0.50 (lời nhắc tối đa 100K) | Ngữ cảnh 1M với giá tiêu chuẩn trên các mô hình 4.6+, ngoại trừ Haiku 5.5 |
| Google Gemini | Gemini 4 Argon $2 / $10 đến hết ngày 30 tháng 11 năm 2026 ($4 / $20 từ ngày 1 tháng 12) | Gemini 3.8 Flash $0.75 cho đầu vào đến hết ngày 31 tháng 12 năm 2026 | Các mô hình Flash-Lite | Có gói miễn phí cho các mô hình Flash; Argon không có trong gói miễn phí |
| DeepSeek | deepseek-v4-pro $1.32 / $3.96 giờ cao điểm, $0.66 / $1.98 giờ thấp điểm | không áp dụng | deepseek-flash $0.30 / $1.20 giờ cao điểm, $0.15 / $0.60 giờ thấp điểm | Giá khi trúng bộ nhớ đệm từ $0.003 |
| OpenRouter | Giá niêm yết của nhà cung cấp | Phí 5.5% khi nạp tín dụng (gói Standard) | ||
| Flatkey | ví dụ: Kimi K3 $1.80 / $9 (niêm yết $3 / $15) | ví dụ: Claude Sonnet 5.5 $1.60 / $8 | ví dụ: gpt-6-luna $0.06 / $0.30 | Một khóa cho 80+ mô hình; giá lấy từ các trang mô hình |
Giá của Flatkey được lấy từ các trang mô hình vào ngày 23 tháng 10 năm 2026, nơi hiển thị cả giá Flatkey và giá niêm yết của nhà cung cấp. Để xem phân tích chi tiết theo từng mô hình, bao gồm giảm giá nhờ lưu đệm và xử lý theo lô, hãy đọc bài so sánh giá API AI của chúng tôi.
API LLM nào rẻ nhất?
Với các mô hình nhỏ, tốc độ nhanh, giá niêm yết chính thức thấp nhất trong tháng 10 năm 2026 thuộc về OpenAI gpt-6-luna và Claude Haiku 5.5 ở mức $0.10 đầu vào / $0.50 đầu ra cho mỗi triệu token, cùng deepseek-flash ở mức $0.15 / $0.60 trong giờ thấp điểm của DeepSeek. Ví dụ: 10,000 yêu cầu mỗi ngày, mỗi yêu cầu có 1,000 token đầu vào và 300 token đầu ra, tương đương 300M token đầu vào và 90M token đầu ra mỗi tháng, tốn khoảng $75 theo giá niêm yết của gpt-6-luna. API xử lý theo lô, lưu đệm lời nhắc và khung giờ thấp điểm có thể tiếp tục giảm một nửa chi phí đó.
Có API LLM miễn phí không?
Có, nhưng có giới hạn. API Gemini của Google có gói miễn phí cho các mô hình Flash (dữ liệu sử dụng có thể được dùng để cải thiện sản phẩm của Google), và một số bộ định tuyến cung cấp các mô hình miễn phí có giới hạn tốc độ. Gói miễn phí phù hợp để làm bản mẫu nhưng có hạn mức yêu cầu mỗi ngày thấp. Xem danh sách API LLM miễn phí năm 2026 của chúng tôi.
Cách chọn API LLM
| Câu hỏi | Vì sao quan trọng | Cần kiểm tra gì |
|---|---|---|
| Đầu ra cần đạt chất lượng đến đâu? | Mô hình cao cấp có thể đắt gấp 50 đến 100 lần mô hình tiết kiệm | Thử 20 đến 50 lời nhắc thực tế trên hai hoặc ba phân khúc mô hình |
| Lời nhắc của bạn dài bao nhiêu? | Ngữ cảnh dài làm tăng nhiều lần chi phí đầu vào | Cửa sổ ngữ cảnh và giá cho lời nhắc dài (ví dụ: Haiku 5.5 trên 100K) |
| Cần phản hồi nhanh đến mức nào? | Người dùng nhận thấy thời gian chờ token đầu tiên | Khả năng hỗ trợ truyền dữ liệu theo luồng và độ trễ tại khu vực của bạn |
| Lưu lượng bao nhiêu? | Giới hạn được tính theo phút và theo ngày | RPM/TPM theo từng cấp; xem hướng dẫn giới hạn tốc độ LLM của chúng tôi |
| Bạn có cần công cụ hoặc JSON không? | Tác tử phụ thuộc vào khả năng gọi hàm | Khả năng hỗ trợ gọi công cụ và đầu ra có cấu trúc |
| Dữ liệu được xử lý ở đâu? | Yêu cầu tuân thủ và hợp đồng với khách hàng | Chính sách lưu giữ dữ liệu, điểm cuối theo khu vực (suy luận Claude chỉ tại Mỹ có giá gấp 1.1x) |
| Bạn có chuyển đổi mô hình không? | Giá và các mô hình dẫn đầu thay đổi vài tháng một lần | Định dạng tương thích với OpenAI hoặc API hợp nhất |
Gọi trực tiếp nhà cung cấp hay dùng API LLM hợp nhất
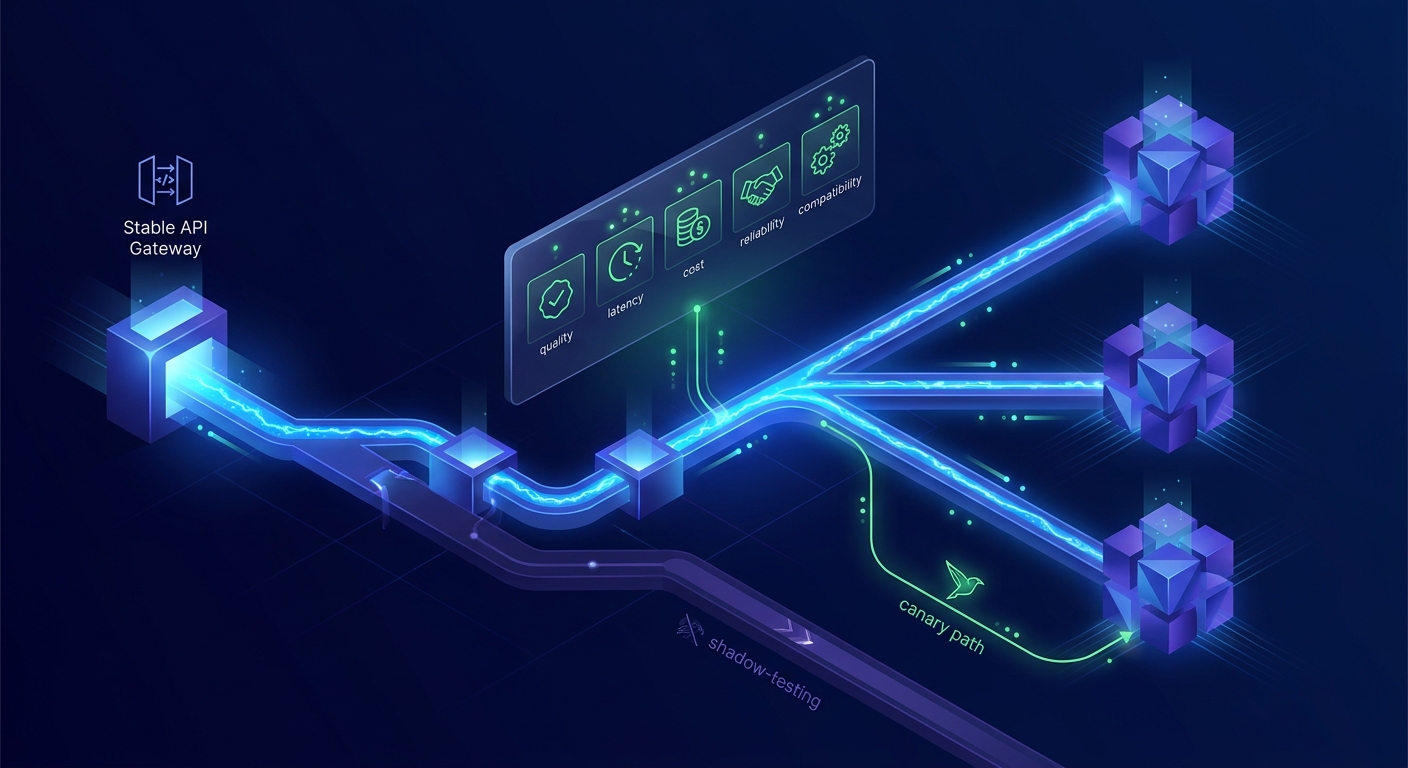
Gọi trực tiếp một nhà cung cấp là cách đơn giản nhất khi bạn dùng một dòng mô hình. Khi kết hợp nhiều mô hình, API hợp nhất (còn gọi là bộ định tuyến LLM hoặc cổng LLM) giúp giảm công sức:
- Một khóa và một số dư thay cho các tài khoản, hóa đơn và giới hạn tốc độ riêng của từng nhà cung cấp.
- Đổi mô hình bằng cách thay một chuỗi ký tự, không cần đổi SDK.
- Chuyển sang mô hình dự phòng khi một nhà cung cấp gặp sự cố hoặc bị giới hạn tốc độ.
- Một nhật ký sử dụng chung để theo dõi chi phí theo tính năng hoặc khách hàng.
Các lựa chọn gồm bộ định tuyến được lưu trữ sẵn (OpenRouter, Flatkey, Vercel AI Gateway) và proxy tự triển khai như LiteLLM. Các bộ định tuyến được lưu trữ sẵn khác nhau chủ yếu ở phí: OpenRouter tính giá niêm yết của nhà cung cấp cộng phí nạp tín dụng 5.5% trên gói Standard, còn các trang mô hình của Flatkey niêm yết giá thấp hơn giá của nhà cung cấp cho nhiều mô hình. So sánh các lựa chọn này trong hướng dẫn về các giải pháp thay thế OpenRouter và bài giải thích về API AI hợp nhất của chúng tôi.
Khi nào API LLM quan trọng, khi nào không
Hãy dùng API LLM khi người dùng thực tế phụ thuộc vào đầu ra, khi bạn cần nhiều hơn một mô hình, khi cần phân bổ chi phí theo tính năng hoặc khách hàng, hoặc khi đang xây dựng tác tử có gọi công cụ. Hãy tự triển khai khi bắt buộc phải giữ dữ liệu trên phần cứng của mình, cần một mô hình mở đã tinh chỉnh để xử lý lưu lượng cao và ổn định, hoặc cần hoạt động ngoại tuyến. Hướng dẫn một khóa API cho nhiều mô hình AI của chúng tôi cho thấy cách các nhóm nhỏ thiết lập hệ thống này mà không cần đội ngũ nền tảng.
Những sai lầm thường gặp
- Ghi cứng cùng một ID mô hình ở khắp nơi. Đưa ID vào cấu hình để dễ chuyển đổi.
- Bỏ qua token đầu ra. Đầu ra thường đắt gấp 4 đến 5 lần đầu vào; hãy giới hạn
max_tokens. - Gửi lại lịch sử quá dài. Tóm tắt hoặc lưu đệm những lời nhắc hệ thống dài.
- Không có cơ chế thử lại. Lỗi 429 và 5xx vẫn xảy ra; hãy bổ sung cơ chế tăng dần thời gian chờ giữa các lần thử lại (xem hướng dẫn xử lý lỗi vượt giới hạn tốc độ API của chúng tôi).
- Đưa khóa vào git. Dùng biến môi trường và luân chuyển khóa.
Câu hỏi thường gặp
API trong LLM là gì?
Đó là giao diện mà mã của bạn dùng để gửi lời nhắc đến mô hình ngôn ngữ lớn và nhận đầu ra. Giao diện này quy định URL điểm cuối, cách xác thực bằng khóa API, định dạng yêu cầu và phản hồi, giới hạn tốc độ và cách tính phí theo token.
ChatGPT là LLM hay NLP?
Theo một nghĩa nào đó thì là cả hai. Xử lý ngôn ngữ tự nhiên (NLP) là một lĩnh vực; mô hình ngôn ngữ lớn là một loại mô hình NLP; còn ChatGPT là sản phẩm dành cho người dùng cuối được xây dựng trên các LLM của OpenAI. Lập trình viên truy cập cùng dòng mô hình đó qua API OpenAI thay vì ứng dụng ChatGPT.
Những API LLM nào tốt nhất?
Vào tháng 10 năm 2026, các lựa chọn chính là OpenAI (dòng GPT-6), Anthropic (dòng Claude 5.5), Google (Gemini 4 Argon và các mô hình Flash), DeepSeek (V4 Pro và Flash), cùng các API hợp nhất như OpenRouter và Flatkey cho phép truy cập nhiều nhà cung cấp bằng một khóa.
API LLM nào rẻ nhất?
Theo giá niêm yết chính thức vào ngày 23 tháng 10 năm 2026, OpenAI gpt-6-luna và Claude Haiku 5.5 có giá $0.10 cho mỗi triệu token đầu vào và $0.50 cho mỗi triệu token đầu ra, còn deepseek-flash có giá $0.15 / $0.60 vào giờ thấp điểm. Gói miễn phí của Gemini còn rẻ hơn khi lưu lượng thấp.
Có API LLM miễn phí không?
Có. API Gemini của Google có gói miễn phí cho các mô hình Flash với hạn mức hằng ngày, và một số bộ định tuyến cung cấp các mô hình miễn phí có giới hạn tốc độ. Bạn cần tính đến hạn mức thấp và các điều khoản có thể cho phép sử dụng dữ liệu.
API LLM khác gì cổng LLM?
API LLM là điểm cuối của một nhà cung cấp để truy cập các mô hình của họ. Cổng LLM hoặc bộ định tuyến nằm trước nhiều nhà cung cấp, cung cấp một khóa, một định dạng, khả năng định tuyến, chuyển sang mô hình dự phòng và thanh toán hợp nhất.
Tôi có cần GPU để dùng API LLM không?
Không. Nhà cung cấp chạy mô hình trên GPU của họ; bạn chỉ gửi yêu cầu HTTP và trả phí theo token.