Panduan API LLM (2026): Pengertian, Cara Kerja, Harga, dan Penyedia Terbaik
API LLM adalah endpoint web yang memungkinkan kode Anda mengirim prompt ke model bahasa besar dan menerima teks, JSON, atau panggilan alat yang dihasilkan model, dengan biaya per token. Anda mengaksesnya melalui permintaan HTTP yang berisi kunci API, nama model, dan pesan Anda, sehingga dapat menggunakan model seperti GPT, Claude, Gemini, DeepSeek, atau Qwen tanpa menjalankan GPU sendiri. Pada Oktober 2026, harga berkisar dari $0.10 per juta token input untuk model kecil hingga $10 untuk model terbesar.
Panduan ini ditujukan bagi pengembang dan pembuat produk independen yang sedang memilih API LLM pertama atau berikutnya. Pembahasannya mencakup alur permintaan, kode siap pakai dalam curl, Python, dan Node.js, harga resmi terkini dari penyedia utama, opsi gratis, cara memilih penyedia, serta kapan API terpadu lebih masuk akal daripada akun terpisah.
Apa itu API dalam LLM?
API (antarmuka pemrograman aplikasi) adalah kontrak yang digunakan program Anda untuk berkomunikasi dengan layanan lain. Untuk model bahasa besar, API menentukan:
- Endpoint: URL tujuan pengiriman permintaan, seperti
/v1/chat/completionsatau/v1/messages. - Autentikasi: kunci API di dalam header yang terhubung ke akun dan penagihan Anda.
- Format permintaan: ID model, daftar pesan (system, user, assistant), serta opsi seperti
max_tokens,temperature, alat, dan format respons. - Format respons: teks yang dihasilkan atau keluaran terstruktur, beserta penggunaan token untuk penagihan.
- Batas: jumlah permintaan dan token per menit, jendela konteks, serta panjang keluaran maksimum.
Modelnya sendiri berjalan di GPU milik penyedia. Anda tidak perlu mengunduh bobot model; Anda menyewa inferensi untuk setiap permintaan. Inilah perbedaan utama dibandingkan menjalankan model terbuka di infrastruktur sendiri dengan alat seperti vLLM atau Ollama.
Cara kerja API LLM, langkah demi langkah
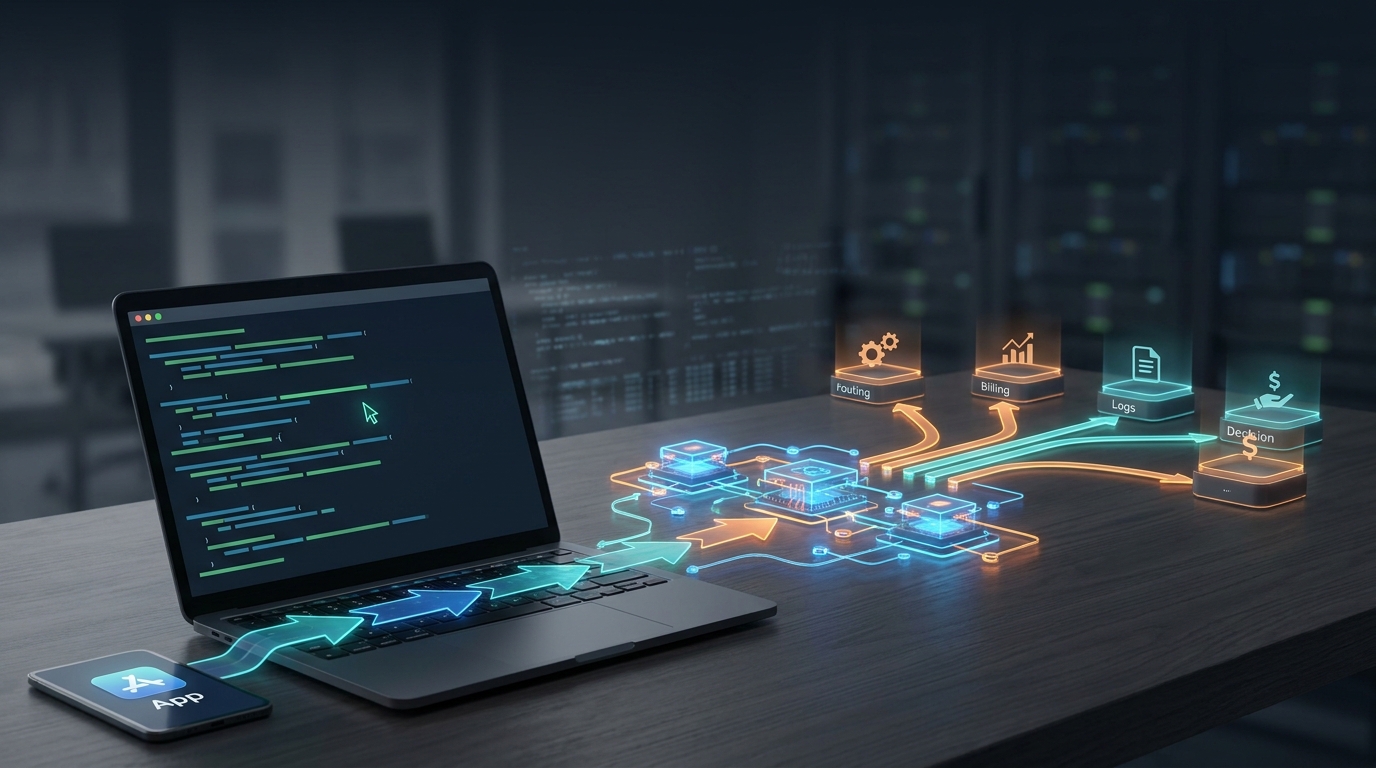
- Aplikasi Anda menyusun permintaan yang berisi nama model dan percakapan sejauh ini.
- Penyedia memecah teks menjadi token (satu token kira-kira setara dengan 3 hingga 4 karakter bahasa Inggris).
- Model menghasilkan token keluaran satu per satu, yang juga dapat dikirim secara streaming sebagai server-sent events.
- Respons menyertakan teks dan objek
usageberisi jumlah token input dan output. - Biaya dihitung: token input x harga input + token output x harga output.
Karena API tidak menyimpan status percakapan, Anda perlu mengirim ulang riwayat percakapan yang relevan pada setiap panggilan. Itulah sebabnya percakapan panjang menjadi lebih mahal dan diskon caching prompt berpengaruh besar.
Contoh API LLM: permintaan pertama Anda
Sebagian besar penyedia kini menerima format chat bergaya OpenAI, sehingga format ini menjadi standar de facto. Contoh berikut dapat langsung digunakan untuk mengakses OpenAI:
curl https://api.openai.com/v1/chat/completions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      {"role": "system", "content": "You are a concise assistant."},
      {"role": "user", "content": "Explain what an LLM API is in one sentence."}
    ],
    "max_tokens": 100
  }'
Permintaan yang sama dalam Python menggunakan paket resmi openai. Dengan mengganti base_url dan kunci API, Anda dapat mengarahkannya ke penyedia mana pun yang kompatibel dengan OpenAI, termasuk router seperti Flatkey (panduan mulai cepat):
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_KEY",
    base_url="https://router.flatkey.ai/v1",  # or https://api.openai.com/v1
)

resp = client.chat.completions.create(
    model="claude-sonnet-5-5",  # any model ID from the provider's catalog
    messages=[{"role": "user", "content": "Give me 3 names for a todo app."}],
    max_tokens=200,
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens, completion_tokens -> what you pay for
Dan dalam Node.js 18+ menggunakan fetch bawaan dan streaming:
const res = await fetch("https://router.flatkey.ai/v1/chat/completions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.FLATKEY_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    model: "gemini-4-argon",
    stream: true,
    messages: [{ role: "user", content: "Write a haiku about APIs." }],
  }),
});
const decoder = new TextDecoder();
for await (const chunk of res.body) process.stdout.write(decoder.decode(chunk));
Anthropic dan Google juga memiliki format asli (Messages API dan Gemini API) dengan fitur khusus masing-masing penyedia, tetapi keduanya juga dapat diakses melalui lapisan yang kompatibel dengan OpenAI.
Penyedia API LLM terbaik pada 2026 (beserta harga resmi)
Harga di bawah ini berlaku per juta token (input / output), diambil dari halaman harga resmi masing-masing penyedia pada 23 Oktober 2026.
| Penyedia | Model premium | Model seimbang | Model hemat | Catatan |
|---|---|---|---|---|
| OpenAI | gpt-6-astra $10 / $50 | gpt-6.1-sol $2 / $10 | gpt-6-luna $0.10 / $0.50 | Opsi Batch dan Flex memangkas harga 50% |
| Anthropic Claude | Opus 5.5 $4 / $20 | Sonnet 5.5 $2 / $10 | Haiku 5.5 $0.10 / $0.50 (prompt hingga 100K) | Konteks 1M dengan harga standar pada model 4.6+ kecuali Haiku 5.5 |
| Google Gemini | Gemini 4 Argon $2 / $10 hingga 30 November 2026 ($4 / $20 mulai 1 Desember) | Gemini 3.8 Flash $0.75 untuk input hingga 31 Desember 2026 | Model Flash-Lite | Paket gratis untuk model Flash; Argon tidak tersedia dalam paket gratis |
| DeepSeek | deepseek-v4-pro $1.32 / $3.96 pada jam sibuk, $0.66 / $1.98 di luar jam sibuk | tidak berlaku | deepseek-flash $0.30 / $1.20 pada jam sibuk, $0.15 / $0.60 di luar jam sibuk | Cache hit mulai $0.003 |
| OpenRouter | Harga katalog penyedia | Biaya 5.5% untuk pembelian kredit (paket Standard) | ||
| Flatkey | misalnya Kimi K3 $1.80 / $9 (harga katalog $3 / $15) | misalnya Claude Sonnet 5.5 $1.60 / $8 | misalnya gpt-6-luna $0.06 / $0.30 | Satu kunci untuk 80+ model; harga dari halaman model |
Harga Flatkey diambil dari halaman modelnya pada 23 Oktober 2026, yang menampilkan tarif Flatkey sekaligus harga katalog penyedia. Untuk rincian per model yang lebih mendalam, termasuk caching dan diskon batch, baca perbandingan harga API AI kami.
API LLM mana yang paling murah?
Untuk model kecil dan cepat, harga katalog resmi termurah pada Oktober 2026 adalah OpenAI gpt-6-luna dan Claude Haiku 5.5 dengan $0.10 untuk input / $0.50 untuk output per juta token, serta deepseek-flash dengan $0.15 / $0.60 di luar jam sibuk DeepSeek. Contoh: 10,000 permintaan per hari, masing-masing dengan 1,000 token input dan 300 token output, menghasilkan 300M token input dan 90M token output per bulan, atau sekitar $75 berdasarkan harga katalog gpt-6-luna. API Batch, caching prompt, dan waktu di luar jam sibuk dapat memangkas biaya itu hingga separuhnya lagi.
Apakah ada API LLM gratis?
Ya, dengan batasan. Gemini API dari Google memiliki paket gratis untuk model Flash (dengan penggunaan yang dapat dimanfaatkan untuk meningkatkan produk Google), dan beberapa router menyediakan model gratis dengan batas laju permintaan. Paket gratis cocok untuk prototipe, tetapi memiliki kuota permintaan harian yang rendah. Lihat daftar API LLM gratis pada 2026 kami.
Cara memilih API LLM
| Pertanyaan | Mengapa penting | Yang perlu diperiksa |
|---|---|---|
| Seberapa baik kualitas keluaran yang dibutuhkan? | Model premium dapat berharga 50 hingga 100 kali lebih mahal daripada model hemat | Uji 20 hingga 50 prompt nyata pada dua atau tiga kelas model |
| Seberapa panjang prompt Anda? | Konteks panjang melipatgandakan biaya input | Jendela konteks dan harga untuk prompt panjang (misalnya Haiku 5.5 di atas 100K) |
| Seberapa cepat respons yang dibutuhkan? | Pengguna merasakan waktu tunggu hingga token pertama | Dukungan streaming dan latensi di wilayah Anda |
| Seberapa besar trafiknya? | Batas berlaku per menit dan per hari | RPM/TPM menurut paket; lihat panduan batas laju LLM kami |
| Apakah Anda membutuhkan alat atau JSON? | Agen bergantung pada pemanggilan fungsi | Dukungan pemanggilan alat dan keluaran terstruktur |
| Di mana data diproses? | Kepatuhan dan kontrak pelanggan | Retensi data, endpoint regional (inferensi Claude khusus AS dikenai biaya 1.1x) |
| Apakah Anda akan berganti model? | Harga dan model terunggul berubah setiap beberapa bulan | Format yang kompatibel dengan OpenAI, atau API terpadu |
Mengakses penyedia langsung vs API LLM terpadu
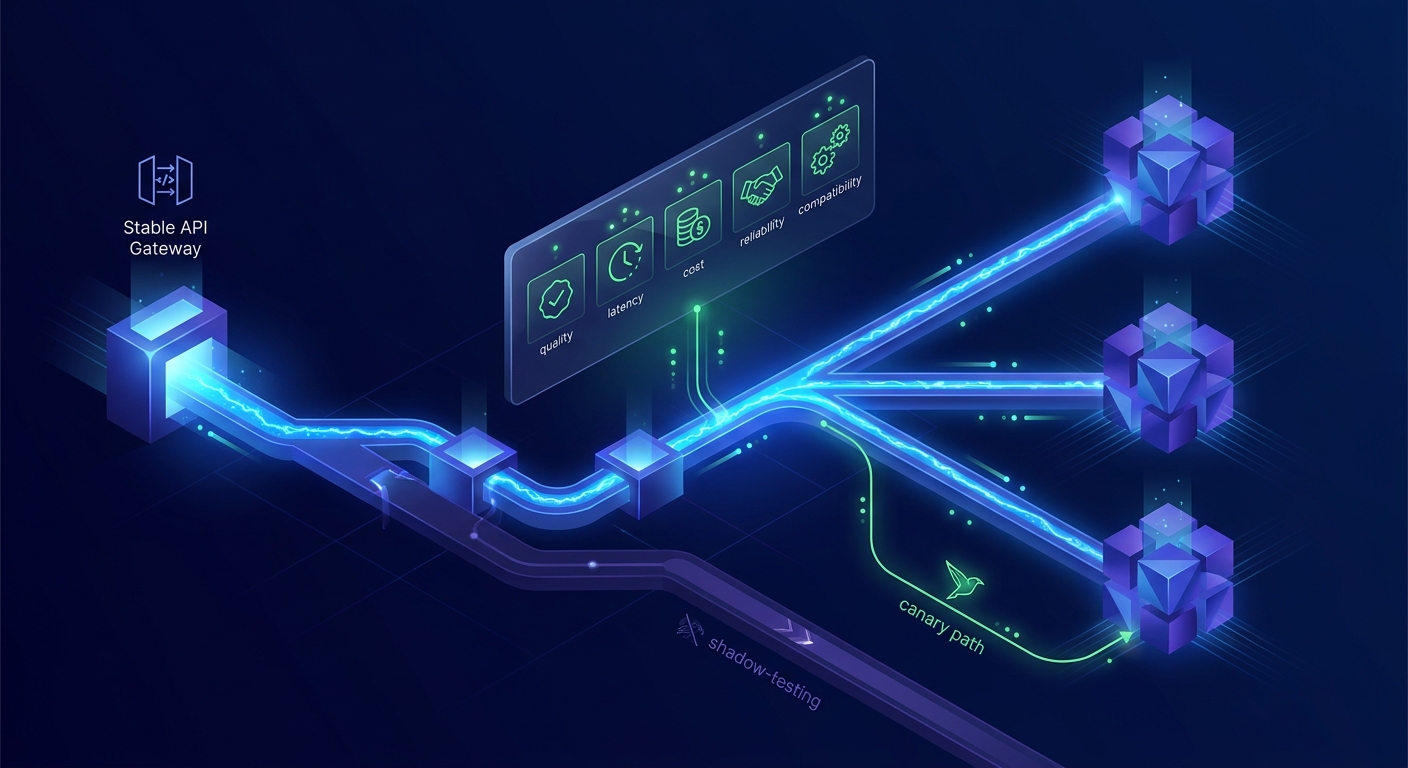
Mengakses satu penyedia secara langsung adalah pilihan paling sederhana jika Anda menggunakan satu keluarga model. Saat Anda mulai menggabungkan model, API terpadu (juga disebut router LLM atau gateway LLM) menghemat pekerjaan:
- Satu kunci dan satu saldo sebagai pengganti akun, faktur, dan batas laju terpisah untuk setiap penyedia.
- Ganti model cukup dengan mengubah satu string, tanpa mengganti SDK.
- Beralih ke model cadangan saat salah satu penyedia mengalami gangguan atau terkena batas laju.
- Satu log penggunaan untuk melacak biaya per fitur atau pelanggan.
Pilihannya mencakup router terkelola (OpenRouter, Flatkey, Vercel AI Gateway) dan proksi yang dihosting sendiri seperti LiteLLM. Perbedaan utama antar-router terkelola terletak pada biaya: OpenRouter mengenakan harga katalog penyedia ditambah biaya kredit 5.5% pada paket Standard, sementara halaman model Flatkey mencantumkan tarif di bawah harga katalog penyedia untuk banyak model. Bandingkan keduanya dalam panduan alternatif OpenRouter dan penjelasan API AI terpadu kami.
Kapan API LLM penting, dan kapan tidak
Gunakan API LLM saat pengguna sungguhan bergantung pada keluarannya, saat Anda membutuhkan lebih dari satu model, saat biaya perlu dikaitkan dengan fitur atau pelanggan, atau saat Anda membangun agen yang memanggil alat. Pilih untuk menghosting sendiri saat data harus tetap berada di perangkat keras Anda, saat Anda membutuhkan model terbuka yang telah di-fine-tune untuk volume tinggi yang stabil, atau saat sistem harus beroperasi secara offline. Panduan kami tentang satu kunci API untuk beberapa model AI menunjukkan cara tim kecil menyiapkannya tanpa tim platform.
Kesalahan umum
- Menanamkan satu ID model langsung di seluruh kode. Simpan dalam konfigurasi agar mudah diganti.
- Mengabaikan token output. Output biasanya berharga 4 hingga 5 kali lebih mahal daripada input; batasi
max_tokens. - Mengirim ulang riwayat yang sangat panjang. Ringkas atau cache prompt sistem yang panjang.
- Tidak menambahkan logika percobaan ulang. Error 429 dan 5xx bisa terjadi; tambahkan jeda yang meningkat antarpercobaan (lihat panduan mengatasi batas laju API yang terlampaui kami).
- Memasukkan kunci API ke dalam commit git. Gunakan variabel lingkungan dan rotasi kunci secara berkala.
Pertanyaan umum
Apa itu API dalam LLM?
API adalah antarmuka yang digunakan kode Anda untuk mengirim prompt ke model bahasa besar dan menerima keluarannya. API menentukan URL endpoint, autentikasi dengan kunci API, format permintaan dan respons, batas laju, serta penagihan per token.
Apakah ChatGPT termasuk LLM atau NLP?
Dalam pengertian tertentu, keduanya. Pemrosesan bahasa alami (NLP) adalah bidangnya; model bahasa besar merupakan salah satu jenis model NLP; dan ChatGPT adalah produk konsumen yang dibangun di atas LLM milik OpenAI. Pengembang mengakses keluarga model yang sama melalui OpenAI API, alih-alih aplikasi ChatGPT.
Apa saja API LLM terbaik?
Pada Oktober 2026, pilihan utamanya adalah OpenAI (keluarga GPT-6), Anthropic (keluarga Claude 5.5), Google (Gemini 4 Argon dan model Flash), DeepSeek (V4 Pro dan Flash), serta API terpadu seperti OpenRouter dan Flatkey yang menyediakan akses ke banyak penyedia melalui satu kunci.
Apa API LLM yang paling murah?
Berdasarkan harga katalog resmi pada 23 Oktober 2026, OpenAI gpt-6-luna dan Claude Haiku 5.5 berharga $0.10 per juta token input dan $0.50 per juta token output, sementara deepseek-flash berharga $0.15 / $0.60 di luar jam sibuk. Paket gratis Gemini bahkan lebih murah untuk volume rendah.
Apakah ada API LLM gratis?
Ya. Gemini API dari Google menawarkan paket gratis untuk model Flash dengan batas harian, dan beberapa router menawarkan model gratis dengan batas laju permintaan. Bersiaplah menghadapi kuota yang ketat dan kemungkinan adanya ketentuan penggunaan data.
Apa perbedaan antara API LLM dan gateway LLM?
API LLM adalah endpoint milik satu penyedia untuk mengakses modelnya. Gateway atau router LLM berada di depan banyak penyedia, menyediakan satu kunci, satu format, perutean, peralihan ke model cadangan, dan penagihan terpadu.
Apakah saya memerlukan GPU untuk menggunakan API LLM?
Tidak. Penyedia menjalankan model di GPU miliknya sendiri; Anda cukup mengirim permintaan HTTP dan membayar per token.