Руководство по API LLM (2026): что это, как работает, цены и лучшие провайдеры
API LLM — это веб-эндпоинт, через который ваш код отправляет промпт большой языковой модели и получает сгенерированный текст, JSON или вызовы инструментов с оплатой за токены. Для обращения к нему нужен HTTP-запрос с API-ключом, названием модели и вашими сообщениями. Так вы получаете доступ к GPT, Claude, Gemini, DeepSeek или Qwen без необходимости запускать собственные GPU. В октябре 2026 года цены варьируются от $0.10 за миллион входных токенов у небольших моделей до $10 у самых крупных.
Это руководство для разработчиков и независимых создателей продуктов, которые выбирают свой первый или следующий API LLM. В нём разобраны устройство запроса, готовые к запуску примеры на curl, Python и Node.js, актуальные официальные цены основных провайдеров, бесплатные варианты, критерии выбора провайдера и ситуации, когда единый API удобнее отдельных аккаунтов.
Что такое API в контексте LLM?
API (интерфейс прикладного программирования) — это набор правил, по которым ваша программа взаимодействует с другим сервисом. Для большой языковой модели API определяет:
- Эндпоинт: URL, на который отправляются запросы, например
/v1/chat/completionsили/v1/messages. - Аутентификацию: API-ключ в заголовке, привязанный к вашему аккаунту и оплате.
- Формат запроса: идентификатор модели, список сообщений (system, user, assistant) и параметры, такие как
max_tokens,temperature, инструменты и формат ответа. - Формат ответа: сгенерированный текст или структурированный результат, а также данные об использовании токенов для расчёта стоимости.
- Лимиты: количество запросов и токенов в минуту, размер контекстного окна и максимальную длину ответа.
Сама модель работает на GPU провайдера. Вы не скачиваете веса, а оплачиваете инференс по мере выполнения запросов. В этом главное отличие от самостоятельного размещения открытой модели с помощью таких инструментов, как vLLM или Ollama.
Как работает API LLM: по шагам
- Ваше приложение формирует запрос с названием модели и текущей историей диалога.
- Провайдер разбивает текст на токены (один токен — это примерно от 3 до 4 символов английского текста).
- Модель генерирует токены ответа по одному и при необходимости передаёт их потоком через server-sent events.
- Ответ содержит текст и объект
usageс количеством входных и выходных токенов. - Стоимость рассчитывается так: входные токены x цена входных токенов + выходные токены x цена выходных токенов.
API не хранит состояние, поэтому при каждом вызове вы заново отправляете нужную историю диалога. Именно поэтому длинные чаты обходятся дороже, а скидки на кеширование промптов имеют значение.
Пример работы с API LLM: ваш первый запрос
Большинство провайдеров теперь принимают формат чата OpenAI, поэтому он стал стандартом де-факто. Этот пример обращается напрямую к OpenAI:
curl https://api.openai.com/v1/chat/completions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      {"role": "system", "content": "You are a concise assistant."},
      {"role": "user", "content": "Explain what an LLM API is in one sentence."}
    ],
    "max_tokens": 100
  }'
Тот же запрос на Python с официальным пакетом openai. Заменив base_url и ключ, вы можете обращаться к любому провайдеру с поддержкой формата OpenAI, в том числе к маршрутизатору вроде Flatkey (быстрый старт):
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_KEY",
    base_url="https://router.flatkey.ai/v1",  # or https://api.openai.com/v1
)

resp = client.chat.completions.create(
    model="claude-sonnet-5-5",  # any model ID from the provider's catalog
    messages=[{"role": "user", "content": "Give me 3 names for a todo app."}],
    max_tokens=200,
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens, completion_tokens -> what you pay for
А вот пример на Node.js 18+ с обычным fetch и потоковой передачей:
const res = await fetch("https://router.flatkey.ai/v1/chat/completions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.FLATKEY_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    model: "gemini-4-argon",
    stream: true,
    messages: [{ role: "user", content: "Write a haiku about APIs." }],
  }),
});
const decoder = new TextDecoder();
for await (const chunk of res.body) process.stdout.write(decoder.decode(chunk));
У Anthropic и Google также есть собственные форматы (Messages API и Gemini API) с функциями, специфичными для каждого провайдера, но к обоим можно обращаться и через слои совместимости с OpenAI.
Лучшие провайдеры API LLM в 2026 году с официальными ценами
Ниже приведены цены за миллион токенов (входные / выходные) с официальных страниц провайдеров по состоянию на 23 октября 2026 года.
| Провайдер | Флагманская модель | Сбалансированная модель | Бюджетная модель | Примечания |
|---|---|---|---|---|
| OpenAI | gpt-6-astra $10 / $50 | gpt-6.1-sol $2 / $10 | gpt-6-luna $0.10 / $0.50 | Режимы Batch и Flex снижают цены на 50% |
| Anthropic Claude | Opus 5.5 $4 / $20 | Sonnet 5.5 $2 / $10 | Haiku 5.5 $0.10 / $0.50 (промпты до 100K) | Контекст 1M по стандартной цене у моделей 4.6+, кроме Haiku 5.5 |
| Google Gemini | Gemini 4 Argon $2 / $10 до 30 ноября 2026 года включительно ($4 / $20 с 1 декабря) | Gemini 3.8 Flash $0.75 за входные токены до 31 декабря 2026 года включительно | Модели Flash-Lite | Бесплатный тариф для моделей Flash; Argon на бесплатном тарифе недоступна |
| DeepSeek | deepseek-v4-pro $1.32 / $3.96 в пиковые часы, $0.66 / $1.98 вне пиковых часов | нет | deepseek-flash $0.30 / $1.20 в пиковые часы, $0.15 / $0.60 вне пиковых часов | Попадания в кеш от $0.003 |
| OpenRouter | Прайсовые цены провайдеров | Комиссия 5.5% при пополнении баланса (тариф Standard) | ||
| Flatkey | например, Kimi K3 $1.80 / $9 (по прайсу $3 / $15) | например, Claude Sonnet 5.5 $1.60 / $8 | например, gpt-6-luna $0.06 / $0.30 | Один ключ для 80+ моделей; цены со страниц моделей |
Цены Flatkey взяты со страниц моделей по состоянию на 23 октября 2026 года: там указаны как тариф Flatkey, так и прайсовая цена провайдера. Подробную разбивку по моделям, включая скидки на кеширование и пакетную обработку, смотрите в нашем сравнении цен на API ИИ.
Какой API LLM самый дешёвый?
Среди небольших быстрых моделей самые низкие официальные прайсовые цены в октябре 2026 года были у OpenAI gpt-6-luna и Claude Haiku 5.5: $0.10 за входные / $0.50 за выходные токены на миллион. У deepseek-flash цена составляла $0.15 / $0.60 вне пиковых часов DeepSeek. Пример: 10,000 запросов в день по 1,000 входных и 300 выходных токенов каждый — это 300M входных и 90M выходных токенов в месяц, или около $75 по прайсовым ценам gpt-6-luna. API пакетной обработки, кеширование промптов и работа вне пиковых часов могут сократить эту сумму ещё вдвое.
Есть ли бесплатные API LLM?
Да, с ограничениями. В Gemini API от Google есть бесплатный тариф для моделей Flash (данные использования могут применяться для улучшения продуктов Google), а некоторые маршрутизаторы предоставляют бесплатные модели с ограничением частоты запросов. Бесплатные тарифы подходят для прототипов, но допускают лишь небольшое количество запросов в день. Посмотрите наш список бесплатных API LLM в 2026 году.
Как выбрать API LLM
| Вопрос | Почему это важно | Что проверить |
|---|---|---|
| Насколько качественным должен быть результат? | Флагманские модели могут стоить в 50–100 раз дороже бюджетных | Протестируйте от 20 до 50 реальных промптов на моделях двух-трёх ценовых категорий |
| Насколько длинные у вас промпты? | Длинный контекст увеличивает затраты на входные токены | Размер контекстного окна и цены для длинных промптов (например, Haiku 5.5 свыше 100K) |
| Как быстро должен приходить ответ? | Пользователи замечают задержку до первого токена | Поддержку потоковой передачи и задержку в вашем регионе |
| Какой объём запросов ожидается? | Лимиты действуют на минуту и на день | RPM/TPM для каждого тарифа; см. наше руководство по лимитам запросов к LLM |
| Нужны ли вам инструменты или JSON? | Работа агентов зависит от вызова функций | Поддержку вызовов инструментов и структурированного вывода |
| Где обрабатываются данные? | Это важно для соблюдения требований и договоров с клиентами | Сроки хранения данных, региональные эндпоинты (инференс Claude только в США стоит в 1.1x дороже) |
| Планируете ли вы менять модели? | Цены и лидеры меняются каждые несколько месяцев | Совместимость с форматом OpenAI или наличие единого API |
Прямое подключение к провайдеру или единый API LLM
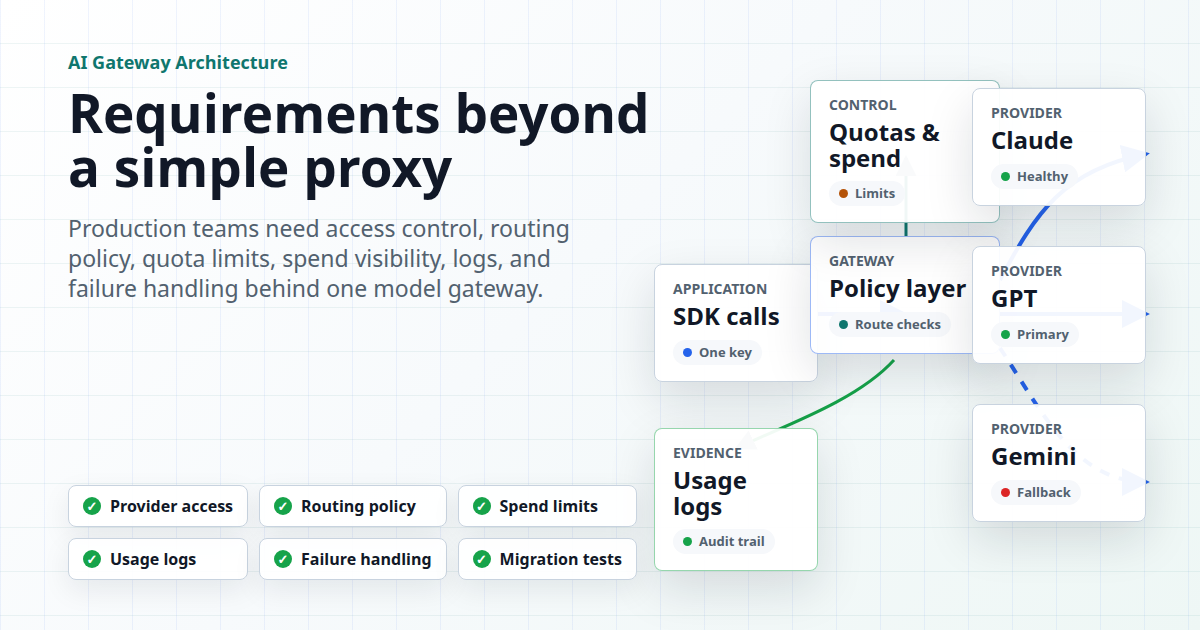
Обращаться напрямую к одному провайдеру проще всего, если вы используете одно семейство моделей. Когда вы начинаете сочетать разные модели, единый API (его также называют маршрутизатором LLM или шлюзом LLM) сокращает объём работы:
- Один ключ и один баланс вместо отдельных аккаунтов, счетов и лимитов запросов у каждого провайдера.
- Смена модели заменой одной строки, без замены SDK.
- Переключение на резервную модель, если один из провайдеров недоступен или достигнут лимит запросов.
- Единый журнал использования для учёта затрат по функциям или клиентам.
Среди вариантов — облачные маршрутизаторы (OpenRouter, Flatkey, Vercel AI Gateway) и прокси для самостоятельного размещения, такие как LiteLLM. Облачные маршрутизаторы различаются в основном комиссиями: OpenRouter использует прайсовые цены провайдеров и взимает комиссию 5.5% за пополнение баланса на тарифе Standard, а на страницах моделей Flatkey для многих моделей указаны тарифы ниже прайсовых цен провайдеров. Сравните их в нашем обзоре альтернатив OpenRouter и объяснении единого API ИИ.
Когда API LLM нужен, а когда можно обойтись без него
Используйте API LLM, когда от результата зависят реальные пользователи, вам нужно больше одной модели, затраты необходимо учитывать по функциям или клиентам либо вы создаёте агентов, вызывающих инструменты. Самостоятельное размещение подходит, если данные должны оставаться на вашем оборудовании, нужна дообученная открытая модель при стабильно высокой нагрузке или требуется работа без подключения к сети. В нашем руководстве об одном API-ключе для нескольких моделей ИИ показано, как небольшие команды настраивают такую схему без отдельной платформенной команды.
Частые ошибки
- Жёстко прописывать один идентификатор модели по всему коду. Вынесите его в конфигурацию, чтобы модель можно было сменить.
- Не учитывать выходные токены. Обычно они стоят в 4–5 раз дороже входных; ограничивайте
max_tokens. - Повторно отправлять огромную историю. Сокращайте или кешируйте длинные системные промпты.
- Не предусматривать повторные попытки. Ошибки 429 и 5xx случаются; добавьте повторы с увеличением задержки (см. наше руководство по превышению лимита запросов API).
- Коммитить ключи в git. Используйте переменные окружения и регулярно меняйте ключи.
Частые вопросы
Что такое API в контексте LLM?
Это интерфейс, через который ваш код отправляет промпты большой языковой модели и получает результат. Он определяет URL эндпоинта, аутентификацию с помощью API-ключа, формат запросов и ответов, лимиты запросов и оплату за токены.
ChatGPT — это LLM или NLP?
В определённом смысле и то и другое. Обработка естественного языка (NLP) — это область, большие языковые модели — один из типов моделей NLP, а ChatGPT — пользовательский продукт на основе LLM от OpenAI. Разработчики получают доступ к тому же семейству моделей через OpenAI API, а не через приложение ChatGPT.
Какие API LLM лучшие?
В октябре 2026 года основные варианты — OpenAI (семейство GPT-6), Anthropic (семейство Claude 5.5), Google (Gemini 4 Argon и модели Flash), DeepSeek (V4 Pro и Flash), а также единые API, такие как OpenRouter и Flatkey, которые дают доступ ко многим провайдерам через один ключ.
Какой API LLM самый дешёвый?
По официальным прайсовым ценам на 23 октября 2026 года OpenAI gpt-6-luna и Claude Haiku 5.5 стоят $0.10 за миллион входных токенов и $0.50 за миллион выходных токенов, а deepseek-flash — $0.15 / $0.60 вне пиковых часов. При небольших объёмах бесплатный тариф Gemini обходится ещё дешевле.
Есть ли бесплатный API LLM?
Да. Gemini API от Google предлагает бесплатный тариф для моделей Flash с суточными лимитами, а некоторые маршрутизаторы предоставляют бесплатные модели с ограничением частоты запросов. Учитывайте жёсткие лимиты и возможные условия использования ваших данных.
Чем API LLM отличается от шлюза LLM?
API LLM — это эндпоинт одного провайдера для доступа к его моделям. Шлюз или маршрутизатор LLM работает перед несколькими провайдерами и предоставляет один ключ, один формат, маршрутизацию, переключение на резервную модель и единый биллинг.
Нужен ли GPU для использования API LLM?
Нет. Провайдер запускает модель на собственных GPU; вы лишь отправляете HTTP-запросы и платите за токены.