Claude API Tools:面向生产代理的评估框架
如果你在搜索 Claude API tools,通常并不是在找一个玩具演示。你真正想判断的是 Claude 的工具使用栈是否足够支撑真实工作流:它要能调用函数、处理重试、保持在预算内,并且在输出需要驱动另一个系统时依然表现良好。
这才是正确的问题。Claude 目前的文档将客户端工具、服务器工具、严格工具使用和并行工具使用区分开来。实际工作是评估这些部分在你的产品开始承载流量之前是否适配。
Claude API tools 到底指什么
在 Anthropic 的文档中,工具使用是允许 Claude 调用你定义或 Anthropic 提供的工具的功能。模型会根据请求决定何时调用工具,然后返回一个结构化的 tool_use 块,由你的应用执行,或者对于服务器工具由 Anthropic 执行。
这意味着 Claude API tools 可以涵盖几种不同的内容:
- 在你的应用中运行的用户自定义客户端工具;
- Anthropic 定义的客户端风格工具,例如
bash和text_editor; - 服务器工具,例如
web_search、web_fetch、code_execution和tool_search; - 当你的工作流依赖远程工具系统时使用的 MCP 连接工具;
- 当一个轮次可能需要多次工具调用时使用的并行工具使用。
如果你不区分这些情况,评估很快就会变得混乱。一个在笔记本里看起来很棒的工具集,到了生产环境里仍然可能失败,因为执行路径、延迟特征或定价模型不同。
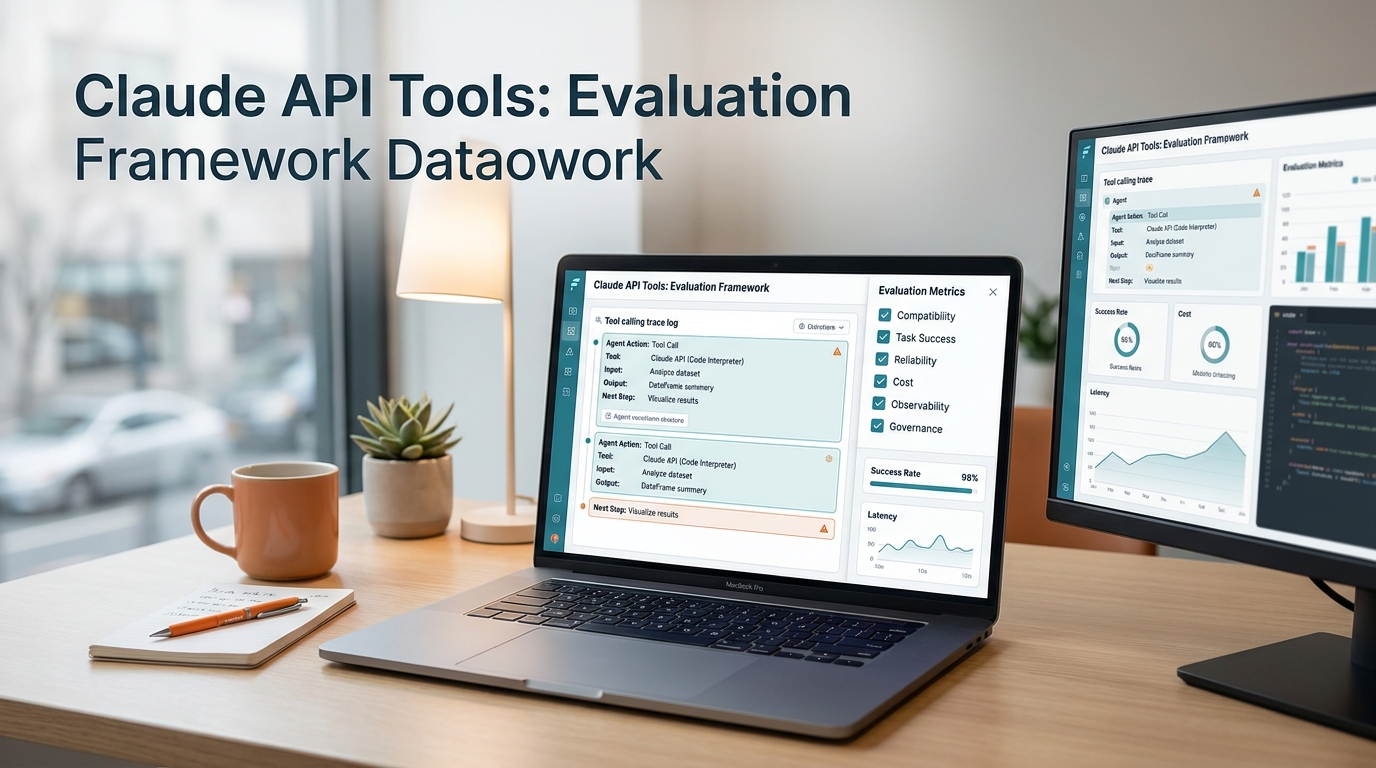
评估框架
为每一次 Claude API tools 上线使用同一套评分卡。
| 维度 | 测试内容 | 通过标准 |
|---|---|---|
| 兼容性 | SDK、基础 URL、认证、schema 和工具定义 | 应用无需频繁适配器修改即可调用工具 |
| 任务成功率 | 针对真实工作流的真实提示词 | 工具结果足够准确,可以上线 |
| 可靠性 | 重试、超时、并行调用和回退行为 | 故障会以可预测的方式降级,而不是级联扩散 |
| 成本 | 工具定义、工具结果和服务端工具费用 | 你可以估算每个成功任务的支出 |
| 可观测性 | 日志、使用情况和成本报告 | 你可以回答谁在何时调用了什么,以及为什么 |
| 治理 | 密钥、权限、写入类工具和审批流程 | 危险操作需要明确控制 |
重点不是抽象地给 Claude 打分。重点是判断 Claude API tools 能否作为生产基础设施运行。
1. 兼容性
先从那些最不起眼的部分开始。
你的工具定义应使用窄范围的名称、明确的描述,以及能够在应用中通过验证的 schema。如果你的工作流依赖严格的形状,那么应尽早测试严格的工具使用,而不是在发布之后。
检查这些项目:
- 客户端是否能干净地发送
tools负载? - 当
tool_choice设置为auto时,行为是否符合预期? - 必需字段是否以代码所期望的形状到达?
- 你的应用能否处理
tool_use和tool_result,而不需要自定义解析技巧? - 如果你使用 MCP 或服务器工具,执行边界是否仍然清晰?
如果这一层很薄弱,其余评估就都没有意义。兼容性是守住 Claude API tools 其余部分不变成维护问题的门槛。
2. 任务成功
工具使用只有在完成实际工作时才有价值。
测试真实任务,而不是空洞的提示词。一个好的评估集通常包括:
- 干净输入;
- 边界情况输入;
- 缺失字段;
- 含糊不清的请求;
- 长上下文请求;
- 如果你的产品需要,多语言提示词;
- 会触发不止一个工具的情况。
按工作流结果来评估,而不是看文本听起来有多流畅。例如:
- 工具调用是否选择了正确的函数?
- 参数是否合理?
- 结果是否与源系统一致?
- 模型在错误的工具结果之后是否能顺利恢复?
这正是大多数 Claude API tools 页面会跳过的部分。它们止步于能力,但生产环境关心的是通过率。
3. 可靠性
工具使用会创建第二个失败面:工具本身。
你的测试计划应包括:
| 失败模式 | 需要验证什么 |
|---|---|
| 缺少参数 | Claude 请求缺失字段或做出合理拒绝 |
| 工具缓慢 | 工作流遵守超时和重试预算 |
| 工具错误 | 应用在 tool_result 失败时不会陷入循环 |
| 并行工具调用 | 多次调用不会破坏状态机 |
| 服务器工具失败 | 响应仍能以受控方式降级 |
| 提示注入 | 不受信任的工具输出不会覆盖策略 |
Anthropic 的文档也明确了边界:客户端工具在你的应用中运行,服务器工具在 Anthropic 基础设施上运行。这意味着你对两侧的失败模型应该不同。一个在某种模式下可靠的工具系统,在另一种模式下可能并不可靠。
4. 成本
Claude API tools 最主要的成本错误,是只计算基础模型调用。
Anthropic 的定价文档说明,工具使用的计费基于输入 tokens、输出 tokens,以及服务器端工具的任何额外按用量收费。tools 负载本身也会增加 tokens,tool_use 和 tool_result 块也是如此。
这意味着你的实际成本模型应包括:
- 提示词;
- 工具定义;
- 工具调用往返;
- 重试;
- 任何服务器端工具费用;
- 错误后的回退调用。
如果你只衡量最顺利的路径,就会少算。若你的工作流大量依赖工具,那么每个已接受任务的成本比每次原始请求的成本更适合作为指标。
5. 可观测性
你无法运维你看不见的东西。
至少要记录:
- 请求 ID;
- 模型;
- 工具名称;
- 工具参数;
- 延迟;
- 重试次数;
- 成功或失败状态;
- 工作区或用户键;
- 该调用是否使用了服务器工具。
Anthropic 的 Usage and Cost Admin API 在这里很重要,因为它允许组织以编程方式查看使用情况和成本,并可按工作区或描述进行分组。当 Claude API tools 从单个开发者变成整个团队都依赖的能力时,这就是正确的兜底方案。
6. 治理
很多团队会在这里掉以轻心。
将读工具与写工具分开。对任何会创建、删除、付款、发货或发送的操作都要加入审批。不要让模型因为“能提出一次调用”就自行决定策略。
最低治理检查清单:
- 谁可以定义工具?
- 谁可以批准写工具?
- 哪些工具是只读的?
- 哪些工具需要确认?
- 哪些环境可以调用生产工具?
- 密钥如何轮换和撤销?
如果你的团队无法回答这些问题,Claude API tools 还不适合大规模上线。
一个简单评分卡
对每个工作流使用这份 14 分评分卡:
| 测试 | 分数 |
|---|---|
| 选择了正确的工具 | 0-2 |
| 包含所需参数 | 0-2 |
| 输出被下游系统接受 | 0-2 |
| 工具出错后的恢复 | 0-2 |
| 并行工具行为 | 0-2 |
| 成本保持在预算内 | 0-2 |
| 日志可供审查 | 0-2 |
得分达到 11 分或以上即可上线。如果某个工作流低于这个分数,那么在增加流量之前,先修复工具契约或策略边界。
Flatkey 的定位
当 Claude API tools 是更大 AI 技术栈的一部分时,Flatkey 是一个有用的对比参照面。
当前的 Flatkey 页面介绍了一个 key、一个计费平面、一层路由,以及大量模型和工具目录。当 Claude 只是更广泛生产系统中的一部分,而你希望在一个地方跨提供商查看支出、路由和使用情况时,这一点就很重要。
如果你仍在判断问题是否出在路由本身,先看 AI API 清单。如果真正的问题是如何在多个提供商之间保持单一控制平面,接下来可以查看 AI API 网关架构 和 定价。对于已经感受到计费和使用情况漂移的团队,统一 AI 计费 指南是下一篇相关阅读。
决策规则
当工作流足够小、便于测试,足够明确、便于治理,并且足够可见、便于运维时,就使用 Claude API tools。在兼容性、任务成功率、可靠性、成本、可观测性和治理全部同时通过之前,不要把工具使用推进到生产环境。
这才是重要的评估框架。模型不是产品,工具契约才是。
常见问题
Claude API tools 和 function calling 是一回事吗?
不完全是。Function calling 是机制。Claude API tools 包括这一机制,以及其周边的执行、策略和可观测性选择。
客户端工具和服务器工具应该以相同方式测试吗?
不。客户端工具在你的应用中运行,而服务器工具在 Anthropic 基础设施上运行。应分别对它们进行测试。
团队什么时候应该添加网关?
当你需要在多个提供商或工具系列之间提供一个路由入口、一个使用视图或一个计费层时,就应添加网关。