Claude API Tools: Kerangka Evaluasi untuk Agen Produksi
Jika Anda mencari Claude API tools, biasanya Anda tidak sedang mencari demo mainan. Anda sedang mencoba memutuskan apakah tumpukan penggunaan tool Claude cukup baik untuk alur kerja nyata: yang memanggil fungsi, menangani percobaan ulang, tetap sesuai anggaran, dan tetap berperilaku baik saat output harus menggerakkan sistem lain.
Itulah pertanyaan yang tepat. Dokumentasi Claude saat ini memisahkan client tools, server tools, strict tool use, dan parallel tool use. Tugas praktisnya adalah mengevaluasi apakah bagian-bagian itu cocok dengan produk Anda sebelum lalu lintas bergantung padanya.
Apa sebenarnya arti Claude API tools
Dalam dokumentasi Anthropic, tool use adalah fitur yang memungkinkan Claude memanggil tool yang Anda definisikan atau yang disediakan Anthropic. Model memutuskan kapan memanggil sebuah tool dari permintaan, lalu mengembalikan blok tool_use terstruktur yang dieksekusi oleh aplikasi Anda atau dieksekusi oleh Anthropic untuk server tools.
Artinya, Claude API tools dapat mencakup beberapa hal berbeda:
- tool buatan pengguna sebagai client yang berjalan di aplikasi Anda;
- tool gaya client yang ditentukan Anthropic seperti
bashdantext_editor; - server tools seperti
web_search,web_fetch,code_execution, dantool_search; - tool yang terhubung lewat MCP ketika alur kerja Anda bergantung pada sistem tool jarak jauh;
- penggunaan tool paralel ketika satu giliran mungkin memerlukan lebih dari satu panggilan tool.
Jika Anda tidak memisahkan kasus-kasus itu, evaluasi Anda akan cepat menjadi kabur. Sekumpulan tool yang tampak hebat di notebook masih bisa gagal di produksi karena jalur eksekusi, profil latensi, atau model harga berbeda.
Kerangka evaluasi
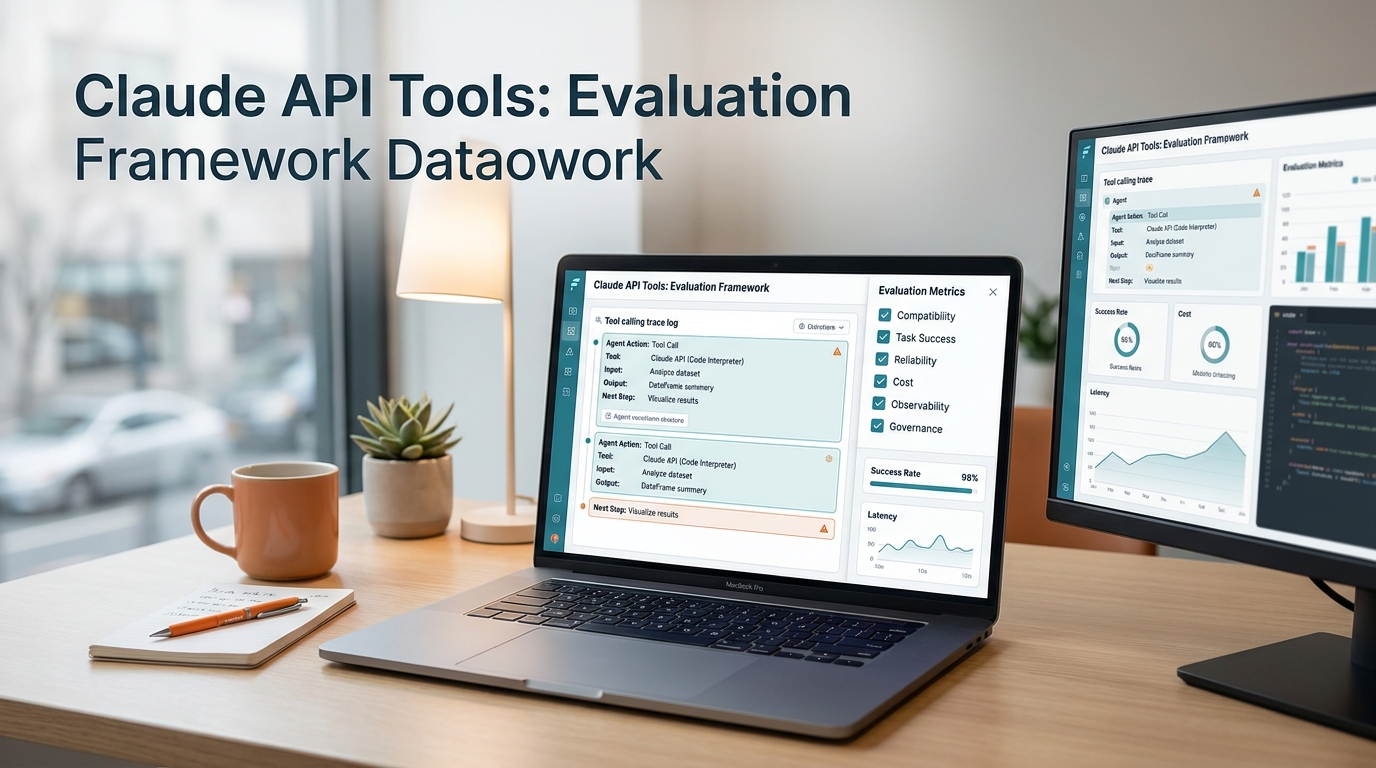
Gunakan satu kartu penilaian untuk setiap peluncuran Claude API tools.
| Dimensi | Apa yang diuji | Tampilan lulus |
|---|---|---|
| Kompatibilitas | SDK, base URL, autentikasi, skema, dan definisi tool | Aplikasi dapat memanggil tool tanpa perlu perubahan adapter |
| Keberhasilan tugas | Prompt nyata terhadap alur kerja nyata | Hasil tool cukup akurat untuk dirilis |
| Keandalan | Percobaan ulang, time-out, panggilan paralel, dan perilaku fallback | Kegagalan menurun secara terprediksi alih-alih merambat |
| Biaya | Definisi tool, hasil tool, dan biaya tool di sisi server | Anda dapat memperkirakan pengeluaran per tugas yang berhasil |
| Observabilitas | Log, penggunaan, dan pelaporan biaya | Anda dapat menjawab siapa memanggil apa, kapan, dan mengapa |
| Tata kelola | Kunci, izin, tool tulis, dan alur persetujuan | Tindakan berbahaya memerlukan kontrol eksplisit |
Tujuannya bukan memberi skor Claude secara abstrak. Tujuannya adalah memutuskan apakah Claude API tools dapat beroperasi sebagai infrastruktur produksi.
1. Kompatibilitas
Mulailah dari hal-hal yang membosankan.
Definisi alat Anda sebaiknya menggunakan nama yang sempit, deskripsi yang eksplisit, dan skema yang lolos validasi di aplikasi Anda. Jika alur kerja Anda bergantung pada bentuk yang ketat, uji penggunaan alat secara ketat sejak awal, bukan setelah peluncuran.
Periksa item berikut:
- Apakah klien mengirim payload
toolsdengan benar? - Apakah
tool_choiceberperilaku sesuai harapan saat disetel keauto? - Apakah field yang wajib tiba dalam bentuk yang diharapkan kode Anda?
- Apakah aplikasi Anda dapat menangani
tool_usedantool_resulttanpa trik parsing khusus? - Jika Anda menggunakan MCP atau server tools, apakah batas eksekusinya masih jelas?
Jika lapisan ini lemah, evaluasi lainnya tidak menjadi masalah. Kompatibilitas adalah gerbang yang mencegah sisanya dari Claude API tools menjadi masalah pemeliharaan.
2. Keberhasilan tugas
Penggunaan alat hanya berguna jika benar-benar menyelesaikan pekerjaan aktual.
Uji tugas nyata, bukan prompt untuk pencitraan. Set evaluasi yang baik biasanya mencakup:
- input yang bersih;
- input kasus ekstrem;
- field yang hilang;
- permintaan yang ambigu;
- permintaan dengan konteks panjang;
- prompt multibahasa jika produk Anda membutuhkannya;
- kasus yang memicu lebih dari satu alat.
Beri skor hasil berdasarkan outcome alur kerja, bukan seberapa lancar teksnya terdengar. Misalnya:
- Apakah panggilan alat memilih fungsi yang tepat?
- Apakah argumennya masuk akal?
- Apakah hasilnya cocok dengan sistem sumber?
- Apakah model pulih dengan bersih setelah hasil alat yang buruk?
Itulah bagian yang paling sering dilewatkan oleh halaman Claude API tools. Mereka berhenti di kapabilitas, tetapi produksi peduli pada acceptance rate.
3. Keandalan
Penggunaan alat menciptakan permukaan kegagalan kedua: alat itu sendiri.
Rencana pengujian Anda harus mencakup:
| Mode kegagalan | Yang perlu diverifikasi |
|---|---|
| Parameter hilang | Claude meminta field yang hilang atau memberikan penolakan yang wajar |
| Alat lambat | Alur kerja mematuhi batas waktu dan anggaran retry |
| Kesalahan alat | Aplikasi menangani kegagalan tool_result tanpa looping |
| Panggilan alat paralel | Beberapa panggilan tidak merusak state machine |
| Kegagalan server tool | Respons tetap menurun dengan cara yang terkendali |
| Prompt injection | Output alat yang tidak tepercaya tidak menimpa kebijakan |
Dokumentasi Anthropic juga memperjelas batasnya: client tools berjalan di aplikasi Anda, server tools berjalan di infrastruktur Anthropic. Artinya model kegagalan Anda harus berbeda untuk setiap sisi. Sistem alat yang andal dalam satu mode belum tentu andal dalam mode lainnya.
4. Biaya
Kesalahan biaya utama dengan Claude API tools adalah hanya menghitung panggilan model dasar.
Dokumentasi harga Anthropic menyebutkan bahwa penggunaan alat dihargai dari token input, token output, dan biaya tambahan berbasis penggunaan untuk server-side tools. Payload tools itu sendiri juga menambah token, begitu juga blok tool_use dan tool_result.
Itu berarti model biaya aktual Anda harus mencakup:
- prompt;
- definisi alat;
- round trip panggilan alat;
- retry;
- biaya alat di sisi server apa pun;
- fallback calls setelah error.
Jika Anda hanya mengukur jalur yang mulus, Anda akan menghitung terlalu sedikit. Jika alur kerja Anda sangat bergantung pada tool, biaya per tugas yang diterima adalah metrik yang lebih baik daripada biaya per permintaan mentah.
5. Observabilitas
Anda tidak bisa mengoperasikan sesuatu yang tidak bisa Anda lihat.
Setidaknya, catat:
- request ID;
- model;
- nama tool;
- argumen tool;
- latensi;
- jumlah percobaan ulang;
- status berhasil atau gagal;
- workspace atau kunci pengguna;
- apakah panggilan tersebut menggunakan server tool.
API Admin Penggunaan dan Biaya dari Anthropic penting di sini karena memungkinkan organisasi meninjau penggunaan dan biaya secara terprogram, dengan pengelompokan berdasarkan workspace atau deskripsi. Itulah pengaman terakhir yang tepat ketika Claude API tools bergeser dari dipakai satu developer menjadi ketergantungan di seluruh tim.
6. Tata Kelola
Di sinilah banyak tim menjadi ceroboh.
Pisahkan tool baca dari tool tulis. Berikan persetujuan untuk apa pun yang membuat, menghapus, membayar, mengirim, atau meluncurkan. Jangan biarkan model menentukan kebijakan hanya karena ia bisa mengusulkan sebuah panggilan.
Daftar periksa tata kelola minimum:
- Siapa yang dapat mendefinisikan tool?
- Siapa yang dapat menyetujui tool tulis?
- Tool mana yang hanya-baca?
- Tool mana yang memerlukan konfirmasi?
- Lingkungan mana yang dapat memanggil tool produksi?
- Bagaimana kunci diputar dan dicabut?
Jika tim Anda tidak bisa menjawab pertanyaan-pertanyaan itu, Claude API tools belum siap untuk penerapan luas.
Kartu skor sederhana
Gunakan kartu skor 14 poin ini untuk setiap alur kerja:
| Uji | Skor |
|---|---|
| Tool yang dipilih benar | 0-2 |
| Argumen yang diperlukan tersedia | 0-2 |
| Output diterima oleh sistem downstream | 0-2 |
| Pemulihan setelah error tool | 0-2 |
| Perilaku tool paralel | 0-2 |
| Biaya tetap berada dalam anggaran | 0-2 |
| Log dapat ditinjau | 0-2 |
Rilis jika nilainya 11 atau lebih tinggi. Jika suatu alur kerja berada di bawah itu, perbaiki kontrak tool atau batas kebijakan sebelum Anda meningkatkan trafik.
Di mana Flatkey berperan
Flatkey adalah permukaan perbandingan yang berguna ketika Claude API tools menjadi bagian dari stack AI yang lebih besar.
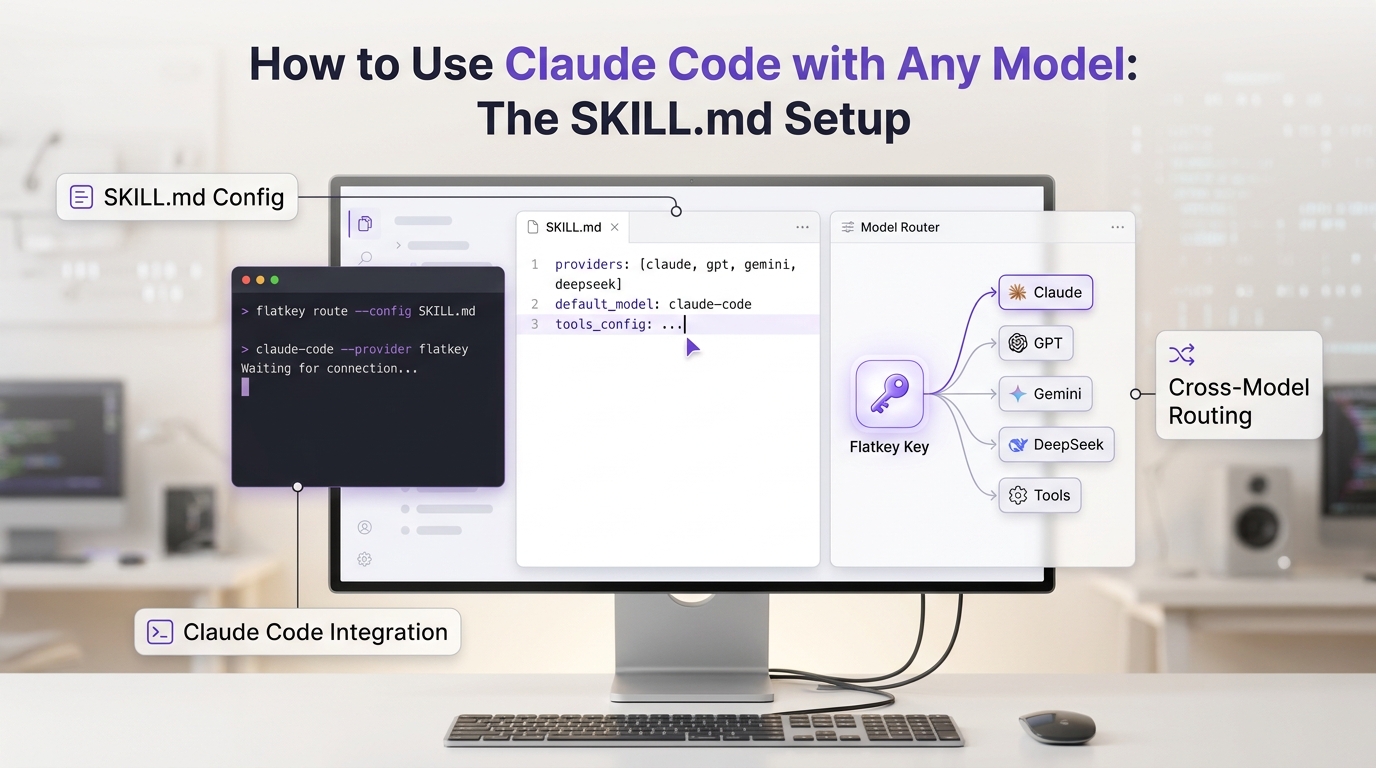
Halaman Flatkey saat ini menjelaskan satu kunci, satu permukaan penagihan, satu lapisan rute, dan katalog model serta tools yang besar. Itu penting ketika Claude hanyalah satu bagian dari sistem produksi yang lebih luas dan Anda menginginkan satu tempat untuk meninjau pengeluaran, routing, dan penggunaan lintas penyedia.
Jika Anda masih mempertimbangkan apakah masalahnya ada pada rutenya sendiri, mulailah dengan daftar periksa AI API. Jika masalah sebenarnya adalah mempertahankan satu control plane lintas penyedia, tinjau arsitektur gateway AI API dan harga berikutnya. Untuk tim yang sudah merasakan pergeseran penagihan dan penggunaan, panduan penagihan AI terpadu adalah bacaan berikutnya yang paling relevan.
Aturan keputusan
Gunakan Claude API tools ketika alur kerja cukup kecil untuk diuji, cukup eksplisit untuk diatur, dan cukup terlihat untuk dioperasikan. Jangan naikkan penggunaan tool ke produksi sampai kompatibilitas, keberhasilan tugas, keandalan, biaya, observabilitas, dan tata kelola semuanya lolos bersama-sama.
Itulah kerangka evaluasi yang penting. Model bukan produknya. Kontrak tool-lah yang menjadi produk.
FAQ
Apakah alat Claude API sama dengan function calling?
Tidak persis. Function calling adalah mekanismenya. Alat Claude API mencakup mekanisme itu plus pilihan eksekusi, kebijakan, dan observabilitas di sekitarnya.
Apakah alat client dan alat server harus diuji dengan cara yang sama?
Tidak. Alat client berjalan di aplikasi Anda, sedangkan alat server berjalan di infrastruktur Anthropic. Uji secara terpisah.
Kapan sebuah tim harus menambahkan gateway?
Tambahkan saat Anda membutuhkan satu permukaan rute, satu tampilan penggunaan, atau satu lapisan penagihan di lebih dari satu penyedia atau keluarga alat.