您的应用程序已经知道如何调用 OpenAI 兼容的客户端。添加模型选择不应要求针对每个提供商都重建那套集成。
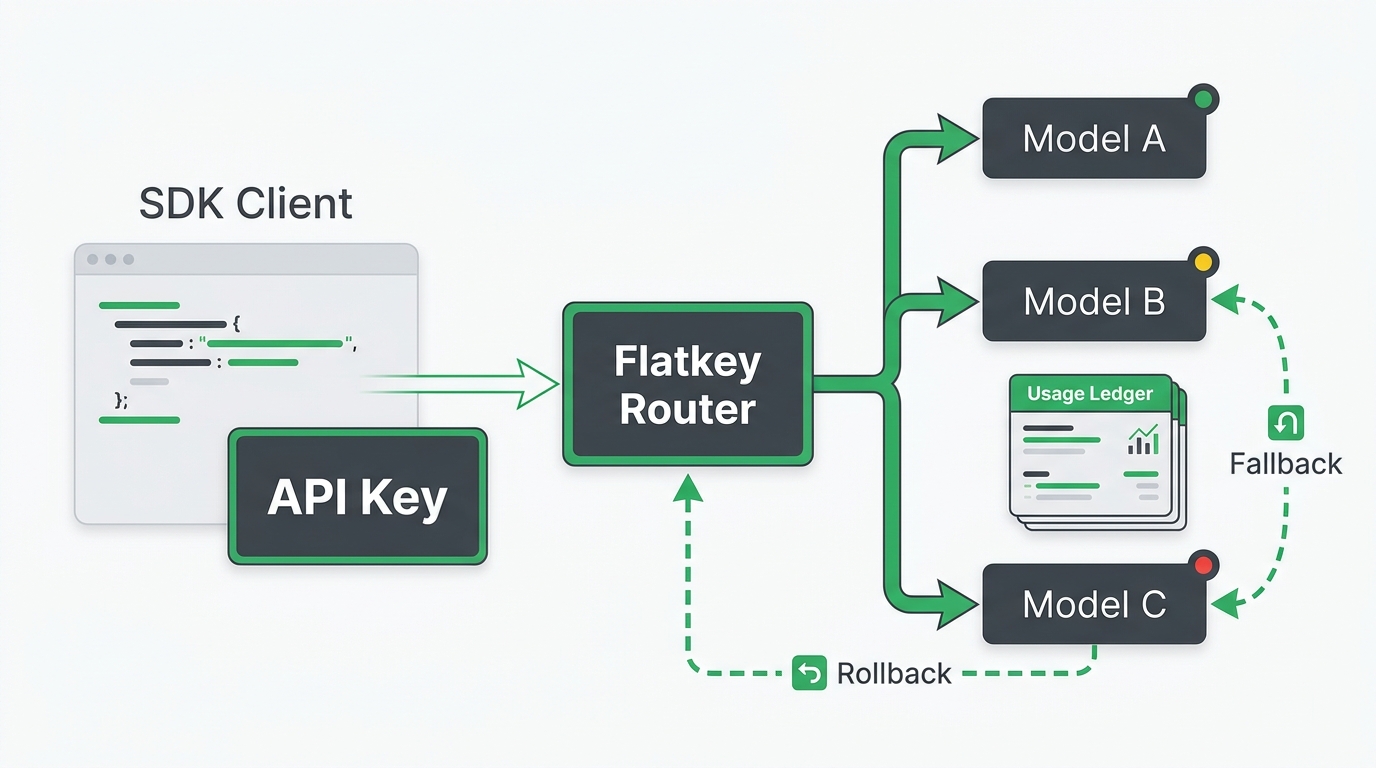
Flatkey 为您提供一个 OpenAI 兼容的 base URL:
https://router.flatkey.ai/v1
将您现有的 OpenAI SDK 客户端指向该 URL,使用 Flatkey API key,并在 model 字段中选择您要测试的模型。您的请求封装器、提示数据集、评估标准以及应用代码都可以继续围绕一个接口展开。
当您的团队已经准备好比较模型,但又不希望特定提供商的账号设置和客户端重写成为评估项目的一部分时,Flatkey 就是一个实用的选择。
从一个模型到候选名单的最低摩擦路径
典型的模型评估始于一个简单的问题:另一种模型能否为这个工作负载提升质量、延迟或成本?
实施工作很快就会盖过这个问题。独立集成会带来各自不同的环境变量、身份验证模式、重试行为、响应适配器、仪表盘以及计费关系。等测试框架准备就绪时,最初的提示实验已经变成了一项基础设施项目。
OpenAI 兼容的 base URL 改变了这个顺序。您保持一个客户端形态,并将模型作为主要变量。
| 保持稳定 | 有意更改 | 按模型验证 |
|---|---|---|
| SDK 和请求封装器 | 一次性设置 base_url |
输出质量 |
| 提示数据集 | 每次运行使用不同的 model |
延迟分布 |
| 评估标准 | 必要时使用特定模型参数 | Token 使用量和成本 |
| 结果存储 | 在有理由时调整超时或重试设置 | 工具和结构化输出行为 |
| 应用侧可观测性 | 仅在评估后进行生产路由 | 错误和拒绝模式 |
目标不是假装每个模型的行为都完全相同。目标是消除可避免的集成差异,让您的团队能把更多时间花在衡量真正重要的差异上。
更改基本 URL,而不是整个 SDK 层
如果您已经在使用 OpenAI Python SDK,那么核心客户端改动很小:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)
同样的模式也适用于 OpenAI JavaScript 客户端:
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});
之后,在请求中使用 Flatkey 当前模型目录中的模型 ID。不要从旧电子表格或文章中硬编码模型假设;模型可用性和能力可能会变化。
response = client.chat.completions.create(
    model=os.environ["EVAL_MODEL_ID"],
    messages=[
        {"role": "system", "content": "使用提供的策略进行回答。"},
        {"role": "user", "content": evaluation_prompt},
    ],
    temperature=0,
    max_tokens=800,
)
这就是核心的采用优势:你的应用可以保留其 OpenAI 兼容客户端,而评估只需更改模型选择。
一个聚焦的多模型提示测试工作流
使用以下工作流,将 base URL 迁移转化为你的团队能够为之辩护的决策。
1. 固定请求契约
从一个已经代表生产工作负载的请求开始。在第一次对比中保持以下内容不变:
- 系统提示和用户提示
- 输入示例
- 温度和 token 限制
- 工具定义或响应 schema
- 超时策略
- 评估标准
如果你同时更改提示、模型和重试策略,你将无法知道是哪一项变化产生了结果。
2. 创建一个小而有代表性的评估集
不要从数百个合成提示开始。先从 20 到 50 个示例入手,覆盖用户实际创建的场景:
- 常见、高频请求
- 较长或杂乱的输入
- 含糊不清的指令
- 对安全敏感或容易触发拒答的场景
- 结构化输出边界情况
- 工具调用场景,如果你的应用使用工具的话
在发送评估流量之前,移除私人数据和密钥。最好的评估集既要足够小,便于检查;又要足够有代表性,能够暴露有意义的失败。
3. 将相同案例通过每个候选模型运行
保持 Flatkey base URL 和请求包装器不变。遍历你的候选名单中的 model ID。
import time

candidate_models = [
    "MODEL_ID_A",
    "MODEL_ID_B",
    "MODEL_ID_C",
]

results = []

for model_id in candidate_models:
    for case in evaluation_cases:
        started_at = time.perf_counter()
        try:
            response = client.chat.completions.create(
                model=model_id,
                messages=case["messages"],
                temperature=0,
                max_tokens=case.get("max_tokens", 800),
            )
            elapsed_ms = round((time.perf_counter() - started_at) * 1000)
            results.append({
                "case_id": case["id"],
                "model": model_id,
                "latency_ms": elapsed_ms,
                "output": response.choices[0].message.content,
                "usage": response.usage.model_dump() if response.usage else None,
                "error": None,
            })
        except Exception as error:
            results.append({
                "case_id": case["id"],
                "model": model_id,
                "latency_ms": None,
                "output": None,
                "usage": None,
                "error": type(error).__name__,
            })
在共享示例中使用占位符,并在运行测试前从实时目录中选择当前模型 ID。还要确认每个候选项都支持你的工作负载所需的能力。
4. 评估结果,而不是模型声誉
一份有用的评分表会将硬性要求与偏好区分开来。
| 维度 | 示例问题 | 建议处理方式 |
|---|---|---|
| 正确性 | 响应是否满足任务要求? | 人工或任务特定评分器 |
| 指令遵循 | 是否遵守了约束和格式? | 通过/未通过加备注 |
| 结构化输出 | 有效载荷是否能解析并匹配架构? | 自动化验证 |
| 工具行为 | 调用是否有效且选择是否恰当? | 自动检查加人工审查 |
| 延迟 | 成功请求耗时多长? | 中位数和尾部百分位 |
| 可靠性 | 请求失败或超时的频率如何? | 按类别统计错误率 |
| 用量 | 报告了多少输入和输出 token? | 按单个案例和汇总统计 |
| 成本 | 评估的工作负载会花费多少? | 按当前定价计算 |
即使某个候选项很便宜,只要它不满足硬性要求,就应当拒绝它。在剩余模型中,比较对你的产品真正重要的取舍。
5. 用生产行为重新测试最终候选
第一轮测试应当受控。最终候选测试应当贴近真实场景。
如果你的界面支持流式输出,就测试流式。如果你的代理使用工具,就测试工具调用。如果下游代码会解析结构化输出,就测试结构化输出。使用你真实的超时和重试设置进行验证,并检查应用如何处理速率限制、中断的流、格式错误的响应以及含糊不清的完成状态。
Flatkey 的 Usage Logs 可以帮助你确认请求是否已到达网关,并查看请求活动。也要保留应用侧的请求 ID 和时间数据,这样你就能把网关可见性与用户体验关联起来。
关于重试和切换细节,请参阅 OpenAI 客户端迁移速率限制和重试指南。
兼容性只是起点,并不保证行为完全一致
OpenAI 兼容 API 降低了客户端迁移工作量,但不会让不同模型变得可互换。
在批准某个模型投入生产之前,请验证:
- 当前确实可用的是准确的模型 ID。
- 该模型支持你需要的端点和模态。
- 必需参数被接受,并且行为符合预期。
- 工具调用、JSON 或结构化输出,以及流式输出都能通过你的测试。
- token 限制适合你的真实输入和输出。
- 安全行为符合你的产品要求。
- 超时、重试和错误处理不会产生重复或含糊不清的工作。
- 当前定价适合预期的流量组合。
如果您需要更全面的工程检查清单,请参阅OpenAI 兼容 API 网关迁移指南。本页的范围刻意更窄:它面向那些已经理解迁移模式,并希望把一次 base-URL 更改变成一场公平的多模型测试的团队。
实用切换检查清单
只有当您能对每一项都回答“是”时,才从评估阶段进入生产阶段。
- 请求一致性: 最终入选模型能与您的真实 prompt、消息、工具和输出模式配合工作。
- 质量阈值: 它通过了您评分标准中的硬性要求。
- 故障处理: 您的应用能够安全地处理速率限制、超时和中断的响应。
- 可观测性: 您记录模型、延迟、用量、错误类别以及应用请求标识符。
- 成本模型: 您已根据当前定价和真实的 token 使用量计算了预期支出。
- 回滚: 您无需发布代码即可回到之前的模型或配置。
- 金丝雀计划: 您可以在全面发布前将变更暴露给一小部分流量。
稳定的接口使回滚和重复测试更容易,因为集成表面保持一致。您的模型决策可以变化,而不必每次都向应用中强行加入新的特定供应商客户端层。
从一个 base URL 和真实工作负载开始
如果您的团队已经在使用 OpenAI 兼容的 SDK,那么下一步有价值的事情不是再进行一次架构争论,而是使用您自己的 prompts 进行受控测试。
- 创建一个 Flatkey 账户和 API key。
- 将
base_url设置为https://router.flatkey.ai/v1。 - 从当前目录中选取一个小型模型候选列表。
- 让每个模型运行相同的代表性案例。
- 一起查看质量、延迟、可靠性、用量和当前成本。
比较当前模型定价并选择您的候选列表,然后使用您的应用已经在用的同一个客户端运行第一次评估。
常见问题
Flatkey 的 OpenAI 兼容 base URL 是什么?
使用 https://router.flatkey.ai/v1。请在您的 OpenAI 兼容客户端中进行配置,并使用 Flatkey API key 进行身份验证。
我需要替换 OpenAI SDK 吗?
不需要。Flatkey 的快速入门文档说明了如何使用 OpenAI Python 和 JavaScript SDK 以及 Flatkey base URL。您仍应测试应用所依赖的每一个请求特性和模型能力。
我可以用相同的 prompt 代码比较多个模型吗?
可以。保持客户端、prompt 数据集和评估逻辑稳定,然后为每个候选模型更改 model 值。特定于模型的能力和参数仍然需要验证。
OpenAI 兼容是否等同于模型行为完全相同?
不等同。兼容性减少的是集成变更。模型在输出质量、工具使用、结构化输出行为、延迟、限制、安全行为和成本方面都可能不同。
在多模型测试中我应该衡量什么?
衡量任务正确性、指令遵循、schema 或工具有效性、延迟、错误率、token 使用量以及当前成本。在比较偏好之前,请先定义硬性要求。
我应该在哪里查看模型价格?
请使用 Flatkey 的实时定价页面,而不是将价格复制到长期使用的评估文档中。