2026 年如何使用统一 AI API
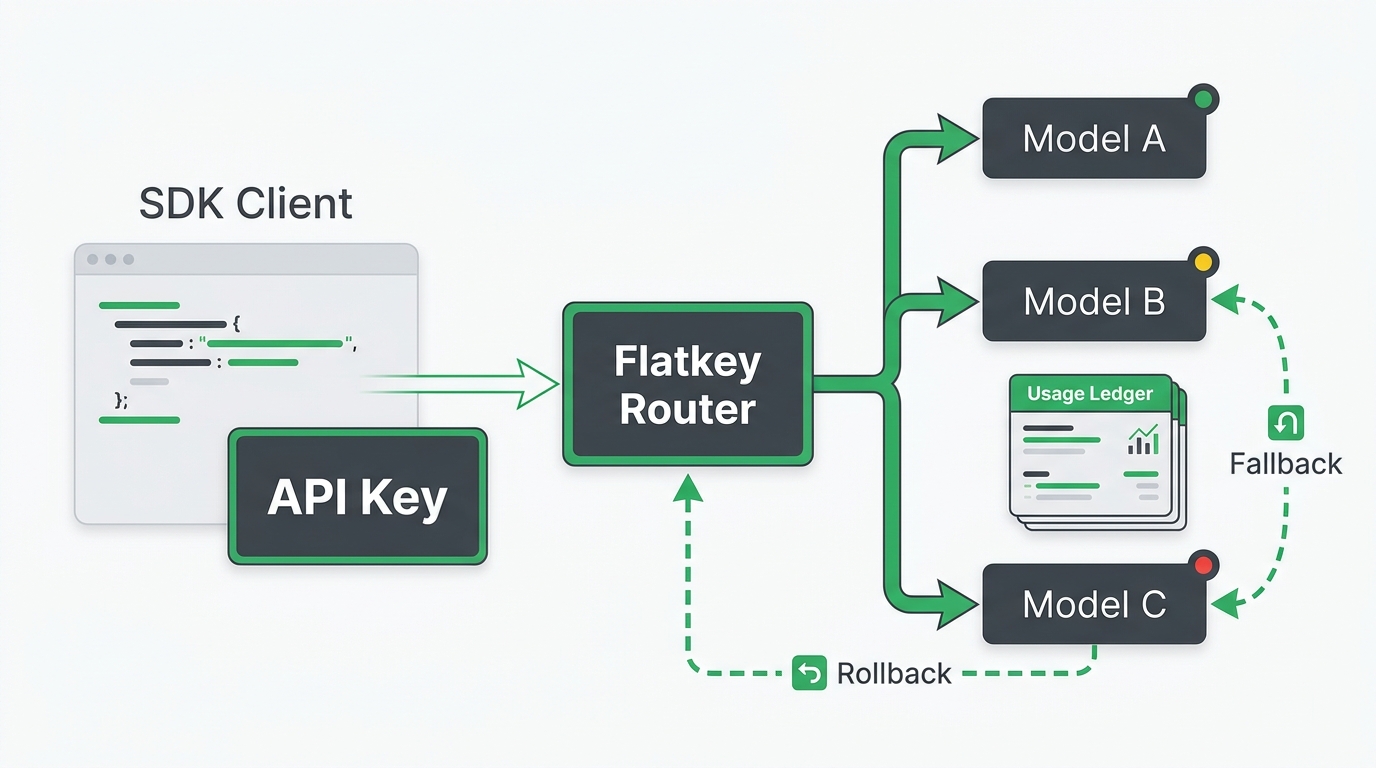
统一 AI API 让你的应用无需为每个提供商分别接入,而是通过一个访问层调用多个 AI 模型提供商。到了 2026 年,这通常意味着一个 API 密钥、一个兼容 OpenAI 的基础 URL、一个模型目录,以及一个用于查看使用情况、成本和故障的统一位置。
这听起来很简单,但实现细节很重要。只有在它能保持你当前的 SDK 工作流不变、让模型切换更安全,并让工程和财务团队在每次请求后看到相同的结果视图时,统一 AI API 才真正有价值。
本指南展示了一条实用的上线路径:设置密钥,将兼容 OpenAI 的客户端指向统一端点,选择模型,发起第一次请求,验证使用日志,然后决定哪些内容应迁移到统一层后面,哪些内容应继续直接对接提供商。
快速回答:统一 AI API 工作流
当你的团队需要测试或运行多个模型,而不想为每个提供商都建立新的集成、计费轨迹和密钥管理流程时,就使用 统一 AI API。
基本工作流如下:
- 为统一网关创建一个 API 密钥。
- 将其存储为环境变量。
- 将客户端的基础 URL 设置为网关端点。
- 发送正常的聊天、响应、嵌入、图像或视频请求。
- 使用
model参数选择模型。 - 检查使用日志中的 token、模型、成本、状态和延迟。
- 仅在第一条路径已具备可观测性之后,再添加回退、配额和路由规则。
对于 Flatkey,兼容 OpenAI 的 REST 基础 URL 是:
https://router.flatkey.ai/v1关键不在于每个模型都表现得完全一样。关键在于,你的应用能获得一个可审计的统一集成入口,同时仍然可以为每个工作负载选择合适的模型。
何时适合使用统一 AI API
当你的团队已经明显感受到提供商碎片化带来的额外负担时,统一 AI API 的优势最明显。
在以下情况使用它:
| 场景 | 统一 AI API 的帮助 |
|---|---|
| 你在同一个产品中测试 GPT、Claude、Gemini、DeepSeek、Qwen,或图像/视频模型 | 模型切换可以在一个集成层后面完成。 |
| 你已经在使用 OpenAI SDK 的结构 | 迁移可以从更改基础 URL 和密钥开始,而不是完全重写。 |
| 财务需要一个统一的使用和计费视图 | 请求可以在一个仪表板中查看,而不是多个提供商控制台。 |
| 平台需要按环境配置密钥和配额 | 密钥所有权、支出上限和路由规则可以集中管理。 |
| 跨提供商的可靠性很重要 | 回退和健康检查可以作为运维策略来处理,而不是零散写在代码里。 |
如果某个工作流依赖统一网关未暴露的提供商原生特性、采购要求直接签约,或者你的产品实际上只使用一个提供商,就保留直接的提供商账户。
步骤 1:先选工作负载,再选提供商
不要先问:“哪个模型最好?” 先把工作负载写下来。
使用这样一个小表格:
| 工作负载 | 面向用户的风险 | 模型候选 | 必须验证 |
|---|---|---|---|
| 客户支持回复 | 政策解释错误 | 快速聊天模型、推理模型 | 准确性、延迟、每个已解决工单的成本 |
| 代码审查助手 | 遗漏 bug 或产生噪声反馈 | 编码模型、推理模型 | 漏洞发现率、编辑质量、回退行为 |
| 产品图片生成 | 创意输出质量差 | 图像生成模型 | 每张被接受图片的成本、提示控制、审核路径 |
| 研究代理 | 响应缓慢或不完整 | 推理模型加工具 | 工具访问、可追溯性、超时处理 |
这一步可以防止统一 AI API 最常见的错误:把网关当作随机模型选择器。良好的实现仍然会将工作负载映射到负责人、质量检查和回退规则。
步骤 2:创建并存储 API 密钥
在网关控制台中创建密钥,并将其存储在源代码管理之外。
对于 Flatkey,在控制台中创建一个密钥,并将其存储为 FLATKEY_API_KEY:
export FLATKEY_API_KEY="sk-fk-your-key"为开发、预发布和生产环境使用不同的密钥。这样可以获得更清晰的日志;如果密钥泄露,也能更安全地吊销。
推荐的密钥命名:
| 环境 | 示例密钥名称 | 用途 |
|---|---|---|
| 开发 | dev-local-ai-tests | 带有低消费限额的本地测试 |
| 预发布 | staging-model-routing | 生产前验证 |
| 生产 | prod-customer-chat | 实时用户流量 |
| 代理工作流 | prod-research-agent | 自主或定时的代理调用 |
统一 AI API 应该减少凭据蔓延,而不是把它隐藏起来。保持密钥所有权明确。
步骤 3:使用 cURL 发起第一次请求
在修改应用之前先从 cURL 开始。这样可以证明密钥、端点、模型 ID 和请求结构都能独立于你的框架正常工作。
curl https://router.flatkey.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $FLATKEY_API_KEY" \
  -d '{
    "model": "gpt-4o-mini",
    "messages": [
      {
        "role": "user",
        "content": "写一句话解释统一 AI API 的作用。"
      }
    ],
    "max_tokens": 120
  }'
在生产中使用某个模型之前,请在当前模型目录或 API 模型列表中确认准确的模型 ID。AI 市场中的模型可用性、别名、定价和支持的端点可能会快速变化。
步骤 4:切换 OpenAI SDK 的 Base URL
许多团队可以使用他们已经在用的 OpenAI Python 或 Node.js SDK 来测试 统一 AI API。核心迁移就是 API 密钥加上 base URL。
Python:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["FLATKEY_API_KEY"],
    base_url="https://router.flatkey.ai/v1",
)

response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "user", "content": "将这条产品反馈总结为三个要点。"}
    ],
    max_tokens=300,
)

print(response.choices[0].message.content)
Node.js:
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.FLATKEY_API_KEY,
  baseURL: "https://router.flatkey.ai/v1",
});

const response = await client.chat.completions.create({
  model: "gpt-4o-mini",
  messages: [
    { role: "user", content: "将这条产品反馈总结为三个要点。" },
  ],
  max_tokens: 300,
});

console.log(response.choices[0].message.content);
目标不是消除所有提供商差异。目标是在模型选择进入受控参数的同时,保持应用包装层的稳定。
第 5 步:用策略选择模型,而不是凭猜测
统一 AI API 让模型切换更容易。这既可能带来帮助,也可能带来问题,取决于你是否定义了选择规则。
使用一个简单的策略表:
| 路由 | 主模型 | 备用模型 | 审批规则 |
|---|---|---|---|
support_summary | 快速低成本聊天模型 | 更大的推理模型 | 产品负责人在 QA 样本通过后可修改 |
code_review | 面向编码的模型 | 通用推理模型 | 需要工程负责人批准 |
image_creative | 图像模型 | 无自动回退 | 创意负责人审批输出质量 |
research_agent | 推理模型 | 低延迟模型 | 如果回退会改变答案深度,则需要运维批准 |
模型名称绝不应该是散落在代码库各处的魔法字符串。把它放进配置中,将其与工作负载关联起来,并记录请求的模型和最终使用的模型。
第 6 步:在第一次调用后验证使用日志
不要在 API 返回 200 时就宣布迁移完成。检查使用和成本轨迹。
对于 Flatkey,Usage 仪表板会显示请求级字段,例如时间戳、模型、输入 tokens、输出 tokens、扣除成本、API key 和状态。第一次请求后,请验证:
| 检查项 | 你应该看到什么 |
|---|---|
| 模型 | 你请求的模型 ID 或最终路由到的模型 |
| Tokens | 输入和输出 token 数 |
| 成本 | 该请求从余额中扣除的金额 |
| Key | 该请求使用的环境 key |
| 状态 | 成功、错误或限流状态 |
| 延迟 | 第一次测试是否在你的预期范围内 |
这正是统一 AI API 在运营上变得有用的地方。产品、工程和财务可以查看同一条请求轨迹,而不必对照多个提供商仪表板上的截图。
第 7 步:只有在能够衡量之后,才添加回退
回退并不一定自动就是好事。只有当它能够在不降低回答质量、不破坏政策或不隐藏成本的情况下恢复请求时,它才是好事。
在启用回退之前,请先定义:
| 问题 | 为什么重要 |
|---|---|
| 哪些错误会触发回退? | 限流、超时、提供商中断和内容政策失败是不同的事件。 |
| 允许哪个模型作为备份? | 回退模型可能会改变质量、延迟、成本或合规态势。 |
| 谁批准这条路由? | 回退策略是一种生产环境行为,而不只是开发者图省事的功能。 |
| 会记录什么? | 你需要记录请求的模型、最终模型、重试次数、最终状态、token、成本和延迟。 |
| 回滚方案是什么? | 如果回退导致响应质量变差,你需要一种快速禁用它的方法。 |
开源和商业路由器文档通常会强调路由、提供商顺序、负载均衡和回退行为。这些功能很重要,但你的上线应该衡量已接受输出率、每个已接受输出的成本、p95 延迟和回退不匹配率。
步骤 8:保留直接提供商异常路径
最好的统一 AI API 上线方案仍然会保留例外情况。
在以下情况下使用直接提供商访问:
- 统一层未暴露某个模型专有功能
- 某项上线关键功能需要提供商原生请求格式
- 采购、合规或数据驻留政策要求使用直接路径
- 某个团队在受监管的工作流中需要提供商原生日志或控制
- 统一路径未通过你的质量、延迟或成本验收测试
这会让架构更可信。统一层会成为可重复的多模型工作的默认方案,而不是强行套用到每一种可能请求上的抽象层。
实施清单
在将工作负载切换到 统一 AI API 之前,请使用此清单:
- 已指定工作负载负责人。
- 已记录主模型和备份模型。
- API 密钥已存储在 secrets manager 或环境变量中。
- 开发、预发布和生产密钥已分离。
- Base URL 已在一个客户端包装器中配置。
- Model ID 由配置驱动,而不是在各文件中硬编码。
- 首次 cURL 请求成功。
- SDK 请求在预发布环境中成功。
- 使用日志显示模型、token、成本、密钥、状态和延迟。
- 每个已接受输出的成本与直接提供商路径进行对比测量。
- 使用非生产故障场景测试了回退行为。
- 已记录回滚方案。
前 30 天要衡量什么
第一个月应该回答 统一 AI API 是否改善了运营,而不仅仅是请求是否能够运行。
跟踪:
| 指标 | 为什么重要 |
|---|---|
| 已接受输出率 | 衡量可用响应,而不仅仅是成功的 HTTP 调用 |
| 每个已接受输出的成本 | 将价格与质量和重试次数进行归一化比较 |
| 按工作负载划分的 p95 延迟 | 防止单一路由掩盖缓慢的用户体验 |
| 回退恢复率 | 显示回退是否真正挽救了请求 |
| 回退不匹配率 | 捕捉在技术上通过但质量不达标的备用响应 |
| 按环境划分的密钥级支出 | 将开发实验与生产使用区分开来 |
| 添加新模型所需时间 | 衡量统一层是否减少了运营摩擦 |
如果这些指标有所改善,就把统一层扩展到另一个工作负载。如果没有,就为该工作流保留直连提供商路径,并将结果作为下一次测试的约束条件。
Flatkey 适配性:一个密钥、一个基础 URL、一个审查界面
Flatkey 专为希望在多个模型和工具工作流中使用一个密钥和一个兼容 OpenAI 的基础 URL 的团队而构建。当前 Flatkey 文档描述了对 https://router.flatkey.ai/v1 的 REST API 访问、Bearer 认证、OpenAI SDK 兼容性、通过 model 参数进行模型选择,以及用于审查模型、令牌、延迟、成本、密钥和状态的使用日志。
这使得当你的团队希望采用统一 AI API 工作流而无需重写每个请求包装器时,Flatkey 成为一个实用选择。从一个预发布工作负载开始,在当前模型目录中验证确切模型,检查使用日志,然后决定路由、回退、配额或团队控制下一步应先引入哪一项。
有关相邻的实现细节,请阅读 Flatkey API 快速入门、OpenAI 兼容 API 网关迁移清单以及 AI 路由 API 工具评估框架。
常见问题
什么是统一 AI API?
统一 AI API 是一个访问层,可通过共享的身份验证、端点配置、模型选择和使用审查来调用多个受支持的 AI 模型或工具。
统一 AI API 和 AI API 网关是一样的吗?
它们有重叠。AI API 网关通常强调路由、控制、回退和可观测性。统一 AI API 则强调在多个模型或提供商之间的一体化集成界面。许多产品会同时具备这两者。
我可以将统一 AI API 与 OpenAI SDK 一起使用吗?
可以,只要网关提供 OpenAI 兼容 API。在这种情况下,通常需要设置 API 密钥、更改 SDK 基础 URL,并使用 model 参数选择目标模型。
统一 AI API 会消除提供商特有的差异吗?
不会。模型行为、上下文限制、支持的参数、延迟、定价和策略行为仍然可能不同。统一 AI API 可以减少集成和运维开销,但你仍然需要针对工作负载进行 QA。
什么时候我不应该使用统一 AI API?
如果某个工作流依赖提供商原生功能、严格的直连提供商采购、专门的合规控制,或者网关无法暴露的单一提供商优化,就不要将其迁移到统一层之后。
结论
统一 AI API 在 2026 年很有用,因为它能让你的团队以更简洁的方式运行多个 AI 模型、管理密钥、检查用量,并在无需重写应用代码的情况下切换路由。最安全的上线方式是循序渐进:先选择一个工作负载,在预发布环境中切换基础 URL,验证请求轨迹,衡量质量和成本,然后只在统一层明确减少运维工作的地方继续扩展。
如果你正在评估用于这一工作流的 Flatkey,请先查看模型目录、定价页面和API 快速入门,然后在更改生产流量之前,先通过 https://router.flatkey.ai/v1 运行一次预发布请求。