
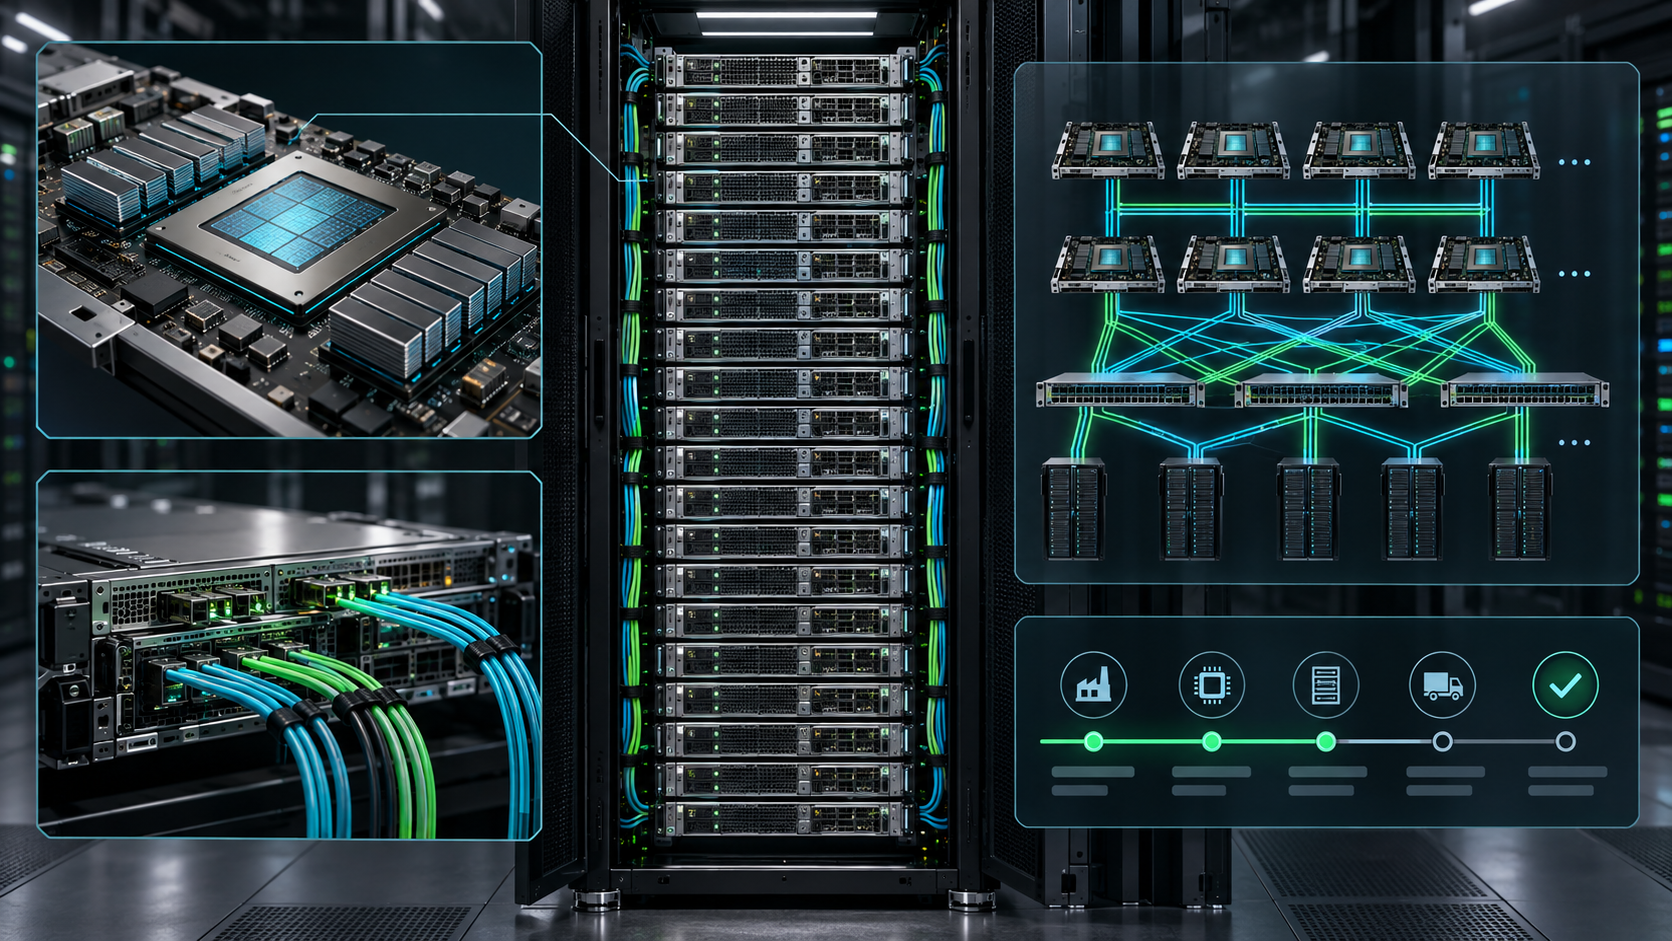
Der AMD MI455X ist der Beschleuniger, den Sie im Blick behalten sollten, wenn Ihre GPU-Roadmap von offener Rack-Scale-KI-Infrastruktur und nicht von einer einzelnen PCIe-Karte oder einer einmaligen Cloud-Instanz abhängt. AMD positioniert den Instinct MI455X als die GPU innerhalb der Helios-Rack-Plattform: ein System mit 72 GPUs auf HBM4-Basis, ausgelegt für großes Training, Post-Training und Inferenz mit hohem Durchsatz.
Für Käufer lautet die nützliche Frage nicht nur „wie lauten die AMD-MI455X-Spezifikationen?“ Ebenso wichtig ist: Wie viel HBM4-Speicher stellt das Rack bereit, welchen Bandbreitenwert sollten Sie modellieren, wann können Sie tatsächlich Kapazität erhalten, und ist vLLM auf AMD-Instinct-MI455X-GPUs in einem Produktionsimage aktiviert?
Dieser Tracker fasst den öffentlichen Stand vom 13. Oktober 2026 zusammen und trennt von AMD bestätigte Aussagen von Annahmen der Käufer.
Kurzantwort: Was ist AMD MI455X?
Der AMD MI455X ist eine AMD-Instinct-Rechenzentrums-GPU auf Basis der CDNA-Next-Architektur von AMD. Auf der öffentlichen Produktseite von AMD sind pro MI455X-Beschleuniger 432 GB HBM4-Speicher und 23,3 TB/s Spitzen-Speicherbandbreite angegeben. Im AMD-Helios-Rack ergeben 72 MI455X-GPUs zusammen rund 31 TB HBM4-Speicher und etwa 1,67 PB/s aggregierte GPU-Speicherbandbreite.
AMD hat Helios als Rack-Scale-Plattform für offene KI-Infrastruktur und nicht als eigenständiges Accelerator-SKU beschrieben. Das ist wichtig, weil die meisten Teams AMD MI455X über Cloud-Kapazitäten, Rack-Reservierungen, verwaltete Cluster und Software-Images bewerten werden, nicht durch den Kauf einer einzelnen losen GPU.
AMD MI455X Tracker
| Feld | Aktueller öffentlicher Status | Fazit für Käufer |
|---|---|---|
| GPU | AMD Instinct MI455X | Als Flaggschiff-Beschleuniger der MI400-Serie für die Helios-Planung betrachten. |
| Architektur | AMD CDNA Next | KI-Architektur der neuen Generation von AMD; die Validierung des Software-Stacks wird voraussichtlich wichtig sein. |
| Speicherkapazität | 432 GB HBM4 pro GPU | Großer Spielraum für KV-Cache, langen Kontext, MoE-Experten und das Serving großer Modelle. |
| Speicherbandbreite | 23,3 TB/s Peak pro GPU | Verwenden Sie für Bandbreitenmodellierungen diesen aktuellen AMD-Wert und nicht ältere Vorabzahlen. |
| Rack-Plattform | AMD Helios | Die praktische Beschaffungseinheit ist wahrscheinlich Rack- oder Cluster-Kapazität. |
| GPUs pro Helios-Rack | 72 MI455X-GPUs | Vergleichbare Entscheidungen sollten auf Ebene der Rack-Topologie und nicht nur auf GPU-Karten-Ebene getroffen werden. |
| Rack-Speicher | Etwa 31 TB HBM4 | Nützlich für Inferenz großer Modelle, Post-Training und Modelle für Multi-Tenant-Scheduling. |
| Rack-Speicherbandbreite | Etwa 1,67 PB/s aggregiert | Bandbreitensensitive Workloads sollten echte Tokens/s- und Step-Time-Benchmarks anfordern. |
| Software-Stack | ROCm, AMD-Entwickler-Stack und Framework-Support | vLLM kann auf AMD-ROCm-Plattformen laufen, aber Produktionsimages für MI455X müssen weiterhin vom Anbieter validiert werden. |
| Verfügbarkeit | AMD hat MI400/Helios für den Infrastrukturzyklus 2026 positioniert | Die tatsächliche Verfügbarkeit hängt vom Bestand des Anbieters, der Region, Preview-Programmen und den Reservierungsbedingungen ab. |
AMD MI455X Architektur: Warum CDNA Next wichtig ist
AMD MI455X ist für Teams, die bereits MI300X betreiben, nicht nur ein inkrementeller Speicherausbau. Er gehört zur nächsten Instinct-Generation von AMD, und das umgebende Helios-System verschiebt das Beschaffungsgespräch von „welche GPU-Instanz sollten wir mieten?“ hin zu „welche Rack-Topologie, welcher Software-Stack und welches Provider-Commitment können unsere Workload-Tests bestehen?“
Die Architekturfragen, die am wichtigsten sind, sind praktisch:
- Speicher pro GPU: 432 GB HBM4 verändern, wie viel Modellzustand, KV-Cache und Batch-Reserve nahe am Beschleuniger bleiben können.
- Speicherbandbreite: 23,3 TB/s Spitzenbandbreite pro AMD MI455X ist die Spezifikation, die Sie für speichergebundene Inferenz- und Post-Training-Workloads benchmarken sollten.
- Scale-up-Topologie: Helios platziert 72 MI455X-GPUs in einem Rack-Scale-System, daher sind Platzierung, Interconnect, Ausfall-Domänen und Scheduler-Bewusstsein allesamt wichtig.
- Software-Reife: Die Kapazität von CDNA Next ist nur dann nützlich, wenn Kernel, ROCm-Images, vLLM-/SGLang-Support, Observability und Orchestrierung für Ihr Modell stabil sind.
- Provider-Paketierung: Cloud-Käufer sehen möglicherweise vollständige Racks, Teilracks, private Cluster, verwaltete Inferenz oder Benchmark-Previews, bevor gewöhnliche On-Demand-Instanzen verfügbar sind.
Deshalb sollte der AMD MI455X neben Ihrem GPU-Cluster-TCO-Modell stehen und nicht nur in einer reinen Beschleuniger-Vergleichstabelle.
AMD MI455X Spezifikationen: Was bestätigt ist
Dies sind die Kernwerte, die Sie heute in ein Planungsblatt aufnehmen sollten:
| Spezifikation | Öffentlicher AMD-MI455X-Wert |
|---|---|
| Produktfamilie | AMD Instinct MI400-Serie |
| GPU | AMD Instinct MI455X |
| Architektur | AMD CDNA Next |
| Speicher | 432 GB HBM4 |
| Spitzen-Speicherbandbreite | 23,3 TB/s |
| Primäre Plattform | AMD-Helios-Rack |
| Helios-GPU-Anzahl | 72 AMD Instinct MI455X-GPUs |
| Helios-Speicher | Etwa 31 TB HBM4 |
| Aggregierte Helios-Speicherbandbreite | Etwa 1,67 PB/s, basierend auf 72 x 23,3 TB/s |
Das sekundäre Schlüsselwort „amd mi455x memory bandwidth“ ist besonders wichtig, weil sich manche frühen Diskussionen gegenüber den aktuellen Zahlen auf der Produktseite verzögern können. Wenn ein Anbieterangebot, eine Folie oder ein Benchmark 19,6 TB/s nennt, fragen Sie nach dem Quellendatum und ob das Zitat den aktuellen MI455X-Produktleitlinien entspricht.
AMD Helios: Das Rack ist das Produkt
AMD Helios ist die Rack-Scale-Plattform, die um den AMD MI455X aufgebaut ist. Für Infrastrukturkäufer bedeutet das, dass die wichtigsten Spezifikationen nicht nur die Zahlen pro GPU sind. Das Rack muss als System bewertet werden:
| Helios-Planungsbereich | Worauf zu achten ist |
|---|---|
| Rack-Topologie | Bietet der Anbieter ein vollständiges Helios-Rack, ein partitioniertes Rack oder einen höherstufigen Managed Service an? |
| GPU-Platzierung | Kann Ihr Job eine zusammenhängende MI455X-Topologie reservieren, oder wird die Platzierung fragmentiert sein? |
| Speichersichtbarkeit | Wie viel der nominalen 31 TB HBM4 sind nach Framework-, Tensor-Parallelismus- und Scheduler-Overhead nutzbar? |
| Netzwerk-Fabric | Welche Scale-up- und Scale-out-Netzwerke werden bereitgestellt, und welche Zähler sind für Kunden sichtbar? |
| Speicherpfad | Kann der Speicher für Checkpoints, Datensätze und Embeddings das Rack versorgen, ohne GPU-Leerlauf zu verursachen? |
| Fehlerdomäne | Was passiert, wenn während eines Laufs ein Tray, eine NIC, ein Switch oder eine Strom-/Kühlkomponente ausfällt? |
| Software-Image | Welche ROCm-, Linux-, Kubernetes-, Slurm-, vLLM-, SGLang-, PyTorch- und Monitoring-Versionen werden unterstützt? |
| Abnahmetest | Können Sie vor der verbindlichen Zusage Ihr eigenes Modell, Sequenzlängen, Batch-Mix und SLOs ausführen? |
Helios sollte auch mit konkurrierenden Rack-Scale-Systemen und mit einer Managed-Model-API-Basislinie verglichen werden. Wenn Ihr Produkt nur zuverlässige Modellausgaben und keine direkte Hardwarekontrolle benötigt, lesen Sie dies zusammen mit GPU-Cloud vs. Model API, bevor Sie Rack-Kapazität reservieren.
Warum HBM4 die AMD-MI455X-Spezifikation ist, auf die man achten sollte
Die Suchanfrage "amd mi455x memory capacity hbm4" existiert, weil Speicher mittlerweile einer der wichtigsten Kauf-Filter für KI-Infrastruktur ist. HBM4 beeinflusst sowohl Kapazität als auch Geschwindigkeit:
- Lange-Context-Inferenz: Mehr HBM gibt mehr Spielraum für den KV-Cache, bevor Batchgröße oder Kontextlänge reduziert werden müssen.
- Große MoE-Modelle: Mehr lokaler Speicher hilft bei aktiven Experten, Routing-Zustand und weniger aggressivem Offloading.
- Post-Training: SFT-, Präferenzoptimierungs- und Reinforcement-Learning-Pipelines können durch Aktivierungs- und Optimizerspeicher begrenzt sein.
- Tenant-Dichte: Mehr Speicher kann mehr Modellvarianten, Replikate oder Kunden pro reservierter Topologie unterstützen, wenn die Isolation gut ausgelegt ist.
- Kosten pro akzeptierter Ausgabe: Größere Batchgrößen helfen nur, wenn Latenz, Qualität, Wiederholungen und Fehlerwiederherstellung innerhalb des Produkt-SLO bleiben.
Kaufen Sie nicht allein anhand der Speicherkapazität. Verlangen Sie von Anbietern belastbare Nachweise auf Workload-Ebene: Tokens/s bei Ihrer Kontextlänge, Zeit bis zum ersten Token, Batch-Latenz, Akzeptanzrate der Modellqualität, Warteschlangenzeit, Kosten eines fehlgeschlagenen Laufs und operative Wiederherstellungszeit.
Ist vLLM auf AMD-Instinct-MI455X-GPUs aktiviert?
Die genaue Antwort lautet: vLLM wird auf AMD-ROCm-Plattformen unterstützt, und AMD positioniert seinen KI-Software-Stack rund um offene Framework-Unterstützung, aber Sie sollten die MI455X-spezifische vLLM-Aktivierung mit dem tatsächlichen Cloud-Anbieter-Image verifizieren, bevor Sie es als produktionsreif behandeln.
Diese Unterscheidung ist wichtig. "ROCm unterstützt vLLM" ist nicht dasselbe wie "diese MI455X-Region, dieser Treiber, dieser Kernel-Satz, dieses Container-Image, dieses Modell und diese Serving-Topologie werden alle von meinem Anbieter produktionsseitig unterstützt."
Verwenden Sie diese vLLM-Validierungs-Checkliste:
- Bestätigen Sie die ROCm-Version des Anbieters und ob MI455X in den Release Notes des Images aufgeführt ist.
- Fragen Sie nach, ob vLLM vorinstalliert, vom Anbieter unterstützt oder von der Community unterstützt wird.
- Führen Sie Ihr Zielmodell mit derselben Quantisierung, dem gleichen Tensor-Parallelismus, der gleichen Sequenzlänge und der gleichen Parallelität aus, die Sie in der Produktion erwarten.
- Messen Sie Prefill, Decode, Zeit bis zum ersten Token, Durchsatz, Fehlerrate und GPU-Speicherdruck.
- Prüfen Sie, ob alternative Serving-Optionen wie SGLang, Triton oder vom Anbieter verwaltete Inferenz verfügbar sind.
- Verifizieren Sie Upgrade-Richtlinie, Rollback-Verfahren, Observability und Kernel-Kompatibilität, bevor Sie einen Vertrag über reservierte Kapazität unterzeichnen.
Wenn der Anbieter diese Fragen noch nicht beantworten kann, behandeln Sie die AMD-MI455X-vLLM-Unterstützung als Evaluierungsaspekt und nicht als abgeschlossene Produktionszusage.
AMD MI455X Release-Date und Verfügbarkeits-Tracker
Die Suchnachfrage rund um "amd mi455x release date" bedeutet meist, dass Käufer wissen wollen, wann sie Kapazität mieten, benchmarken oder reservieren können. Der saubere Weg, dies zu verfolgen, ist über Meilensteine statt über ein einzelnes Datum:
| Meilenstein | Was öffentlich nützlich ist | Was Käufer noch brauchen |
|---|---|---|
| Produktfreigabe | AMD hat die MI455X-Produktspezifikationen und Details der Helios-Plattform öffentlich aufgeführt. | Bestätigen Sie das Datum der Spezifikationsrevision in den Angeboten der Anbieter. |
| Software-Aktivierung | ROCm und die AMD-KI-Softwareunterstützung sind zentral für die Plattform-Story. | Bestätigen Sie MI455X-spezifische Image-Unterstützung, Framework-Versionen und den Status von vLLM/SGLang. |
| Systemverfügbarkeit | AMD positioniert Helios für den KI-Infrastrukturzyklus 2026. | Bestätigen Sie die ersten Anbieterregionen, das Zuteilungsmodell und die Kapazitätsfenster. |
| Cloud-Vorschau | Frühe Kapazität kann als Benchmark-Zugang oder Private Preview erscheinen. | Bitten Sie um eine repräsentative Topologie, nicht um isolierte Marketing-Benchmarks. |
| Allgemeine Mietbarkeit | On-Demand-Kapazität kann der Systemverfügbarkeit hinterherhinken. | Vergleichen Sie On-Demand-, Reserved-, Private-Cluster- und Managed-Service-Konditionen. |
Die praktische Regel: Setzen Sie AMDs Hardware-Roadmap nicht mit der verfügbaren Kapazität Ihres Teams gleich. Anbieterbestand, Region, Strom, Kühlung, Netzwerktechnik, Software-Images und kommerzielle Konditionen bestimmen gemeinsam, wann AMD-MI455X-Kapazität nutzbar ist.
Wann man auf AMD MI455X warten sollte
Warten auf AMD MI455X- oder Helios-Kapazität kann sinnvoll sein, wenn:
- Ihre Workload speichergebunden ist und 432 GB HBM4 pro GPU die Wirtschaftlichkeit verändert.
- Sie Rack-Scale-Kontrolle für Training, Post-Training, Inferenz für große MoE-Modelle oder kundenspezifisches Serving benötigen.
- Sie auf produktionsnahen Prompts, Kontextfenstern und gleichzeitiger Ausführung benchmarken können.
- Ihr Team bereit ist, ROCm-Images, Scheduler-Richtlinien, Netzwerkzähler, Speicher und Fehlerwiederherstellung zu betreiben.
- Ihr Beschaffungszeitfenster Provider-Preview, Zuteilung und regionale Unsicherheit tolerieren kann.
Warten ist riskant, wenn:
- Sie jetzt produktionsfähige Kapazität für Endnutzer benötigen.
- Ihre Workload gehostete Modelle über eine API ohne direkte GPU-Kontrolle nutzen kann.
- Sie nicht genug Auslastung haben, um ein reserviertes Rack oder einen privaten Cluster zu amortisieren.
- Ihr Hauptengpass Routing, Zuverlässigkeit, Evaluierung, Kostenzuordnung oder Nutzer-Workflow ist und nicht der reine Accelerator-Zugriff.
- Sie keinen Abnahme-Benchmark ausführen können, bevor Sie sich vertraglich binden.
Für viele Teams ist der pragmatische Weg hybrid: Jetzt Modell-APIs für die Produktion nutzen, MI455X oder Helios benchmarken, wenn Kapazität verfügbar wird, und Hardware erst reservieren, nachdem sie Ihr Modell/API-Baseline bei den Kosten pro akzeptierter Ausgabe übertrifft.
Fragen an Anbieter zur AMD MI455X-Kapazität
Bevor Sie AMD MI455X-Kapazität reservieren, senden Sie Anbietern diese Checkliste:
- Bieten Sie AMD MI455X, AMD Helios oder eine andere MI400-Serien-Konfiguration an?
- Handelt es sich bei der Kapazität um ein vollständiges Rack, ein teilweises Rack, einen privaten Cluster, Managed Inference, Preview oder eine On-Demand-Instanz?
- Welche Regionen haben physische Bestände, und wie groß ist das Zuteilungsfenster?
- Welche Versionen von ROCm, Kernel, Treiber, Firmware, Slurm/Kubernetes, PyTorch, vLLM und SGLang werden unterstützt?
- Können wir unser Modell, die Prompt-Mischung, die Kontextlänge, die Parallelität und das Evaluierungsharness vor einer Verpflichtung ausführen?
- Wie hoch sind die Kosten für Warteschlangenzeit, Wiederholungen, fehlgeschlagene Jobs, Egress, Speicher und Support?
- Welche Telemetrie ist für GPU-Auslastung, HBM-Druck, Speicherbandbreite, Netzwerkzähler und Jobfehler verfügbar?
- Was passiert, wenn sich öffentliche Spezifikationen, Lieferzeitpunkt oder Benchmark-Ergebnisse nach Vertragsunterzeichnung ändern?
- Welche Sicherheitskontrollen gibt es für Mandantenisolierung, Datenverarbeitung und Audit-Nachweise?
- Wie vergleicht sich die Preisgestaltung mit aktuellen GPU-Mietpreisen, serverless GPU vs. dedizierte GPU und verwalteten Modell-/API-Alternativen?
Flatkey-Fazit: MI455X beobachten, aber eine Produktions-Baseline beibehalten
Die AMD MI455X ist wichtig, weil sie Käufern eine ernstzunehmende HBM4- und Rack-Scale-Alternative für den nächsten KI-Infrastrukturzyklus bietet. Sie sollte von allen beobachtet werden, die Large-Model-Inferenz, Post-Training oder Private-AI-Factory-Kapazität planen.
Sie ist nicht automatisch der richtige erste Schritt für jedes KI-Produktteam. Wenn Ihr Produkt zuverlässigen Zugriff auf Modellausgaben, Kosten-Transparenz, Fallback-Routing und eine einzige Abrechnungsoberfläche benötigt, kann eine verwaltete Modell-/API-Schicht den Betrieb aufrechterhalten, während sich MI455X-Angebot und Software-Images weiterentwickeln.
Flatkey ist für diesen Weg gebaut: ein Schlüssel, ein Kontostand und Routing über offizielle Modell- und Tool-APIs hinweg. Verwenden Sie Flatkey als Produktions-Baseline in Ihrer AMD-MI455X-Analyse, damit Sie Rack-Scale-Hardware mit einem funktionierenden Bereitstellungspfad vergleichen und nicht mit einer leeren Tabellenkalkulation.
Häufig gestellte Fragen
Was ist AMD MI455X?
AMD MI455X ist ein Data-Center-Accelerator der AMD-Instinct-MI400-Serie auf Basis der AMD-CDNA-Next-Architektur. AMD nennt 432 GB HBM4-Speicher und 23,3 TB/s Spitzen-Speicherbandbreite für die GPU.
Was ist AMD Helios?
AMD Helios ist eine Rack-Scale-KI-Plattform, die auf 72 AMD-Instinct-MI455X-GPUs aufbaut. In dieser Größenordnung stellt das Rack etwa 31 TB HBM4-Speicher und etwa 1,67 PB/s aggregierte GPU-Speicherbandbreite bereit.
Wie hoch ist die AMD MI455X-Speicherkapazität?
Die öffentliche AMD-MI455X-Speicherkapazität beträgt 432 GB HBM4 pro GPU. Ein Helios-Rack mit 72 GPUs erreicht damit vor praktischem Software- und Scheduling-Overhead ungefähr 31 TB HBM4-Speicher.
Wie hoch ist die AMD MI455X-Speicherbandbreite?
Der aktuelle öffentliche MI455X-Wert von AMD liegt bei 23,3 TB/s Spitzen-Speicherbandbreite pro GPU. Für ein Helios-Rack mit 72 GPUs entspricht das etwa 1,67 PB/s aggregierter Speicherbandbreite.
Wann ist das Veröffentlichungsdatum von AMD MI455X?
AMD hat MI455X öffentlich angekündigt und Helios für den KI-Infrastrukturzyklus 2026 positioniert. Käufer sollten anbieterspezifischen Bestand, Regionen, Preview-Zugang, Software-Images und Reservierungsbedingungen verfolgen, statt ein einheitliches allgemeines Mietdatum anzunehmen.
Ist vLLM auf AMD Instinct MI455X GPUs aktiviert?
vLLM unterstützt AMD-ROCm-Plattformen, aber die MI455X-spezifische Produktionsaktivierung hängt vom Anbieter-Image, der ROCm-Version, den Kerneln, dem Modell, der Serving-Konfiguration und der Support-Richtlinie ab. Verifizieren Sie dies vor dem Go-live mit dem Anbieter, bevor Sie Produktionsverkehr zusagen.
Geprüfte Quellen
- AMD Instinct MI455X Produktseite: https://www.amd.com/en/products/accelerators/instinct/mi400/mi455x.html
- AMD Helios Lösungsseite: https://www.amd.com/en/solutions/ai/helios.html
- AMD Newsroom, KI-Roadmap und Ankündigungen zur offenen KI-Infrastruktur: https://www.amd.com/en/newsroom/press-releases/2025-6-12-amd-unveils-ai-roadmap-and-comprehensive-full-stack-open-ai-infrastructure-solutions.html
- AMD ROCm vLLM-Dokumentation: https://rocm.docs.amd.com/en/latest/how-to/rocm-for-ai/inference-optimization/vllm.html


