
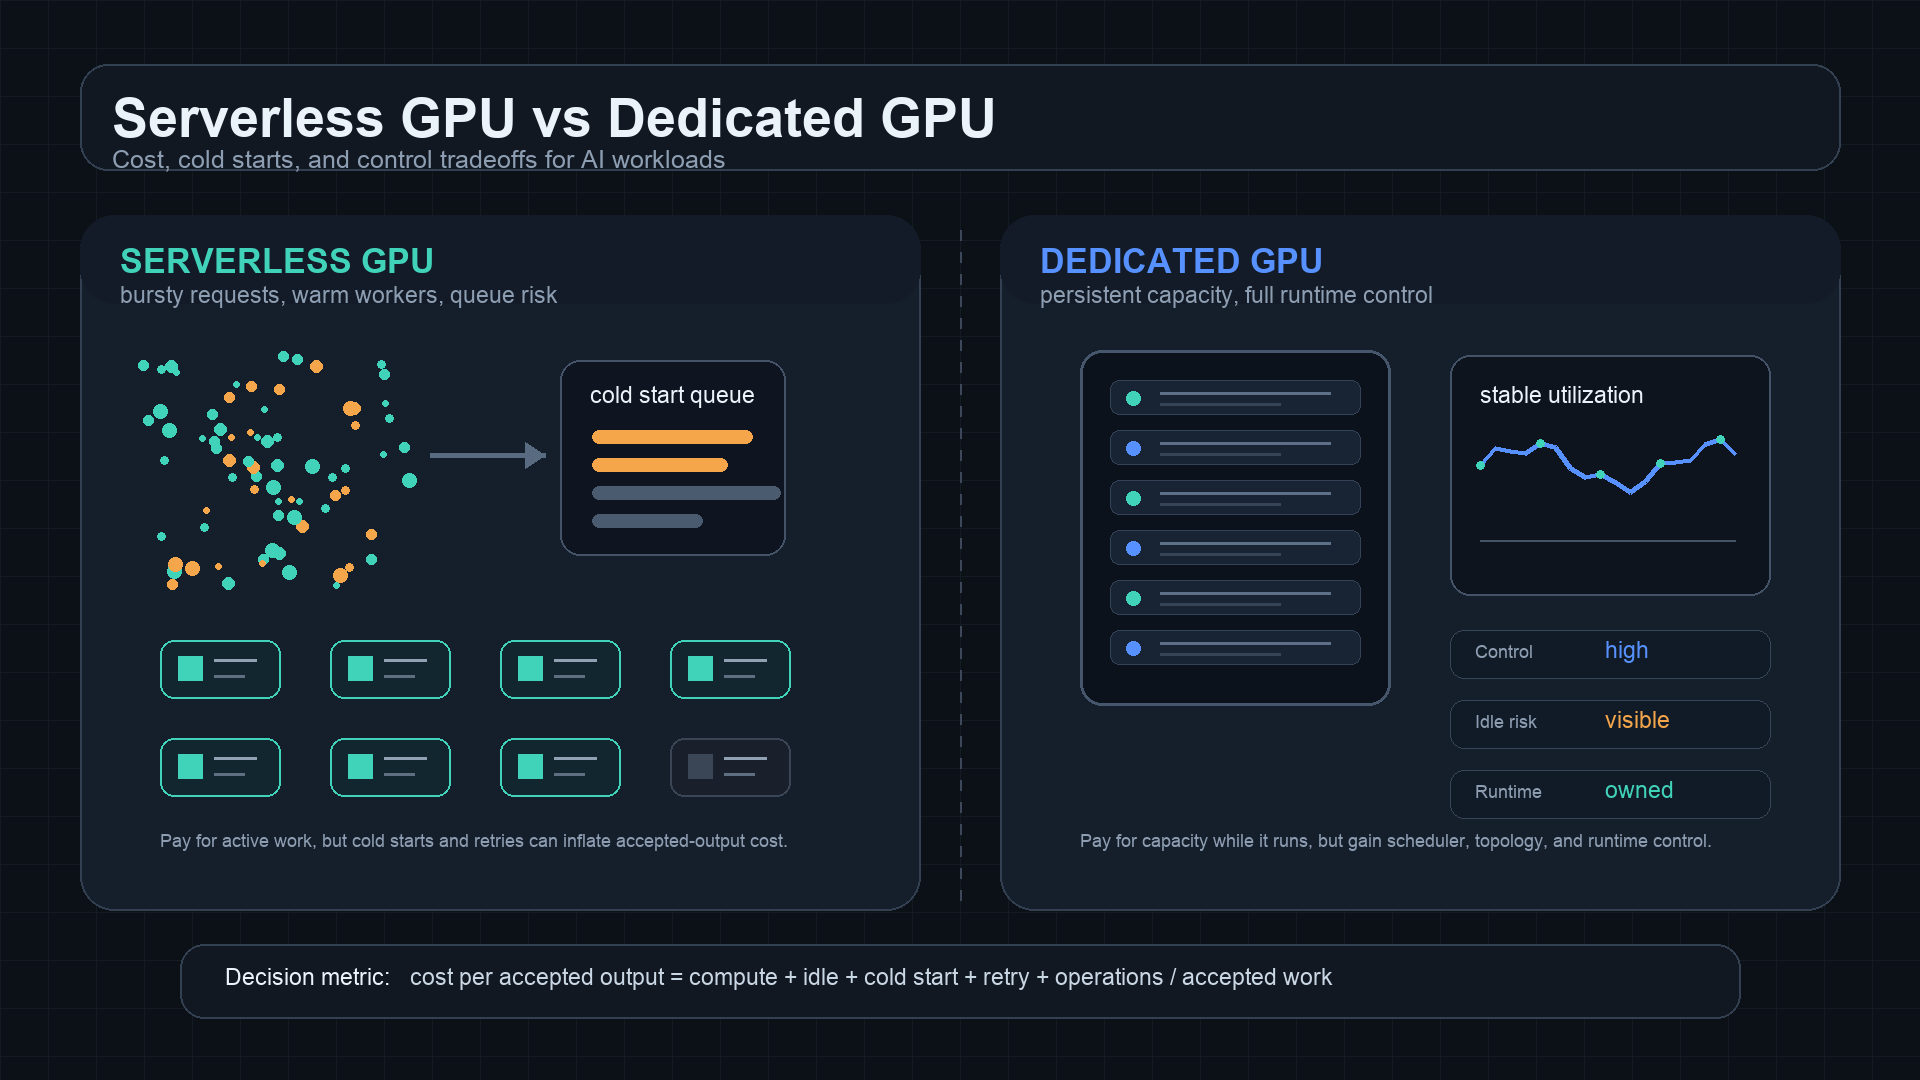
Serverless GPU vs. Dedizierte GPU: Kosten, Cold Starts und Kontrolle
Die Entscheidung zwischen Serverless-GPU- und dedizierter GPU-Kapazität ist vor allem eine Frage des Workload-Profils. Serverless GPUs sind attraktiv, wenn der Traffic sprunghaft ist, Experimente ungleichmäßig ausfallen oder das Team Leerlauf-Hardware vermeiden möchte. Dedizierte GPUs sind attraktiv, wenn die Nachfrage konstant ist, die Startlatenz wichtig ist oder das Team Kontrolle über Treiber, Scheduler, Netzwerke, Modell-Caches und Serving-Runtimes benötigt.
Der Fehler besteht darin, den Preis einer Serverless-GPU-Anfrage mit dem Stundenpreis einer dedizierten GPU zu vergleichen, als würden sie dasselbe beschreiben. Das tun sie nicht. Ein Serverless-Endpoint kann Cold Starts, Queue-Verzögerung, Parallelitätsgrenzen, Retry-Kosten und Overhead pro Anfrage verbergen. Eine dedizierte GPU kann Leerlaufzeit, Risiko durch reservierte Kapazität, Storage, Support und Plattform-Engineering-Aufwand verbergen.
Für unabhängige Entwickler und kleine KI-Teams lautet die praktische Regel:
serverless GPU vs dedicated GPU sollte anhand der Kosten pro akzeptierter Ausgabe verglichen werden,
nicht anhand des niedrigsten sichtbaren GPU-Tarifs.
Wenn Sie noch entscheiden, ob direkte GPU-Miete überhaupt nötig ist, lesen Sie auch die Leitfäden von Flatkey zu GPU-Cloud vs. Model API, GPU-Mietpreisen und versteckten Kosten von Cloud-GPUs. Dieser Artikel konzentriert sich auf die Wahl zwischen Serverless GPU und dedizierter GPU, nachdem GPUs bereits im Evaluationsset enthalten sind.
Serverless GPU vs. dedizierte GPU: die Kurzantwort
Nutzen Sie diese Tabelle als ersten Filter.
| Entscheidungspunkt | Serverless GPU passt meist | Dedizierte GPU passt meist |
|---|---|---|
| Traffic-Muster | Sprunghaft, in der Warteschlange, experimentell oder ungleichmäßig | Konstant, mit hohem Volumen, latenzempfindlich oder kapazitätsgeplant |
| Abrechnungsform | Bezahlen vor allem, wenn Worker laufen oder Anfragen ausgeführt werden, abhängig vom Anbieter | Bezahlen, solange die Instanz, der Pod, der Node, der Cluster oder die Reservierung existiert |
| Start-Risiko | Cold Starts, Modell-Laden, Container-Pull, Worker-Warmup und Queue-Verzögerung | Weniger Cold-Start-Exposition nach dem Warmup, aber Leerkapazität wird berechnet |
| Betriebliche Kontrolle | Weniger Kontrolle über Host, Scheduler, Runtime, Topologie und Caching | Mehr Kontrolle über Treiber, Serving-Stack, Caches, Topologie und Observability |
| Zuverlässigkeitsmodell | Vom Anbieter verwaltetes Scaling mit Endpoint-Grenzen und möglichen Cold Paths | Vom Team verwaltete Verfügbarkeit, Autoscaling, Failover, Patches und Incident Response |
| Beste erste Nutzung | Demos, Bild-/Video-Jobs, Batch-Inferenz, sporadische APIs, Prototypen | Stabile Inferenz-Endpunkte, lang laufende Services, benutzerdefinierte Runtimes, Arbeit mit mehreren Nodes |
Die beste Antwort ist oft gestuft:
- Mit Serverless GPU für unbekannte Nachfrage starten.
- Cold Starts, Queue-Verzögerung, Retry-Rate und Kosten pro akzeptierter Ausgabe messen.
- Nur stabile Workloads mit hohem Volumen auf dedizierte GPU-Kapazität verlagern.
- Einen Model-API-Pfad offen halten, wenn das Produkt viele Modelle benötigt oder keine Hardware-Kontrolle braucht.
Diese Reihenfolge ist sicherer, als dedizierte GPUs zu reservieren, bevor Sie wissen, ob der Workload sie auslasten kann.
Was „Serverless GPU“ in der Praxis bedeutet
Serverless GPU bedeutet in der Regel, dass der Anbieter die Verantwortung für einen dauerhaft laufenden Server abstrahiert. Sie verpacken ein Modell, einen Container, eine Funktion oder einen Endpoint; die Plattform startet GPU-Worker, wenn Anfragen eintreffen; und die Plattform skaliert Worker je nach Nachfrage hoch oder herunter.
Die Implementierungen der Anbieter variieren. RunPod beschreibt Serverless rund um Endpoints und Worker mit separater Serverless-Preisgestaltung gegenüber Pod-Preisen. Modal dokumentiert GPU-Funktionen, Cold Starts und den Container-Lebenszyklus. Google Cloud Run unterstützt Services mit GPUs und hat sein eigenes Cloud-Run-Preismodell. Replicate-Deployments bieten konfigurierbare Production-Inference-Endpunkte. Das sind keine identischen Produkte, daher ist die Checkliste der Quelle wichtig.
Aus Sicht eines Käufers ist Serverless-GPU-Kapazität nützlich, wenn:
- Das Anfragevolumen niedrig, sprunghaft oder noch nicht bekannt ist.
- Jobs in einer Warteschlange warten können, ohne die User Experience zu beeinträchtigen.
- Cold Starts akzeptabel sind oder verdeckt werden können.
- Das Team weniger Infrastrukturverantwortung übernehmen möchte.
- Der Workload als wiederholbare Jobs statt als dauerhaft warmgehaltener Service verpackt ist.
- Das Geschäft Ausgaben bevorzugt, die dem Nutzungsverlauf folgen, statt einer festen monatlichen Kapazitätswette.
Der versteckte Kompromiss ist, dass Serverless GPU die Physik nicht aufhebt. Modellgewichte müssen weiterhin geladen werden. Container müssen weiterhin starten. GPUs müssen weiterhin verfügbare Kapazität haben. Queue-Verzögerungen wirken sich weiterhin auf Nutzer aus. Retries kosten weiterhin Geld.
Was „dedizierte GPU“ in der Praxis bedeutet
Dedizierte GPU-Kapazität bedeutet, dass Sie für einen Zeitraum eine laufende Instanz, einen Pod, Server, Node oder Cluster kontrollieren. Das kann On-Demand, reserviert, committed, Bare Metal, Marketplace-Kapazität oder ein privater Cluster sein. Das gemeinsame Merkmal ist, dass die GPU Ihrem Workload zugewiesen ist, statt nur rund um eine Anfrage gestartet zu werden.
Dedizierte GPU-Kapazität ist nützlich, wenn:
- Der Endpunkt muss warm bleiben.
- Der Traffic ist vorhersehbar genug, um die GPU auszulasten.
- Sie benötigen benutzerdefinierte Treiber, CUDA-Versionen, Kernel, Model-Server oder Netzwerke.
- Sie benötigen konsistente Benchmark-Bedingungen.
- Ein Cold Start würde die Latenz oder das Nutzererlebnis beeinträchtigen.
- Die Workload ist Multi-Node, topologieempfindlich oder datenlokalitätsempfindlich.
- Sie möchten vLLM, SGLang, TensorRT-LLM, Triton, Ray Serve, Kubernetes, Slurm oder eine benutzerdefinierte Serving-Infrastruktur direkt betreiben.
Der verdeckte Kompromiss ist ungenutzte Kapazität. Wenn eine dedizierte GPU 730 Stunden im Monat läuft, aber nur 180 Stunden tatsächlich nützliche Arbeit verrichtet, ist der angegebene Stundenpreis nicht der echte Preis pro Nutzstunde. Die Leerlaufstunden sind Teil der Workload-Kosten.
Die Kostenformel, die den Vergleich fair macht
Verwenden Sie für beide Seiten denselben Nenner:
Kosten pro akzeptierter Ausgabe =
  Compute
  + Speicher
  + Bandbreite
  + Leerlaufzeit
  + Cold-Start-Verschwendung
  + Retry- und Fehlschlag-Verschwendung
  + Support
  + Engineering-Overhead
  / akzeptierte Ausgaben, Datensätze, Tokens, Bilder, Clips oder Jobs
Für Serverless GPU:
Serverless-GPU-Kosten pro akzeptierter Ausgabe =
  Kosten für abgerechnete Worker/Requests
  + Cold-Start- und Queue-Verschwendung
  + Kosten für fehlgeschlagene Requests und Retries
  + Speicher- und Artefaktübertragung
  + Overhead für die Plattformintegration
  / akzeptierte Ausgaben
Für dedizierte GPU:
Kosten für dedizierte GPU pro akzeptierter Ausgabe =
  Kosten für laufende GPU-Kapazität
  + Speicher und Netzwerke
  + ungenutzte Kapazität
  + Betrieb des Serving-Stacks
  + Support- und Incident-Arbeit
  + Verschwendung durch Ausfälle und Neu-Deployments
  / akzeptierte Ausgaben
Hier kippen Vergleiche zwischen Serverless GPU und dedizierter GPU oft. Serverless kann pro Sekunde teuer aussehen, aber insgesamt günstiger sein, wenn dadurch ungenutzte GPUs vermieden werden. Dediziert kann pro Monat teuer aussehen, aber insgesamt günstiger sein, wenn die Workload den Beschleuniger auslastet und Cold-Start-Verschwendung vermeidet.
Cold Starts sind die Serverless-GPU-Steuer
Cold Starts sind das wichtigste Risiko bei Serverless GPU. Ein Cold Start kann Folgendes umfassen:
- GPU-Kapazität finden.
- Ein Container-Image ziehen oder einbinden.
- Abhängigkeiten importieren.
- Modellgewichte laden.
- Das Modell in den GPU-Speicher verschieben.
- Kernel oder Kompilierungspfade aufwärmen.
- Caches neu aufbauen.
- Hinter früheren, in der Warteschlange befindlichen Requests warten.
Die Cold-Start-Dokumentation von Modal ist nützlich, weil sie Container-Startarbeit, Imports und Anwendungsinitialisierung trennt. Die genauen Mechanismen unterscheiden sich je nach Anbieter, aber die Lehre bleibt gleich: Startzeit ist Teil der Nutzererfahrung und des Kostenmodells.
Cold Starts sind besonders wichtig, wenn:
| Workload | Warum Cold Starts schaden |
|---|---|
| Interaktiver Chat oder Agents | Benutzer bemerken hohe Latenz beim ersten Token. |
| Bildbearbeitung in Echtzeit | Der erste Request kann sich kaputt anfühlen, selbst wenn spätere Requests schnell sind. |
| Webhooks oder APIs mit Benutzerkontakt | Upstream-Timeouts können Cold Starts in fehlgeschlagene Jobs verwandeln. |
| Batch-Queues mit strengem SLA | Queue-Verzögerungen können Lieferfenster verletzen. |
| Große Modelle | Das Laden der Gewichte kann den Request-Pfad dominieren. |
Serverless GPU kann dennoch die richtige Wahl sein, wenn die Anwendung diese Verzögerung verkraften kann. Beispielsweise tolerieren Offline-Bildjobs, nächtliche Evaluierungsqueues, asynchrone Batch-Inferenz und interne Experimente Warmup oft besser als kundenorientierter Chat.
Dedizierte GPUs tauschen Cold Starts gegen Leerlaufrisiko
Dedizierte GPUs reduzieren normalerweise die Exposition gegenüber Cold Starts, weil der Dienst warm bleiben kann. Modellgewichte bleiben geladen, Caches bleiben heiß, und das Request-Routing kann einen bekannten Endpunkt treffen.
Aber dedizierte Kapazität schafft eine andere Steuer:
Anteil der Leerlaufverschwendung =
  1 - nutzbare GPU-Aktivzeit / abrechenbare Laufzeit
Wenn der Anteil der nutzbaren GPU-Aktivität 30 % beträgt, kann ein niedrigerer ausgewiesener Stundenpreis dennoch teuer werden. Die dedizierte GPU ist technisch bereit, finanziell aber im Leerlauf.
Dedizierte GPUs funktionieren am besten, wenn Sie nachweisen können:
- Grundlast an Requests.
- Hohe GPU-Auslastung nach Batching und Queueing.
- Stabile Modellauswahl.
- Vorhersehbare Speicheranforderungen.
- Einen Serving-Stack, den das Team betreiben kann.
- Einen Plan für Rolling Deployments, Monitoring, Alarme und Fallback.
Wenn diese Eingaben unbekannt sind, ist Serverless GPU oder eine Model-API oft der sauberere erste Schritt.
Kontrolle: Was dedizierte GPUs zurückgeben
Das stärkste Argument für dedizierte GPU-Kapazität ist nicht immer der Preis. Es ist die Kontrolle.
Dedizierte Kapazität gibt dem Team mehr Einfluss auf:
- GPU-Modell, Speicher und Anzahl.
- Region und Datenlokalität.
- CUDA-, Treiber-, Kernel- und Image-Versionen.
- vLLM-, SGLang-, TensorRT-LLM-, Triton-, Ray-Serve- oder benutzerdefinierte Runtime-Einstellungen.
- Continuous Batching, KV-Cache-Verhalten, Quantisierung, spekulative Dekodierung und Scheduler-Tuning.
- Lokale Modell-Caches und vorab geladene Gewichte.
- Netzwerktopologie, private Verbindungen, VPC-Design, Load Balancer und Ingress.
- Observability, Traces, Logs und Incident Response.
Diese Kontrolle ist wertvoll, wenn die Workload wichtig genug ist, um Ownership zu rechtfertigen. Sie ist teuer, wenn das Team nur zuverlässige Modellausgaben benötigt.
Dieselbe Grenze wird in Flatkeys Artikeln beste GPU für LLM-Inferenz, vLLM-Bereitstellungsleitfaden und vLLM vs SGLang behandelt. Wenn Sie das Runtime-System selbst optimieren, kann dedizierte GPU-Kapazität die richtige Ebene sein. Wenn Sie Produktfunktionen über viele Modelle hinweg ausrollen, ist ein verwalteter API-Pfad möglicherweise schneller.
Workload-Entscheidungsmatrix
Verwenden Sie diese Matrix, bevor Sie eine Tabelle erstellen.
| Workload | Besserer Ausgangspunkt | Warum |
|---|---|---|
| Neue KI-Produktfunktion mit unbekannter Nachfrage | Serverless GPU oder Modell-API | Vermeidet den Kauf ungenutzter Kapazität, bevor der Traffic bekannt ist. |
| Asynchrone Bildgenerierungs-Warteschlange | Serverless GPU | Warteschlangenverzögerung kann akzeptabel sein, und Lastspitzen erfordern keine ständig aktiven GPUs. |
| Kurze Demo oder Prototyp | Serverless GPU | Schnelles Setup und nutzungsabhängige Abrechnung sind in der Regel wichtiger als Runtime-Kontrolle. |
| Stabile LLM-Inferenz mit hohem Volumen | Dedizierte GPU | Anhaltende Auslastung kann den Serving-Stack amortisieren. |
| Latenzsensibler Kunden-Endpunkt | Dedizierte GPU oder Modell-API | Cold Starts und Warteschlangenverzögerungen lassen sich schwerer verbergen. |
| Großes Modell mit langsamer Gewichteladung | Dedizierte GPU | Warm gehaltene Gewichte können wiederholten serverlosen Starts überlegen sein. |
| Periodische Evaluierungs-Suite | Serverless GPU, Spot-GPU oder Batch-Modell-API | Jobs können erneut ausgeführt werden und hinter einer Warteschlange laufen. |
| Eigene CUDA-Kernels oder Runtime-Forschung | Dedizierte GPU | Das Team benötigt Low-Level-Kontrolle. |
| Multi-Node-Training oder verteilte Inferenz | Dedizierter Cluster | Topologie, Netzwerk-Fabric und Fehlerdomänen dominieren. |
| Produkt mit Bedarf an vielen Frontier-Modellen | Modell-API oder Gateway | Direkter GPU-Besitz löst den Zugriff auf Modelle mehrerer Anbieter nicht. |
Für eine breitere Kapazitätsplanung kombinieren Sie dies mit Flatkeys Leitfäden On-Demand vs. Spot-GPU, GPU-Cluster-TCO und GPU-Cluster-Miete.
Serverless-GPU-Kostenfallen
Die Ökonomie von Serverless GPU kann enttäuschen, wenn Teams diese Felder ignorieren.
| Falle | Was passiert | Kontrolle |
|---|---|---|
| Langsames Laden des Modells | Jeder kalte Worker verbringt abrechenbare Zeit, bevor die nützliche Arbeit beginnt | Artefakte vorab paketieren, Images verkleinern, Gewichte cachen, Warmup separat messen |
| Timeout-Mismatch | Cold Starts lösen Upstream-Timeouts und Retries aus | Realistische Timeouts setzen, asynchrone Warteschlangen, idempotente Job-IDs |
| Warteschlangen-Intransparenz | Benutzer sehen Verzögerung, aber Dashboards zeigen nur abgeschlossene Requests | Warteschlangenwartezeit, Cold-Start-Zeit, aktive Worker-Zeit und Latenz bis zur akzeptierten Ausgabe erfassen |
| Kleine Jobs auf großen GPUs | Der Overhead pro Request dominiert das nützliche Rechnen | Arbeit bündeln oder ein kleineres Modell/einen API-Pfad verwenden |
| Grenzen für Burst-Concurrency | Requests stauen sich während Startfenstern | Endpunkt-Concurrency vor dem Start Lasttest unterziehen |
| Retry-Verstärkung | Fehlgeschlagene Jobs vervielfachen berechnete Versuche | Akzeptierte Ausgaben verfolgen, nicht versuchte Ausgaben |
| Datenübertragung | Eingaben, Gewichte und Ausgaben werden wiederholt verschoben | Artefakte in der Nähe der Worker halten und temporäre Dateien ablaufen lassen |
Die Beschaffungsfrage lautet nicht „Unterstützt der Anbieter Serverless GPU?“, sondern „Was passiert mit den Kosten pro akzeptierter Ausgabe, wenn Worker kalt sind, Warteschlangen voll sind und Retries auftreten?“
Kostenfallen bei dedizierten GPUs
Die Ökonomie dedizierter GPUs kann in die entgegengesetzte Richtung enttäuschen.
| Falle | Was passiert | Kontrolle |
|---|---|---|
| Leerlaufender Endpunkt | Die GPU bleibt für seltene Anfragen warm | Autoscaling, Workloads konsolidieren oder bei geringem Volumen Serverless/Modell-API verwenden |
| Überprovisionierter Speicher | Eine große GPU führt einen Workload aus, der auf kleinere Hardware passt | Speicherbedarf und Durchsatz des Modells vor der Entscheidung benchmarken |
| Reservierungs-Mismatch | Der Vertrag geht von einer Nachfrage aus, die nie eintritt | Auf Basis der gemessenen Grundlast reservieren, nicht auf Basis von Launch-Prognosen |
| Verantwortung für den Serving-Stack | Ingenieure pflegen die Runtime statt Produktfunktionen | Plattformarbeit in die TCO einrechnen |
| Versteckte Cloud-Positionen | Speicher, Egress, Support und Networking liegen außerhalb der GPU-Rate | Einen vollständigen Arbeitsbogen für versteckte GPU-Cloud-Kosten verwenden |
| Model-Churn | Eine neue Modellfamilie ändert Speicher-, Präzisions- oder Runtime-Anforderungen | Ausstiegspfade offen halten |
| Incident-Last | Verfügbarkeit wird zum Problem Ihres Teams | Alerts, Fallback und den Support-Umfang des Anbieters definieren |
Die Kontrolle durch eine dedizierte GPU ist nur dann wertvoll, wenn das Team sie nutzen kann. Wenn der Workload nicht stabil genug ist, um ihn zu optimieren, kann die zusätzliche Kontrolle zu operativem Ballast werden.
Durchgerechnetes Beispiel: Warum sich die Antwort mit der Auslastung ändert
Angenommen, ein Team betreibt eine asynchrone Mediengenerierungsfunktion. Die exakten Raten sind hypothetisch; ersetzen Sie sie vor dem Kauf durch geprüfte Anbieterpreise.
| Feld | Serverless GPU | Dedizierte GPU |
|---|---|---|
| Angenommene Jobs pro Monat | 120.000 | 120.000 |
| Ausgewiesene Rechenleistung | nutzungsabhängig | feste monatliche Kapazität |
| Cold Start- und Warteschlangenverschwendung | Höher | Niedriger |
| Leerlaufkapazität | Niedriger | Höher |
| Laufzeitkontrolle | Niedriger | Höher |
| Bester Fall bei Risiko | Nachfrage ist unbekannt | Nachfrage ist stabil |
Wenn die meisten Jobs in kurzen Wellen eintreffen und der Rest des Tages ruhig ist, kann Serverless GPU gewinnen, weil ungenutzte dedizierte Kapazität vermieden wird. Wenn Jobs den ganzen Tag über gleichmäßig eintreffen und das Modell einen langsamen Warm-up-Pfad hat, kann dedizierte GPU gewinnen, weil die Worker warm bleiben und der Durchsatz leichter zu optimieren ist.
Ändern Sie nun die Workload zu LLM-Inferenz mit Kundenkontakt und strikter Latenz. Die Entscheidung kann sich selbst dann umkehren, wenn Serverless bei geringem Traffic günstiger aussieht, weil Cold-Start-Pfade und Warteschlangenverzögerung ein Produktrisiko erzeugen. In diesem Fall kann eine dedizierte GPU oder eine verwaltete Modell-API mit etablierten Latenzkontrollen die sicherere Wahl sein.
Der Punkt ist nicht, dass ein Modell immer gewinnt. Der Punkt ist, dass Serverless GPU vs. dedizierte GPU anhand der gemessenen Workload-Form entschieden werden sollte.
Benchmark-Plan vor der Entscheidung
Führen Sie dieselbe Workload für ein repräsentatives Testfenster über beide Pfade aus. Verfolgen Sie diese Metriken.
| Metrik | Serverless-GPU-Pfad | Dedizierter GPU-Pfad |
|---|---|---|
| Angenommene Outputs | Zählen Sie erfolgreiche Outputs nach Qualitätsfiltern | Gleicher Nenner |
| Versuchte Outputs | Fehlgeschlagene und erneut versuchte Jobs einschließen | Fehlgeschlagene und erneut versuchte Jobs einschließen |
| p50 / p95 / p99-Latenz | Warteschlangen- und Cold-Start-Zeit einschließen | Routing- und Batch-Zeit einschließen |
| Zeit bis zur ersten nützlichen Arbeit | Worker-Start, Modell-Ladevorgang, Warm-up | Deploy-Start, Modell-Ladevorgang, Rollout |
| Anteil Cold Starts | Prozentsatz der Anfragen, die auf kalte Worker treffen | Nach dem Warm-up meist niedriger |
| Wartezeit in der Warteschlange | Endpoint-Warteschlangenverzögerung und Konkurrrenzdruck | Scheduler-Warteschlange und Batch-Wartezeit |
| GPU-Auslastung | Aktive Zeit des Workers, falls verfügbar | GPU-Compute- und Speicherauslastung |
| Leerlaufkosten | Meist niedriger, aber Mindestwerte prüfen | Hauptrisiko bei den Kosten |
| Retry-Rate | Timeout, Worker-Fehler, Kapazitätsfehler | OOM, Deploy-, Laufzeit- und Host-Fehler |
| Ingenieurstunden | Integration und Endpoint-Debugging | Plattformbetrieb und Incident-Arbeit |
Der Test sollte kalte Bedingungen, warme Bedingungen, Burst-Traffic, normalen Traffic und Fehlerbehebung abdecken. Ein Benchmark, der nur den Warm-Throughput misst, ist keine Entscheidung zwischen Serverless GPU und dedizierter GPU; er ist ein Teilgeschwindigkeitstest.
Quellen-Checkliste für Anbieter
Verwenden Sie offizielle Seiten als Quellen-Checklisten, nicht als eingefrorene Preistabellen. Prüfen Sie sie am Tag der Freigabe der Ausgaben erneut.
| Anbieter/Kategorie | Zu prüfende offizielle Quelle | Was erfasst werden soll |
|---|---|---|
| RunPod Serverless | RunPod Serverless overview, RunPod Serverless pricing | Endpoint-Modell, Worker-Verhalten, Abrechnungsbasis, Cold-Start-Verhalten, Speicher, Netzwerk, Parallelität, Logs, Limits |
| RunPod Pods / dedizierter Stil | RunPod Pods overview, RunPod Pods pricing, RunPod pricing | GPU-Modell, Secure-/Community-Modus, Pod-Abrechnung, Speicher, Netzwerkvolumen, Uptime-Erwartungen |
| Modal | Modal GPU docs, Modal cold starts, Modal pricing | GPU-Typ, Funktionslebenszyklus, Cold-Start-Kontrollen, Container-Image-Strategie, Abrechnung aktiver Nutzung |
| Google Cloud Run mit GPUs | Cloud Run GPU configuration, Cloud Run pricing | GPU-Dienstbeschränkungen, Mindestinstanzen, Parallelität, CPU-/Speicher-/GPU-Abrechnung, Einfluss auf die Anfragelatenz |
| Google Compute Engine GPUs | Compute Engine GPU pricing | GPU-Typ, Region, VM-Kosten, Disk, Netzwerk, Reservierungen, Rabatte für committed use |
| AWS EC2 GPU instances | Amazon EC2 pricing | On-Demand, Spot, Savings Plans, Reserved Instances, Capacity Blocks, Storage, Datentransfer, Support |
| Lambda Cloud | Lambda GPU Cloud | Instanztyp, Verfügbarkeit, On-Demand-/Reserved-Bedingungen, Speicher, Netzwerk, Supportumfang |
| Replicate deployments | Replicate deployments docs | Deployment-Einstellungen, Skalierungsverhalten, Hardwareoptionen, minimale/maximale Instanzen, Eignung als Produktions-Endpoint |
Für diesen Artikel wurde die Quellen-Checkliste am 13. Oktober 2026 geprüft.
Beschaffungsfragen, bevor Sie sich festlegen
Stellen Sie diese Fragen, bevor Sie sich für Serverless GPU vs. dedizierte GPU entscheiden.
| Frage | Warum das wichtig ist |
|---|---|
| Was ist der Nenner für akzeptierte Ausgaben? | Verhindert, dass Anfragenversuche mit erfolgreichen Geschäftsergebnissen verglichen werden. |
| Wie oft ist der Endpoint kalt? | Cold Starts können bei sporadischen Workloads Latenz und Kosten dominieren. |
| Wie lange dauert das Laden des Modells? | Große Gewichte können die Einsparungen durch Serverless zunichtemachen. |
| Was passiert bei Burst-Concurrency? | Sowohl Serverless-Warteschlangen als auch dedizierte Autoscaler brauchen Stresstests. |
| Wie hoch ist die Leerlaufrate der dedizierten GPU? | Ungenutzte Kapazität ist das größte Leck bei den Fixkosten. |
| Können Jobs sicher erneut versucht werden? | Serverless- und Spot-ähnliche Workflows brauchen Idempotenz. |
| Brauchen wir benutzerdefinierte Runtime-Kontrolle? | Wenn nicht, ist der Besitz einer dedizierten GPU möglicherweise unnötig. |
| Sind Speicher, Egress, Logs und Support enthalten? | GPU-Compute ist nur ein Teil der Rechnung. |
| Kann der Workload auf eine Modell-API umgestellt werden? | Produkte mit niedriger Auslastung oder mehreren Modellen rechtfertigen den GPU-Betrieb möglicherweise nicht. |
| Wie sieht der Exit-Pfad aus, wenn sich das Modell ändert? | Hardware-Verpflichtungen werden riskant, wenn sich die Modellarchitektur verschiebt. |
Das beste Beschaffungspaket umfasst ein Benchmark-Ergebnis, ein Arbeitsblatt zu Kosten pro akzeptierter Ausgabe und einen klaren Grund, warum das Team entweder nutzungsabhängige Serverless-GPU-Kapazität oder kontrollierte dedizierte GPU-Kapazität benötigt.
Wann eine Modell-API beide übertrifft
Sowohl Serverless GPU als auch dedizierte GPU setzen voraus, dass der Betrieb auf der GPU-Ebene sinnvoll ist. Manchmal ist das nicht der Fall.
Eine verwaltete Modell-API oder ein Gateway kann besser sein, wenn:
- Die Nachfrage unbekannt oder burstartig ist.
- Das Produkt mehrere Modelle benötigt, nicht nur ein stabiles selbst gehostetes Modell.
- Das Team Frontier- oder proprietäre Modelle benötigt.
- Zuverlässigkeit, Fallback und Anbieterdiversität wichtiger sind als Host-Kontrolle.
- Die Finanzabteilung Nutzungsnachweise, Budgets und eine einzige Rechnung benötigt.
- Die Engineering-Zeit besser für Produktverhalten als für GPU-Betrieb genutzt wird.
Flatkey passt zu dieser Seite der Entscheidung. Es gibt Teams einen OpenAI-kompatiblen Weg, einen Schlüssel, ein Guthaben, eine Rechnung, Nutzungsübersicht und Zugriff auf offizielle Modellendpunkte über verschiedene Anbieter hinweg. Wenn das Arbeitsblatt für Serverless GPU vs. dedizierte GPU eine niedrige Auslastung, hohe Cold-Start-Verschwendung oder zu viel operativen Overhead zeigt, vergleichen Sie diesen Weg mit AI-Modell-Preisvergleich, AI-API-Preisvergleich und Ausgabenmanagement für AI-APIs, bevor Sie sich auf GPU-Infrastruktur festlegen.
Abschließende Empfehlung
Verwenden Sie diese Abfolge für Entscheidungen zwischen Serverless GPU und dedizierter GPU:
- Verwenden Sie Serverless GPU für Prototypen, burstartige Jobs, asynchrone Warteschlangen und unbekannte Nachfrage.
- Messen Sie Cold Starts, Warteschlangenverzögerung, Wiederholungsrate und Kosten pro akzeptierter Ausgabe.
- Verschieben Sie stabile, volumenstarke, latenzsensitive Workloads erst dann auf dedizierte GPU-Kapazität, wenn die Auslastung nachgewiesen ist.
- Halten Sie einen Modell-API-Pfad offen, wenn sich die Modellauswahl häufig ändert, Hardware-Kontrolle nicht erforderlich ist oder das Team sauberere Abrechnung und Fallback benötigt.
Serverless GPU vs. dedizierte GPU ist keine universelle Gewinner-nehmen-alles-Entscheidung. Serverless GPU bringt Flexibilität und geringeres Leerlaufrisiko. Dedizierte GPU bringt Kontrolle und wärmere Kapazität. Die richtige Antwort ist diejenige, die Ihrem Team die niedrigsten Kosten pro akzeptierter Ausgabe liefert und gleichzeitig Latenz, Zuverlässigkeit und operatives Risiko dort platziert, wo Sie sie tatsächlich managen können.
Häufig gestellte Fragen
Ist Serverless GPU günstiger als dedizierte GPU?
Serverless GPU ist günstiger, wenn der Traffic niedrig, burstartig oder so unsicher ist, dass dedizierte GPUs sonst im Leerlauf wären. Dedizierte GPU ist günstiger, wenn die Auslastung hoch ist, das Modell warm bleibt und das Team den Serving-Stack effizient betreiben kann.
Hat Serverless GPU immer Cold Starts?
Nicht jede Anfrage wird kalt sein, und Anbieter bieten unterschiedliche Steuerungen für warme Kapazität, Mindestanzahl an Workern, Bildoptimierung und Skalierung. Aber Cold Starts sind ein zentrales Risiko bei der Bewertung von Serverless GPU, da große Modelle und Container spürbare Zeit brauchen können, um nutzbar zu werden.
Wann sollte ich von Serverless GPU zu dedizierter GPU wechseln?
Wechseln Sie, wenn Sie stabile Nachfrage, hohe Auslastung, inakzeptable Cold-Start-Latenz, den Bedarf an benutzerdefinierter Runtime-Kontrolle oder einen Kostenvorteil pro akzeptierter Ausgabe nach Einbeziehung von Betrieb und Leerlaufzeit nachweisen können.
Ist dedizierte GPU besser für LLM-Inferenz?
Dedizierte GPU kann für stabile, volumenstarke LLM-Inferenz besser sein, besonders wenn Sie vLLM, SGLang, TensorRT-LLM, Batching, Cache-Verhalten und das Laden des Modells optimieren. Für Produkte mit geringem Volumen, mehreren Modellen oder schnell wechselnden Anforderungen kann eine Modell-API einfacher und günstiger sein.
Was sollte ich zuerst messen?
Messen Sie akzeptierte Ausgaben, Anteil der Cold Starts, Warteschlangenwartezeit, p95/p99-Latenz, Wiederholungsrate, sinnvolle GPU-Auslastung, Leerlaufkosten, Speicher/Egress und Engineering-Stunden. Diese Kennzahlen machen die Entscheidung zwischen Serverless GPU und dedizierter GPU belastbar.


