
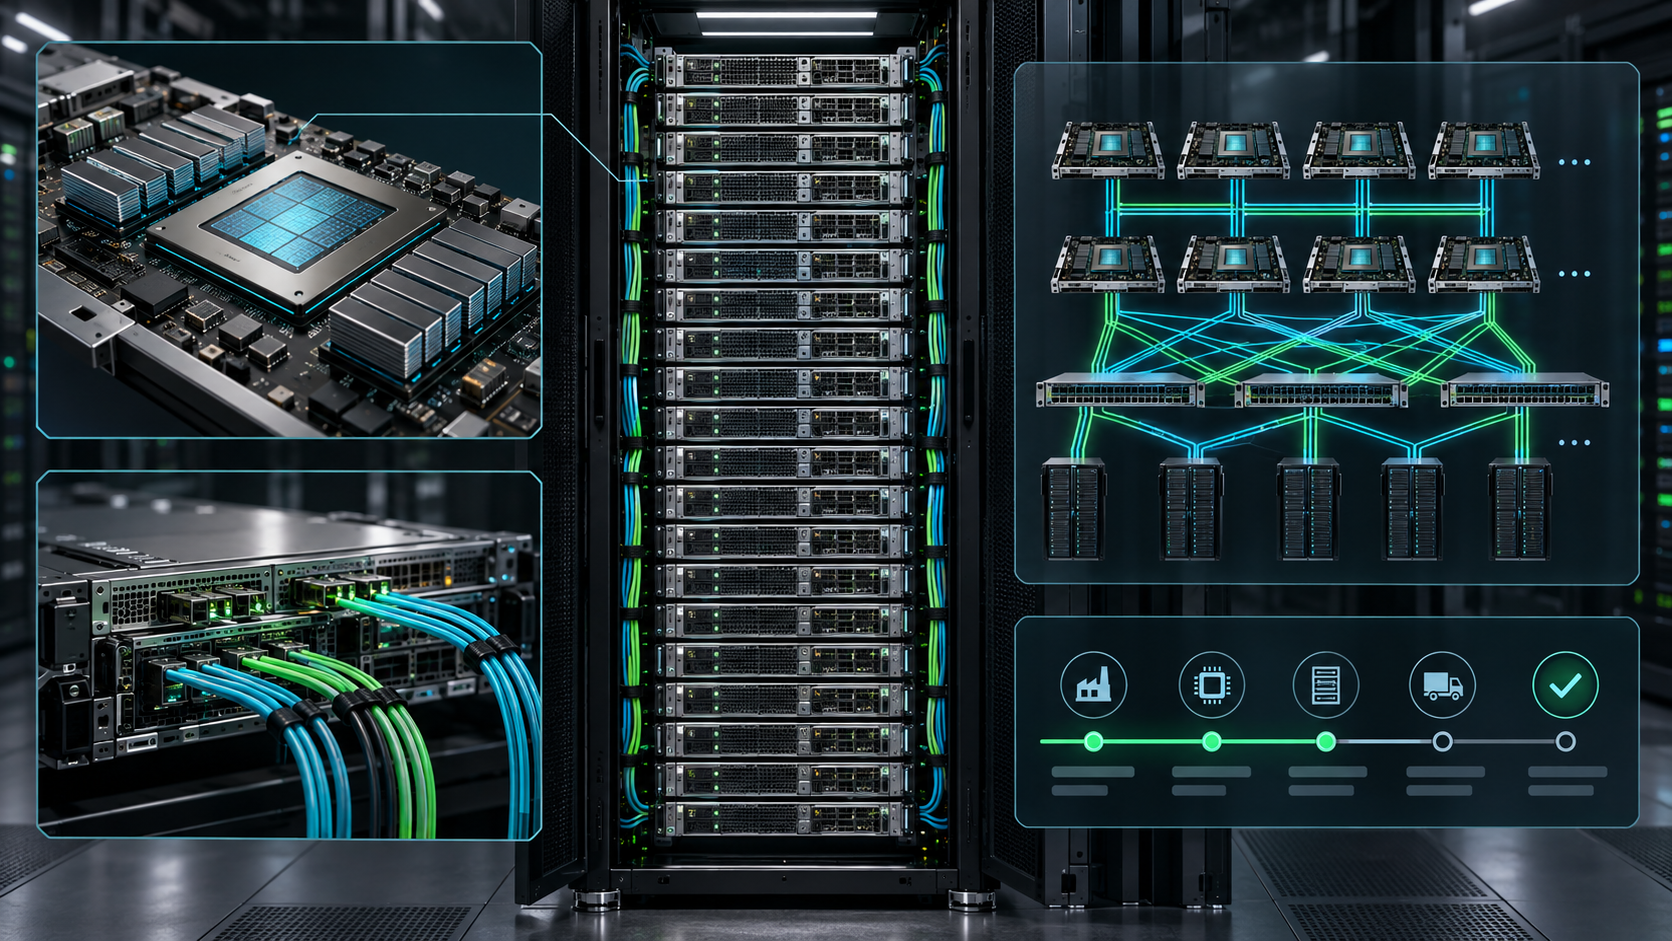
O AMD MI455X é o acelerador a observar se o seu roadmap de GPU depende de infraestrutura de IA em rack aberto, em vez de uma única placa PCIe ou de uma instância única na nuvem. A AMD posiciona o Instinct MI455X como a GPU dentro da plataforma em rack Helios: um sistema baseado em 72 GPUs, com HBM4, voltado para treinamento em grande escala, pós-treinamento e inferência de alto throughput.
Para compradores, a pergunta útil não é apenas "quais são as especificações do AMD MI455X?" Também é: quanta memória HBM4 o rack expõe, qual número de largura de banda deve ser usado no modelo, quando você realmente pode obter capacidade e o vLLM está habilitado em GPUs AMD Instinct MI455X em uma imagem de produção?
Este rastreador resume o registro público até 13 de outubro de 2026 e separa as afirmações confirmadas pela AMD das suposições do comprador.
Resposta Rápida: O Que É o AMD MI455X?
O AMD MI455X é uma GPU de data center AMD Instinct baseada na arquitetura CDNA Next da AMD. A página pública do produto da AMD lista 432 GB de memória HBM4 e 23,3 TB/s de largura de banda de memória de pico por acelerador MI455X. No rack AMD Helios, 72 GPUs MI455X combinam para cerca de 31 TB de memória HBM4 e aproximadamente 1,67 PB/s de largura de banda agregada de memória da GPU.
A AMD descreveu o Helios como uma plataforma em escala de rack para infraestrutura de IA aberta, e não como um SKU de acelerador independente. Isso importa porque a maioria das equipes avaliará o AMD MI455X por meio de capacidade na nuvem, reservas de rack, clusters gerenciados e imagens de software, e não comprando uma única GPU avulsa.
Rastreador AMD MI455X
| Campo | Status Público Atual | Conclusão para o Comprador |
|---|---|---|
| GPU | AMD Instinct MI455X | Trate-o como o acelerador carro-chefe da série MI400 para o planejamento do Helios. |
| Arquitetura | AMD CDNA Next | Arquitetura de IA AMD de nova geração; espere que a validação da stack de software seja importante. |
| Capacidade de memória | 432 GB de HBM4 por GPU | Grande folga para cache KV, contexto longo, especialistas MoE e serving de modelos grandes. |
| Largura de banda de memória | 23,3 TB/s de pico por GPU | Use este valor atual da AMD ao modelar largura de banda, e não números anteriores ao briefing. |
| Plataforma em rack | AMD Helios | A unidade prática de aquisição provavelmente será a capacidade do rack ou do cluster. |
| GPUs por rack Helios | 72 GPUs MI455X | Decisões comparáveis devem ser tomadas no nível da topologia do rack, e não apenas no nível da placa GPU. |
| Memória do rack | Cerca de 31 TB HBM4 | Útil para inferência de modelos grandes, pós-treinamento e modelos de agendamento multi-tenant. |
| Largura de banda de memória do rack | Cerca de 1,67 PB/s agregado | Cargas de trabalho sensíveis à largura de banda devem solicitar benchmarks reais de tokens/s e tempo por etapa. |
| Stack de software | ROCm, stack de desenvolvedor da AMD e suporte a frameworks | O vLLM pode executar em plataformas AMD ROCm, mas as imagens de produção do MI455X ainda precisam de validação do provedor. |
| Disponibilidade | A AMD posicionou o MI400/Helios para o ciclo de infraestrutura de 2026 | A disponibilidade real depende do inventário do provedor, da região, de programas de prévia e dos termos de reserva. |
Arquitetura AMD MI455X: Por Que o CDNA Next Importa
O AMD MI455X não é apenas um aumento incremental de memória para equipes que já usam MI300X. Ele pertence à próxima geração Instinct da AMD, e o sistema Helios ao redor muda a conversa de aquisição de "qual instância de GPU devo alugar?" para "qual topologia de rack, stack de software e compromisso do provedor podem passar nos nossos testes de workload?"
As questões arquiteturais que mais importam são práticas:
- Memória por GPU: 432 GB de HBM4 muda quanto estado do modelo, cache KV e folga para batching podem permanecer próximos do acelerador.
- Largura de banda de memória: 23,3 TB/s de largura de banda de pico por AMD MI455X é a especificação a ser benchmarkada para workloads de inferência e pós-treinamento limitados por memória.
- Topologia de scale-up: o Helios coloca 72 GPUs MI455X em um único sistema em escala de rack, então posicionamento, interconexão, domínios de falha e consciência do scheduler importam.
- Maturidade do software: a capacidade do CDNA Next só é útil quando kernels, imagens ROCm, suporte a vLLM/SGLang, observabilidade e orquestração estão estáveis para o seu modelo.
- Empacotamento pelo provedor: compradores de nuvem podem ver racks completos, racks parciais, clusters privados, inferência gerenciada ou prévias de benchmark antes de instâncias on-demand comuns.
É por isso que o AMD MI455X deve ficar ao lado do seu modelo de TCO de cluster de GPU, e não apenas dentro de uma tabela bruta de comparação de aceleradores.
Especificações do AMD MI455X: O Que Está Confirmado
Estes são os valores principais para colocar hoje em uma planilha de planejamento:
| Especificação | Valor Público do AMD MI455X |
|---|---|
| Família de produto | Série AMD Instinct MI400 |
| GPU | AMD Instinct MI455X |
| Arquitetura | AMD CDNA Next |
| Memória | 432 GB HBM4 |
| Largura de banda de memória de pico | 23,3 TB/s |
| Plataforma primária | Rack AMD Helios |
| Quantidade de GPUs no Helios | 72 GPUs AMD Instinct MI455X |
| Memória do Helios | Cerca de 31 TB HBM4 |
| Largura de banda agregada de memória do Helios | Cerca de 1,67 PB/s, com base em 72 x 23,3 TB/s |
A palavra-chave secundária "amd mi455x memory bandwidth" é especialmente importante porque parte da discussão inicial pode ficar atrás dos números atuais da página do produto. Se uma cotação de provedor, deck de apresentação ou benchmark disser 19,6 TB/s, peça a data da स्रोत da informação e se a cotação reflete a orientação atual do produto MI455X.
AMD Helios: O Rack É o Produto
AMD Helios é a plataforma em escala de rack construída em torno do AMD MI455X. Para compradores de infraestrutura, isso significa que as especificações mais importantes não são apenas os números por GPU. O rack precisa ser avaliado como um sistema:
| Área de Planejamento do Helios | O que Perguntar |
|---|---|
| Topologia do rack | O provedor está oferecendo um rack Helios completo, um rack segmentado ou um serviço gerenciado de nível superior? |
| Posicionamento da GPU | Seu trabalho pode reservar uma topologia contígua do MI455X ou o posicionamento será fragmentado? |
| Visibilidade da memória | Quanto dos 31 TB nominais de HBM4 é utilizável após o framework, o paralelismo tensorial e o overhead do agendador? |
| Fabric de rede | Qual rede de scale-up e scale-out está exposta e quais contadores ficam visíveis para os clientes? |
| Path de armazenamento | O armazenamento de checkpoints, datasets e embeddings pode alimentar o rack sem criar tempo ocioso de GPU? |
| Domínio de falha | O que acontece quando uma bandeja, NIC, switch ou componente de energia/resfriamento falha no meio da execução? |
| Imagem de software | Quais versões de ROCm, Linux, Kubernetes, Slurm, vLLM, SGLang, PyTorch e monitoramento são suportadas? |
| Teste de aceitação | Você pode executar seu próprio modelo, comprimentos de sequência, mix de batch e SLOs antes de se comprometer? |
O Helios também deve ser comparado com sistemas concorrentes em escala de rack e com uma linha de base de API de modelo gerenciado. Se o seu produto só precisa de saídas confiáveis do modelo e não de controle direto do hardware, leia isto em conjunto com cloud de GPU vs API de modelo antes de reservar capacidade de rack.
Por que HBM4 é a especificação do AMD MI455X a observar
A busca "amd mi455x memory capacity hbm4" existe porque a memória agora é um dos principais filtros de compra para infraestrutura de IA. O HBM4 afeta tanto a capacidade quanto a velocidade:
- Inferência de contexto longo: Mais HBM oferece maior folga de KV cache antes que o tamanho do batch ou o comprimento do contexto precisem ser reduzidos.
- Grandes modelos MoE: Mais memória local ajuda com especialistas ativos, estado de roteamento e menos offload agressivo.
- Pós-treinamento: Pipelines de SFT, otimização de preferência e aprendizado por reforço podem ser limitados pela memória de ativações e do otimizador.
- Densidade de tenants: Mais memória pode suportar mais variantes de modelos, réplicas ou clientes por topologia reservada, se o isolamento for bem projetado.
- Custo por saída aceita: Tamanhos de batch maiores só ajudam se latência, qualidade, retentativas e recuperação de falhas permanecerem dentro do SLO do produto.
Não compre com base apenas na capacidade de memória. Peça aos provedores evidências no nível da carga de trabalho: tokens/s no seu comprimento de contexto, tempo até o primeiro token, latência de batch, taxa de aceitação da qualidade do modelo, tempo de fila, custo de execução com falha e tempo de recuperação operacional.
O vLLM está habilitado nas GPUs AMD Instinct MI455X?
A resposta precisa é: o vLLM é suportado em plataformas AMD ROCm, e a AMD posiciona sua pilha de software de IA em torno do suporte a frameworks abertos, mas você deve verificar o habilitamento do vLLM específico do MI455X com a imagem real do provedor de nuvem antes de tratá-lo como pronto para produção.
Essa distinção é importante. "ROCm suporta vLLM" não é o mesmo que "esta região MI455X, este driver, este conjunto de kernel, esta imagem de contêiner e este modelo e esta topologia de serving são todos suportados em produção pelo meu provedor".
Use esta checklist de validação do vLLM:
- Confirme a versão do ROCm do provedor e se o MI455X está listado nas notas de versão da imagem.
- Pergunte se o vLLM vem pré-instalado, é suportado pelo provedor ou é suportado pela comunidade.
- Execute seu modelo-alvo com a mesma quantização, paralelismo tensorial, comprimento de sequência e concorrência que você espera em produção.
- Meça prefill, decode, tempo até o primeiro token, throughput, taxa de erro e pressão de memória da GPU.
- Verifique se opções alternativas de serving, como SGLang, Triton ou inferência gerenciada pelo provedor, estão disponíveis.
- Verifique a política de atualização, o procedimento de rollback, a observabilidade e a compatibilidade do kernel antes de assinar um contrato de capacidade reservada.
Se o provedor ainda não puder responder a essas perguntas, trate o suporte ao vLLM no AMD MI455X como um item de avaliação, e não como uma afirmação pronta de produção.
Data de lançamento e rastreador de disponibilidade do AMD MI455X
A demanda de busca em torno de "amd mi455x release date" geralmente significa que os compradores querem saber quando podem alugar, benchmarkar ou reservar capacidade. A forma correta de acompanhar isso é por marco, e não por uma única data:
| Marco | O que é Publicamente Útil | O que os Compradores Ainda Precisam |
|---|---|---|
| Divulgação do produto | A AMD listou publicamente as especificações do produto MI455X e os detalhes da plataforma Helios. | Confirmar a data da revisão da especificação nas cotações do provedor. |
| Habilitação de software | O ROCm e o suporte de software de IA da AMD são centrais para a história da plataforma. | Confirmar suporte à imagem específica do MI455X, versões de frameworks e status do vLLM/SGLang. |
| Disponibilidade do sistema | A AMD posiciona o Helios para o ciclo de infraestrutura de IA de 2026. | Confirmar as primeiras regiões de provedores, o modelo de alocação e as janelas de capacidade. |
| Prévia na nuvem | Capacidade inicial pode aparecer como acesso a benchmark ou prévia privada. | Pedir uma topologia representativa, não benchmarks de marketing isolados. |
| Aluguel geral | Capacidade sob demanda pode ficar atrás da disponibilidade no nível do sistema. | Comparar termos de on-demand, reservado, cluster privado e serviço gerenciado. |
A regra prática: não equipare o roadmap de hardware da AMD com a capacidade disponível da sua equipe. Inventário do provedor, região, energia, resfriamento, rede, imagens de software e termos comerciais todos determinam quando a capacidade do AMD MI455X pode ser usada.
Quando esperar pelo AMD MI455X
Aguardar por capacidade AMD MI455X ou Helios pode fazer sentido quando:
- Sua carga de trabalho é limitada por memória e 432 GB de HBM4 por GPU mudam a economia.
- Você precisa de controle em escala de rack para treinamento, pós-treinamento, inferência de MoE em larga escala ou serving personalizado.
- Você pode fazer benchmark com prompts em formato de produção, janelas de contexto e concorrência.
- Sua equipe está pronta para operar imagens ROCm, políticas de agendador, contadores de rede, armazenamento e recuperação de falhas.
- Sua janela de aquisição pode tolerar incerteza de preview do provedor, alocação e região.
Aguardar é arriscado quando:
- Você precisa de capacidade de produção voltada ao usuário agora.
- Sua carga de trabalho pode usar modelos hospedados por meio de uma API sem controle direto da GPU.
- Você não tem utilização suficiente para amortizar um rack reservado ou cluster privado.
- Seu principal gargalo é roteamento, confiabilidade, avaliação, atribuição de gastos ou fluxo de trabalho do usuário, e não acesso bruto ao acelerador.
- Você não pode executar um benchmark de aceitação antes de assumir um compromisso de prazo.
Para muitas equipes, o caminho pragmático é híbrido: use APIs de modelo para produção agora, faça benchmark de MI455X ou Helios quando a capacidade aparecer e reserve hardware apenas depois que ele superar sua linha de base de modelo/API em custo por saída aceita.
Perguntas ao Provedor para Capacidade AMD MI455X
Antes de reservar capacidade AMD MI455X, envie aos provedores esta lista de verificação:
- Vocês estão oferecendo AMD MI455X, AMD Helios ou uma configuração diferente da série MI400?
- A capacidade é de rack completo, rack parcial, cluster privado, inferência gerenciada, preview ou instância sob demanda?
- Quais regiões têm inventário físico e qual é a janela de alocação?
- Quais versões de ROCm, kernel, driver, firmware, Slurm/Kubernetes, PyTorch, vLLM e SGLang são compatíveis?
- Podemos executar nosso modelo, mix de prompts, comprimento de contexto, concorrência e harness de avaliação antes de comprometer?
- Quais são os custos de tempo de fila, retry, job com falha, egress, armazenamento e suporte?
- Quais telemetrias estão expostas para utilização da GPU, pressão de HBM, largura de banda de memória, contadores de rede e falhas de job?
- O que acontece se as especificações públicas, o prazo de entrega ou os resultados de benchmark mudarem após a assinatura do contrato?
- Quais controles de segurança existem para isolamento de tenants, tratamento de dados e evidências de auditoria?
- Como o preço se compara com os atuais preços de aluguel de GPU, GPU sem servidor vs GPU dedicada e alternativas de modelos/API gerenciados?
Visão da Flatkey: Acompanhe o MI455X, mas Mantenha uma Base de Produção
A AMD MI455X é importante porque oferece aos compradores uma alternativa séria de HBM4 e em escala de rack para o próximo ciclo de infraestrutura de IA. Ela deve ser acompanhada por qualquer pessoa que planeje inferência de modelos grandes, pós-treinamento ou capacidade privada de fábrica de IA.
Ela não é automaticamente o primeiro movimento certo para toda equipe de produto de IA. Se seu produto precisa de acesso confiável às saídas do modelo, visibilidade de custos, roteamento de fallback e uma única superfície de cobrança, uma camada de modelo/API gerenciada pode manter a produção em andamento enquanto o fornecimento do MI455X e as imagens de software amadurecem.
A Flatkey foi criada para esse caminho: uma chave, um saldo e roteamento entre APIs oficiais de modelos e ferramentas. Use a Flatkey como a base de produção na sua análise da AMD MI455X para comparar hardware em escala de rack com um caminho de implantação funcionando, e não com uma planilha em branco.
Perguntas frequentes
O que é AMD MI455X?
A AMD MI455X é um acelerador de data center da série AMD Instinct MI400 baseado na arquitetura AMD CDNA Next. A AMD lista 432 GB de memória HBM4 e 23,3 TB/s de largura de banda de memória de pico para a GPU.
O que é AMD Helios?
A AMD Helios é uma plataforma de IA em escala de rack construída em torno de 72 GPUs AMD Instinct MI455X. Nessa escala, o rack expõe cerca de 31 TB de memória HBM4 e cerca de 1,67 PB/s de largura de banda agregada de memória da GPU.
Qual é a capacidade de memória do AMD MI455X?
A capacidade pública de memória do AMD MI455X é de 432 GB de HBM4 por GPU. Um rack Helios com 72 GPUs, portanto, chega a cerca de 31 TB de memória HBM4 antes de considerar a sobrecarga prática de software e agendamento.
Qual é a largura de banda de memória do AMD MI455X?
A cifra pública atual da MI455X da AMD é de 23,3 TB/s de largura de banda de memória de pico por GPU. Para um rack Helios com 72 GPUs, isso implica cerca de 1,67 PB/s de largura de banda agregada de memória.
Qual é a data de lançamento do AMD MI455X?
A AMD divulgou publicamente a MI455X e posicionou a Helios para o ciclo de infraestrutura de IA de 2026. Os compradores devem acompanhar o inventário específico do provedor, a região, o acesso de preview, as imagens de software e os termos de reserva, em vez de assumir uma única data universal de aluguel.
O vLLM está habilitado nas GPUs AMD Instinct MI455X?
O vLLM é compatível com plataformas AMD ROCm, mas a habilitação específica de produção do MI455X depende da imagem do provedor, da versão do ROCm, dos kernels, do modelo, da configuração de serving e da política de suporte. Verifique isso com o provedor antes de comprometer tráfego de produção.
Fontes verificadas
- Página do produto AMD Instinct MI455X: https://www.amd.com/en/products/accelerators/instinct/mi400/mi455x.html
- Página da solução AMD Helios: https://www.amd.com/en/solutions/ai/helios.html
- AMD Newsroom, roadmap de IA e anúncios de infraestrutura de IA aberta: https://www.amd.com/en/newsroom/press-releases/2025-6-12-amd-unveils-ai-roadmap-and-comprehensive-full-stack-open-ai-infrastructure-solutions.html
- Documentação do AMD ROCm vLLM: https://rocm.docs.amd.com/en/latest/how-to/rocm-for-ai/inference-optimization/vllm.html


