
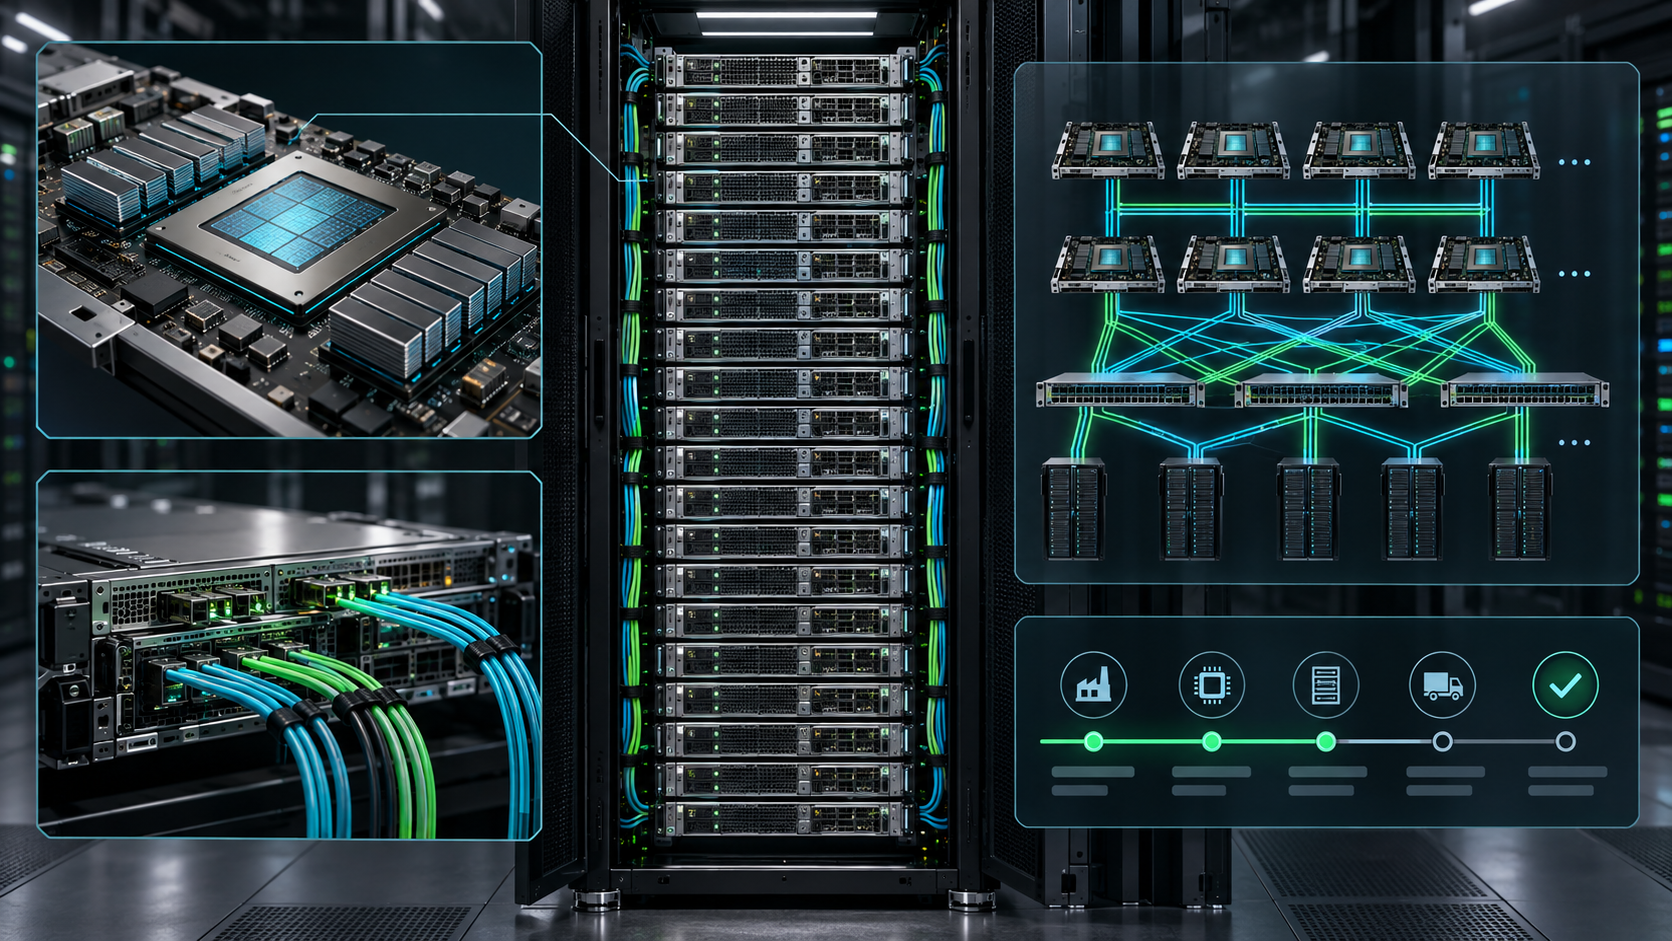
El AMD MI455X es el acelerador al que debes prestar atención si tu hoja de ruta de GPU depende de una infraestructura de IA abierta a escala de rack en lugar de una sola tarjeta PCIe o una instancia puntual en la nube. AMD posiciona el Instinct MI455X como la GPU dentro de la plataforma de rack Helios: un sistema basado en HBM4 de 72 GPU orientado a entrenamiento a gran escala, postentrenamiento e inferencia de alto rendimiento.
Para los compradores, la pregunta útil no es solo "¿cuáles son las especificaciones del AMD MI455X?" También es: ¿cuánta memoria HBM4 expone el rack, qué cifra de ancho de banda conviene modelar, cuándo se puede obtener capacidad realmente y vLLM está habilitado en las GPU AMD Instinct MI455X en una imagen de producción?
Este rastreador resume el registro público a fecha de 13 de octubre de 2026 y separa las afirmaciones confirmadas por AMD de las suposiciones del comprador.
Respuesta rápida: ¿Qué es AMD MI455X?
El AMD MI455X es una GPU para centros de datos AMD Instinct basada en la arquitectura CDNA Next de AMD. La página pública del producto de AMD indica 432 GB de memoria HBM4 y 23,3 TB/s de ancho de banda máximo de memoria por acelerador MI455X. En el rack AMD Helios, 72 GPU MI455X suman aproximadamente 31 TB de memoria HBM4 y unos 1,67 PB/s de ancho de banda agregado de memoria de GPU.
AMD ha descrito Helios como una plataforma a escala de rack para una infraestructura de IA abierta, en lugar de un SKU de acelerador independiente. Eso importa porque la mayoría de los equipos evaluarán AMD MI455X a través de capacidad en la nube, reservas de rack, clústeres gestionados e imágenes de software, no comprando una GPU suelta.
Rastreador de AMD MI455X
| Campo | Estado público actual | Conclusión para el comprador |
|---|---|---|
| GPU | AMD Instinct MI455X | Trátalo como el acelerador insignia de la serie MI400 para la planificación de Helios. |
| Arquitectura | AMD CDNA Next | Arquitectura de IA de nueva generación de AMD; conviene validar la pila de software. |
| Capacidad de memoria | 432 GB de HBM4 por GPU | Amplio margen para caché KV, contexto largo, expertos MoE y servicio de modelos grandes. |
| Ancho de banda de memoria | 23,3 TB/s máximo por GPU | Usa esta cifra actual de AMD al modelar el ancho de banda, no números anteriores previos al lanzamiento. |
| Plataforma de rack | AMD Helios | La unidad práctica de adquisición probablemente sea la capacidad de rack o de clúster. |
| GPU por rack Helios | 72 GPU MI455X | Las decisiones comparables deben tomarse a nivel de topología de rack, no solo de tarjeta GPU. |
| Memoria del rack | Unos 31 TB de HBM4 | Útil para inferencia de modelos grandes, postentrenamiento y modelos de programación multiinquilino. |
| Ancho de banda de memoria del rack | Unos 1,67 PB/s agregados | Las cargas de trabajo sensibles al ancho de banda deberían solicitar benchmarks reales de tokens/s y tiempo por paso. |
| Pila de software | ROCm, pila de desarrollo de AMD y compatibilidad con frameworks | vLLM puede ejecutarse en plataformas AMD ROCm, pero las imágenes de producción de MI455X aún necesitan validación del proveedor. |
| Disponibilidad | AMD ha posicionado MI400/Helios para el ciclo de infraestructura de 2026 | La disponibilidad real depende del inventario del proveedor, la región, los programas de vista previa y los términos de reserva. |
Arquitectura AMD MI455X: por qué importa CDNA Next
AMD MI455X no es solo un aumento incremental de memoria para los equipos que ya usan MI300X. Pertenece a la próxima generación Instinct de AMD, y el sistema Helios que lo acompaña cambia la conversación de adquisición de "¿qué instancia de GPU deberíamos alquilar?" a "¿qué topología de rack, pila de software y compromiso del proveedor pueden superar las pruebas de nuestra carga de trabajo?"
Las cuestiones de arquitectura que más importan son prácticas:
- Memoria por GPU: 432 GB de HBM4 cambian cuántos estados del modelo, caché KV y margen de batching pueden permanecer cerca del acelerador.
- Ancho de banda de memoria: 23,3 TB/s de ancho de banda máximo por AMD MI455X es la especificación que hay que comparar en cargas de inferencia y postentrenamiento limitadas por memoria.
- Topología de escalado: Helios coloca 72 GPU MI455X en un solo sistema a escala de rack, por lo que la ubicación, la interconexión, los dominios de fallo y la visibilidad del programador importan.
- Madurez del software: La capacidad de CDNA Next solo es útil cuando los kernels, las imágenes ROCm, la compatibilidad con vLLM/SGLang, la observabilidad y la orquestación son estables para tu modelo.
- Empaquetado del proveedor: Los compradores en la nube pueden ver racks completos, racks parciales, clústeres privados, inferencia gestionada o vistas previas de benchmarks antes de las instancias ordinarias bajo demanda.
Por eso el AMD MI455X debería aparecer junto a tu modelo de TCO de clúster de GPU, no solo dentro de una tabla de comparación de aceleradores sin procesar.
Especificaciones de AMD MI455X: lo que está confirmado
Estas son las cifras clave que conviene incluir hoy en una hoja de planificación:
| Especificación | Cifra pública de AMD MI455X |
|---|---|
| Familia de producto | Serie AMD Instinct MI400 |
| GPU | AMD Instinct MI455X |
| Arquitectura | AMD CDNA Next |
| Memoria | 432 GB de HBM4 |
| Ancho de banda máximo de memoria | 23,3 TB/s |
| Plataforma principal | Rack AMD Helios |
| Cantidad de GPU Helios | 72 GPU AMD Instinct MI455X |
| Memoria de Helios | Unos 31 TB de HBM4 |
| Ancho de banda agregado de memoria de Helios | Unos 1,67 PB/s, basado en 72 x 23,3 TB/s |
La palabra clave secundaria "amd mi455x memory bandwidth" es especialmente importante porque parte de la discusión temprana puede ir por detrás de las cifras actuales de la página del producto. Si una cotización de un proveedor, una presentación o un benchmark indica 19,6 TB/s, pide la fecha de la fuente y si esa cifra refleja la guía actual del producto MI455X.
AMD Helios: el producto es el rack
AMD Helios es la plataforma a escala de rack construida en torno al AMD MI455X. Para los compradores de infraestructura, esto significa que las especificaciones más importantes no son solo las cifras por GPU. El rack debe evaluarse como un sistema:
| Área de planificación de Helios | Qué preguntar |
|---|---|
| Topología del rack | ¿El proveedor ofrece un rack Helios completo, un rack particionado o un servicio gestionado de nivel superior? |
| Ubicación de las GPU | ¿Su carga de trabajo puede reservar una topología contigua de MI455X o la ubicación estará fragmentada? |
| Visibilidad de la memoria | ¿Cuánta parte de los 31 TB nominales de HBM4 es utilizable después de la sobrecarga del framework, el paralelismo tensorial y el planificador? |
| Fabric de red | ¿Qué red de scale-up y scale-out se expone, y qué contadores son visibles para los clientes? |
| Ruta de almacenamiento | ¿El almacenamiento de checkpoints, datasets y embeddings puede alimentar el rack sin generar tiempo de GPU ocioso? |
| Dominio de fallo | ¿Qué ocurre cuando falla a mitad de ejecución una bandeja, una NIC, un switch o un componente de alimentación/refrigeración? |
| Imagen de software | ¿Qué versiones de ROCm, Linux, Kubernetes, Slurm, vLLM, SGLang, PyTorch y monitorización son compatibles? |
| Prueba de aceptación | ¿Puede ejecutar su propio modelo, longitudes de secuencia, mezcla de batches y SLO antes de comprometerse? |
También conviene comparar Helios con sistemas competidores a escala de rack y con una línea base de API de modelo gestionada. Si su producto solo necesita resultados de modelo fiables y no control directo del hardware, lea esto junto con cloud de GPU vs API de modelo antes de reservar capacidad de rack.
Por qué HBM4 es la especificación del AMD MI455X que hay que vigilar
La consulta "amd mi455x memory capacity hbm4" existe porque la memoria es ahora uno de los principales filtros de compra para la infraestructura de IA. HBM4 afecta tanto a la capacidad como a la velocidad:
- Inferencia de contexto largo: Más HBM da más margen para la caché KV antes de tener que recortar el tamaño del batch o la longitud del contexto.
- Grandes modelos MoE: Más memoria local ayuda con expertos activos, estado de enrutamiento y un offload menos agresivo.
- Postentrenamiento: Los pipelines de SFT, optimización de preferencias y aprendizaje por refuerzo pueden estar limitados por la memoria de activaciones y del optimizador.
- Densidad de inquilinos: Más memoria puede dar soporte a más variantes de modelos, réplicas o clientes por topología reservada, si el aislamiento está bien diseñado.
- Coste por salida aceptada: Los batches más grandes solo ayudan si la latencia, la calidad, los reintentos y la recuperación ante fallos permanecen dentro del SLO del producto.
No compre basándose solo en la capacidad de memoria. Pida a los proveedores evidencia a nivel de carga de trabajo: tokens/seg para su longitud de contexto, tiempo hasta el primer token, latencia de batch, tasa de aceptación de calidad del modelo, tiempo en cola, coste de ejecución fallida y tiempo de recuperación operativa.
¿Está vLLM habilitado en las GPU AMD Instinct MI455X?
La respuesta precisa es: vLLM está soportado en plataformas AMD ROCm, y AMD posiciona su stack de software de IA en torno al soporte de frameworks abiertos, pero debe verificar la habilitación de vLLM específica para MI455X con la imagen real del proveedor cloud antes de considerarlo listo para producción.
Esa distinción importa. "ROCm soporta vLLM" no es lo mismo que "esta región MI455X, este driver, este conjunto de kernels, esta imagen de contenedor y este topología de serving están todos soportados para producción por mi proveedor".
Use esta lista de verificación para validar vLLM:
- Confirme la versión de ROCm del proveedor y si MI455X aparece en las notas de lanzamiento de la imagen.
- Pregunte si vLLM viene preinstalado, está soportado por el proveedor o si el soporte es comunitario.
- Ejecute su modelo objetivo con la misma cuantización, paralelismo tensorial, longitud de secuencia y concurrencia que espera en producción.
- Mida el prefill, el decode, el tiempo hasta el primer token, el throughput, la tasa de error y la presión de memoria de la GPU.
- Compruebe si hay opciones alternativas de serving como SGLang, Triton o inferencia gestionada por el proveedor.
- Verifique la política de actualizaciones, el procedimiento de rollback, la observabilidad y la compatibilidad del kernel antes de firmar un contrato de capacidad reservada.
Si el proveedor aún no puede responder a esas preguntas, trate el soporte de vLLM en AMD MI455X como un elemento de evaluación y no como una afirmación de producción ya cerrada.
Rastreador de fecha de lanzamiento y disponibilidad de AMD MI455X
La demanda de búsqueda en torno a "amd mi455x release date" suele significar que los compradores quieren saber cuándo pueden alquilar, hacer benchmarks o reservar capacidad. La forma más clara de seguir esto es por hitos y no por una sola fecha:
| Hito | Qué es útil públicamente | Qué siguen necesitando los compradores |
|---|---|---|
| Divulgación del producto | AMD ha publicado públicamente las especificaciones del producto MI455X y los detalles de la plataforma Helios. | Confirme la fecha de revisión de la especificación en las cotizaciones del proveedor. |
| Habilitación del software | El soporte de ROCm y del software de IA de AMD es central en la historia de la plataforma. | Confirme el soporte de imagen específico para MI455X, las versiones de framework y el estado de vLLM/SGLang. |
| Disponibilidad del sistema | AMD posiciona Helios para el ciclo de infraestructura de IA de 2026. | Confirme las primeras regiones de proveedores, el modelo de asignación y las ventanas de capacidad. |
| Vista previa en la nube | La capacidad temprana puede aparecer como acceso a benchmarks o vista previa privada. | Pida una topología representativa, no benchmarks de marketing aislados. |
| Alquiler general | La capacidad bajo demanda puede ir por detrás de la disponibilidad a nivel de sistema. | Compare los términos de capacidad bajo demanda, reservada, clúster privado y servicio gestionado. |
La regla práctica: no equipare la hoja de ruta de hardware de AMD con la capacidad disponible de su equipo. El inventario del proveedor, la región, la alimentación eléctrica, la refrigeración, la red, las imágenes de software y los términos comerciales determinan cuándo la capacidad de AMD MI455X es utilizable.
Cuándo esperar por AMD MI455X
Esperar capacidad de AMD MI455X o Helios puede tener sentido cuando:
- Su carga de trabajo está limitada por la memoria y 432 GB de HBM4 por GPU cambian la economía.
- Necesita control a escala de rack para entrenamiento, post-entrenamiento, inferencia de grandes MoE o serving personalizado.
- Puede hacer benchmarking con prompts, ventanas de contexto y concurrencia parecidos a producción.
- Su equipo está listo para operar imágenes ROCm, políticas de scheduler, contadores de red, almacenamiento y recuperación ante fallos.
- Su ventana de adquisición puede tolerar incertidumbre de vista previa del proveedor, asignación y región.
Esperar es arriesgado cuando:
- Necesita capacidad de producción orientada al usuario ahora.
- Su carga de trabajo puede usar modelos alojados a través de una API sin control directo de GPU.
- No tiene suficiente utilización para amortizar un rack reservado o un clúster privado.
- Su principal cuello de botella es el enrutamiento, la fiabilidad, la evaluación, la atribución del gasto o el flujo de trabajo del usuario, no el acceso bruto al acelerador.
- No puede ejecutar un benchmark de aceptación antes de asumir un compromiso de plazo.
Para muchos equipos, la vía pragmática es híbrida: use APIs de modelos para producción ahora, haga benchmarking de MI455X o Helios cuando aparezca capacidad, y reserve hardware solo después de que supere su referencia de modelo/API en coste por salida aceptada.
Preguntas para proveedores sobre capacidad AMD MI455X
Antes de reservar capacidad AMD MI455X, envíe a los proveedores esta lista de verificación:
- ¿Están ofreciendo AMD MI455X, AMD Helios o una configuración diferente de la serie MI400?
- ¿La capacidad es rack completo, rack parcial, clúster privado, inferencia gestionada, vista previa o instancia bajo demanda?
- ¿Qué regiones tienen inventario físico y cuál es la ventana de asignación?
- ¿Qué versiones de ROCm, kernel, driver, firmware, Slurm/Kubernetes, PyTorch, vLLM y SGLang son compatibles?
- ¿Podemos ejecutar nuestro modelo, mezcla de prompts, longitud de contexto, concurrencia y framework de evaluación antes de comprometernos?
- ¿Cuáles son los costes de tiempo en cola, reintento, trabajo fallido, salida de datos, almacenamiento y soporte?
- ¿Qué telemetría se expone para utilización de GPU, presión de HBM, ancho de banda de memoria, contadores de red y fallos de trabajos?
- ¿Qué ocurre si las especificaciones públicas, el plazo de entrega o los resultados del benchmark cambian después de firmar el contrato?
- ¿Qué controles de seguridad existen para el aislamiento de inquilinos, el tratamiento de datos y las evidencias de auditoría?
- ¿Cómo se compara el precio con los actuales precios de alquiler de GPU, GPU serverless frente a GPU dedicada y alternativas gestionadas de modelo/API?
Opinión de Flatkey: siga MI455X, pero mantenga una referencia de producción
El AMD MI455X es importante porque ofrece a los compradores una alternativa seria de HBM4 y a escala de rack para el próximo ciclo de infraestructura de IA. Debería ser seguido por cualquiera que planifique inferencia de modelos grandes, post-entrenamiento o capacidad privada de fábrica de IA.
No es automáticamente el primer movimiento correcto para todos los equipos de producto de IA. Si su producto necesita acceso fiable a salidas de modelo, visibilidad de costes, enrutamiento de respaldo y una única superficie de facturación, una capa gestionada de modelo/API puede mantener la producción en marcha mientras maduran el suministro de MI455X y las imágenes de software.
Flatkey está construido para ese camino: una sola clave, un solo saldo y enrutamiento entre APIs oficiales de modelos y herramientas. Use Flatkey como línea base de producción en su análisis de AMD MI455X para comparar hardware a escala de rack con una ruta de despliegue funcional, no con una hoja de cálculo en blanco.
Preguntas frecuentes
¿Qué es AMD MI455X?
AMD MI455X es un acelerador para centros de datos de la serie AMD Instinct MI400 basado en la arquitectura AMD CDNA Next. AMD indica 432 GB de memoria HBM4 y 23.3 TB/s de ancho de banda máximo de memoria para la GPU.
¿Qué es AMD Helios?
AMD Helios es una plataforma de IA a escala de rack construida en torno a 72 GPU AMD Instinct MI455X. A esa escala, el rack expone unos 31 TB de memoria HBM4 y aproximadamente 1.67 PB/s de ancho de banda agregado de memoria de GPU.
¿Cuál es la capacidad de memoria del AMD MI455X?
La capacidad de memoria pública del AMD MI455X es de 432 GB de HBM4 por GPU. Un rack Helios de 72 GPU alcanza por tanto aproximadamente 31 TB de memoria HBM4 antes del sobrecoste práctico de software y programación.
¿Cuál es el ancho de banda de memoria del AMD MI455X?
La cifra pública actual del MI455X de AMD es 23.3 TB/s de ancho de banda máximo de memoria por GPU. Para un rack Helios de 72 GPU, eso implica aproximadamente 1.67 PB/s de ancho de banda agregado de memoria.
¿Cuándo es la fecha de lanzamiento del AMD MI455X?
AMD ha hecho pública la MI455X y ha posicionado Helios para el ciclo de infraestructura de IA de 2026. Los compradores deberían seguir el inventario específico del proveedor, la región, el acceso de vista previa, las imágenes de software y los términos de reserva en lugar de asumir una única fecha universal de alquiler.
¿Está vLLM habilitado en las GPU AMD Instinct MI455X?
vLLM es compatible con plataformas AMD ROCm, pero la habilitación en producción específica para MI455X depende de la imagen del proveedor, la versión de ROCm, los kernels, el modelo, la configuración de serving y la política de soporte. Verifíquelo con el proveedor antes de comprometer tráfico de producción.
Fuentes consultadas
- Página de producto de AMD Instinct MI455X: https://www.amd.com/en/products/accelerators/instinct/mi400/mi455x.html
- Página de la solución AMD Helios: https://www.amd.com/en/solutions/ai/helios.html
- AMD Newsroom, hoja de ruta de IA y anuncios de infraestructura abierta de IA: https://www.amd.com/en/newsroom/press-releases/2025-6-12-amd-unveils-ai-roadmap-and-comprehensive-full-stack-open-ai-infrastructure-solutions.html
- Documentación de AMD ROCm vLLM: https://rocm.docs.amd.com/en/latest/how-to/rocm-for-ai/inference-optimization/vllm.html


