Wenn Ihre Produktionsprotokolle 529 overloaded_error anzeigen, teilt Ihnen der Anbieter mit, dass die API vorübergehend überlastet ist. In der Claude-API-Dokumentation von Anthropic bedeutet 529 - overloaded_error „Die API ist vorübergehend überlastet“, und die Dokumentation weist darauf hin, dass 529-Fehler bei hohem Traffic über alle Nutzer hinweg auftreten können.
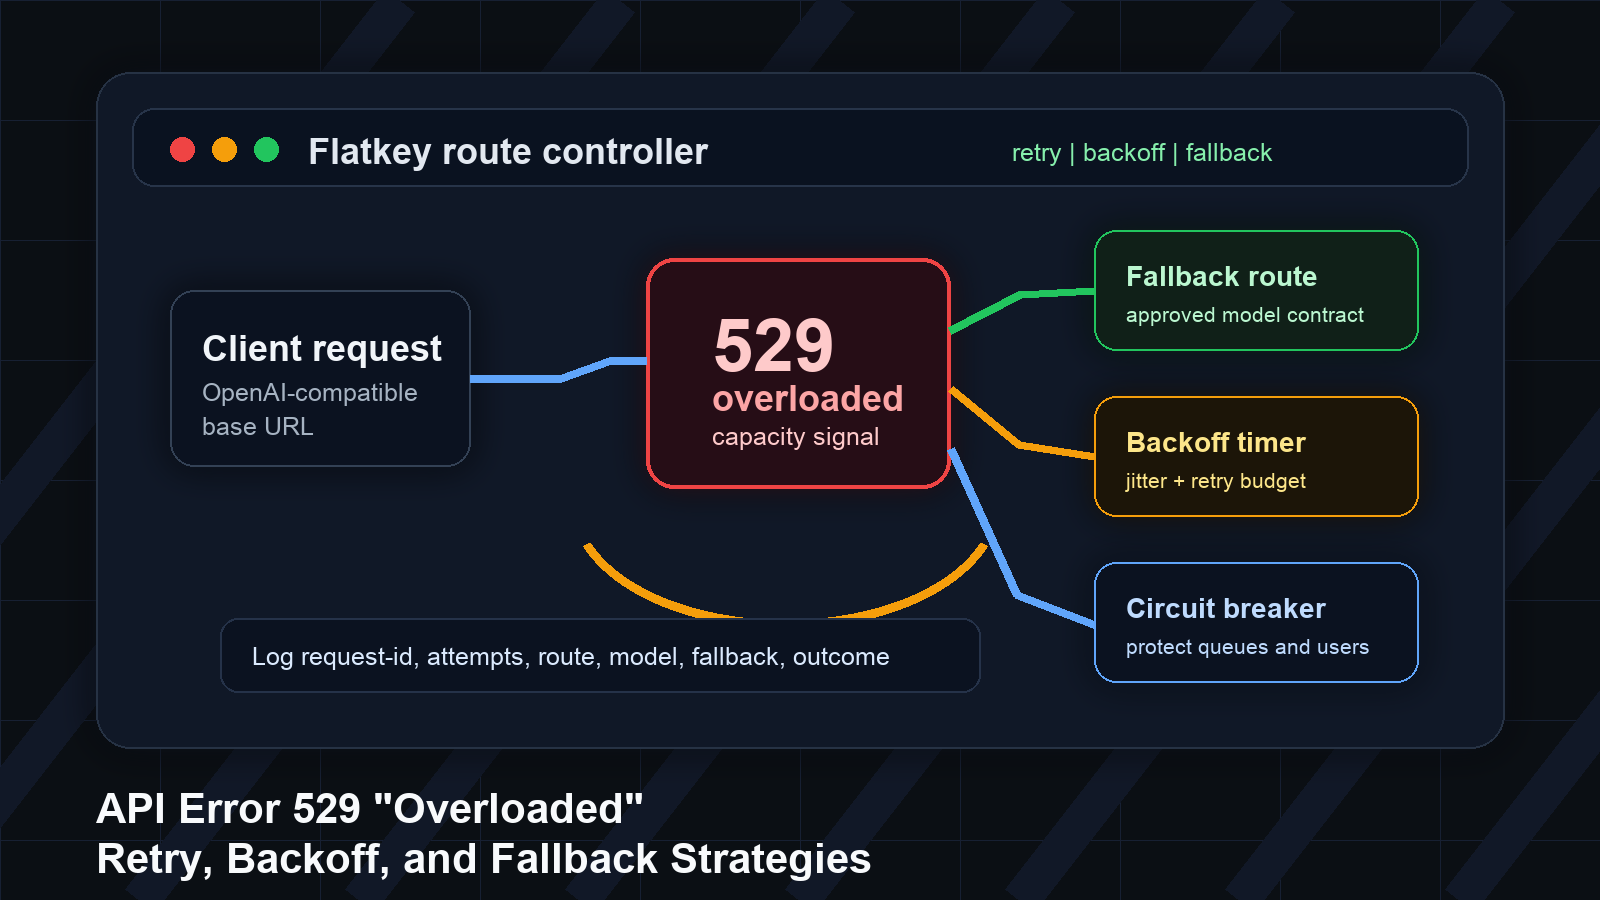
Das macht API-Fehler 529 „Overloaded“: Retry-, Backoff- und Fallback-Strategien anders als eine fehlerhaft formatierte Anfrage, einen ungültigen API-Schlüssel oder ein normales Kontingentproblem. Die erste Reaktion sollte nicht „den Prompt ändern“ oder „mehr Kontingent kaufen“ sein. Die erste Reaktion sollte ein kontrolliertes Zuverlässigkeits-Playbook sein: den Fehler klassifizieren, nur innerhalb eines Budgets erneut versuchen, Nutzer vor Retry-Stürmen schützen und entscheiden, wann ein Fallback-Pfad sicherer ist als Warten.
Dieser Leitfaden richtet sich an KI-Produkt- und Plattformteams, die LLM-, Agenten- oder multimodale Workloads in der Produktion betreiben. Er bietet Ihnen eine praktische Fehler-Aktions-Matrix, ein Retry-Budget, ein Backoff-Muster und einen Fallback-Entscheidungsfluss, den Sie in ein Incident-Runbook übernehmen können.
Schnelle Antwort
Für API-Fehler 529 „Overloaded“: Retry-, Backoff- und Fallback-Strategien verwenden Sie diese Standardrichtlinie:
- Behandeln Sie
529 overloaded_errorals transienten Kapazitätshinweis des Anbieters, nicht als Client-Validierungsfehler. - Wiederholen Sie idempotente oder schreibgeschützte Anfragen mit exponentiellem Backoff und Jitter.
- Beachten Sie
retry-after, wenn der Anbieter es sendet. - Brechen Sie nach einem kleinen Retry-Budget ab, in der Regel nach zwei oder drei Versuchen für interaktiven Traffic.
- Wiederholen Sie nicht blind nicht-idempotente Tool-Aufrufe, Schreibaktionen, Käufe, E-Mails oder alles, was Nebenwirkungen verursacht haben könnte.
- Öffnen Sie einen Circuit Breaker, wenn sich 529er nach Anbieter, Modell, Endpunkt oder Region häufen.
- Weichen Sie nur dann auf einen Fallback aus, wenn das alternative Modell denselben Produktvertrag erfüllen kann.
- Protokollieren Sie
request-id, Modell, Route, Anzahl der Retries, Endergebnis und die sichtbaren Auswirkungen für den Nutzer.
Mit anderen Worten: kurz erneut versuchen, die Herde verlangsamen, failover nur dann nutzen, wenn Gleichwertigkeit akzeptabel ist, und aufhören, wenn die Anfrage nicht mehr sicher zu wiederholen ist.
Warum API-Fehler 529 Overloaded auftritt
529 overloaded_error ist ein Kapazitätszustand. Er bedeutet in der Regel, dass Ihre Anfrage den Anbieter erreicht hat, aber die Anbieterseite im Moment zu stark ausgelastet ist, um sie zu bedienen. Anthropic dokumentiert dies getrennt von 429 rate_limit_error. Dieser Unterschied ist wichtig:
| Fehlerfamilie | Typische Bedeutung | Erste Maßnahme des Verantwortlichen |
|---|---|---|
400, 401, 403, 404 |
Problem mit Anfrage, Anmeldedaten, Berechtigung oder Modellnamen | Anfrage korrigieren; nicht unverändert erneut versuchen |
429 |
Rate-Limit, Beschleunigungs-Limit oder Ausgabenobergrenze | Drosseln, Kontingent und retry-after prüfen, Traffic-Form anpassen |
500, 502, 503, 504 |
Ausfall auf Anbieter- oder Netzwerk-/Server-Seite | Bei Sicherheit mit exponentiellem Backoff erneut versuchen |
529 overloaded_error |
Anbieter durch hohen Traffic überlastet | Mit Backoff erneut versuchen, dann Circuit Breaker oder Fallback |
Ein 529 kann während eines providerweiten Traffic-Anstiegs auftreten, selbst wenn Ihre eigene Workload nichts Ungewöhnliches getan hat. Wenn Sie jedoch eine neue Funktion einführen, einen Batch ausführen oder plötzlich einen Agentenschwarm senden, sollten Sie auch prüfen, ob Ihr Traffic-Anstieg lokalen Druck oder ein Verhalten der Beschleunigungsgrenze verursacht hat.
Fehler-Aktions-Matrix
Verwenden Sie diese Matrix, bevor Sie in Panik Code ändern.
| Signal in den Logs | Retry? | Backoff? | Fallback? | Was protokollieren |
|---|---|---|---|---|
| Einzelner 529 bei einer schreibgeschützten Chat-Anfrage | Ja, kurzzeitig | Ja, mit Jitter | Nicht beim ersten Fehler | request-id, Modell, Route, Versuch |
| Wiederholte 529s für ein Modell | Ja, bis das Budget aufgebraucht ist | Ja | Ja, wenn die Alternative vertragskompatibel ist | Fallback-Modell, Qualitätsprüfung, Auswirkungen auf den Nutzer |
| 529s auf allen Claude-Routen | Begrenzt | Ja | Vielleicht, nur auf eine freigegebene Nicht-Claude-Route | Provider-Status, Circuit-Zustand |
| 529 nach teilweiser Streaming-Ausgabe | Normalerweise kein transparentes Retry | Kein blindes Replay | Stoppen oder den Nutzer zum Neu-Generieren auffordern | Teil-Tokens, letztes Event, für den Nutzer sichtbare Kopie |
| 529 während der Tool-Ausführung | Nur wenn das Tool idempotent ist | Ja | Nicht, bis Seiteneffekte abgeglichen sind | Tool-Name, Idempotenz-Schlüssel, externer Zustand |
| 529 während eines Hintergrund-Batches | Ja, langsamer | Ja, größeres Fenster | Ja, wenn es die SLA erfordert | Queue-Alter, Retry-Alter, verworfene Anzahl |
| 529 plus überschrittene Nutzer-Deadline | Nein | Nein | Vielleicht, wenn es noch nützlich ist | Timeout-Klasse, Fallback-Grund |
Das ist der Teil, den die meisten generischen Fehlerseiten verpassen: Ein überlastetes Modell ist nicht nur ein HTTP-Status. Es ist eine Produktentscheidung über doppelte Arbeit, Latenz, Ausgabequalität und das Vertrauen der Nutzer.
Eine sichere Retry-Richtlinie für 529
Beginnen Sie mit getrennten Retry-Budgets für interaktive und Hintergrund-Workloads.
| Workload | Empfohlene erste Richtlinie |
|---|---|
| Für Nutzer sichtbarer Chat oder Autocomplete | 2 Retries, begrenzt auf unter das nutzerseitige Timeout |
| Planungsschritt eines Agenten | 2-3 Retries, stoppen, bevor die Tool-Ausführung veraltet |
| Hintergrund-Zusammenfassung | 3-5 Retries, queue-bewusst, mit weiterem Backoff |
| Batch-Evaluierung | Retry aus der Queue mit Altersgrenzen und Dead-Letter-Behandlung |
| Schreibender Tool-Call | Nur mit Idempotenzschutz und Abgleich erneut versuchen |
Die einfachste Retry-Form ist exponentielles Backoff mit Jitter:
function backoffMs(attempt: number) {
  const base = 250;
  const cap = 8_000;
  const exponential = Math.min(cap, base * 2 ** attempt);
  const jitter = Math.floor(Math.random() * exponential * 0.4);
  return exponential + jitter;
}
Verwenden Sie kleine Werte für interaktive Produkte. Eine Chat-Nachricht, die 60 Sekunden lang erneut versucht wird, mag technisch widerstandsfähig sein, fühlt sich für den Nutzer aber trotzdem kaputt an. Für Hintergrund-Queues verwenden Sie ein breiteres Backoff-Fenster und bewahren Sie das Arbeitselement für die spätere Verarbeitung auf, anstatt den Provider zu überlasten.
Beachten Sie Retry-After, aber verlassen Sie sich nicht darauf
Einige APIs senden retry-after-Header für Rate-Limits oder vorübergehende Ausfälle. In den Docs von Anthropic steht, dass offizielle SDKs vorübergehende Ausfälle mit exponentiellem Backoff standardmäßig zweimal erneut versuchen und retry-after respektieren, wenn er vorhanden ist. Ihr eigener Controller sollte dasselbe tun, wenn Sie das SDK umgehen oder darum herum eine eigene Schicht bauen.
Aber bauen Sie keine Policy, die nur funktioniert, wenn retry-after existiert. Eine 529-Antwort kommt möglicherweise nicht immer mit einer sinnvollen Wartezeit zurück. Ihr Fallback-Controller braucht dennoch:
- einen maximalen Versuchswert,
- ein maximales Wall-Clock-Budget,
- einen Circuit Breaker pro Route,
- ein Limit für das Warteschlangenalter,
- und einen finalen, für Nutzer sichtbaren Fehlerzustand.
Vermeiden Sie Retry-Stürme
Die schlimmste Reaktion auf eine Überlastung des Providers ist synchronisierter Retry-Traffic. Wenn jeder Worker sofort erneut versucht, machen Sie aus einem Vorfall beim Provider einen größeren Vorfall.
Fügen Sie diese Kontrollen hinzu:
| Kontrolle | Warum sie wichtig ist |
|---|---|
| Jitter | Verhindert, dass alle Clients im selben Moment erneut versuchen |
| Concurrent-Limits pro Route | Sorgt dafür, dass ein überlastetes Modell nicht alle Worker-Slots belegt |
| Retry-Budget | Stoppt Endlosschleifen und überraschende Ausgaben |
| Circuit Breaker | Verlagert wiederholte Fehler aus dem Hot Path |
| Queue Backpressure | Verlangsamt Produzenten, wenn Verbraucher keine Fortschritte machen können |
| Für Nutzer sichtbarer Status | Zeigt Nutzern an, wenn das System erneut versucht oder degradiert ist |
Die AWS-Guidance zu Retry mit Backoff macht denselben operativen Punkt: Retries helfen bei vorübergehenden Fehlern, aber zu viele Retries können die Konkurrenz um Ressourcen und die Degradierung des Dienstes erhöhen.
Wann Sie statt Retry einen Fallback verwenden sollten
Fallback ist nicht dasselbe wie Retry. Ein Retry lässt denselben Pfad es noch einmal versuchen. Ein Fallback wechselt den Pfad, den Anbieter, das Modell, die Region oder die Fähigkeit.
Verwenden Sie einen Fallback, wenn alle vier Bedingungen erfüllt sind:
- Der primäre Pfad scheitert wiederholt mit 529 oder ähnlichen vorübergehenden Fehlern.
- Der Nutzer oder die Workload profitiert trotz der zusätzlichen Latenz noch von einer Antwort.
- Der alternative Pfad erfüllt denselben Produktvertrag.
- Die Anfrage hat noch keine Teilausgabe oder unsicheren Seiteneffekte erzeugt.
Verwenden Sie einen Route-Vertrag wie diesen:
task: support_reply_draft
primary:
  model: claude-sonnet-current
  max_attempts: 2
  retry_on: [529, 500, 502, 503, 504, timeout]
  backoff: exponential_jitter
fallback:
  model: approved-general-chat-model
  allowed_when:
    - no_partial_stream_output
    - no_write_side_tool_executed
    - response_schema_compatible
    - latency_budget_remaining_ms > 3000
stop:
  user_message: "Das Modell ist überlastet. Bitte versuchen Sie es in einem Moment erneut."
log:
  fields:
    - request_id
    - route
    - model
    - retry_count
    - fallback_used
    - final_status
Wenn Ihr Produkt von exakt diesem Modellverhalten, dem Format von Tool-Calls, der Zitationsrichtlinie, dem Sicherheitsverhalten oder einer Long-Context-Funktion abhängt, kann ein Cross-Model-Fallback schlechter sein als ein klarer Fehler. Für diese Workloads ist ein Fallback auf denselben Anbieter/dasselbe Modell in einer anderen Route sicherer als ein Fallback auf eine andere Modellfamilie.
Für die breitere Architektur hinter dieser Entscheidung kombinieren Sie diese Fehlerseite mit Flatkeys LLM API fallback routing production playbook und dem model fallback strategy workflow playbook. Diese Leitfäden behandeln das größere Controller-Muster; diese Seite bleibt auf die 529-overloaded-Antwort fokussiert.
Idempotenzregeln für 529
Die Sicherheit von Retries hängt von Idempotenz ab. Die AWS-Richtlinien weisen darauf hin, dass Operationen idempotent sein sollten, wenn Sie mit Backoff erneut versuchen; andernfalls können partielle Updates den Zustand beschädigen. Auch Stripes Low-Level-Fehlerhinweise machen denselben Punkt für Netzwerk- und Serverfehler: Fehlgeschlagene oder unklare Requests können den Client im Unklaren darüber lassen, ob der Server die Anfrage empfangen oder ausgeführt hat.
Für KI-Produkte wenden Sie diese Regel auf Tools und Side Effects an:
| Operation | Sicherer 529-Retry? | Hinweise |
|---|---|---|
| Eine Entwurfsantwort generieren | Meistens | Doppelter Text ist akzeptabel, wenn Sie den alten Versuch ersetzen |
| Eine Antwort streamen, nachdem Tokens bereits gestartet wurden | Riskant | Der Nutzer könnte doppelte oder inkonsistente Ausgabe sehen |
| Ein Dokument lesen | Meistens | Verwenden Sie Request-IDs zur Nachverfolgbarkeit |
| Eine E-Mail senden | Nein, außer idempotent | Verwenden Sie einen Idempotenzschlüssel und Abgleich mit dem externen Zustand |
| Ein Ticket erstellen | Nur mit Idempotenz | Verwenden Sie dieselbe Operations-ID erneut |
| Eine Karte belasten | Kein blinder Retry | Stimmen Sie sich vor einer Wiederholung mit dem Zahlungsanbieter ab |
| Eine Browser- oder Agent-Aktion ausführen | Meistens nicht blind | Prüfen Sie, was der Agent bereits getan hat |
Die praktische Regel ist einfach: Wenn eine wiederholte Anfrage doppelten externen Zustand erzeugen könnte, lassen Sie nicht einen generischen Retry-Wrapper die Verantwortung übernehmen.
Schwellenwerte für den Circuit Breaker
Ein Circuit Breaker wandelt wiederholte Überlastung in eine vorübergehende Routing-Entscheidung um. Sie benötigen dafür kein komplexes System, um zu starten.
Verwenden Sie eine Richtlinie wie:
- Öffnen Sie den Circuit, wenn 529er über zwei Minuten hinweg mehr als 20 % der Versuche für eine Route ausmachen und mindestens 20 Requests versucht wurden.
- Halten Sie den Circuit für interaktiven Traffic 60–180 Sekunden offen.
- Senden Sie eine kleine Anzahl von Probe-Requests, bevor Sie den Circuit schließen.
- Setzen Sie langsam zurück; senden Sie nicht die gesamte Warteschlange auf einmal zurück zur Route.
- Verfolgen Sie den Circuit-Status nach Provider, Modell, Endpoint-Familie und Region, wenn möglich.
Circuit Breaker sind besonders wichtig für Agentensysteme, weil Agenten oft auf mehreren Ebenen erneut versuchen: Model-SDK, Orchestrierungsbibliothek, Job-Worker und Benutzerbefehls-Schleife. Zählen Sie jede Ebene mit, sonst multiplizieren Sie möglicherweise ungewollt Ihr Retry-Budget.
Observability-Checkliste
Pro 529-Incident sollten Sie genügend Belege protokollieren, um vier Fragen zu beantworten: Was ist fehlgeschlagen, warum wurde es erneut versucht, ob ein Fallback stattgefunden hat und was der Benutzer gesehen hat.
| Feld | Warum es wichtig ist |
|---|---|
request_id oder Provider-Request-Header |
Wird für Support und die Lookup-Seite des Providers benötigt |
model und provider |
Gruppiert Fehler nach Route |
endpoint_family |
Chat, Batch, Bild, Video, Embeddings, Tool-Call |
attempt_number |
Erkennt versteckte Retry-Vervielfachung |
retry_after_ms |
Bestätigt, ob die Vorgaben des Providers befolgt wurden |
backoff_ms |
Hilft, Retry-Stürme zu erkennen |
fallback_route |
Zeigt, wann Qualität oder Kosten abweichen können |
partial_output_started |
Verhindert unsicheres erneutes Abspielen |
tool_side_effect_state |
Verhindert doppelte externe Aktionen |
user_visible_outcome |
Trennt behobene Fehler von defekten Sessions |
Flatkey-Teams können dasselbe Muster mit https://router.flatkey.ai/v1 verwenden: über eine OpenAI-kompatible Basis-URL routen, die Modellauswahl explizit halten und die Nutzungsprotokolle nach dem Vorfall prüfen. Das Quickstart von Flatkey dokumentiert den gemeinsamen Schlüssel, den Modellkatalog, die Router-Basis-URL und die Usage Logs als die Stellen, an denen Anfrageverkehr und Kosten verifiziert werden.
Wenn Sie die Behandlung von Rate Limits noch von der Behandlung von Überlastung trennen, verwenden Sie den LLM-Rate-Limits-Leitfaden für die 429/RPM/TPM-Richtlinie und den Leitfaden zu KI-Routing-API-Metriken für Zuverlässigkeitsberichte.
Wie Flatkey in einen 529-Wiederherstellungsplan passt
Flatkey sollte nicht als Möglichkeit betrachtet werden, so zu tun, als könne eine Überlastung nicht auftreten. Upstream-Modellanbieter können trotzdem ausgelastet sein. Die nützliche Rolle eines Gateways ist die operative Kontrolle:
- Eine OpenAI-kompatible Basis-URL für Modellverkehr.
- Ein gemeinsamer Modellkatalog für genehmigte Fallback-Kandidaten.
- Eine einzige Nutzungs- und Kostenübersicht für Retries und wiederhergestellte Fehler.
- Schnellere Änderungen der Routing-Richtlinie, ohne jeden Anwendungsklienten neu zu schreiben.
- Eine sauberere Prüfhistorie, wenn Produkt-, Plattform- und Finanzteams den Vorfall bewerten.
Für ein Produktionsteam ist das oft wertvoller als eine größere Retry-Schleife. Eine größere Retry-Schleife kann Vorfälle verbergen, bis sie teuer werden. Eine geroutete Richtlinie macht Überlastung sichtbar und kontrollierbar.
Produktions-Runbook für API-Fehler 529
Kopieren Sie dies in Ihren Incident-Prozess:
- Bestätigen Sie die Fehlerklasse:
529 overloaded_error, Anbieter, Modell, Endpunkt, Zeitstempel und Request-ID. - Prüfen Sie, ob die Anfrage nur lesend, Streaming oder schreibend war.
- Wenden Sie das Retry-Budget der Route mit exponentiellem Backoff und Jitter an.
- Brechen Sie Retries ab, wenn die Anfrage eine teilweise Ausgabe oder unklare Nebenwirkungen erzeugt hat.
- Öffnen Sie einen Circuit Breaker, wenn 529er sich auf derselben Anbieter-/Modellroute häufen.
- Weichen Sie nur auf eine freigegebene Route mit kompatiblem Ausgabe-, Sicherheits-, Latenz- und Kostenverhalten aus.
- Zeigen Sie eine benutzerseitige Meldung an, wenn das Latenzbudget abläuft.
- Prüfen Sie nach dem Vorfall die Anzahl der Retries, Fallbacks, wiederhergestellten Anfragen, fehlgeschlagenen Anfragen und den Nachweis zur Vermeidung von Duplikaten.
FAQ
Ist API-Fehler 529 dasselbe wie 429?
Nein. In den Anthropic-Dokumenten bedeutet 529, dass die API vorübergehend überlastet ist, während 429 ein Rate-Limit-Fehler ist. Behandeln Sie 529 als Überlastung des Anbieters und 429 als ein Problem mit Rate, Kontingent oder Traffic-Form, bis Ihre Logs etwas anderes belegen.
Sollte ich API-Fehler 529 erneut versuchen?
Ja, aber nur innerhalb eines Budgets und nur, wenn die Anfrage gefahrlos wiederholt werden kann. Verwenden Sie exponentielles Backoff mit Jitter, beachten Sie retry-after, wenn vorhanden, und stoppen Sie, wenn eine teilweise Ausgabe oder externe Nebenwirkungen ein Replay unsicher machen.
Wie viele Retries sollte ich bei 529-overloaded-Fehlern verwenden?
Für interaktive KI-Funktionen beginnen Sie mit zwei Retries und einer strikten Wall-Clock-Deadline. Hintergrundjobs können mehr Retries verwenden, sollten aber Altersgrenzen der Queue, Dead-Letter-Behandlung und Circuit Breaker nutzen.
Sollte ich nach einem 529 automatisch Modelle wechseln?
Nur dann, wenn das Fallback-Modell denselben Produktvertrag erfüllen kann. Wenn modellspezifisches Verhalten, Tools, Schema, Sicherheitsrichtlinien oder die Kontextlänge wichtig sind, braucht das Fallback möglicherweise eine für den Benutzer sichtbare Aktion „mit einem anderen Modell neu generieren“ statt eines transparenten Wechsels.
Was sollte ich Benutzern während eines 529-Vorfalls anzeigen?
Verwenden Sie eine einfache Sprache für einen temporären Zustand: „Das Modell ist überlastet. Wir versuchen es kurz erneut.“ Wenn das Retry-Budget abläuft, bieten Sie eine Schaltfläche zum erneuten Versuch oder eine reduzierte Alternative an. Legen Sie keine internen Details des Anbieters offen, es sei denn, Ihre Nutzer sind Entwickler, die diese Details benötigen.
Endgültige Empfehlung
Der sicherste Plan für API-Fehler 529 „Overloaded“: Retry-, Backoff- und Fallback-Strategien ist keine einzelne while retry-Schleife. Er ist eine Routenrichtlinie: temporäre Überlastungen kurz erneut versuchen, mit Jitter zurückoffen, nicht-idempotente Vorgänge schützen, wiederholte Fehler per Circuit Breaker abfangen und nur dann auf eine alternative Route ausweichen, wenn der Nutzervertrag erhalten bleibt.
Wenn Ihr Team bereits mehr als ein Modell oder einen Anbieter betreibt, legen Sie diese Richtlinie hinter ein einziges Gateway. Mit Flatkey können Sie OpenAI-kompatible Clients auf https://router.flatkey.ai/v1 verweisen, Fallback-Kandidaten in einem Modellkatalog bündeln und wiederhergestellte Ausfälle nach dem Launch in den Usage Logs prüfen.
Beginnen Sie mit dem Flatkey API-Quickstart, wenn Sie einen Weg für den ersten Aufruf benötigen, oder vergleichen Sie routingbezogene Entscheidungen auf Workload-Ebene in Claude API Proxy vs. Multi-Model-Router.
Geprüfte Quellen
- Anthropic Claude API-Fehler: https://platform.claude.com/docs/en/api/errors
- AWS Prescriptive Guidance, Retry-with-Backoff-Muster: https://docs.aws.amazon.com/prescriptive-guidance/latest/cloud-design-patterns/retry-backoff.html
- Erweitertes Fehlermanagement und Idempotenz bei Stripe: https://docs.stripe.com/error-low-level
- Flatkey-Dokumentationsindex: https://docs.flatkey.ai/index.md
- Flatkey-Kurzanleitung: https://docs.flatkey.ai/quickstart.md
- Produktübersicht von Flatkey:
/Users/solveainc/.11agents/flatkey/knowledge_base/information/what-we-do/product-overview.md - Marketingstrategie von Flatkey:
/Users/solveainc/.11agents/flatkey/knowledge_base/marketing/strategy.md