Si vos journaux de production affichent 529 overloaded_error, le fournisseur vous indique que l’API est temporairement surchargée. Dans la documentation de l’API Claude d’Anthropic, 529 - overloaded_error signifie « L’API est temporairement surchargée », et la documentation précise que des erreurs 529 peuvent survenir lors de pics de trafic touchant tous les utilisateurs.
Cela distingue Erreur API 529 « Surchargée » : stratégies de retry, de backoff et de repli d’une requête mal formée, d’une clé API invalide ou d’un problème normal de quota. La première réaction ne doit pas être « modifier le prompt » ni « acheter plus de quota ». La première réaction doit être un plan d’action de fiabilité maîtrisé : classer l’échec, réessayer uniquement dans la limite d’un budget, protéger les utilisateurs contre les tempêtes de retries, et décider quand une voie de repli est plus sûre que l’attente.
Ce guide est destiné aux équipes produit et plateforme IA qui exécutent en production des charges de travail LLM, agentiques ou multimodales. Il vous fournit une matrice pratique d’erreur-action, un budget de retry, un schéma de backoff et un flux de décision de repli que vous pouvez copier dans un runbook d’incident.
Réponse rapide
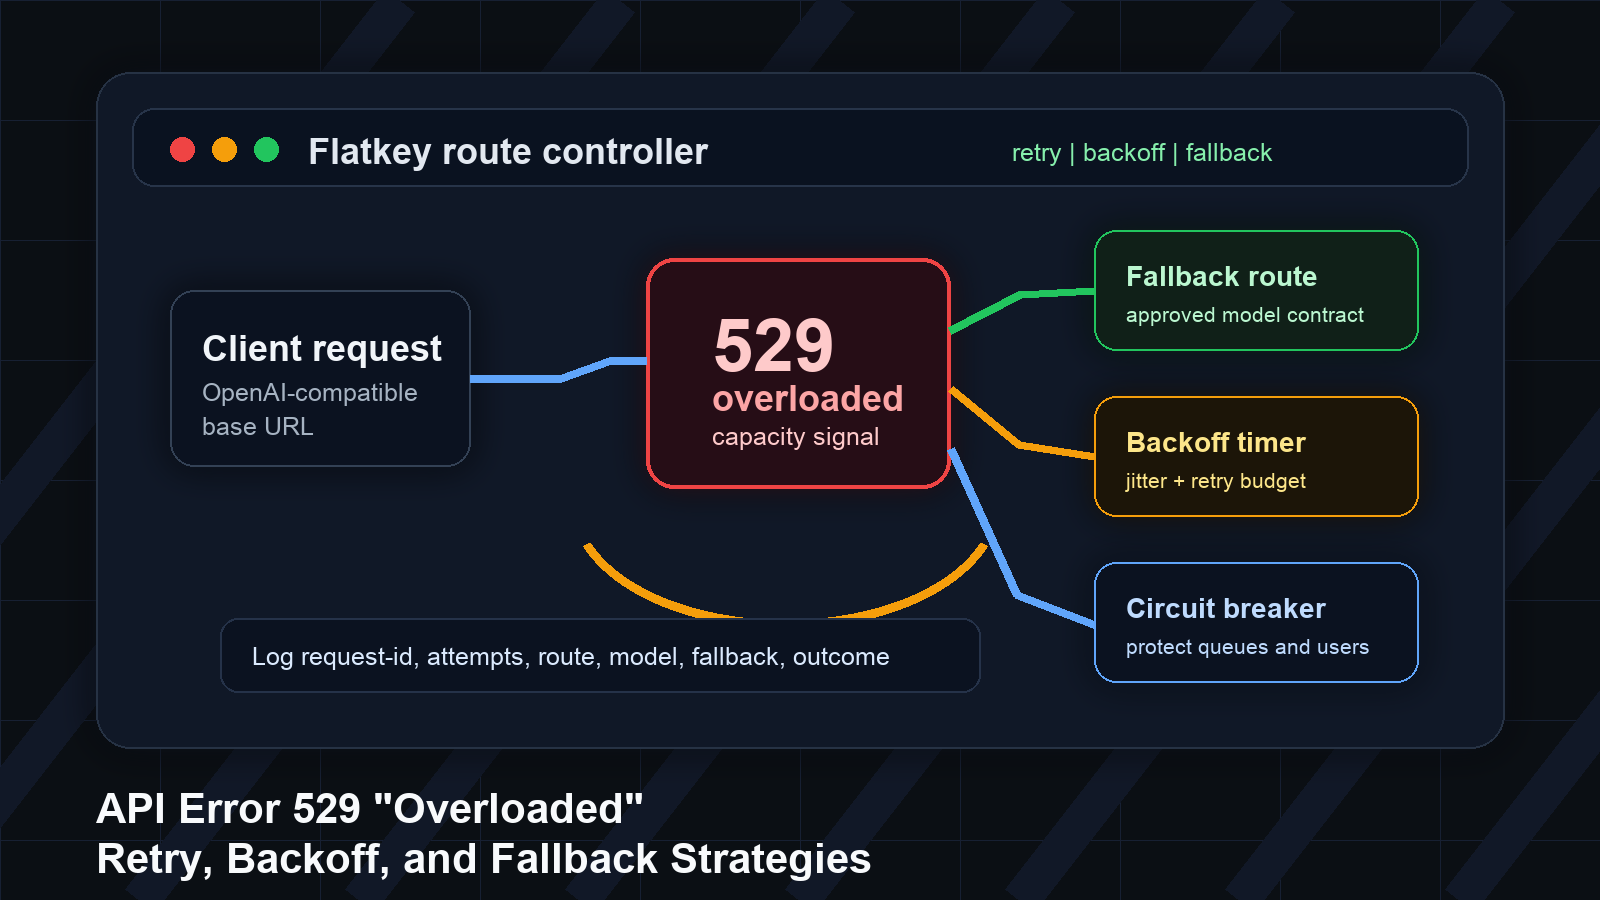
Pour Erreur API 529 « Surchargée » : stratégies de retry, de backoff et de repli, utilisez cette politique par défaut :
- Traitez
529 overloaded_errorcomme un signal temporaire de capacité du fournisseur, et non comme un bug de validation côté client. - Réessayez les requêtes idempotentes ou en lecture seule avec un backoff exponentiel et du jitter.
- Respectez
retry-afterlorsque le fournisseur l’envoie. - Arrêtez après un petit budget de retry, généralement deux ou trois tentatives pour le trafic interactif.
- Ne réessayez pas aveuglément les appels d’outils non idempotents, les actions d’écriture, les achats, les e-mails ou tout ce qui a pu provoquer des effets de bord.
- Ouvrez un circuit breaker lorsque les erreurs 529 se concentrent par fournisseur, modèle, endpoint ou région.
- Ne basculez vers un repli que lorsque le modèle alternatif peut satisfaire le même contrat produit.
- Journalisez
request-id, le modèle, la route, le nombre de retries, le résultat final et l’impact visible pour l’utilisateur.
En d’autres termes : réessayez brièvement, ralentissez la vague, basculez en cas d’équivalence acceptable, et arrêtez lorsque la requête n’est plus sûre à répéter.
Pourquoi l’erreur API 529 Surchargée se produit
529 overloaded_error est une condition de capacité. Cela signifie généralement que votre requête a bien atteint le fournisseur, mais que le côté fournisseur est trop occupé pour la traiter à cet instant. Anthropic documente cela séparément de 429 rate_limit_error. Cette distinction est importante :
| Famille d’erreurs | Signification typique | Première action du responsable |
|---|---|---|
400, 401, 403, 404 |
Problème de requête, d’identifiants, d’autorisation ou de nom de modèle | Corriger la requête ; ne pas réessayer sans modification |
429 |
Limite de débit, limite d’accélération ou plafond de dépense | Ralentir, vérifier le quota et retry-after, modifier le profil de trafic |
500, 502, 503, 504 |
Défaillance du fournisseur ou du côté réseau/serveur | Réessayer avec un backoff exponentiel si c’est sûr |
529 overloaded_error |
Fournisseur surchargé par un trafic élevé | Réessayer avec backoff, puis activer un circuit breaker ou un repli |
Un 529 peut apparaître lors d’un pic de trafic à l’échelle du fournisseur, même si votre propre charge n’a rien fait d’inhabituel. Mais si vous lancez une nouvelle fonctionnalité, exécutez un lot ou envoyez un essaim soudain d’agents, vous devez aussi vérifier si votre montée en charge du trafic a provoqué une pression locale ou un comportement de limite d’accélération.
Matrice erreur-action
Utilisez cette matrice avant de modifier le code sous l’effet de la panique.
| Signal dans les logs | Retry ? | Backoff ? | Repli ? | Quoi consigner |
|---|---|---|---|---|
| Un seul 529 sur une requête de chat en lecture seule | Oui, brièvement | Oui, avec jitter | Pas au premier échec | request-id, modèle, route, tentative |
| 529 répétés pour un modèle | Oui, jusqu’à expiration du budget | Oui | Oui, si l’alternative est compatible avec le contrat | modèle de repli, seuil de qualité, impact utilisateur |
| 529 sur toutes les routes Claude | Limité | Oui | Peut-être, uniquement vers une route non-Claude approuvée | statut du fournisseur, état du circuit |
| 529 après une sortie de streaming partielle | En général, pas de retry transparent | Pas de relecture aveugle | Arrêter ou demander à l’utilisateur de régénérer | tokens partiels, dernier événement, copie visible par l’utilisateur |
| 529 pendant l’exécution d’un outil | Seulement si l’outil est idempotent | Oui | Pas avant réconciliation des effets de bord | nom de l’outil, clé d’idempotence, état externe |
| 529 pendant un batch en arrière-plan | Oui, plus lentement | Oui, fenêtre plus large | Oui, si le SLA l’exige | ancienneté de la file, ancienneté du retry, nombre abandonné |
| 529 plus dépassement du délai utilisateur | Non | Non | Peut-être, si cela reste utile | classe de timeout, raison du repli |
C’est la partie que la plupart des pages d’erreur génériques ratent : un modèle surchargé n’est pas seulement un statut HTTP. C’est une décision produit concernant le travail en double, la latence, la qualité de sortie et la confiance de l’utilisateur.
Une politique de retry sûre pour 529
Commencez par des budgets de retry séparés pour les charges interactives et les charges en arrière-plan.
| Charge | Première politique suggérée |
|---|---|
| Chat ou autocomplétion orientés utilisateur | 2 retries, plafonnés sous le timeout visible par l’utilisateur |
| Étape de planification d’agent | 2-3 retries, arrêt avant que l’exécution d’outils ne devienne obsolète |
| Résumé en arrière-plan | 3-5 retries, sensibles à la file, avec backoff plus large |
| Évaluation par lot | Retry depuis la file avec des limites d’âge et une gestion de dead-letter |
| Appel d’outil côté écriture | Retry uniquement avec protection contre l’idempotence et réconciliation |
La forme de retry la plus simple est un backoff exponentiel avec jitter :
function backoffMs(attempt: number) {
  const base = 250;
  const cap = 8_000;
  const exponential = Math.min(cap, base * 2 ** attempt);
  const jitter = Math.floor(Math.random() * exponential * 0.4);
  return exponential + jitter;
}
Utilisez de petites valeurs pour les produits interactifs. Un message de chat qui retry pendant 60 secondes peut être techniquement résilient, mais donner quand même à l’utilisateur l’impression que tout est cassé. Pour les files d’attente en arrière-plan, utilisez une fenêtre de backoff plus large et conservez l’élément de travail pour un traitement ultérieur au lieu de marteler le fournisseur.
Respectez Retry-After, mais ne dépendez pas de lui
Certaines API envoient des en-têtes retry-after pour les limites de débit ou les échecs transitoires. La documentation d'Anthropic indique que les SDK officiels réessaient les échecs transitoires avec un backoff exponentiel, deux fois par défaut, et respectent retry-after lorsqu'il est présent. Votre propre contrôleur devrait faire de même lorsque vous contournez ou encapsulez le SDK.
Mais ne construisez pas une politique qui ne fonctionne que lorsque retry-after existe. Une réponse 529 peut ne pas toujours arriver avec un délai d'attente exploitable. Votre contrôleur de repli doit quand même prévoir :
- une valeur maximale de tentatives,
- un budget maximal en temps réel,
- un disjoncteur par route,
- une limite d'ancienneté de file d'attente,
- et un mode d'échec final visible par l'utilisateur.
Évitez les tempêtes de retries
La pire réponse à une surcharge du fournisseur est un trafic de retry synchronisé. Si chaque worker réessaie immédiatement, vous transformez un incident chez le fournisseur en incident plus grave.
Ajoutez ces contrôles :
| Contrôle | Pourquoi c'est important |
|---|---|
| Jitter | Empêche tous les clients de réessayer au même instant |
| Plafonds de concurrence par route | Évite qu'un modèle surchargé consomme tous les emplacements de worker |
| Budget de retry | Empêche les boucles infinies et les dépenses surprises |
| Disjoncteur | Éloigne les échecs répétés du chemin critique |
| Contre-pression de la file d'attente | Ralentit les producteurs lorsque les consommateurs ne peuvent pas progresser |
| État visible par l'utilisateur | Indique aux utilisateurs quand le système réessaie ou est dégradé |
Les recommandations de retry-with-backoff d'AWS formulent le même point opérationnel : les retries aident en cas d'échecs transitoires, mais un trop grand nombre de retries peut augmenter la contention et la dégradation du service.
Quand utiliser un repli au lieu d'un retry
Le repli n'est pas la même chose que le retry. Un retry demande à la même route d'essayer à nouveau. Un repli change de route, de fournisseur, de modèle, de région ou de capacité.
Utilisez un repli lorsque les quatre conditions suivantes sont vraies :
- La route primaire échoue de manière répétée avec 529 ou des erreurs transitoires associées.
- L'utilisateur ou la charge de travail bénéficie encore d'une réponse après la latence supplémentaire.
- La route alternative satisfait au même contrat produit.
- La requête n'a pas déjà produit de sortie partielle ni d'effets secondaires incertains.
Utilisez un contrat de route comme celui-ci :
task: support_reply_draft
primary:
  model: claude-sonnet-current
  max_attempts: 2
  retry_on: [529, 500, 502, 503, 504, timeout]
  backoff: exponential_jitter
fallback:
  model: approved-general-chat-model
  allowed_when:
    - no_partial_stream_output
    - no_write_side_tool_executed
    - response_schema_compatible
    - latency_budget_remaining_ms > 3000
stop:
  user_message: "The model is overloaded. Please retry in a moment."
log:
  fields:
    - request_id
    - route
    - model
    - retry_count
    - fallback_used
    - final_status
Si votre produit dépend du comportement exact du modèle, du format des appels d'outils, de la politique de citation, du comportement de sécurité ou d'une fonctionnalité de long contexte, un repli vers un autre modèle peut être pire qu'un échec clair. Pour ces charges de travail, un repli vers le même fournisseur/modèle sur une autre route est plus sûr qu'un repli vers une autre famille de modèles.
Pour l’architecture plus large derrière cette décision, associez cette page d’erreur au playbook de production du routage de repli pour les API LLM de Flatkey et au playbook de workflow de stratégie de repli de modèle. Ces guides couvrent le schéma de contrôleur plus large ; cette page reste centrée sur la réponse 529 de surcharge.
Règles d’idempotence pour 529
La sécurité des retries dépend de l’idempotence. Les recommandations AWS indiquent que les opérations doivent être idempotentes lorsque vous effectuez des retries avec backoff ; sinon, des mises à jour partielles peuvent corrompre l’état. Les recommandations de bas niveau de Stripe disent la même chose pour les erreurs réseau et serveur : les requêtes échouées ou ambiguës peuvent laisser le client dans l’incertitude quant à savoir si le serveur a reçu ou exécuté la requête.
Pour les produits d’IA, appliquez cette règle aux outils et aux effets secondaires :
| Opération | Retry 529 sûr ? | Notes |
|---|---|---|
| Générer une réponse brouillon | Généralement | Du texte en double est acceptable si vous remplacez l’ancienne tentative |
| Diffuser une réponse après le début des tokens | À risque | L’utilisateur peut voir une sortie dupliquée ou incohérente |
| Lire un document | Généralement | Utilisez des IDs de requête pour la traçabilité |
| Envoyer un e-mail | Non, sauf si idempotent | Utilisez une clé d’idempotence et un rapprochement de l’état externe |
| Créer un ticket | Uniquement avec idempotence | Réutilisez le même ID d’opération |
| Débiter une carte | Pas de retry aveugle | Rapprochez avec le prestataire de paiement avant de répéter |
| Exécuter une action de navigateur ou d’agent | Généralement pas en aveugle | Vérifiez ce que l’agent a déjà fait |
La règle pratique est simple : si une requête répétée peut créer un état externe dupliqué, ne laissez pas un wrapper de retry générique en être propriétaire.
Seuils du coupe-circuit
Un coupe-circuit transforme une surcharge répétée en une décision de routage temporaire. Vous n’avez pas besoin d’un système complexe pour commencer.
Utilisez une politique comme :
- Ouvrez le coupe-circuit lorsque les 529 dépassent 20 % des tentatives pour une route sur deux minutes et qu’au moins 20 requêtes ont été tentées.
- Gardez le coupe-circuit ouvert pendant 60 à 180 secondes pour le trafic interactif.
- Envoyez un petit nombre de requêtes de test avant de refermer le coupe-circuit.
- Réinitialisez lentement ; n’envoyez pas toute la file d’attente d’un coup vers la route.
- Suivez l’état du coupe-circuit par fournisseur, modèle, famille de point de terminaison et région lorsque c’est possible.
Les coupe-circuits sont particulièrement importants pour les systèmes d’agents, car les agents effectuent souvent des retries à plusieurs niveaux : SDK du modèle, bibliothèque d’orchestration, worker de tâche et boucle de commande utilisateur. Comptez chaque niveau, sinon vous risquez de multiplier accidentellement votre budget de retry.
Liste de contrôle de l’observabilité
Pour chaque incident 529, journalisez suffisamment de preuves pour répondre à quatre questions : ce qui a échoué, pourquoi cela a été retenté, si un repli a eu lieu, et ce que l’utilisateur a vu.
| Champ | Pourquoi c’est important |
|---|---|
request_id ou en-tête de requête du fournisseur |
Requis pour le support et la recherche côté fournisseur |
model et provider |
Regroupe les échecs par route |
endpoint_family |
Chat, batch, image, vidéo, embeddings, appel d’outil |
attempt_number |
Détecte la multiplication cachée des retries |
retry_after_ms |
Confirme si les recommandations du fournisseur ont été suivies |
backoff_ms |
Aide à repérer les tempêtes de retries |
fallback_route |
Montre quand la qualité ou le coût peuvent différer |
partial_output_started |
Empêche une reprise dangereuse |
tool_side_effect_state |
Empêche les actions externes en double |
user_visible_outcome |
Sépare les échecs récupérés des sessions défaillantes |
Les équipes Flatkey peuvent utiliser le même schéma avec https://router.flatkey.ai/v1 : acheminer le trafic via une seule URL de base compatible OpenAI, garder la sélection du modèle explicite et consulter les journaux d’utilisation après l’incident. Le guide de démarrage rapide de Flatkey documente la clé partagée, le catalogue de modèles, l’URL de base du routeur et les journaux d’utilisation comme endroits où vérifier le trafic des requêtes et les coûts.
Si vous séparez encore le traitement des limites de débit du traitement de la surcharge, utilisez le guide des limites de débit des LLM pour la politique 429/RPM/TPM et le guide des métriques d’API de routage IA pour le reporting de fiabilité.
Comment Flatkey s’intègre dans un plan de reprise après erreur 529
Flatkey ne doit pas être considéré comme un moyen de faire comme si la surcharge ne pouvait pas se produire. Les fournisseurs de modèles en amont peuvent toujours être occupés. Le rôle utile d’une passerelle est le contrôle opérationnel :
- Une seule URL de base compatible OpenAI pour le trafic des modèles.
- Un catalogue de modèles partagé pour les candidats de repli approuvés.
- Un seul registre d’utilisation et de coûts pour les retries et les échecs récupérés.
- Des changements plus rapides de politique de routage sans réécrire chaque client applicatif.
- Une piste d’audit plus claire lorsque les équipes produit, plateforme et finance examinent l’incident.
Pour une équipe de production, cela est souvent plus précieux qu’une boucle de retry plus large. Une boucle de retry plus large peut masquer les incidents jusqu’à ce qu’ils deviennent coûteux. Une politique routée rend la surcharge visible et maîtrisée.
Procédure d’exploitation en production pour l’erreur API 529
Copiez ceci dans votre processus d’incident :
- Confirmez la classe d’erreur :
529 overloaded_error, le fournisseur, le modèle, l’endpoint, l’horodatage et l’ID de requête. - Vérifiez si la requête était en lecture seule, en streaming ou côté écriture.
- Appliquez le budget de retry de la route avec un backoff exponentiel et du jitter.
- Arrêtez les retries si la requête a produit une sortie partielle ou des effets de bord incertains.
- Ouvrez un circuit breaker si des 529 se regroupent sur la même route fournisseur/modèle.
- Ne basculez vers un repli que vers une route approuvée offrant un comportement compatible en matière de sortie, de sécurité, de latence et de coût.
- Affichez un message côté utilisateur lorsque le budget de latence expire.
- Examinez le nombre de retries, le nombre de replis, les requêtes récupérées, les requêtes échouées et les preuves de prévention des doublons après l’incident.
FAQ
L’erreur API 529 est-elle la même que 429 ?
Non. Dans la documentation d’Anthropic, 529 signifie que l’API est temporairement surchargée, tandis que 429 est une erreur de limite de taux. Traitez 529 comme une surcharge du fournisseur et 429 comme un problème de taux/quota/profil de trafic jusqu’à ce que vos journaux prouvent le contraire.
Dois-je retenter l’erreur API 529 ?
Oui, mais uniquement dans la limite d’un budget et seulement lorsque la requête peut être répétée sans risque. Utilisez un backoff exponentiel avec jitter, respectez retry-after lorsqu’il est présent, et arrêtez-vous lorsque une sortie partielle ou des effets de bord externes rendent la répétition dangereuse.
Combien de retries dois-je utiliser pour les erreurs 529 overloaded ?
Pour des fonctionnalités IA interactives, commencez avec deux retries et une deadline stricte en temps réel. Les tâches d’arrière-plan peuvent utiliser davantage de retries, mais doivent s’appuyer sur des limites d’âge de file d’attente, une gestion des dead letters et des circuit breakers.
Dois-je basculer automatiquement vers un autre modèle après un 529 ?
Seulement lorsque le modèle de repli peut satisfaire le même contrat produit. Si le comportement spécifique au modèle, les outils, le schéma, la politique de sécurité ou la longueur du contexte comptent, le repli peut nécessiter une action visible par l’utilisateur du type « régénérer avec un autre modèle » plutôt qu’un basculement transparent.
Que dois-je montrer aux utilisateurs pendant un incident 529 ?
Utilisez un langage simple décrivant un état temporaire : « Le modèle est surchargé. Nous réessayons brièvement. » Si le budget de retry expire, proposez un bouton de retry ou une alternative dégradée. N’exposez pas les détails internes du fournisseur, sauf si vos utilisateurs sont des développeurs qui ont besoin de ces informations.
Recommandation finale
Le plan le plus sûr pour l’erreur API 529 « Surchargée » : stratégies de retry, de backoff et de repli n’est pas une simple boucle while retry. C’est une politique de route : réessayer brièvement les surcharges transitoires, ralentir avec jitter, protéger les opérations non idempotentes, ouvrir un circuit breaker pour les échecs répétés, et ne se replier que lorsque la route alternative préserve le contrat utilisateur.
Si votre équipe exploite déjà plus d’un modèle ou fournisseur, placez cette politique derrière une seule gateway. Avec Flatkey, vous pouvez pointer des clients compatibles OpenAI vers https://router.flatkey.ai/v1, conserver les candidats de repli dans un seul catalogue de modèles, et consulter les échecs récupérés dans les Usage Logs après le lancement.
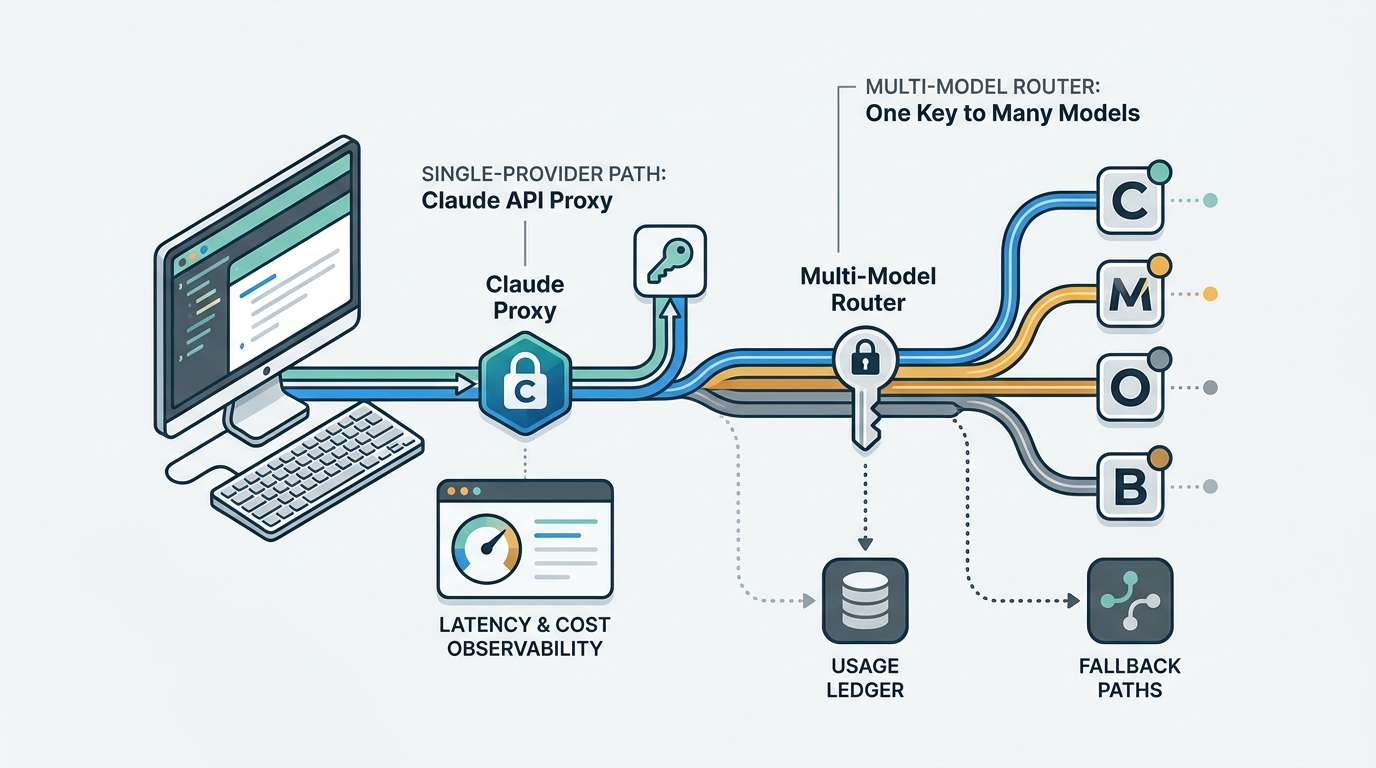
Commencez par le démarrage rapide de l’API Flatkey si vous avez besoin d’un chemin pour le premier appel, ou comparez les विकल्प de routage au niveau de la charge de travail dans proxy d’API Claude vs routeur multi-modèles.
Sources consultées
- Erreurs de l’API Anthropic Claude : https://platform.claude.com/docs/en/api/errors
- Guide prescriptif AWS, modèle de retry avec backoff : https://docs.aws.amazon.com/prescriptive-guidance/latest/cloud-design-patterns/retry-backoff.html
- Gestion avancée des erreurs et idempotence chez Stripe : https://docs.stripe.com/error-low-level
- Index de la documentation Flatkey : https://docs.flatkey.ai/index.md
- Démarrage rapide Flatkey : https://docs.flatkey.ai/quickstart.md
- Présentation du produit Flatkey :
/Users/solveainc/.11agents/flatkey/knowledge_base/information/what-we-do/product-overview.md - Stratégie marketing Flatkey :
/Users/solveainc/.11agents/flatkey/knowledge_base/marketing/strategy.md