Если в ваших production-логах появляется 529 overloaded_error, провайдер сообщает, что API временно перегружен. В документации API Claude от Anthropic 529 - overloaded_error означает «API временно перегружен», и в документации отмечается, что ошибки 529 могут возникать при высокой нагрузке у всех пользователей.
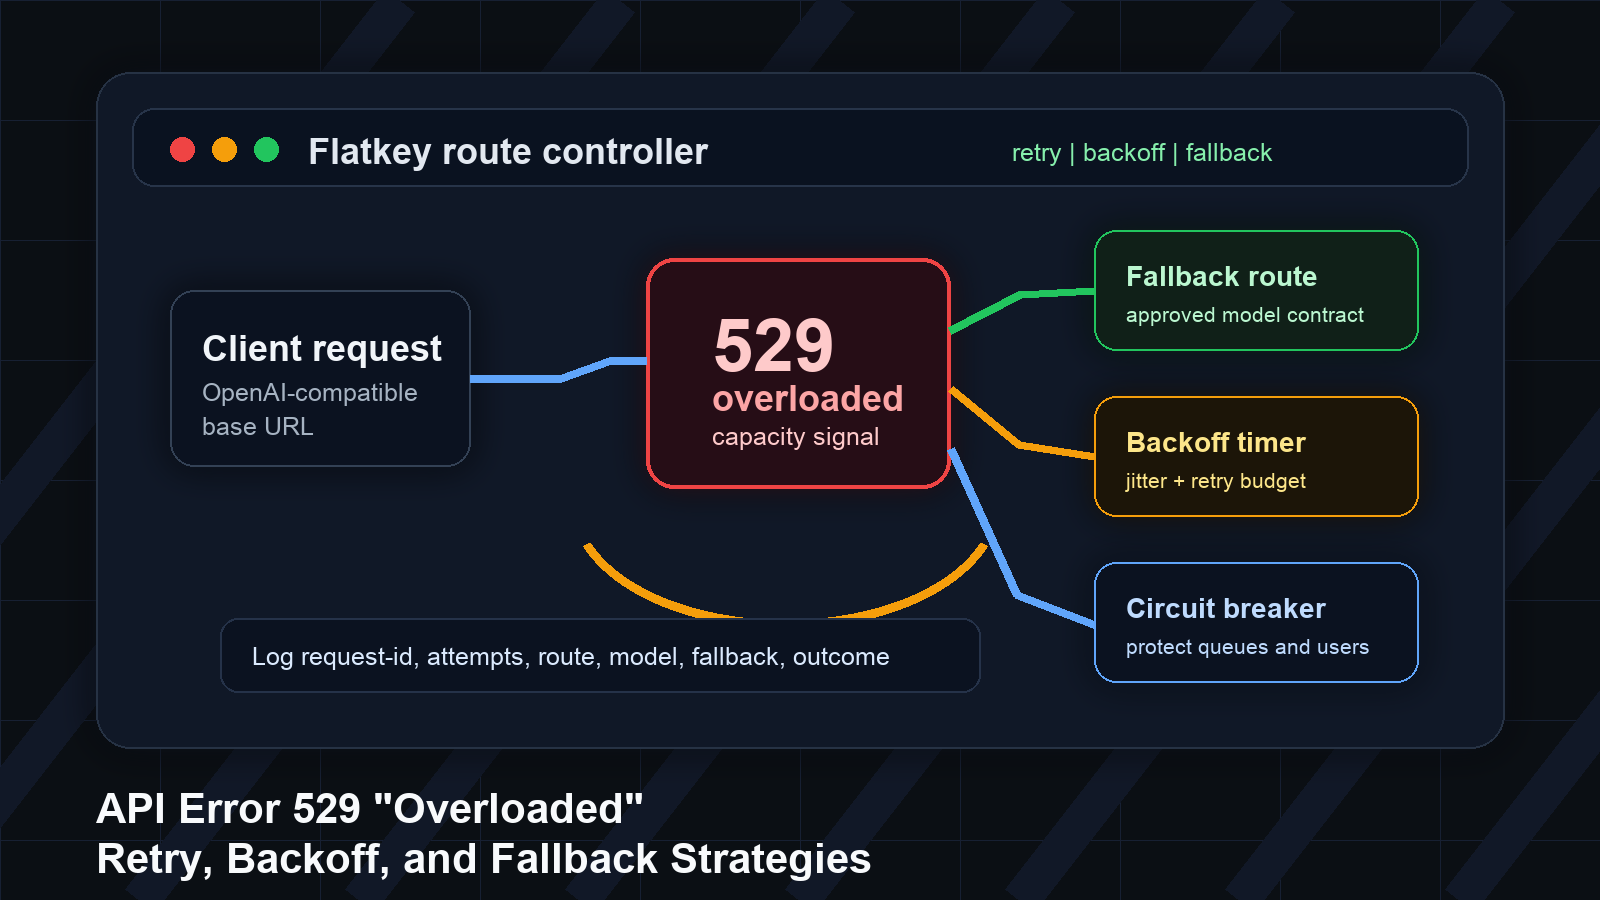
Это делает Ошибка API 529 «Перегрузка»: стратегии повторных попыток, backoff и fallback отличной от некорректного запроса, неверного API-ключа или обычной проблемы с квотой. Первой реакцией не должно быть «изменить prompt» или «купить больше квоты». Первая реакция должна быть контролируемым планом обеспечения надежности: классифицировать сбой, повторять запрос только в рамках бюджета, защищать пользователей от штормов повторных попыток и решать, когда запасной маршрут безопаснее ожидания.
Это руководство написано для команд AI-продуктов и платформ, которые запускают LLM-, agent- или multimodal-нагрузки в production. Оно дает вам практическую матрицу «ошибка-действие», бюджет повторных попыток, шаблон backoff и схему принятия решения о fallback, которые можно перенести в incident runbook.
Краткий ответ
Для Ошибки API 529 «Перегрузка»: стратегии повторных попыток, backoff и fallback используйте такую политику по умолчанию:
- Считайте
529 overloaded_errorвременным сигналом нехватки мощности у провайдера, а не ошибкой валидации на стороне клиента. - Повторяйте идемпотентные или только для чтения запросы с экспоненциальным backoff и jitter.
- Учитывайте
retry-after, когда провайдер его отправляет. - Останавливайтесь после небольшого бюджета повторных попыток, обычно двух или трех попыток для интерактивного трафика.
- Не повторяйте вслепую недемпотентные tool calls, операции записи, покупки, письма или что-либо, что могло вызвать побочные эффекты.
- Открывайте circuit breaker, когда 529-сообщения группируются по провайдеру, модели, endpoint или региону.
- Переходите на fallback только тогда, когда альтернативная модель может выполнить тот же продуктовый контракт.
- Логируйте
request-id, model, route, число повторных попыток, итоговый результат и влияние на пользователя.
Иными словами: повторяйте кратко, замедляйте поток запросов, переключайтесь на резерв при допустимой эквивалентности и останавливайтесь, когда запрос уже небезопасно повторять.
Почему возникает ошибка API 529 Overloaded
529 overloaded_error — это состояние нехватки емкости. Обычно это означает, что ваш запрос дошел до провайдера, но на стороне провайдера в этот момент слишком высокая нагрузка, чтобы обработать его. Anthropic документирует это отдельно от 429 rate_limit_error. Это различие важно:
| Семейство ошибок | Типичное значение | Первое действие владельца |
|---|---|---|
400, 401, 403, 404 |
Проблема с запросом, учетными данными, правами доступа или именем модели | Исправьте запрос; не повторяйте его без изменений |
429 |
Ограничение скорости, limit ускорения или лимит расходов | Снизьте нагрузку, проверьте квоту и retry-after, измените форму трафика |
500, 502, 503, 504 |
Сбой на стороне провайдера или сети/сервера | Повторяйте с экспоненциальным backoff, если это безопасно |
529 overloaded_error |
Провайдер перегружен высоким трафиком | Повторяйте с backoff, затем включайте circuit breaker или fallback |
529 может появиться во время общесистемного всплеска трафика у провайдера, даже если в вашей собственной нагрузке не было ничего необычного. Но если вы запускаете новую функцию, выполняете пакетную обработку или отправляете внезапный рой агентов, вам также следует проверить, не вызвал ли ваш рост трафика локальное давление или поведение, связанное с лимитом ускорения.
Матрица ошибок и действий
Используйте эту матрицу, прежде чем в панике менять код.
| Сигнал в логах | Повторить? | Backoff? | Fallback? | Что записать |
|---|---|---|---|---|
| Один 529 в запросе на чтение в чат | Да, ненадолго | Да, с jitter | Не при первой ошибке | request-id, модель, маршрут, попытка |
| Повторяющиеся 529 для одной модели | Да, пока не исчерпан бюджет | Да | Да, если альтернативный вариант совместим по контракту | резервная модель, quality gate, влияние на пользователя |
| 529 на всех маршрутах Claude | Ограниченно | Да | Возможно, только на одобренный не-Claude маршрут | статус провайдера, состояние circuit |
| 529 после частичной потоковой выдачи | Обычно без прозрачного повторного запроса | Не делать blind replay | Остановить или попросить пользователя сгенерировать заново | частичные токены, последнее событие, видимый пользователю текст |
| 529 во время выполнения инструмента | Только если инструмент идемпотентен | Да | Не до тех пор, пока side effects не будут согласованы | имя инструмента, ключ идемпотентности, внешнее состояние |
| 529 во время фоновой batch-задачи | Да, но медленнее | Да, с более широким окном | Да, если это требует SLA | возраст очереди, возраст повторной попытки, число отброшенных |
| 529 плюс превышен дедлайн пользователя | Нет | Нет | Возможно, если это все еще полезно | класс таймаута, причина fallback |
Вот что упускает большинство общих страниц ошибок: перегруженная модель — это не просто HTTP-статус. Это продуктовое решение о дублирующейся работе, задержке, качестве вывода и доверии пользователя.
Безопасная политика повторных попыток для 529
Начните с отдельных бюджетов повторных попыток для интерактивных и фоновых нагрузок.
| Нагрузка | Рекомендуемая начальная политика |
|---|---|
| Чат или автодополнение для пользователя | 2 повторные попытки, ограниченные пользовательским таймаутом |
| Шаг планирования агента | 2-3 повторные попытки, остановка до того, как выполнение инструмента устареет |
| Фоновое суммирование | 3-5 повторных попыток, с учетом очереди, с более широким backoff |
| Пакетная оценка | Повтор из очереди с ограничением по возрасту и обработкой dead-letter |
| Вызов write-side инструмента | Повторять только с защитой от повторов и согласованием состояния |
Самая простая форма повторов — экспоненциальный backoff с jitter:
function backoffMs(attempt: number) {
  const base = 250;
  const cap = 8_000;
  const exponential = Math.min(cap, base * 2 ** attempt);
  const jitter = Math.floor(Math.random() * exponential * 0.4);
  return exponential + jitter;
}
Используйте небольшие значения для интерактивных продуктов. Сообщение чата, которое повторяется 60 секунд, может быть технически устойчивым, но для пользователя все равно выглядит сломанным. Для фоновых очередей используйте более широкое окно backoff и сохраняйте рабочий элемент для последующей обработки вместо того, чтобы постоянно нагружать провайдера.
Учитывайте Retry-After, но не полагайтесь на него
Некоторые API отправляют заголовки retry-after для лимитов запросов или временных сбоев. В документации Anthropic говорится, что официальные SDK повторяют попытки при временных сбоях с экспоненциальным backoff, по умолчанию два раза, и учитывают retry-after, если он присутствует. Ваш собственный контроллер должен делать то же самое, если вы обходите SDK или оборачиваете его.
Но не стройте политику, которая работает только при наличии retry-after. Ответ 529 не всегда приходит с полезным временем ожидания. Вашему fallback-контроллеру по-прежнему нужны:
- максимальное число попыток,
- максимальный бюджет по времени wall-clock,
- circuit breaker на уровне маршрута,
- ограничение возраста очереди,
- и финальный режим отказа, видимый пользователю.
Избегайте штормов повторных попыток
Худшая реакция на перегрузку провайдера — синхронизированный поток повторных попыток. Если каждый worker пытается повторить запрос немедленно, вы превращаете один инцидент у провайдера в более крупный инцидент.
Добавьте следующие механизмы:
| Механизм | Почему это важно |
|---|---|
| Jitter | Не позволяет всем клиентам повторять попытку в один и тот же момент |
| Ограничения параллелизма по маршруту | Не дает одной перегруженной модели занять все слоты worker-ов |
| Бюджет повторных попыток | Останавливает бесконечные циклы и неожиданные расходы |
| Circuit breaker | Убирает повторяющиеся сбои с горячего пути |
| Backpressure очереди | Замедляет producers, когда consumers не могут продвигаться |
| Состояние, видимое пользователю | Сообщает пользователям, когда система повторяет попытки или деградировала |
Рекомендации AWS по retry-with-backoff формулируют тот же операционный вывод: повторные попытки помогают при временных сбоях, но слишком большое их число может усилить конкуренцию и привести к ухудшению работы сервиса.
Когда использовать fallback вместо повторной попытки
Fallback — это не то же самое, что retry. Retry просит тот же маршрут попробовать снова. Fallback меняет маршрут, провайдера, модель, регион или возможность.
Используйте fallback, когда выполняются все четыре условия:
- Основной маршрут repeatedly терпит сбой с 529 или связанными временными ошибками.
- Пользователь или рабочая нагрузка все еще получает пользу от ответа после дополнительной задержки.
- Альтернативный маршрут удовлетворяет тому же продуктовым контракту.
- Запрос еще не породил частичный вывод или неопределенные побочные эффекты.
Используйте такой контракт маршрута:
task: support_reply_draft
primary:
  model: claude-sonnet-current
  max_attempts: 2
  retry_on: [529, 500, 502, 503, 504, timeout]
  backoff: exponential_jitter
fallback:
  model: approved-general-chat-model
  allowed_when:
    - no_partial_stream_output
    - no_write_side_tool_executed
    - response_schema_compatible
    - latency_budget_remaining_ms > 3000
stop:
  user_message: "Модель перегружена. Пожалуйста, повторите попытку через некоторое время."
log:
  fields:
    - request_id
    - route
    - model
    - retry_count
    - fallback_used
    - final_status
Если ваш продукт зависит от точного поведения модели, формата вызовов инструментов, политики цитирования, поведения в области безопасности или функции длинного контекста, fallback на другую модель может быть хуже, чем явный отказ. Для таких рабочих нагрузок fallback на того же провайдера/модель по другому маршруту безопаснее, чем fallback на другую семейство моделей.
Для более широкой архитектуры, стоящей за этим решением, сопоставьте эту страницу ошибки с LLM API fallback routing production playbook от Flatkey и model fallback strategy workflow playbook. Эти руководства охватывают более общий шаблон контроллера; эта страница остается сосредоточенной на ответе 529 overload.
Правила идемпотентности для 529
Безопасность повторных попыток зависит от идемпотентности. Рекомендации AWS указывают, что операции должны быть идемпотентными, когда вы повторяете запрос с backoff; иначе частичные обновления могут повредить состояние. Низкоуровневые рекомендации Stripe по ошибкам говорят о том же в отношении сетевых и серверных ошибок: неудачные или неясные запросы могут оставить клиента в неопределенности относительно того, получил ли сервер запрос или выполнил ли его.
Для AI-продуктов применяйте это правило к инструментам и побочным эффектам:
| Операция | Безопасно повторять при 529? | Примечания |
|---|---|---|
| Сгенерировать черновой ответ | Обычно | Дублирование текста допустимо, если вы заменяете предыдущую попытку |
| Потоковая передача ответа после начала выдачи токенов | Рискованно | Пользователь может увидеть дублированный или несогласованный вывод |
| Прочитать документ | Обычно | Используйте идентификаторы запросов для трассируемости |
| Отправить email | Нет, если только не идемпотентно | Используйте idempotency key и сверку с внешним состоянием |
| Создать тикет | Только с идемпотентностью | Переиспользуйте тот же operation ID |
| Списать средства с карты | Не выполнять blind retry | Перед повтором выполните сверку с платежным провайдером |
| Выполнить действие в браузере или агенте | Обычно не blind | Проверьте, что агент уже сделал |
Практическое правило простое: если повторный запрос может создать дублированное внешнее состояние, не позволяйте общему retry-wrapper управлять им.
Пороговые значения circuit breaker
Circuit breaker превращает повторяющуюся перегрузку во временное решение маршрутизации. Чтобы начать, не нужна сложная система.
Используйте такую политику:
- Открывайте circuit, когда доля 529 превышает 20% попыток для маршрута в течение двух минут и было предпринято не менее 20 запросов.
- Держите circuit открытым 60-180 секунд для интерактивного трафика.
- Отправляйте небольшое число probe-запросов перед закрытием circuit.
- Сбрасывайте медленно; не отправляйте всю очередь обратно на маршрут сразу.
- По возможности отслеживайте состояние circuit по провайдеру, модели, семейству endpoint и региону.
Circuit breaker особенно важны для agent-систем, потому что агенты часто повторяют попытки на нескольких уровнях: model SDK, orchestration library, job worker и user command loop. Считайте каждый уровень, иначе вы можете случайно умножить свой retry budget.
Чеклист наблюдаемости
Для каждого инцидента 529 фиксируйте достаточно данных, чтобы ответить на четыре вопроса: что вышло из строя, почему был выполнен повтор, был ли fallback и что увидел пользователь.
| Поле | Почему это важно |
|---|---|
request_id или заголовок запроса провайдера |
Нужен для поддержки и поиска на стороне провайдера |
model и provider |
Группирует сбои по маршруту |
endpoint_family |
Чат, batch, изображение, видео, embeddings, вызов инструмента |
attempt_number |
Выявляет скрытое умножение повторных попыток |
retry_after_ms |
Подтверждает, была ли соблюдена рекомендация провайдера |
backoff_ms |
Помогает выявлять штормы повторных попыток |
fallback_route |
Показывает, когда качество или стоимость могут отличаться |
partial_output_started |
Предотвращает небезопасное повторное воспроизведение |
tool_side_effect_state |
Предотвращает дублирование внешних действий |
user_visible_outcome |
Отделяет восстановленные сбои от сломанных сессий |
Команды Flatkey могут использовать тот же подход с https://router.flatkey.ai/v1: направляйте трафик через один базовый URL, совместимый с OpenAI, явно указывайте выбор модели и после инцидента проверяйте журналы использования. В quickstart Flatkey описаны общий ключ, каталог моделей, базовый URL роутера и Usage Logs как места, где можно проверить трафик запросов и стоимость.
Если вы всё ещё разделяете обработку ограничений по rate limit и обработку перегрузки, используйте руководство по ограничениям LLM rate limits для политики 429/RPM/TPM и руководство по метрикам API для AI-роутинга для отчётности по надёжности.
Как Flatkey вписывается в план восстановления после 529
Не следует воспринимать Flatkey как способ сделать вид, что перегрузка не может произойти. Вышестоящие провайдеры моделей всё равно могут быть заняты. Полезная роль шлюза — операционный контроль:
- Один базовый URL, совместимый с OpenAI, для трафика моделей.
- Общий каталог моделей для одобренных кандидатов на fallback.
- Единый реестр использования и затрат для повторных попыток и восстановленных сбоев.
- Более быстрые изменения политики маршрутизации без переписывания каждого клиентского приложения.
- Более чистый аудиторский след, когда команды продукта, платформы и финансов рассматривают инцидент.
Для production-команды это часто ценнее, чем более крупный цикл повторных попыток. Более крупный цикл retry может скрывать инциденты, пока они не станут дорогими. Маршрутизируемая политика делает перегрузку заметной и управляемой.
Производственный runbook для ошибки API 529
Скопируйте это в процесс работы с инцидентами:
- Подтвердите класс ошибки:
529 overloaded_error, провайдер, модель, endpoint, временную метку и ID запроса. - Проверьте, был ли запрос только на чтение, потоковым или с записью.
- Применяйте лимит повторных попыток маршрута с экспоненциальным backoff и jitter.
- Прекратите повторные попытки, если запрос сформировал частичный вывод или имеет неясные побочные эффекты.
- Откройте circuit breaker, если 529 возникают кластерно на одном и том же маршруте провайдер/модель.
- Переключайтесь на fallback только к одобренному маршруту с совместимым поведением по выводу, безопасности, задержке и стоимости.
- Показывайте пользователю сообщение, когда истекает бюджет по задержке.
- После инцидента проверьте число повторных попыток, число fallback, восстановленные запросы, неудачные запросы и доказательства предотвращения дубликатов.
FAQ
Ошибка API 529 — это то же самое, что 429?
Нет. В документации Anthropic 529 означает, что API временно перегружен, а 429 — это ошибка ограничения частоты запросов. Рассматривайте 529 как перегрузку провайдера, а 429 — как проблему скорости/квоты/формы трафика, пока ваши логи не докажут обратное.
Стоит ли повторять запрос при ошибке API 529?
Да, но только в пределах бюджета и только когда запрос безопасно повторить. Используйте экспоненциальный backoff с jitter, учитывайте retry-after, если он присутствует, и останавливайтесь, если частичный вывод или внешние побочные эффекты делают повтор небезопасным.
Сколько повторных попыток следует использовать для ошибок 529 overloaded?
Для интерактивных AI-функций начните с двух повторных попыток и жесткого дедлайна по времени. Фоновые задачи могут использовать больше повторных попыток, но должны применять лимиты по возрасту очереди, обработку dead-letter и circuit breaker.
Нужно ли автоматически переключать модели после 529?
Только если fallback-модель может обеспечить тот же продуктовый контракт. Если важны поведение конкретной модели, инструменты, схема, политика безопасности или длина контекста, fallback может потребовать видимого для пользователя действия «перегенерировать с другой моделью» вместо прозрачного переключения.
Что показывать пользователям во время инцидента 529?
Используйте простые формулировки о временном состоянии: «Модель перегружена. Мы ненадолго повторяем запрос». Если бюджет повторных попыток исчерпан, предложите кнопку повтора или упрощенную альтернативу. Не раскрывайте внутренние детали провайдера, если только ваши пользователи не разработчики, которым нужны эти сведения.
Итоговая рекомендация
Самый безопасный план Ошибки API 529 «Перегрузка»: стратегии повторных попыток, backoff и fallback — это не один цикл while retry. Это политика маршрута: кратко повторять временную перегрузку, делать backoff с jitter, защищать неидемпотентные операции, включать circuit breaker при повторяющихся сбоях и переходить на fallback только тогда, когда альтернативный маршрут сохраняет пользовательский контракт.
Если ваша команда уже использует более одной модели или провайдера, поместите эту политику за единый шлюз. С Flatkey вы можете направлять OpenAI-compatible клиентов на https://router.flatkey.ai/v1, хранить кандидатов для fallback в одном каталоге моделей и просматривать восстановленные сбои в Usage Logs после запуска.
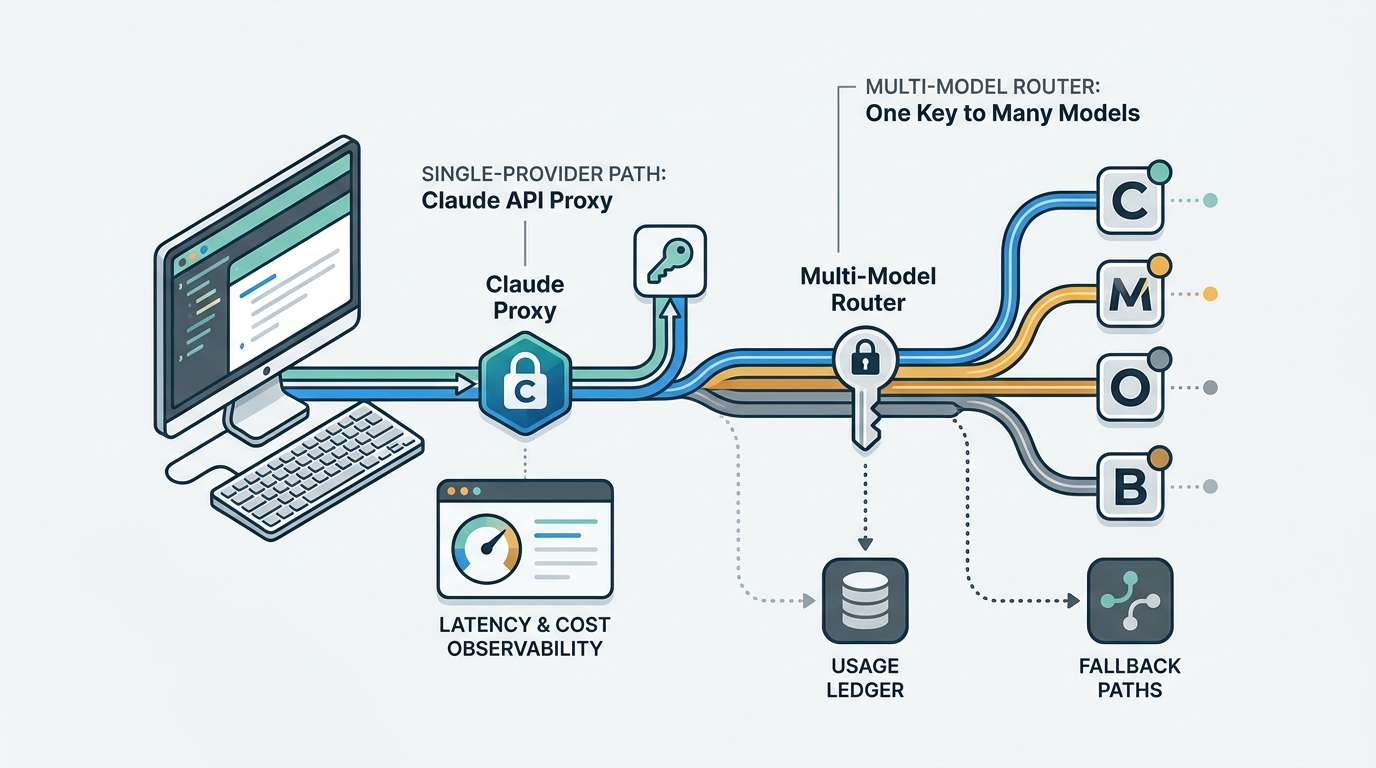
Начните с быстрого старта Flatkey API, если вам нужен путь для первого вызова, или сравните варианты маршрутизации на уровне рабочих нагрузок в Claude API proxy vs multi-model router.
Проверенные источники
- Ошибки API Anthropic Claude: https://platform.claude.com/docs/en/api/errors
- Руководство AWS Prescriptive Guidance, шаблон retry with backoff: https://docs.aws.amazon.com/prescriptive-guidance/latest/cloud-design-patterns/retry-backoff.html
- Расширенная обработка ошибок Stripe и идемпотентность: https://docs.stripe.com/error-low-level
- Индекс документации Flatkey: https://docs.flatkey.ai/index.md
- Быстрый старт Flatkey: https://docs.flatkey.ai/quickstart.md
- Обзор продукта Flatkey:
/Users/solveainc/.11agents/flatkey/knowledge_base/information/what-we-do/product-overview.md - Маркетинговая стратегия Flatkey:
/Users/solveainc/.11agents/flatkey/knowledge_base/marketing/strategy.md